قيّم نموذج Claude Fable 5.2 عبر مهام برمجية واقعية وممثلة لمستودعك البرمجي، مستندًا إلى معايير قبول محددة، وبيئات تشغيل متطابقة، وخط أساس تستخدمه بالفعل. قس التعديلات المقبولة، وجهد المراجعة المطلوب، والوقت المستغرق، والتكلفة الإجمالية بصورة متكاملة. كرّر جولات الاختبار، واحتفظ بمحاولات الفشل، واتخذ قرار الاعتماد وفقًا لتصنيف كل مهمة بدلاً من الاعتماد على درجة تقييم معيارية واحدة.
أعلنت Anthropic عن Fable 5.2 في 9 نوفمبر 2026. وتفيد نشرة الإعلان بتحقيق تحسينات في البرمجة والاستدلال المنطقي. تظل هذه مجرد ادعاءات تسويقية تستند إلى تجارب وتقييمات الشركة المطورة، ولا تقدم دليلاً عمليًا على أداء النموذج في التعامل مع تبعياتك البرمجية الخاصة، وأعرافك المتبعة، ومعايير الإصدار لديك.
ينبغي لتقييمك أن يجيب عن سؤال أكثر دقة وتحديدًا: ما هي المهام التي يمكنك إسنادها للنموذج مع إبقاء عبء المراجعة البشرية في حدود المقبول؟ وإذا كان لديك بالفعل عدة وكلاء برمجة (coding agents) يتشاركون هذا العمل، فإن منصة Sharkly توفر لك مساحة مركزية لتنظيم المهام وسياق مراجعتها بدقة.
يقترح هذا الدليل إطار عمل لتجربة منضبطة، ولا يتضمن نتائج مقارنة مسبقة.
بناء مجموعة مهام ممثلة لبيئة العمل الفعلية
التقييم المستند إلى المستودع البرمجي هو مقارنة منضبطة لآليات عمل البرمجة في مواجهة متطلبات مستمدة مباشرة من عملك التطويري الفعلي. المقياس الأساسي للنجاح هنا هو "التعديل المقبول"، بما يشمله ذلك من اختبارات ومراجعة برمجية. فمجرد تقديم تعديل ظاهري يبدو سليمًا، أو نجاح أمر تشغيل الاختبارات، أو ظهور رسالة إكمال واثقة، لا يعني بأي حال من الأحوال قبول الكود.
ابدأ باثنتي عشرة مهمة مستمدة من أعمال الصيانة البرمجية الأخيرة. هذا العدد مجرد مقترح لمرحلة تجريبية أولية وليس ضمانة إحصائية شاملة. واحرص على تضمين إصلاحات للثغرات والأخطاء، وإضافات برمجية صغيرة، وإعادة هيكلة للأكواد (refactoring)، ومهام استقصاء وتشخيص بنسب تحاكي توزيع سجل مهامك الفعلي (backlog).
اختر مهامًا تبدأ من إيداع برمجـي (commit) واضح ومعروف، مع تعيين مراجع يفهم السلوك المتوقع للكود جيدًا. تجنب حصر الاختيار في المشكلات ذات الحلول البديهية، واحرص على تضمين مهمة واحدة على الأقل تتطلب الاستجابة الصحيحة فيها طرح سؤال استيضاحي أو توضيح وجود تبعية برمجية مفقودة.
بالنسبة للمشكلات المأخوذة من سجلات سابقة، احرص على إزالة الحل من السياق المعطى للنموذج. وسجّل ما إذا كان الحل منشورًا للعامة في السابق أم لا، فقد يكون النموذج قد تدرب عليه بالفعل. واحتفظ بمجموعة منفصلة من المهام غير المنشورة لإجراء جولة تأكيدية لاحقة.
حدد معايير القبول بدقة واكتبها قبل تنفيذ أي تشغيل. فعلى سبيل المثال، عند التعامل مع مشكلة تقسيم الصفحات في الـ API (pagination)، حدد كيفية التعامل مع النتائج الفارغة، وحدود الصفحات، ومؤشرات التمرير (cursors) غير الصالحة، والتوافق مع واجهات العملاء الحالية. وحدد أيضًا النطاق المسموح به للتعديلات وعمليات التحقق الإلزامية للموافقة على التعديل.
| الفئة | مهمة توضيحية | أدلة القبول |
|---|---|---|
| إصلاح خطأ برمجي (Bug fix) | تصحيح معالجة حدود مؤشر التمرير (cursor) | اجتياز اختبار الانحدار (regression test) وكامل مجموعة الاختبارات الحالية |
| إضافة برمجية صغيرة | إضافة تصفية اختيارية للطلبات | اختبارات العقود (contract tests) مع توثيق القيم الافتراضية |
| إعادة هيكلة (Refactor) | فصل وتجميع آليات التحقق المكررة | بقاء السلوك البرمجي العام دون تغيير واجتياز المراجعة |
| استقصاء وتشخيص | تشخيص سبب انتهاء المهلة (timeout) المتقطع | إعادة إنتاج الخطأ وتقديم تفسير سببي مدعوم بالأدلة |
اعتمد على المهام الصغيرة عندما تحتاج إلى مقارنة واضحة ومباشرة، بينما استخدم المهام الأكبر حجمًا عندما يكون التنسيق والتعقيد جزءًا من التقييم، مع تقييم تلك التجربة بصورة منفصلة.
تثبيت الشروط والبيئة قبل تشغيل الوكلاء
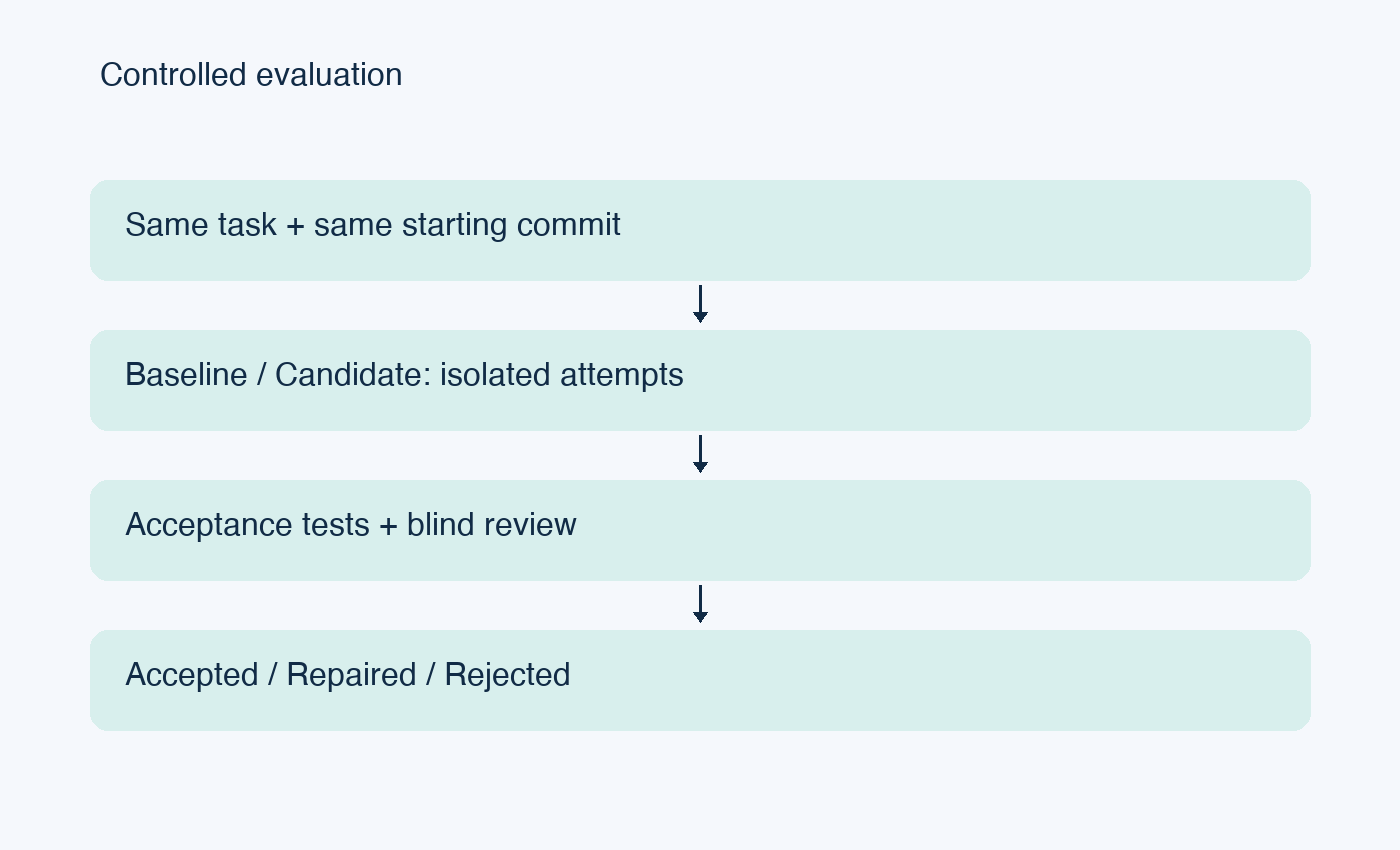
قم بتوثيق وتثبيت إيداع المستودع (commit)، ونظام التشغيل، وملفات قفل التبعيات (lockfiles)، وإصدارات الأدوات، ومعرّف النموذج، وكافة الإعدادات البرمجية. وعليك أيضًا تثبيت بيئة تشغيل الوكيل (agent harness)؛ وهي المنظومة البرمجية المسؤولة عن تزويد النموذج بالأدوات والسياق والتحكم في سلوك التنفيذ المحيط به.
قارن بين نموذج Fable 5.2 وآلية عملك الحالية. تتطلب المقارنة المباشرة بين النماذج استخدام نفس بيئة التشغيل (harness) حيثما أمكن ذلك. أما عند مقارنة آليات وسير العمل (workflows) فيمكن استخدام أدوات مختلفة، شريطة أن تتضمن النتائج النهائية تفاصيل تلك التهيئات الكاملة بدقة.
حافظ على تكافؤ الصلاحيات، وإمكانية الوصول إلى الشبكة، والسياق الأولي للمهمة، والحدود الزمنية المتاحة. حدد بوضوح ما إذا كان وقت تثبيت التبعيات يُحسب ضمن إجمالي الوقت المستغرق أم لا. ولا تسمح لأي إعداد بأن يرث ملفات معدلة من محاولة سابقة، أو ذاكرة تخزين مؤقت تحتوي على إجابات، أو سجل محادثات سابقة.
استخدم نسخة مفرغة ونظيفة من المستودع البرمجي أو مساحة عمل معزولة (isolated worktree) لكل محاولة على حدة. توضح وثائق Git حول worktree كيفية مشاركة مستودع واحد عبر مساحات عمل متعددة. وتذكر أن عزل الملفات لا يعزل قواعد البيانات أو المنافذ (ports) أو الخدمات الخارجية؛ لذا وفّر موارد اختبار منفصلة لها أيضًا.
ضع قاعدة واضحة وصريحة لأي تدخل بشري. على سبيل المثال، اسمح برد استيضاحي واحد يحتوي فقط على المعلومات المتاحة مسبقًا لجميع البيئات الخاضعة للاختبار، وسجّل بدقة الوقت المستغرق في هذا التدخل. فقيام المراجع بإصلاح الكود بهدوء في أثناء الاختبار يغير تمامًا من دقة ما تقيسه التجربة.
إجراء محاولات متوازية والاحتفاظ بنتائج الإخفاق
شغّل كل بيئة اختبارية في مواجهة نفس المهام المحددة. قم بالتبديل بين ترتيب التنفيذ حتى لا يؤدي تباطؤ مؤقت في الخدمات إلى منح أفضلية غير عادلة لأحد النماذج. كرّر المحاولات كلما سمحت الموارد بذلك، مع الالتزام بعدد مرات تكرار ثابت ومحدد قبل الاطلاع على النتائج.
كخيار عملي للمرحلة التجريبية، يمكن تطبيق ثلاث محاولات لكل بيئة على كل مهمة. تعامل مع هذا الرقم كنقطة انطلاق هندسية؛ إذ لا يمكن لعينة صغيرة أن تثبت ادعاءات قاطعة بشأن حالات الفشل النادرة أو التفوق المطلق.
احتفظ بمدخلات الأوامر (prompts)، والتكوينات، والطوابع الزمنية، وسجل المحادثة الكامل، والتعديلات البرمجية المقترحة، ومخرجات الأدوات، والقرار النهائي لكل محاولة. وسجّل حالات انتهاء المهلة والمحاولات المتروكة كجزء لا يتجزأ من النتائج؛ فاستبعادها يجعل المحاولات الناجحة تبدو أقل تكلفة وأسرع مما ستكون عليه بيئة الإنتاج الفعلية.
افصل بيانات الاختبار وبيانات الاعتماد تمامًا عن بيئة الإنتاج. اتبع أساليب الاختبار المعتمدة في مستودعك؛ وبالنسبة لمستودعات Python، توضح وثائق pytest كيفية إدارة التجهيزات الثابتة (fixtures) وتنفيذ الاختبارات، مع مراعاة أن أداة الاختبار لا تقرر بنفسها ما إذا كانت معايير القبول لديك تغطي المتطلبات بالكامل أم لا.
تقديم الدقة وصحة الكود على سرعة الإنجاز
اجعل المراجع يفحص التعديلات البرمجية دون معرفة النموذج الذي أنتجها (عمى التقييم) كلما أمكن ذلك عمليًا. استخدم نموذج تقييم ثابتًا يغطي استيفاء المتطلبات، ومخاطر حدوث تراجع في الأداء أو الوظائف (regression risk)، وقابلية الصيانة، وجودة الاختبارات، وغياب أي تعديلات خارج النطاق المطلوب.
يعد اجتياز الاختبارات شرطًا أساسيًا إذا كانت المهمة تتطلب ذلك، إلا أن الاختبارات ذاتها قد تكرس سلوكًا برمجيًا خاطئًا. تحقق من دقة شروط التحقق (assertions) ومقارنتها بالمتطلب الأصلي، وتأكد من عدم وجود فحوصات معطلة، أو هوامش سماح موسعة بصورة غير مبررة، أو أخطاء تم تجاهلها وإسكاتها، أو تعديلات تتجاوز المسار البرمجي الذي حدث فيه الإخفاق.
صنّف نتائج المراجعة إلى ثلاث حالات منفصلة: مقبول بدون تعديل، ومقبول بعد الإصلاح، ومرفوض. سجّل الدقائق المستغرقة في الإصلاح وطبيعة كل تعديل أجريته، وحدد مسبقًا ما إذا كانت التعديلات التي تطلبت تدخلًا وإصلاحًا ستُحسب ضمن معدل القبول الأساسي أم لا.
في مهام الاستقصاء والتشخيص، قم بتقييم سلسلة الأدلة المقدمة. التقرير المفيد هو الذي يحدد الملاحظات بدقة، ويفصل بين الفرضيات المختلفة، ويقدم خطوة تالية يمكن تكرارها وإعادة إنتاجها. لا تكافئ الاستنتاجات أو التشخيصات التي تُطرح بثقة مفرطة دون أدلة تدعمها.
حساب التكلفة لكل تعديل مقبول
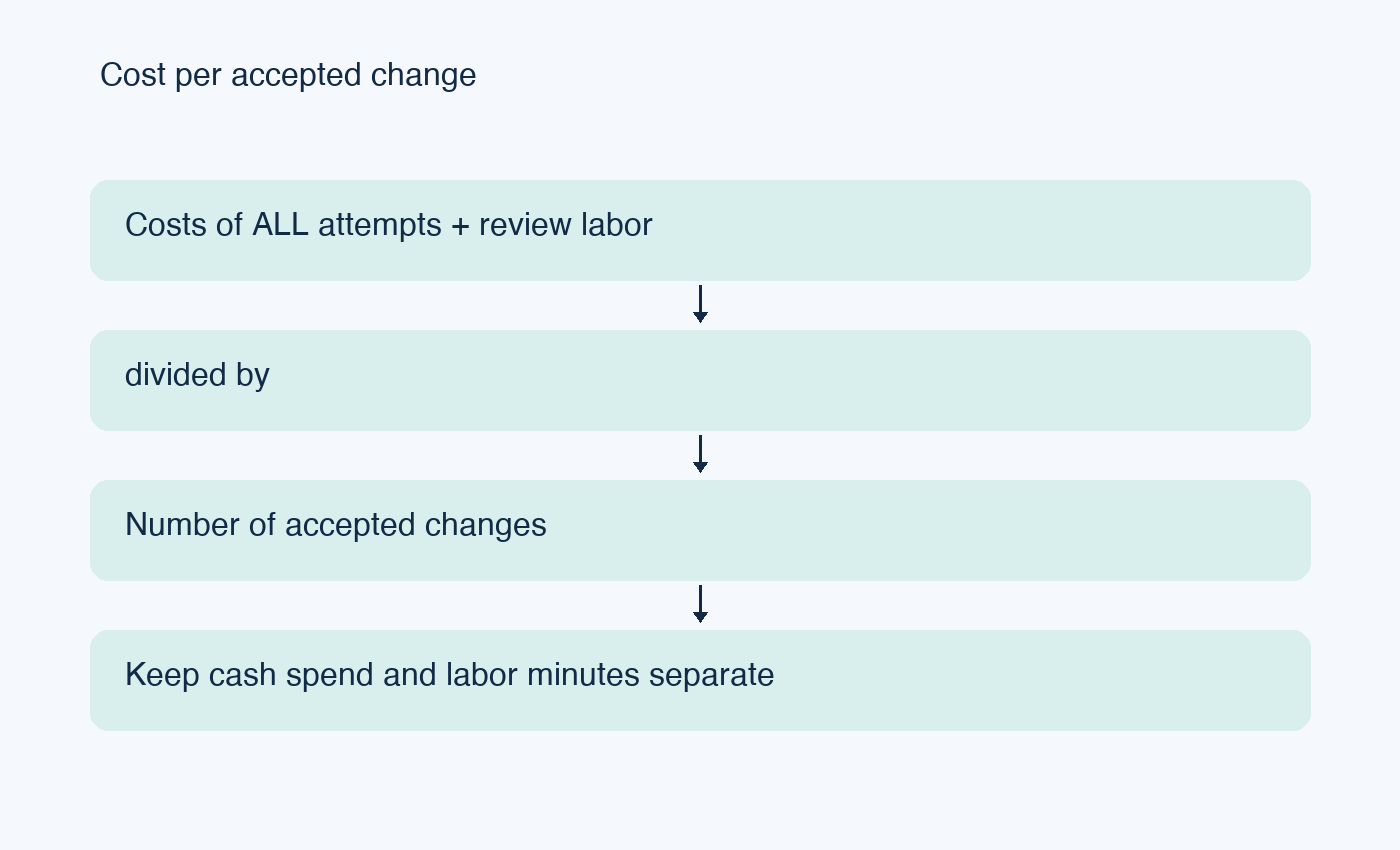
يتم حساب تكلفة التعديل المقبول الواحد بقسمة إجمالي تكلفة التقييم على عدد التعديلات التي تم قبولها وفقًا لقاعدتك المحددة مسبقًا. تأكد من تضمين المحاولات الفاشلة في بسط المعادلة. وإذا لم يتم قبول أي تعديل، فاذكر التكلفة وسجّل صفرًا في خانة القبول، حيث لا يكون للنسبة في هذه الحالة قيمة رياضية محددة.
تتبّع المقاييس التالية معًا بشكل متكامل:
- معدل القبول مصنفًا حسب فئة المهمة.
- الوقت الزمني الإجمالي المنقضي من بدء المهمة وحتى تجهيز المخرجات للمراجعة.
- الوقت البشري (بالدقائق) المستغرق في المراجعة والإصلاح.
- تكاليف استهلاك النموذج ورسوم الأدوات لكافة المحاولات.
- تكاليف البنية التحتية كلما كانت مؤثرة.
- أي تراجعات أو أخطاء تكتشف لاحقًا خلال فترة المراقبة والمتابعة.
سجّل استهلاك الرموز (tokens) ومصدر الأسعار وتاريخها إلى جانب المبالغ المفوترة. فالرموز المخزنة مؤقتًا (cached tokens)، وإعادة المحاولة، وأدوات التنفيذ تؤثر جميعها في التكاليف، لذا لا تكتفِ بتقدير الفاتورة بناءً على طول النص المُخرج وحده.
إذا خصصت سعرًا ماليًا مقدرًا لوقت المراجع البشري، فوضّح أنه افتراض داخلي ضمن التقرير. وافصل دائمًا بين الإنفاق المالي المباشر والدقائق المستغرقة في العمل البشري لتمكين القراء من إعادة تقييم المقارنة بأنفسهم؛ فقد يكون التوليد البرمجي الأرخص تكلفة في استهلاك الرموز هو نفسه الذي يتطلب وقتًا وانتباهًا هندسيًا أكبر.
ربط أدلة التقييم بسجل العمل مباشرة
تتولى منصة Sharkly إدارة وتنسيق المهام المحيطة بوكلاء البرمجة. يربط سير العمل الموثق فيها بين المهام (Tasks)، والوكلاء (Agents)، وأجهزة الحاسوب (Computers)، وسياق التنفيذ، والمراجعة البشرية. راجع وثائق Sharkly للاطلاع على المصطلحات المحدثة للمنتج وخطوات الإعداد.
في هذه التجربة، ضع معايير القبول داخل كل مهمة (Task)، وأعد التعديل البرمجي (patch)، وأدلة الاختبارات، والنتيجة النهائية إلى نفس سجل العمل. واحتفظ بسجل التقييم في جدول بيانات أو في ملف بيانات يخضع لإدارة النسخ (versioned data file) إذا كان ذلك أيسر في التحليل. لا تفترض أن المنصة ستحسب مقاييسك التجريبية المخصصة تلقائيًا.
استعن بوكيل واحد (Single Agent) لتنفيذ تجربة محددة النطاق، ولا تلجأ إلى استخدام فريق من الوكلاء (Crew) إلا إذا كان التنسيق والتكامل بين الوكلاء بحد ذاته جزءًا خاضعًا للتقييم، فتغيير هيكل الفريق في منتصف التجربة يضيف متغيرًا جديدًا يعقد النتائج.
يقوم الوكلاء بالتنفيذ وتقديم الأدلة، بينما يحدد البشر معايير القبول ويفحصون التعديلات ويصرحون بالإطلاق والاعتماد. ويظل هذا الفصل في الأدوار ضروريًا وفعالاً حتى لو اجتاز الكود كافة الفحوصات المؤتمتة بنجاح.
اتخاذ قرار الاعتماد وفقًا لتصنيف كل مهمة
حدد معايير وقواعد الاعتماد بوضوح قبل الاطلاع على النتائج. اجعل تحقيق مستوى الدقة المقبول شرطًا أوليًا، ثم قارن بين التكلفة والوقت المنقضي بين التهيئات التي استوفت هذا المعيار. واستبعد الفئات الحساسة أمنيًا أو التي تفتقر إلى تغطية اختبارية كافية من مراحل الإطلاق الأولى.
اعرض الأرقام الفعلية جنبًا إلى جنب مع النسب المئوية؛ فقبول مهمتين من أصل ثلاث يعكس دلالة مختلفة تمامًا عن قبول مائتي مهمة من أصل ثلاثمائة. وركّز على توضيح هوامش عدم اليقين وأنماط الإخفاق المتكررة بدلاً من الإعلان عن فائز مطلق لكل الاستخدامات.
أعد إجراء التقييم بعد إدخال أي تعديلات جوهرية على مدخلات التوجيه (prompts)، أو بيئات التشغيل، أو إصدارات النماذج، أو هيكل المستودع البرمجي. واحتفظ بالتكوين القديم ليكون بمثابة خط أساس موثوق وقابل للتكرار لقياس أي تحسينات لاحقة.
ابدأ بمهمة صيانة واحدة ممثلة لطبيعة عملك داخل منصة Sharkly، وأرفق بها معايير قبول واضحة وصريحة، وقارن الأدلة المسترجعة مع آلية عملك الحالية. ولا تتوسع في الاعتماد إلا بعد أن تصبح قادرًا على تفسير أسباب النجاح وأسباب الفشل على حد سواء.
الأسئلة الشائعة
هل يمكن للاختبارات المعيارية العامة لتقييم البرمجة أن تغني عن هذا التقييم؟
يمكنها أن تساعدك في تصفية واختيار النماذج المرشحة، لكنها لا تغطي أعراف مستودعك البرمجي، أو تبعياته، أو توقعات المراجعة، أو القيود التشغيلية الخاصة ببيئتك.
هل يجب استخدام توجيهات (prompts) متطابقة تمامًا في كل محاولة؟
استخدم معلومات متكافئة للمهام مع الالتزام بسياسة توجيه محددة مسبقًا، وقم بتوثيق التعديلات البرمجية الخاصة بكل أداة حتى تظل الفروق بينها قابلة للفحص والمراجعة.
هل تُحتسب التعديلات التي خضعت للإصلاح نجاحًا؟
حدد هذه القاعدة مسبقًا. ويُفضل تسجيل التعديلات المقبولة بعد الإصلاح وتلك المقبولة دون تغيير كلٍ على حدة، مع تضمين الوقت المستغرق في الإصلاح عند مقارنة مسارات العمل.
كيف يتم احتساب حالات انتهاء المهلة (Timeouts) في التقييم؟
تُعامل كحالات إخفاق ضمن الميزانية الزمنية المحددة، ويجب تضمين تكلفتها والوقت المستغرق فيها ضمن النتائج الإجمالية.
متى يحين الوقت لتوسيع نطاق الاعتماد وتطبيقه؟
يمكنك التوسع عندما تستوفي فئة معينة من المهام قواعد القبول الموضوعة عبر جولات تجريبية متكررة، وعندما يستوعب المراجعون أنماط الإخفاق المتكررة الخاصة بها جيدًا.
مصادر إضافية
اطّلع على وثائق Git للتعرف على آليات عزل المستودعات البرمجية، ودليل تجهيزات pytest (fixtures) لضبط بيئة الاختبارات، ومنصة Sharkly لتنظيم عمل وكلاء البرمجة وإدارته بالتكامل مع المراجعة البشرية.