
الخلاصة السريعة: حدود معدل الطلبات في GPT-6.2 متطابقة لكل من Astra وSol في واجهة API: 5,000 طلب في الدقيقة (RPM) و1,000,000 رمز في الدقيقة (TPM) على مستوى Build، و10,000 RPM و4,000,000 TPM على Launch، و15,000 RPM و40,000,000 TPM على Grow. تنطبق الحدود على مستوى المؤسسة وعلى مستوى المشروع، ما يعني أن جميع الوكلاء على المفتاح نفسه يتشاركونها. لفرق الوكلاء، الرموز في الدقيقة هي ما ينفد أولًا، وليس الطلبات.
أطلقت OpenAI كلاً من GPT-6.2 Astra وGPT-6.2 Sol في 17 نوفمبر 2026. Astra هو النموذج الطليعي لأصعب المهام؛ أما Sol فهو النموذج اليومي الأرخص، وقد صُمم من أجل "تشغيل الوكلاء على نطاق واسع" بتعبير OpenAI نفسها.
نادرًا ما يصل وكيل واحد إلى الحد. أما ستة وكلاء على مفتاح API واحد فيصلونه قبل الغداء. يغطي هذا الدليل حدود معدل الطلبات في GPT-6.2، وسقوف خطط Codex، وكيفية ضبط حجم فريق الوكلاء بحيث تتراكم المهام في طابور بدلًا من الفشل. إذا كنت تشغّل عدة وكلاء برمجة بالفعل، فإن Sharkly هو المكان الذي تحدد فيه عدد الوكلاء الذين يعملون في وقت واحد.
حدود معدل الطلبات في GPT-6.2 حسب مستوى الاستخدام
يتشارك GPT-6.2 Astra وGPT-6.2 Sol جدول حدود معدل واحدًا قياسيًا في صفحة نموذج Sol وصفحة نموذج Astra لدى OpenAI. يعني RPM عدد الطلبات في الدقيقة، بينما يعني TPM عدد الرموز في الدقيقة. وأيّهما تنفد أولًا هو ما يوقفك.
| المستوى | التأهل عند (إجمالي مشتريات الرصيد) | حد الاستخدام الشهري | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5,000 | 1,000,000 |
| Launch | $100 | $5,000 | 10,000 | 4,000,000 |
| Grow | $500 | $200,000 | 15,000 | 40,000,000 |
عمودا التأهل والاستخدام الشهري مأخوذان من دليل حدود المعدل لدى OpenAI. تتم ترقية مستواك تلقائيًا عند تجاوز إجمالي مشتريات الرصيد كل حد من هذه الحدود. وحد الاستخدام الشهري سقف منفصل عن حدود الإنفاق التي تحددها بنفسك.
تكلفة Astra أربعة أضعاف تكلفة Sol للرمز الواحد (8 دولارات للإدخال و40 دولارًا للإخراج لكل مليون، مقابل دولارين و10 دولارات لـ Sol)، لكن حد المعدل نفسه. ما ستصل إليه يعتمد على عدد الرموز التي يدفعها وكلاؤك.
كيف تعمل سقوف استخدام GPT-6.2 في Codex
إذا كان وكلاؤك يعملون عبر Codex ضمن خطة ChatGPT بدلًا من مفتاح API، ينطبق سقف مختلف. تعرض صفحة تسعير Codex لدى OpenAI الرسائل المحلية لكل نافذة زمنية من خمس ساعات كنطاقات، لأن حجم المهمة يغيّر تكلفة كل رسالة.
| النموذج | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6 إلى 50 | 6 إلى 50 |
| GPT-6.2 Sol | 17 إلى 180 | 17 إلى 180 |
| GPT-6.1 Sol | 15 إلى 160 | 15 إلى 160 |
| GPT-6 Astra | 5 إلى 45 | 5 إلى 45 |
أربعة تفاصيل تهم فرق الوكلاء:
- خطط Pro لا تملك حدًا خماسي الساعات حاليًا، لكن قد تنطبق حدود أسبوعية.
- الرسائل المحلية والمحادثات السحابية تتشارك حصة واحدة. يمكن أن تستهلك المهمة السحابية منها أكثر من الرسالة المحلية.
- السرعة تكلّف من الحصة. يستهلك الوضع السريع (Fast) ضعفي الاستخدام المشمول على نماذج GPT-6.2؛ أما Ultrafast فيستهلك ستة أضعاف.
- الجلسات الطويلة تكلّف أكثر لكل رسالة. تقول OpenAI إن المهام التي تحتفظ بسياق أكبر تستهلك "قدرًا أكبر بكثير" من الحصة.
الوكيل الذي قرأ نصف مستودع برمجي يرسل سياقًا ضخمًا في كل دورة، فينخفض عدد رسائله بسرعة. غطّينا النمط نفسه لخطط Anthropic في مقال حدود استخدام Claude Code، ويتبع الرد على تخفيض حد Codex Pro المنطق ذاته.
لماذا TPM وليس RPM هو ما يحدّ فريق الوكلاء
وكيل البرمجة لا يرسل آلاف الطلبات الصغيرة، بل يرسل طلبات قليلة ضخمة. في كل دورة يعيد إرسال المحادثة حتى تلك اللحظة: التعليمات، والملفات التي قرأها، ومخرجات الأدوات، واستدلالاته السابقة.
لنأخذ وكيلًا توضيحيًا: 80,000 رمز إدخال لكل دورة و6 دورات في الدقيقة. أي 6 RPM وحوالي 480,000 TPM. مقابل مستوى Build:
- RPM: تم استخدام 6 من أصل 5,000. غير قريب من الحد.
- TPM: تم استخدام 480,000 من أصل 1,000,000. وكيلان يملآنه.
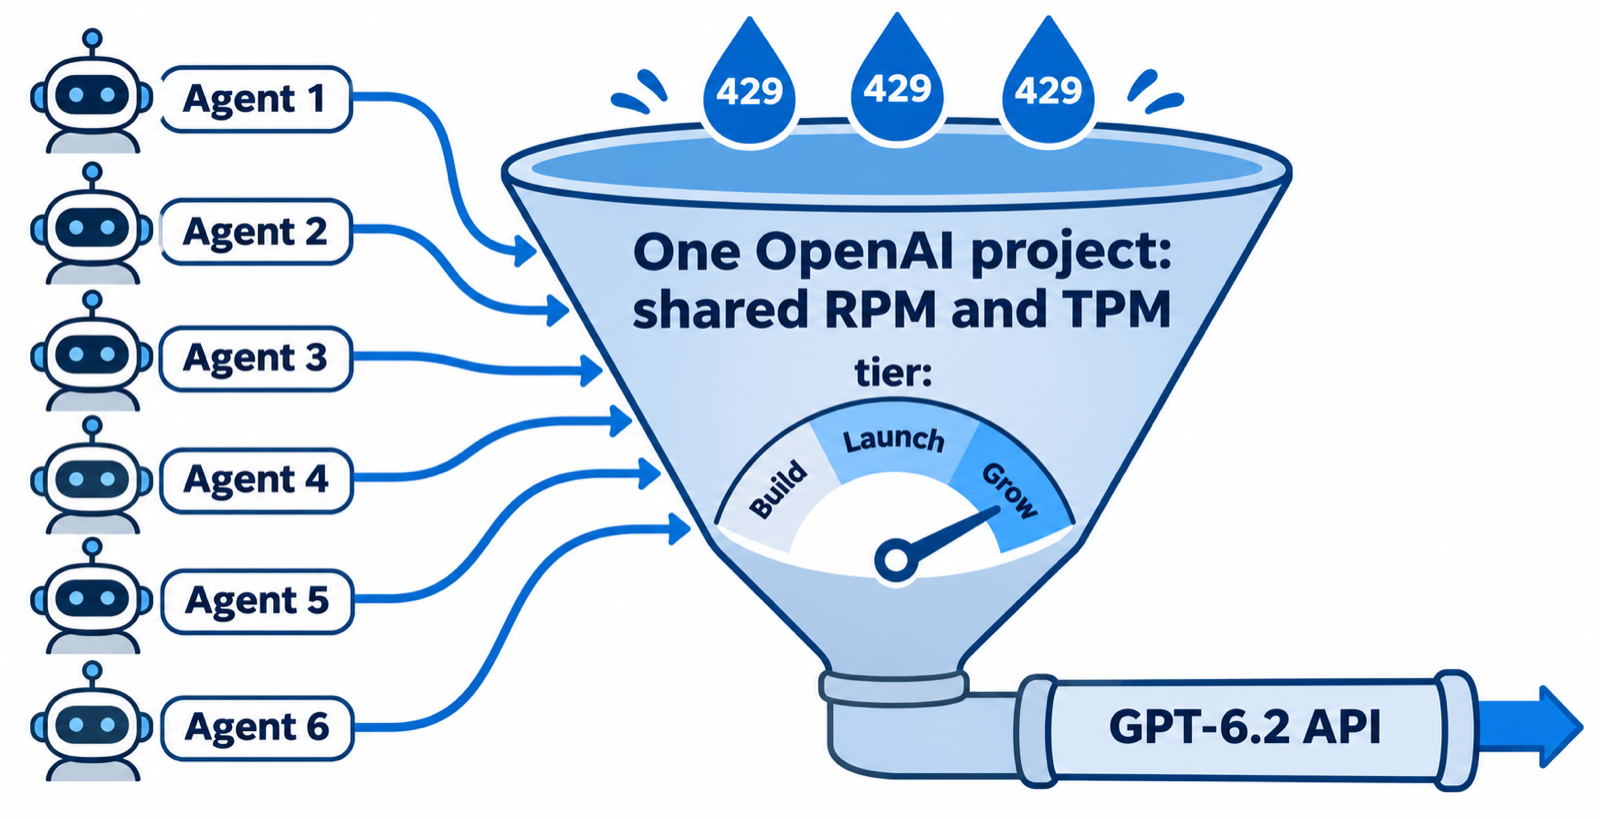
ستختلف أرقامك؛ لكن النسبة لن تتغير. الوكلاء ثقيلو الرموز وخفيفو الطلبات. لهذا الوكيل التوضيحي، السقف الخام هو وكيلان لكل مشروع على Build وثمانية على Launch. وعند الاحتفاظ بهامش أمان 30 بالمئة من خطوات ضبط الحجم أدناه، ينخفض إلى وكيل واحد على Build وخمسة على Launch. أما على Grow، فلن يكون حد المعدل هو عنق الزجاجة، بل يتولى الدور سقف الـ200,000 دولار الشهري أو ميزانيتك الخاصة.
الحدود مشتركة على مستوى المؤسسة
تحدد OpenAI حدود المعدل على مستوى المؤسسة وعلى مستوى المشروع، لا على مستوى المستخدم. كل وكيل يستخدم مفاتيح من مشروع واحد يسحب من الحصة نفسها. وتتمتع بعض عائلات النماذج أيضًا بحد مشترك معروض في صفحة الحدود لديك، بحيث يمكن أن يُحسب التوجه إلى نموذج ما مقابل نموذج آخر.
كيف تضبط تزامن الوكلاء على مستوى GPT-6.2 لديك
الحل هو تحديد سقف لعدد الوكلاء الذين يعملون في وقت واحد، بحيث تنتظر المهام الإضافية في طابور بدلًا من الاصطدام عند الـAPI. إليك الترتيب الذي يعمل:
- حدّد مستواك من الإعدادات ثم المؤسسة ثم الحدود على منصة OpenAI.
- قِس تشغيلًا حقيقيًا لوكيل واحد. سجّل رموز الإدخال لكل دورة وعدد الدورات في الدقيقة من مخرجات الاستخدام في بيئة التشغيل لديك.
- اقسم TPM الخاص بك على TPM الوكيل الواحد واحتفظ بهامش 30 بالمئة للذروات.
- اجعل ذلك الرقم سقف التزامن لكل وكيل يعتمد على المشروع.
- راقب أخطاء 429 لأسبوع، ثم ارفع السقف درجة واحدة في كل مرة.
في Sharkly، لكل وكيل إعداد الحد الأقصى للتزامن (المهام الموكلة)، والمدة القصوى للتشغيل بالدقائق، ومهلة الطابور بالساعات. عند امتلاء السقف، تنتظر المهام الجديدة في حالة "في الطابور" حتى يتفرغ مكان. ويمكن للمحادثات أن تتشارك الحد نفسه، فلا تتسلل محادثة خارج السقف.

ولجهاز الكمبيوتر (Computer) حد خاص لتزامن المهام أيضًا. تذكر وثائق Sharkly أن التزامن الأعلى يستهلك المزيد من المعالج والذاكرة والقرص وسعة المزوّد وعرض نطاق المستودع، لذا ارفعه فقط بعد أن يعمل الحمل الحالي بسلاسة.
وزّع الوكلاء على مشاريع OpenAI متعددة
تتيح لك الحدود على مستوى المشروع عزل مجموعات الوكلاء. امنح وكلاء المراجعة مشروع OpenAI واحدًا، ووكلاء إعادة الهيكلة الجماعية مشروعًا آخر. عندها يصطدم إعادة الهيكلة الجارفة بحد مشروعه هو بدل أن يجوّع المراجعة. يظل حد المؤسسة يسقّف الإجمالي، لذا فهذا يضبط الأولويات ولا يضيف سعة.
بالنسبة لبيئة تشغيل تستخدم مفتاح API للمصادقة، اجعل المفتاح متغير بيئة على الوكيل. يحقن Sharkly متغيرات بيئة الوكيل في عملية الوكيل عند بدء التشغيل. امنح كل مجموعة وكلاء مفتاحًا من مشروع OpenAI الخاص بها، ليسقط ترددها على الحد الصحيح.
راقب الرموز لكل مهمة
يعرض ترويسة الوكيل في Sharkly المهام الموكلة، وإجمالي التشغيلات، والرموز المستخدمة. اقرأ الرموز لكل مهمة، لا الإجمالي الشهري فقط. نوع المهمة الذي يحرق ثلاثة أضعاف رموز البقية هو أول مرشّح للتحول إلى Sol بدل Astra، أو لوصف مهمة أكثر إحكامًا.
انقل العمل الجماعي خارج أوقات الذروة
تتضمن إعدادات بيئة التشغيل لكل وكيل مفتاح ساعات العمل لجدولة العمل خارج الذروة. وجّهه نحو توليد الاختبارات، وترقية الاعتماديات، ومراجعات التوثيق. تلك المهام تعمل ليلًا وتترك سعة النهار للعمل الذي ينتظره الناس.
كيف تتعامل مع خطأ 429 في GPT-6.2
حتى مع وجود سقف، ستشاهد أحيانًا خطأ 429. دليل OpenAI محدد بشأن ما ينبغي فعله:
- اتبع ترويسة
Retry-Afterعند وجودها، واعتبرها حدًا أدنى. - بدونها، استخدم التراجع الأسي مع اهتزاز عشوائي (jitter).
- اقرأ
x-ratelimit-remaining-tokensوx-ratelimit-reset-tokensلترى مدى قربك من الحد. - لا تداخل إعادة المحاولات: إذا كان كودك يعيد المحاولة، فأوقف إعادة المحاولة المدمجة في الـSDK، وإلا فسيتضاعف الاثنان.
- لا تعد المحاولة عند أخطاء الحصة أو الفوترة. فهذه تحتاج إلى إنسان.
خطأ 503 مع server_is_overloaded يعني أن النموذج مشغول، لا أنت. تعامل معه بالتراجع الأسي نفسه.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra أم Sol: أي نموذج يمدّ حدودك أبعد
حدود المعدل متطابقة، لذا يتوقف الاختيار على استهلاك الرموز والسعر. استخدم Astra لتغييرات البنية، والأخطاء الصعبة، والتشغيلات المستقلة الطويلة. واستخدم Sol لكل شيء روتيني. في Codex على خطة Plus، يحصل Sol على حوالي ثلاثة أضعاف الرسائل لكل نافذة خماسي الساعات مقارنة بـ Astra، وهي أوضح إشارة على فجوة التكلفة.
الفريق المختلط هو الحل المعتاد: وكيل Astra واحد يقود، وعدة وكلاء Sol يؤدون الأجزاء، كما في مقال GPT-6 Astra كقائد لفريقك. العمل الروتيني يخص نموذجًا أرخص، وهو المنطق وراء GPT-6 Luna للثمانين بالمئة المملة.
طرق أخرى لزيادة إنتاجية GPT-6.2
- Batch API. تعمل خارج حدود المعدل المتزامنة لديك وتكلّف 50 بالمئة من الأسعار القياسية. مناسبة للتقييمات والتصنيف الجماعي؛ وغير مناسبة للوكيل التفاعلي.
- الوضع الخلفي بنافذة
2hأو8h. يُحسب ضمن حد طابور Batch/Background منفصل بدل TPM المباشر لديك. - تخزين التلميحات مؤقتًا (Prompt caching). تكلفة الإدخال المخزَّن 0.40 دولار لكل مليون على Astra و0.10 دولار على Sol، وهو توفير كبير للوكلاء الذين يعيدون إرسال السياق نفسه.
الخلاصة
حدود GPT-6.2 سخية لكل طلب وضيقة لكل رمز. لفريق من الوكلاء، الحد الفعلي هو TPM مستواك مقسومًا على ما يحرقه وكيل واحد، مشتركًا بين كل الوكلاء على المشروع. قِس تشغيلًا واحدًا، وضع سقف التزامن تحت ذلك الرقم، وزّع مجموعات الوكلاء الصاخبة على مشاريعها الخاصة، ودَع الطابور يمتص الباقي.
يمكنك بناء ذلك بسكربتات ومِخدود إشارة (semaphore)، أو ضبطه لكل وكيل في Sharkly. اربط جهاز كمبيوتر واحدًا، وأنشئ وكيلًا واحدًا على Codex بنموذج GPT-6.2 Sol، واضبط حد تزامنه على 2، ووكّله شيئًا مملًا. المزيد عن تشغيل الوكلاء جنبًا إلى جنب في مقال كيفية تشغيل 10 وكلاء برمجة بالذكاء الاصطناعي في وقت واحد.
الأسئلة الشائعة
ما هي حدود معدل الطلبات في GPT-6.2؟
في الـAPI، يتشارك GPT-6.2 Astra وSol الحدود نفسها: 5,000 RPM و1,000,000 TPM على Build، و10,000 RPM و4,000,000 TPM على Launch، و15,000 RPM و40,000,000 TPM على Grow.
هل حدود معدل GPT-6.2 Astra أقل من Sol؟
لا. تسرد OpenAI نفس RPM وTPM لكلا النموذجين في كل مستوى. تكلفة Astra أعلى لكل رمز، لذا يصطدم بميزانيتك أسرع، لا بحد المعدل.
كيف أنتقل إلى مستوى استخدام أعلى لدى OpenAI؟
تتم ترقية المستويات تلقائيًا حسب إجمالي مشتريات الرصيد: 5 دولارات لـ Build، و100 دولار لـ Launch، و500 دولار لـ Grow.
هل حدود المعدل لكل مفتاح API أم لكل مؤسسة؟
لكل مؤسسة ولكل مشروع. كل مفتاح في المشروع يسحب من الحصة نفسها، لذا يظل عشرة وكلاء على عشرة مفاتيح في مشروع واحد يتشاركون حدًا واحدًا.
كم رسالة GPT-6.2 Astra أحصل عليها في Codex؟
على Plus وStandard Business، تقدّر OpenAI من 6 إلى 50 رسالة محلية لكل نافذة خماسي الساعات لـ GPT-6.2 Astra، ومن 17 إلى 180 لـ Sol. خطط Pro لا تملك حاليًا حدًا خماسي الساعات، مع أنه قد تنطبق حدود أسبوعية.
لماذا يصطدم وكلائي بأخطاء 429 بينما يبدو RPM جيدًا؟
يرسل الوكلاء سياقات ضخمة، لذا يستنفدون الرموز في الدقيقة قبل الطلبات في الدقيقة بفترة طويلة. تحقق من x-ratelimit-remaining-tokens في ترويسات الاستجابة.
هل يضيف Sharkly حدودًا خاصة به للنماذج؟
لا. يشغّل Sharkly وكلاء البرمجة الذين تستخدمهم بالفعل، وتعتمد حصة النموذج على الأدوات والخطط وحسابات الـAPI التي يربطها فريقك. يتحكم Sharkly في عدد المهام التي يديرها كل وكيل في وقت واحد.