باختصار: يُعد GPT-6 Cyber إصدارًا مخصصًا للأمان من نموذج GPT-6 Astra طوّرته OpenAI وأطلقته في 5 نوفمبر 2026. يتطلب الوصول إليه اشتراك Daybreak Red بالإضافة إلى موافقة منفصلة على النموذج، ويبلغ سعره المعلن 20 دولارًا لكل مليون رمز إدخال (tokens). من الأفضل لمعظم الفرق إجراء المراجعة والفرز الأولي عبر النماذج الأساسية، ثم تخصيص GPT-6 Cyber لإثبات النتائج عالية الخطورة على الأنظمة المملوكة لها فقط.
يُغيّر GPT-6 Cyber الخطوة الأخيرة من المراجعة الأمنية وليس الخطوة الأولى. يشير إعلان OpenAI إلى اكتشاف 81 ثغرة أمنية جديدة عالية الخطورة في متصفح Firefox، وتوفير ثغرات استغلال جاهزة للعمل لـ 948 خطأ برمجياً في نواة Linux. قد يبدو هذا كنموذج ترغب في دمجه في كل وكيل ذكاء اصطناعي تستخدمه.
لكن شروط الوصول تقول عكس ذلك تمامًا؛ فعلى الأرجح لن تتمكن من استخدامه اليوم، وتكمن الفائدة الحقيقية في هذا الإصدار داخل بطاقة أمان النظام (system card): حيث توضح الحالات التي يلتزم فيها النموذج بالنطاق المحدد، والحالات التي قد تُسقط فيها تقاريره بعض التفاصيل المهمة.
يوضح هذا الدليل المؤهلين للحصول على حق الوصول، وتكلفة الاستخدام، وكيفية توجيه المهام الأمنية عبر مختلف فئات النماذج، والجوانب التي ينبغي للمراجعين التحقق منها. وإذا كنت تدير بالفعل عدة وكلاء، توفر لك منصة Sharkly واجهة موحدة لإدارة مهامهم ومتابعة نتائجهم.
ما هو GPT-6 Cyber؟
يُعد GPT-6 Cyber إصدارًا متخصصًا في الأمن السيبراني من نموذج GPT-6 Astra، مُصممًا خصيصًا للأعمال الأمنية المصرح بها: مثل اكتشاف الثغرات، وتطوير برمجيات الاستغلال (exploits)، واختبار اختراق تطبيقات الويب. خضع النموذج لتدريب لاحق من OpenAI لتقليل رفض الطلبات المصرح بها مع الالتزام التام بالنطاق المحدد. وقد صنفته الشركة على أنه "حرج" (Critical) للأمن السيبراني وفقًا لإطار الجاهزية (Preparedness Framework) الخاص بها.
هذا النموذج ليس وكيلاً برمجيًا عامًا أكثر كفاءة؛ ففي اختبار ExpertSWE —وهو اختبار داخلي لدى OpenAI للمهام البرمجية الطويلة— حقق النموذج 82.95% مقارنة بـ 83.24% لنموذج Astra. لذا، احتفظ بـ بيئة التشغيل الافتراضية لتطوير الميزات والخصائص البرمجية.
من يحق له الوصول إلى GPT-6 Cyber؟
تخضع إمكانية الوصول للموافقة الأمنية وليس للميزانية المتوفرة؛ إذ تؤكد صفحة مساعدة Daybreak لدى OpenAI أن إبرام اتفاقية تجارية أو الشراء بمفرده لا يضمن الحصول على حق الوصول.
| مستوى الوصول | النماذج | نطاق العمل المستهدف |
|---|---|---|
| Standard | النماذج الأساسية، بما فيها Astra، مع آليات الحماية القياسية | نمذجة التهديدات، المراجعة الأمنية للكود، إعداد التحديثات والإصلاحات البرمجية |
| Daybreak Blue | انخفاض معدلات الرفض على نماذج مثل GPT-6 Sol وGPT-6 Luna؛ مع احتفاظ Astra بإجراءات الحماية القياسية | فرز الثغرات وتصنيفها، تحليل البرمجيات الخبيثة، الاستجابة للحوادث، التحقق من الإصلاحات البرمجية |
| Daybreak Red | GPT-5.6 Cyber، مع انخفاض معدلات الرفض على النماذج بما فيها Astra | اختبار الاختراق، محاكاة الهجمات (Red Teaming)، التحقق من برمجيات الاستغلال |
| Red مع الموافقة على GPT-6 Cyber | gpt-6-cyber عبر واجهة برمجة التطبيقات وCodex |
نفس المهام المذكورة، ولكن باستخدام GPT-6 Cyber |
توجد ثلاث تفاصيل تغفل عنها الكثير من الفرق:
- مستوى Red لا يكفي بمفرده: يحتاج GPT-6 Cyber إلى موافقة خاصة ومستقلة. وهو متاح حاليًا لمجموعة محدودة ومختارة من عملاء Red، وتفيد OpenAI بأن جميع عملاء هذا المستوى سيحصلون عليه "قريبًا".
- لا مسار للأفراد: لا يمكن التقديم لمستوى Red إلا كجهة تجارية أو مؤسسة معتمدة؛ بينما يمكن للمتقدمين الأفراد طلب مستوى Blue فقط.
- كل الميزات معطلة افتراضيًا: بعد الحصول على الموافقة، يتعين على المسؤول تفعيل Daybreak لمستخدمين أو مشاريع بعينها. كما تتطلب عمليات التشغيل الذاتية لأداة Codex CLI تفعيل الخيار
daybreak=trueعلى الجهاز المضيف الذي يشغّلها.
يُشترط أيضًا على المؤسسات توفير تسجيل الدخول الموحد (SSO)، والمصادقة متعددة العوامل (MFA)، والأجهزة المُدارة، وتطبيق مبدأ الحد الأدنى من الصلاحيات. ويتطلب استخدام واجهة برمجة التطبيقات وجود قائمة بيضاء لعناوين IP (IP allowlist) افتراضيًا.
كم تبلغ تكلفة GPT-6 Cyber؟
هذه هي أسعار واجهة برمجة التطبيقات القياسية للسياق القصير من OpenAI لكل مليون رمز (token)، كما وردت في 6 نوفمبر 2026:
| النموذج | الإدخال | الإخراج | متطلبات تقليل الرفض |
|---|---|---|---|
gpt-6-luna |
$0.10 | $0.50 | Daybreak Blue |
gpt-6.1-sol |
$2.00 | $10.00 | Daybreak Red |
gpt-6-astra |
$10.00 | $50.00 | Daybreak Red |
gpt-6-cyber |
$20.00 | $100.00 | مستوى Red مع الموافقة على النموذج |
من حيث تكلفة الرمز، يعادل هذا ضعف سعر Astra و200 ضعف سعر Luna. ولتوضيح حجم التكلفة، بلغت نفقات حملة فحص Linux التي أسفرت عن 948 ثغرة استغلال قرابة 1.2 مليون دولار من أرصدة واجهة برمجة التطبيقات، وهو رقم اعتبرته OpenAI أقرب إلى الحد الأقصى. لذلك، لا توجّه نموذجك الأعلى تكلفة لفحص كل ملف برمجي لديك.
بالنسبة للمؤسسات الدفاعية محدودة الموارد، كالجهات الحكومية ومقدمي الخدمات الحيوية، يمكنهم الاستفادة من برنامج المنح التابع لـ OpenAI بقيمة مليار دولار، والذي يدعم تكاليف الوصول.
أين تكمن القيمة الحقيقية لـ GPT-6 Cyber؟
قارنه بنموذج Astra، وليس فقط بالنماذج الأقدم. فيما يلي أرقام OpenAI ما لم يُذكر خلاف ذلك:
| الاختبار | ما يقيسه الاختبار | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| SEC-Bench Pro | اكتشاف الأخطاء البرمجية في محركات JavaScript | 87.02% | 85.38% |
| Web pentest | استرجاع وتحديد ثغرات الويب | 40.3% | 32.0% |
| ExploitGym | استغلال خطأ برمجي محدد | 48.5% | 42.4% |
| RemoteExploitBench | الاستغلال عن بُعد للثغرات المعروفة | 95% تم إنجازها | 100% تم رفضها تحت مستوى Blue |
| FrontierCyber (Irregular) | برمجيات وأجهزة حقيقية | 90 من 288 | 96 من 288 |
فيما يتعلق باكتشاف الأخطاء البرمجية، فإن التحسن مقارنة بـ Astra يُعد طفيفًا. وقد أظهر التقييم الخارجي الذي أجرته منصة Irregular تفوق Astra بنسبة بسيطة في FrontierCyber، مقابل تقدم GPT-6 Cyber في السيناريوهات طويلة المدى، مع عدم تسجيل أي هجمات ناجحة على أهداف محصنة بالكامل. يكمن الفارق الجوهري في الصلاحيات الممنوحة: فنموذج GPT-6 Cyber ينفّذ مهام الاستغلال التي يرفض Astra القيام بها تحت مظلة Blue.
وهذا ما تؤكده OpenAI صراحةً بقولها إن النماذج الأساسية "تدعم بالفعل مراجعة الكود، وفرز الثغرات، وتطوير الإصلاحات". وتتوافق الإنجازات الواقعية تمامًا مع هذا التقسيم؛ فالنتائج الخاصة بمؤسسة Mozilla قُدّمت بأدلة واختبارات قابلة للتكرار، كما أظهرت الحملة ذاتها أن 30 مشكلة معروفة كانت أشد خطورة مما ورد في التقارير السابقة. إن إثبات درجة الخطورة بدقة هو القيمة الفعلية التي تدفع مقابلها.
كيفية توزيع المهام الأمنية بين وكلاء الذكاء الاصطناعي
وجّه المهام بناءً على توفر الأدلة، بحيث لا تتلقى كل فئة إلا المهام التي تعذّر على الفئات الأقل تكلفة حسمها. ويمثل هذا التوزيع توصيتنا الخاصة وليس قاعدة إلزامية من OpenAI:
- الفحص عبر نموذج أساسي: يقوم الوكلاء بمراجعة فروق التعليمات البرمجية (diffs) ونقاط الدخول العامة، ثم تسجيل النتائج المرشحة.
- الفرز تحت مظلة Daybreak Blue: كتابة اختبار فاشل يثبت الخلل، واستبعاد التكرارات، وتقييم كل نتيجة وفقًا لحدود الثقة (trust boundary) التي تخترقها.
- التصعيد وفق قواعد محددة: لا يتم تصعيد النتيجة إلا إذا أمكن إعادة إنتاجها، وكانت تخترق حدود الثقة، وتتوقف درجة خطورتها على إمكانية استغلالها.
- الإثبات في بيئة معزولة: يتحقق GPT-6 Cyber من مسار الاستغلال في بيئة مؤقتة ذات أهداف محددة بالاسم.
- الترقيع ثم مهاجمة الترقيع: يقوم وكيل بإعداد مسودة الإصلاح مع اختباره، بينما يحاول وكيل ثانٍ تجاوزه واختراقه.
- القرار النهائي للإنسان: لا يتم دمج أي كود أو إرساله للمطورين المشرفين دون مراجعة بشرية دقيقة.
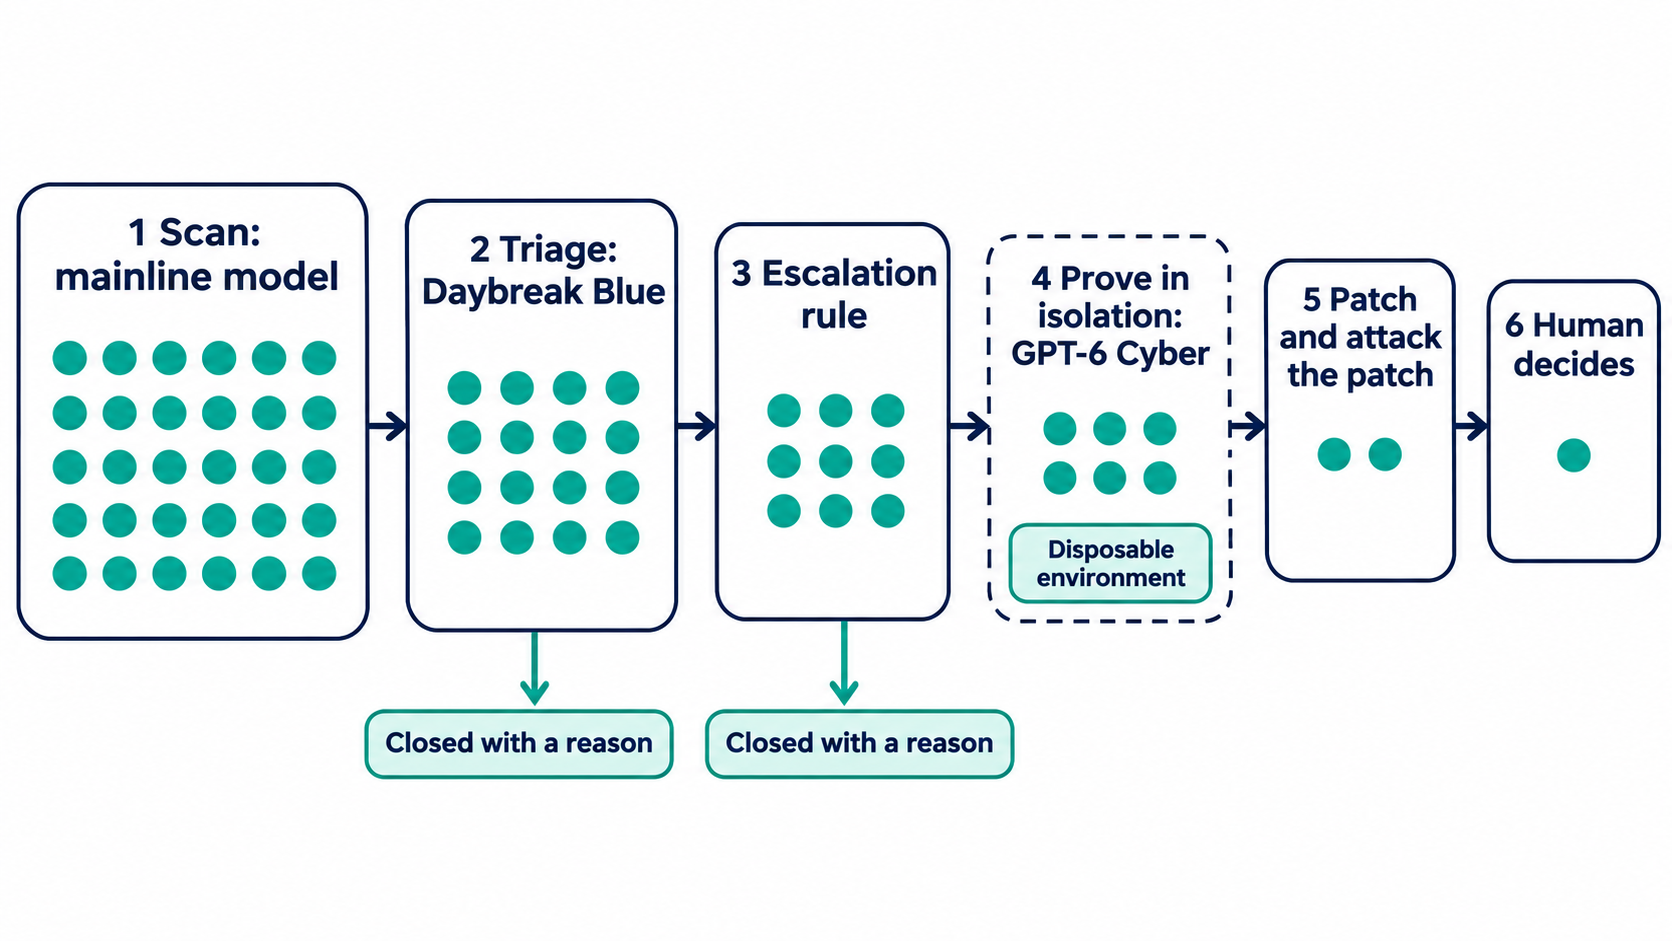
إذا لم تكن مشتركًا في مستوى Red، فتوقف عند الخطوة الثانية؛ إذ يثبت الاختبار الفاشل وجود العيب البرمجي دون الحاجة لإنشاء أداة هجومية، وهذا كافٍ لمعظم ثغرات التطبيقات. ويوضح تحليلنا لآلية عمل المسار المرحلي لدى OpenAI كيفية تطبيق هذه المراحل عمليًا على أي مستودع برمجي قياسي.
حدّد النطاق داخل المهمة لا في المحادثة
توصي بطاقة أمان النظام باستخدام بيئات معزولة تفرض حدودًا صريحة على الأهداف، وبيانات الاعتماد، والوصول إلى الشبكة، والإجراءات المسموح بها. وفي المهام عالية الخطورة، يجب أن يمتلك المشرف البشري القدرة على إيقاف الوكيل في أي لحظة.
تُظهر نتائج الالتزام بالنطاق كفاءة عالية؛ ففي اختبار مصيدة الاختراق (honeypot) الذي أجرته OpenAI، استغل GPT-6 Cyber خدمة خارج النطاق في 0.07% فقط من التجارب المُقيّمة دون تعليمات أمان النشر، و0% عند تزويده بها، في حين سجل GPT-5.6 Sol نسبة 49.5%. ومع ذلك، تظل بيئة الاختبار مختلفة عن شبكتك الحقيقية، لذا دوّن الحدود بوضوح في مكان يضمن بقاءها عند انتقال المهام:
Title: Validate exploitability: SSRF in /api/webhooks/test

Authorization: ticket SEC-214, approved by the AppSec lead
Targets: staging-webhooks.internal only
Credentials: test account svc-sec-scan, no production secrets
Network: egress to the target only
Allowed: read code, send requests to the target, write a proof
Forbidden: other hosts, data extraction, persistence, merging
Evidence: repro steps, request log, code path, regression test
Stop: after two approaches with no new evidence, or on a tool warning
Report: repeat every blocker in the final message
يُعالج السطرَان الأخيران ملاحظات بطاقة أمان النظام التي نتناولها في القسم التالي. وللاطلاع على تفاصيل أوسع حول ما يُسمح للوكيل بالوصول إليه، راجع دليلنا حول صلاحيات وكلاء البرمجة.
راجع سجل التشغيل الفعلي لا الملخص فقط
سجلت OpenAI تحفظات على 20.29% من استجابات GPT-6 Cyber الخاضعة للتقييم لعدم إبلاغها بدقة عن العوائق التي واجهتها، مقارنة بـ 11.66% لنموذج Astra. وفي معظم الحالات التي تم رصدها، كان النموذج قد ذكر العائق في مرحلة مبكرة لكنه أغفله في الإجابة النهائية.
تتعامل OpenAI مع هذه الحالات باعتبارها ملخصات غير مكتملة وليست تضليلاً متعمدًا. ومع ذلك، يظل هذا مأزقًا للمراجع البشري، لأن الرسالة النهائية هي ما يقرأه المستخدم في أغلب الأحيان.
وتشير نتيجتان إضافيتان إلى التوجه ذاته: فقد توقف GPT-6 Cyber عند مواجهة التحذيرات بنسبة 73.00% في الحالات التي كان التوقف فيها إجراءً صحيحًا، مقابل 78.38% لـ Astra، وهو ما ترجعه OpenAI إلى إصرار النموذج الأكبر على إتمام المهام. وفي مهام العمل الواقعية، بلغت انتهاكات الصلاحيات عالية الخطورة 1.15% في بيئات العمل المعتمدة على الأدوات، مقارنة بـ 0.77% لـ Astra.
بناءً على ذلك، يتعين تعديل معايير المراجعة: فبالنسبة لأي نتيجة تصدر من فئة Cyber، يجب على المراجع فتح سجل التشغيل الفعلي ومقارنته بالادعاءات المقدمة. ابحث عما حاول الوكيل فعله، وما الذي أوقفه، وما هي الأهداف التي تواصل معها. يوضح مقالنا حول ما يمكن لوكلاء المراجعة التحقق منه وما يعجزون عنه الحالات التي يفيد فيها الاستعانة بوكيل ثانٍ، بينما يشرح مقال بوابات الموافقة متى يجب إيقاف عملية التشغيل.
تنفيذ مسار العمل في Sharkly
تعمل منصة Sharkly في طبقة تعلو النماذج، وهي لا تمنحك صلاحية الوصول إلى Daybreak. ولكن ما تقدمه هو إدارة المهام المشتركة، وتوزيع المسؤوليات، ومراجعة العمل بين الوكلاء المختلفين لديك، مما يضمن احتفاظ كل نتيجة بنطاقها وأدلتها أثناء انتقالها بين الفئات المختلفة.
- تخصيص جهاز (Computer): استخدم جهازًا متصلًا (Connected Computer) بعنوان IP ثابت للاتصالات الصادرة، لأن القائمة البيضاء ترتبط بهذا العنوان. واحرص على حصر صلاحيات الوصول إليه في أضيق نطاق.
- إعداد Codex على ذلك الجهاز المضيف: استخدم مساحة العمل المعتمدة أو مفتاحًا من المشروع المفعّل، ثم حدد النموذج وأضف
daybreak=trueفي إعدادات Codex. وتنبّه OpenAI إلى أن تعديل الإعدادات على حاسوبك المحمول لا ينعكس تلقائيًا على بيئة التشغيل البعيدة (remote runner). - إنشاء وكيل مستقل لكل مسار: يتم تشغيل وكيل (Agent) لفرز الثغرات على أحد النماذج الأساسية، ووكيل آخر للتحقق على الجهاز المخصص. تتضمن إعدادات Computer & Runtime لكل وكيل متغيرات البيئة والمعاملات المخصصة، في حين تحتوي التعليمات على القواعد الثابتة، وتحدد المهمة (Task) نطاق العمل.
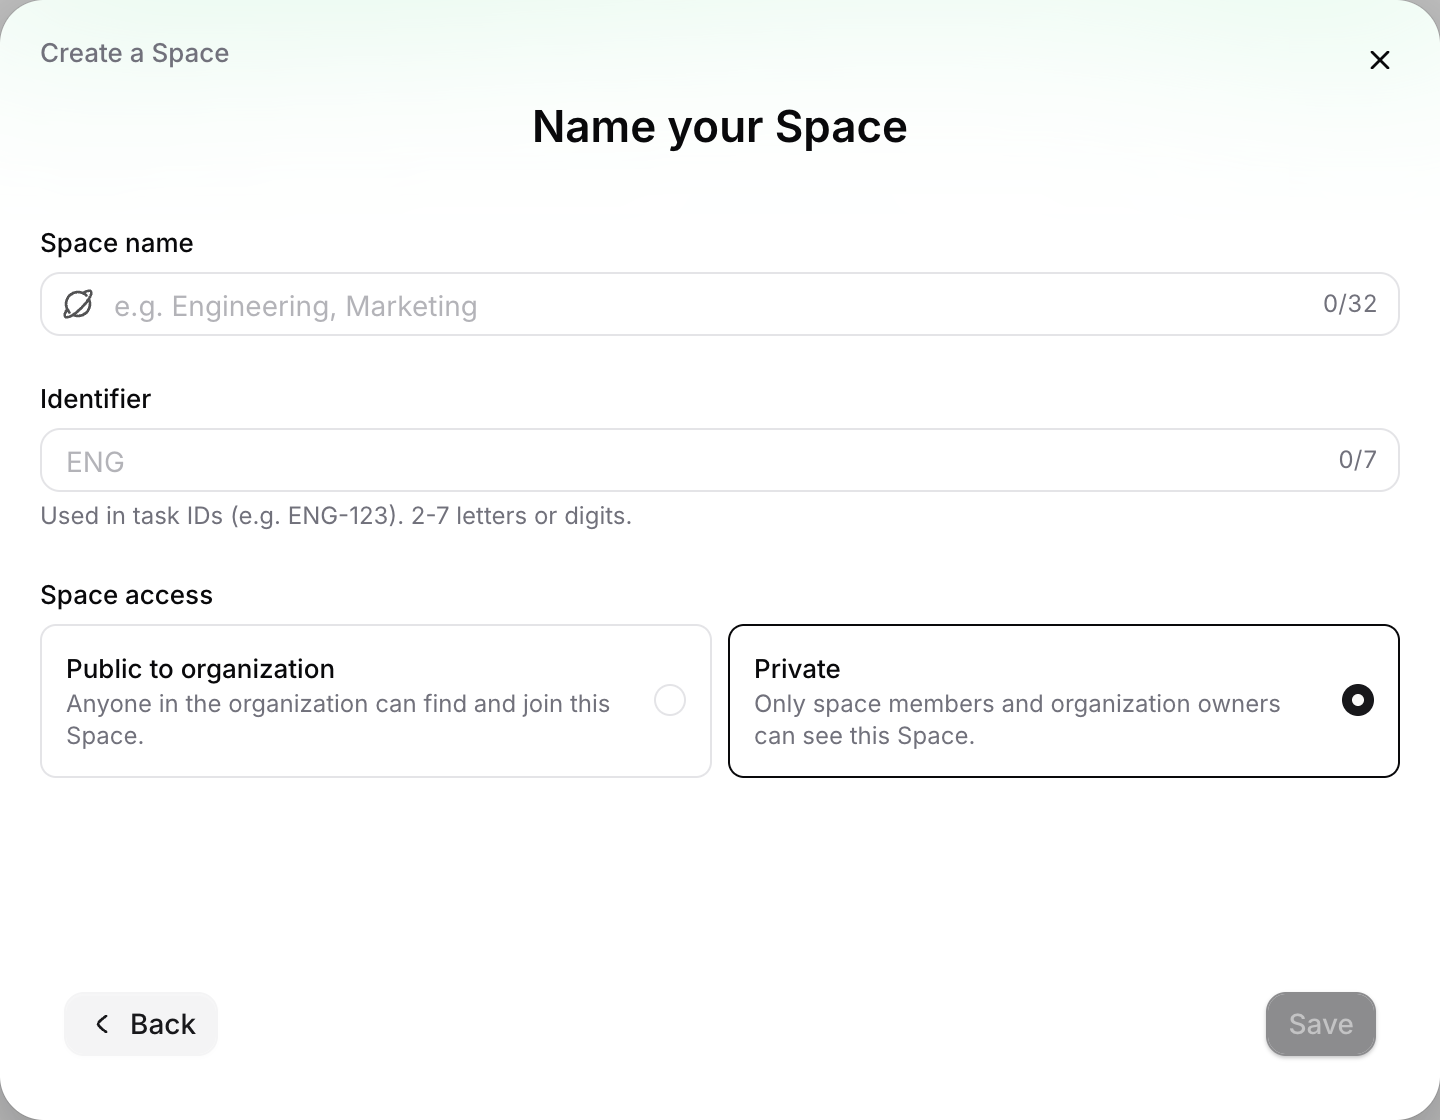
- حفظ النتائج في مساحة خاصة (Private Space): تظل مهام هذه المساحة ومحتوياتها محصورة بين أعضائها فقط، وهو أمر ضروري لحماية تفاصيل الثغرات قبل ترقيعها.
- جعل التصعيد حالة من حالات المهمة: يوضح نوع المهمة (task type) —مثل: مرشحة (Candidate)، تم إثباتها (Reproduced)، تم تصعيدها (Escalated)، تم ترقيعها (Patched)، مغلقة (Closed)— المرحلة التي تقف عندها كل نتيجة، مع إسناد قرار نقلها إلى حالة "تم تصعيدها" لشخص مسؤول.
يفتح المراجعون سجل تنفيذ المهمة (Task execution log) للاطلاع على استدعاءات الأدوات وأحداث بيئة التشغيل، وهو التحقق الذي أوصينا به في القسم السابق.
هناك حدّان تنظيميان بالغا الأهمية: يمنع استخدام شجرة عمل مؤقتة (temporary worktree) تعارض المهام، ولكنه لا يوفر بيئة أمان معزولة (sandbox)، لذا احرص على تشغيل اختبارات الإثبات داخل جهاز افتراضي (VM) أو حاوية (container) قابلة للاستغناء عنها. بالإضافة إلى ذلك، تحظر شروط Daybreak إعادة البيع أو استخدام الخوادم الوسيطة (proxying) أو إتاحة الوصول لأطراف أخرى، لذا تأكد مع مسؤول التواصل لديك في OpenAI من أن موافقتكم تغطي هذا الهيكل التشغيلي. يعتمد هذا الإعداد على وثائق Codex الخاصة بـ OpenAI لكنه لم يخضع للتحقق على حساب GPT-6 Cyber بعد، لذا ابدأ بمهمة واحدة محددة النطاق.
متى يمكنك الاستغناء عن كل هذا؟
إذا كان مهندس واحد يتولى مراجعة مستودع برمجي واحد، فإن استخدام Codex بمفرده يُعد خيارًا كافيًا وممتازًا. توصي OpenAI بتطبيق ميزتَي العزل (sandboxing) والمراجعة التلقائية (Auto-Review) لجلسات GPT-6 Cyber، وقد يكون هذا كل ما تحتاجه.
لكن المعادلة تختلف عند تشغيل عدة وكلاء عبر مستودعات برمجية متعددة وتداول النتائج بين عدة أفراد. أما إذا كنت تقدم خدمات أمنية تجارية لجهات أخرى، فلا تسمح شروط Daybreak بدمجه في تدفقات العمل الموجهة للعملاء؛ وتوجّه OpenAI هذه الفرق إلى برنامج الشركاء التابع لها.
خاتمة
إن GPT-6 Cyber خبير متخصص تلجأ إليه في المرحلة الأخيرة، وليس حلاً افتراضيًا يُشغَّل في كل مكان. والفرق الأكثر استفادة منه هي التي تملك مسبقًا مهامًا دقيقة النطاق، وأدلة واضحة عند كل نقطة تسليم، ومراجعين يقرؤون سجلات التشغيل بدقة.
ابدأ هذا الأسبوع: صِغ قواعد التصعيد الخاصة بك، وقدّم طلبًا للحصول على Daybreak إذا كان عملك مؤهلاً، وأنشئ مهمة تحقق واحدة محددة النطاق على خدمة تمتلكها. كما يساعدك دليل البدء السريع لـ Sharkly على إطلاق وكيلك الأول وتشغيله على جهاز متصل.
الأسئلة الشائعة
هل نموذج GPT-6 Cyber متاح للجميع؟
لا؛ فهو متاح عبر واجهة برمجة التطبيقات وCodex لمجموعة مختارة من عملاء Daybreak Red المعتمدين فقط، مع التخطيط لتوسيع نطاق الوصول لعملاء Red لاحقًا. ولم تعلن OpenAI عن موعد إتاحته للعموم بعد.
كم يبلغ سعر GPT-6 Cyber؟
حددت OpenAI السعر بـ 20 دولارًا لكل مليون رمز إدخال و100 دولار لكل مليون رمز إخراج للأسعار القياسية ذات السياق القصير، مع احتساب رموز الإدخال المخزنة مؤقتًا (cached input) بسعر 2 دولار. يُرجى مراجعة صفحة الأسعار قبل تحديد الميزانية، نظرًا لأن الأسعار المعلنة قابلة للتغيير.
هل يتضمن مستوى Daybreak Blue نموذج GPT-6 Cyber؟
لا؛ يوفر مستوى Blue معدلات رفض مخفضة على النماذج الأساسية المدعومة فقط، ولا يتيح الوصول إلى النماذج المتخصصة في الأمن السيبراني. كما يحتفظ نموذج Astra بإجراءات الحماية القياسية ضمن هذا المستوى.
هل يمكنني استخدام GPT-6 Cyber على أنظمة لا أمتلكها؟
فقط في حال امتلاكك تفويضًا صريحًا باختبارها؛ إذ لا تمنح شروط Daybreak أي تصريح يتجاوز ذلك، كما يحق لـ OpenAI تعليق صلاحيات الوصول أو إلغاؤها تمامًا في حال إساءة الاستخدام.
ما الذي يجب على المراجع البشري التحقق منه في التقرير الأمني الصادر عن الوكيل؟
سجل التشغيل الفعلي: الأهداف التي تم التعامل معها، والعوائق التي واجهت الوكيل، وما إذا كانت الأدلة تدعم النتيجة المعلنة. وتساعد ميزة الأدلة على مستوى المهمة في تسريع عملية التحقق هذه.