

Jev هو نموذج جديد من TypeSafe AI، وهو لا يكتب الأكواد ولا النصوص الإنشائية. أنت تُعطيه جزءًا من حالة البرنامج، وتُعلن الأسئلة التي تريد إجابات عنها، فيُعيد لك إجابات مُحددة النوع مصحوبة باحتمالات مُعايَرة. تُسمّيه TypeSafe نموذج النظام الأول (System One Model). وقد أُتيح على Vercel AI Gateway في 16 سبتمبر 2026، ولهذا ظهر فجأة في كل مكان.
بالنسبة لفريق يُشغّل عدة وكلاء برمجة، الجزء المثير للاهتمام ليس النموذج نفسه، بل موضع نموذج القرار في المنظومة. وكلاؤك يُنتجون العمل، أما المشكلة الصعبة — كما شرحنا في لماذا تُعدّ المراجعة البشرية عنق الزجاجة — فهي تحديد ما يجب فعله بمخرجات خمس عمليات تشغيل في آنٍ واحد: أيّها يحتاج إلى إنسان، وأيّها يمكن دمجه، وأيّها متعثر. صُمّم Jev لهذا النوع من الأسئلة تحديدًا. تشرح هذه التدوينة ما هو Jev، وما ليس هو، وأين يقع فوق وكلائك.
ما هو Jev
نموذج النظام الأول هو نموذج يُعيد قرارات بدلًا من نصوص. تصف تدوينة الإطلاق من TypeSafe الأمر بأنه «حالة غير مُهيكلة تدخل، وقرارات احتمالية مُحددة النوع تخرج». وثمة ثلاث خصائص مهمة.
يُعلَن شكل المخرجات قبل الاستدعاء. تُحدّد نوع كل سؤال مسبقًا، ولا يمكن للنموذج الإجابة خارج هذا الإطار. لا وجود لنص يجب تحليله، ولا لعدم توافق في المخطط يجب اكتشافه.
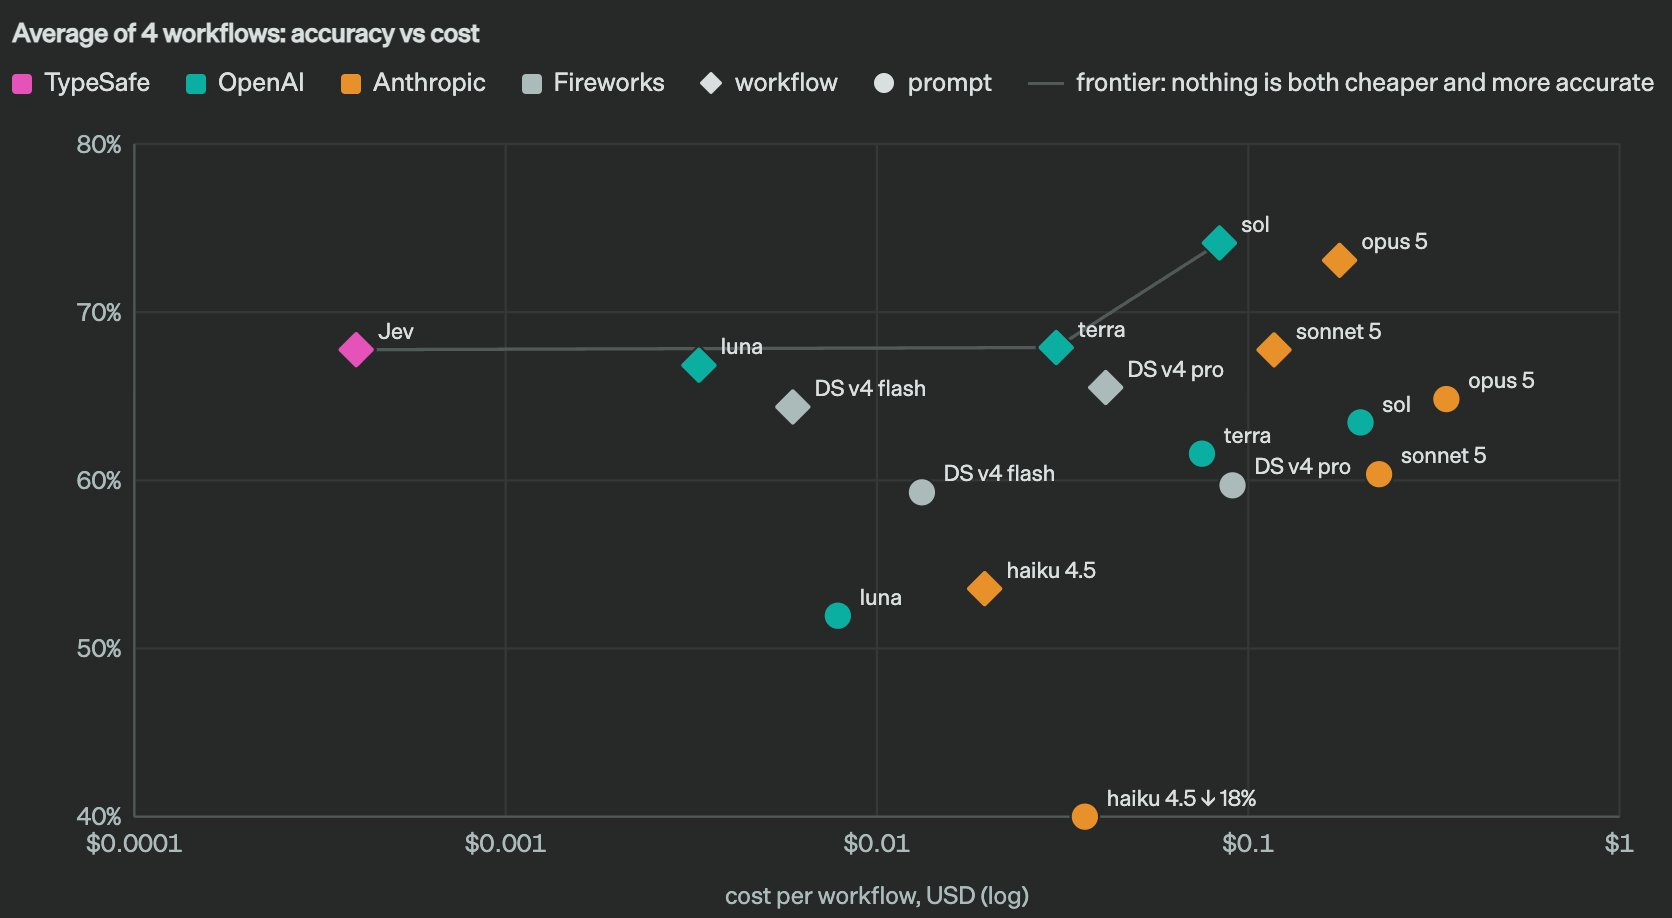
كل إجابة تحمل احتمالًا. فسؤال بنعم/لا يُعيد 0.97 وليس true. والاختيار يُعيد التوزيع الكامل عبر الخيارات. درّبت TypeSafe النموذج بطريقة تُسمّيها التعلّم المعزّز للقرارات المُعايَرة (Reinforcement Learning for Calibrated Decisions)، والادّعاء أن الثقة الأعلى تعني دقة أعلى، بحيث يمكنك ضبط عتبة: أتمِت ما فوقها، وأحِل ما تبقّى إلى إنسان.
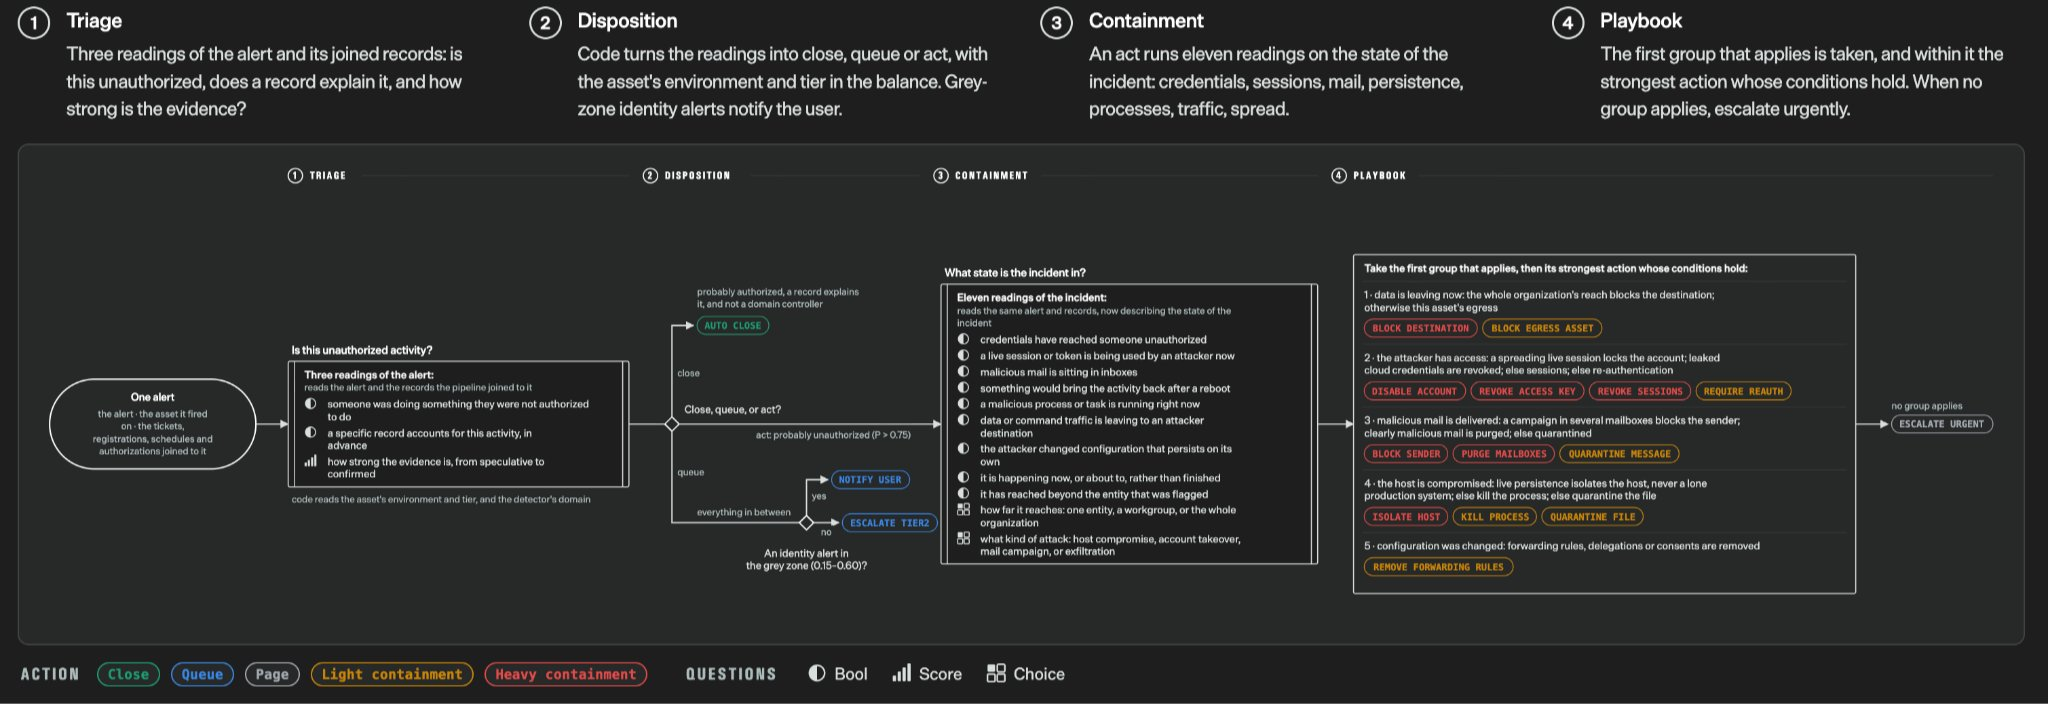
يُجاب عن جميع الأسئلة على التوازي في طلب واحد. ولهذا تذكر TypeSafe أزمنة من الطرف إلى الطرف تتراوح بين 70 و500 مللي ثانية. هذه أرقام البائع وليست مقياسًا مستقلًا، لكن المعمارية تفسّرها: لا شيء يُولَّد رمزًا تلو رمز.
أنواع الأسئلة الثلاثة
يكشف واجهة برمجة Jev عن ثلاث وحدات أساسية. كل واحدة منها كائن JSON تحت مفتاح تختاره، وتُقيَّم جميعها مقابل الحالة state نفسها.
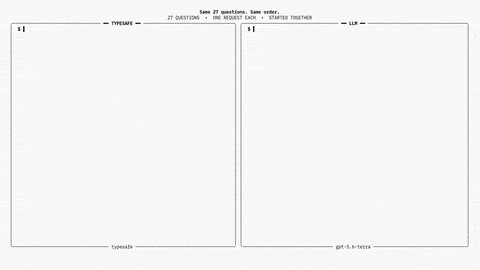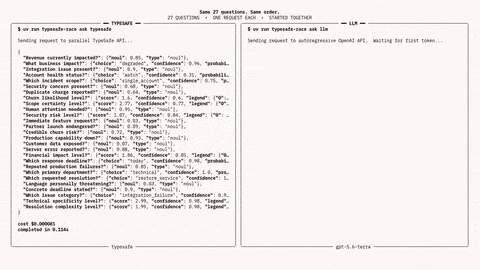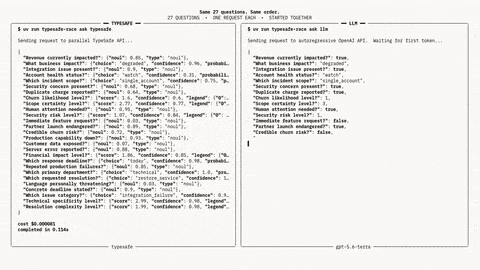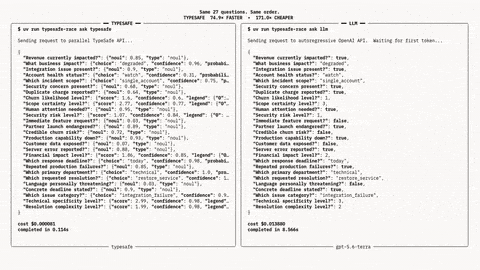
Noul هو احتمال بنعم/لا. يُعيد {"type": "noul", "instructions": "Does this run need a human before merge?"} القيمة {"noul": 0.91}. وأنت تضبط العتبة في الكود.
Choice يختار خيارًا واحدًا من مجموعة مُسمّاة تضم حتى 255 خيارًا. تمرّر criteria التي تربط أسماء الخيارات بأوصافها، وتحمل الإجابة الاختيار والتوزيع الكامل وقيمة ثقة.
Score يضع الحالة على مقياس مرتّب من مستويين إلى 10 مستويات. والإجابة هي موضع مرجّح بالاحتمال، فيمكن أن يُسجّل خطأ برمجي 1.3 بين «يوجد حل بديل» و«مانع للعمل».
عبر Vercel AI SDK يُسمّى نوع نعم/لا boolean ويُسمّى الحقل probability؛ أما عبر نقطة نهاية TypeSafe الخاصة فهو noul. الفكرة نفسها بمفتاح مختلف.
أين يقع نموذج القرار فوق وكلائك
هذا هو النموذج الذهني الذي نستخدمه. النماذج تُنتج الرموز. ووكلاء البرمجة (Claude Code وCodex وGemini CLI وOpenCode) يحوّلون الرموز إلى تغييرات على جهاز (Computer). وطبقة الإدارة تقرّر من يعمل على ماذا وما يحدث بالنتيجة. ينتمي Jev إلى هذه الطبقة العليا وليس الوسطى. فهو ليس وكيلًا ولا يستطيع تعديل ملف. إنه إجابة سريعة محدّدة النوع عن سؤال إداري.
ثمة ثلاثة أسئلة تظهر على كل لوحة تُشغّل وكلاء على التوازي، وكل واحد منها يقابل وحدة أساسية في Jev.
أيّ مُكلَّف يجب أن يتولّى هذه المهمة؟ اختيار (Choice) بين وكلائك، مع criteria تصف ما يُجيده كل واحد. والحالة هي عنوان المهمة ووصفها والمستودع المرتبط بها. هذه هي خطوة الفرز التي وصفناها في إدارة مخزون العمل بالذكاء الاصطناعي وفرزه، منفّذة كاستدعاء واحد يستغرق 100 مللي ثانية بدلًا من قراءة شخص لأربعين تذكرة.
هل تحتاج هذه العملية إلى إنسان قبل الدمج؟ Noul على ملخّص الفروقات في العملية ونتائج الاختبارات والمسارات المتأثرة. فوق 0.85، احتفظ بها للمراجعة؛ وتحت 0.15، دع بوابة الموافقة تمرّرها؛ وفيما بينهما، ضع عليها علامة. الهدف ليس إلغاء المراجع، بل ضمان أن تُخصّص فترة ما بعد الظهر لديه للعمليات التي تحتاجه فعلًا.
ما مدى خطورة هذا التغيير؟ درجة (Score) من «تجميلي» إلى «يمسّ المصادقة أو المدفوعات»، تُطبَّق على الحالة نفسها. هذا الرقم يرتّب قائمة المراجعة، وهو معظم الغرض من تتبّع العمل المنجز بواسطة وكلاء البرمجة.
سبق المجتمعُ ذلك. ففي الأسبوع التالي للإطلاق، أنتج المطورون سير عمل لمراجعة الأكواد على مراحل مبنيًّا على Jev، وإضافة لـ Claude Code تستبدل ملخّصات الضغط بقرارات Jev حول أيّ نداءات أدوات يجب الإبقاء عليها، و«مشرف مصنع برمجيات» يوجّه العمل باستخدامه. وكل واحد منها طبقة قرار فوق وكيل، وهو النمط المهم.
قاعدة قرار صادقة
استخدم Jev عندما يكون للسؤال مجموعة ثابتة من الإجابات وتحتاج معها احتمالًا: التوجيه، والخطورة، و«يحتاج مراجعة»، و«متعطّل»، و«هل وصف طلب الدمج هذا صادق». هذه هي الأسئلة التي تطرحها اللوحة مئة مرة في اليوم.
لا تستخدم Jev عندما يحتاج السؤال إلى حكم لا يوجد في الحالة. «هل هذه هي المعمارية الصحيحة» ليس اختيارًا (Choice). و«هل سيقبل العميل هذا» ليس درجة (Score). والاحتمال على هذه الأسئلة رقم يشبه القرار. أبقِ إنسانًا، أو نموذجًا لغويًا قادرًا على شرح منطقه، على هذا الجانب من الحد.
ولا تدع احتمالًا يحلّ محل بوابة المراجعة. فقيمة 0.96 على «آمن للدمج» إشارة قوية لوضع العملية في مقدمة قائمة الإنسان، وليست سببًا لتخطّي الإنسان. الحد الذي ترسمه Sharkly هو أن الأتمتة تتوقف حيث يلزم حكم الفريق، ونموذج القرار لا يحرّك هذا الحد. إنه يجعل القائمة على جانبه البشري أقصر وأفضل ترتيبًا.
كيف تستدعيه
مباشرةً: POST https://api.typesafe.ai/v1/systemone بمفتاح Bearer من console.typesafe.ai، والطراز jev-latest (حاليًّا jev-1.13.0). عبر Vercel AI Gateway: الطراز typesafe-ai/jev من خلال experimental_evaluate في AI SDK 7، ولاحِظ أن وثائق Gateway تقول إن التقييم متاح عبر AI SDK فقط، وليس عبر نقاط النهاية المتوافقة مع OpenAI.
استدعاء فرز يُجيب عن الأسئلة الثلاثة دفعة واحدة:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
الأسعار وفق صفحة الطرازات في TypeSafe: 0.042 دولار لكل مليون رمز إدخال، والمخرجات بلا رسوم، و64 ألف رمز لكل طلب مع 32 ألفًا للحالة، ونصوص فقط. بهذا السعر يكلّف استدعاء الفرز أعلاه جزءًا ضئيلًا من السنت، وهذا ما يجعل تشغيله على كل مهمة وكل عملية أمرًا معقولًا.
كيف يتصل هذا بـ Sharkly
لا تستدعي Sharkly نموذج Jev نيابةً عنك، وهي ليست نموذج قرار. إنها طبقة المهام وجهاز الحوسبة والسياق والمراجعة المشتركة حول الوكلاء الذين تُشغّلهم بالفعل. وما يمنحك إياه نموذج كـ Jev هو طريقة رخيصة ومحدّدة النوع لاتخاذ قرارات التوجيه والمراجعة التي تُبرزها هذه الطبقة: أيّ مُكلَّف، وأيّ قائمة، وما مدى الإلحاح. اربطه بأتمتة تُنشئ مهمة وتختار الوكيل، أو شغّله على مخرجات عملية مكتملة قبل أن تصل النتيجة إلى المراجع. في كلتا الحالتين يستقر القرار في مكان يمكن لإنسان رؤيته، وهذا هو الجزء الذي يجب أن يظل صحيحًا مهما قال الاحتمال.
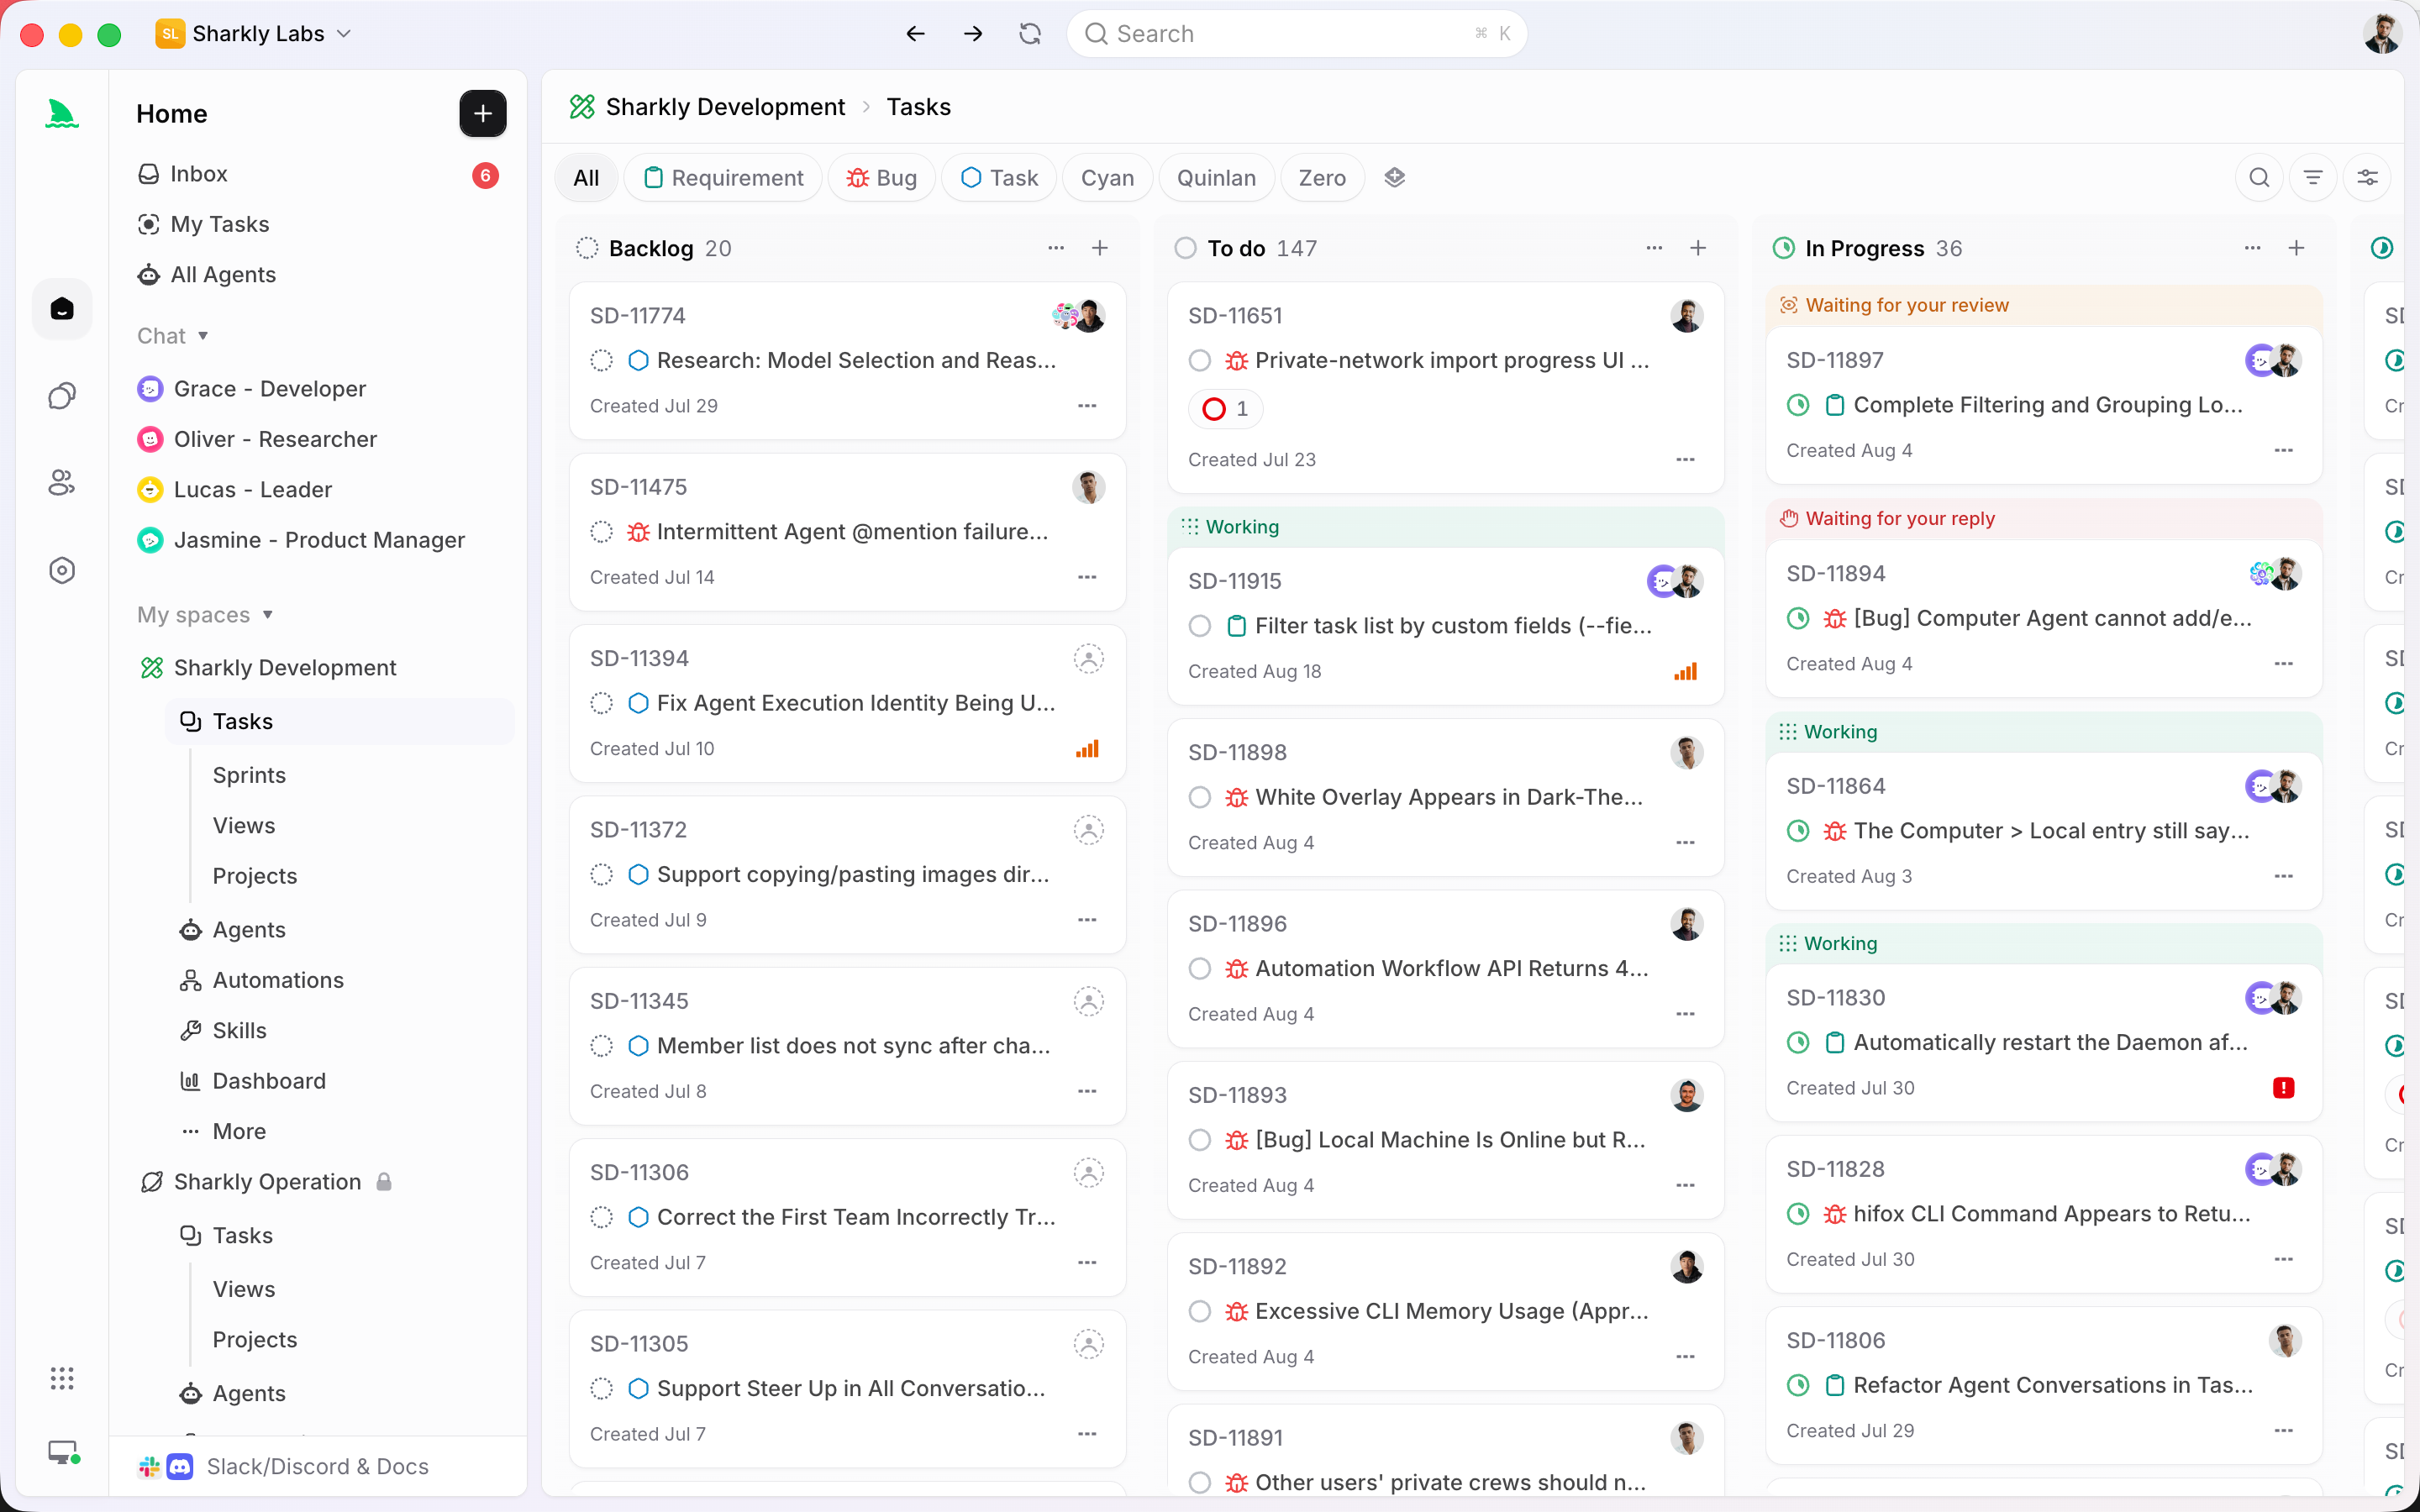
إذا كنت تُشغّل أكثر من وكيل وكانت قائمة المراجعة هي ما يُسبب الألم، فإن البدء مع Sharkly يغطي اللوحة وأجهزة الحوسبة وسير المراجعة الذي يتصل به نموذج القرار.
الأسئلة الشائعة
هل Jev وكيل برمجة؟
لا. فهو لا يستطيع توليد الأكواد ولا تعديل ملف. إنه يجيب عن أسئلة مُعلَنة حول حالة تُعطيه إياها، مع احتمال. الوكلاء يُنتجون العمل، وJev يساعد في تقرير ما يجب فعله به.
هل يمكنه أن يحلّ محل مراجعة الأكواد؟
لا، ولا ينبغي له ذلك. يمكنه ترتيب قائمة المراجعة وانتزاع الحالات الواضحة منها. أما قرار الدمج فيبقى بيد إنسان، وهو الحد الذي يعتمد عليه سير العمل هذا بأكمله.
ماذا يعني «مُعايَر»؟
إذا قال Jev إن القيمة 0.9، فينبغي أن يكون محقًّا نحو 90% من الوقت في هذا النوع من الأسئلة. اختبر ذلك على عملياتك الخاصة قبل أن تثق بعتبة: بضع عشرات من الفروقات الموسومة تكفي لمعرفة ما إذا كان الرقم يعني ما يقول.
هل أحتاج إلى Vercel لاستخدامه؟
لا. فـ API المباشر يعمل بمفتاح Bearer. وGateway مجرد تسهيل إن كنت تستخدم AI SDK بالفعل.


