

باختصار
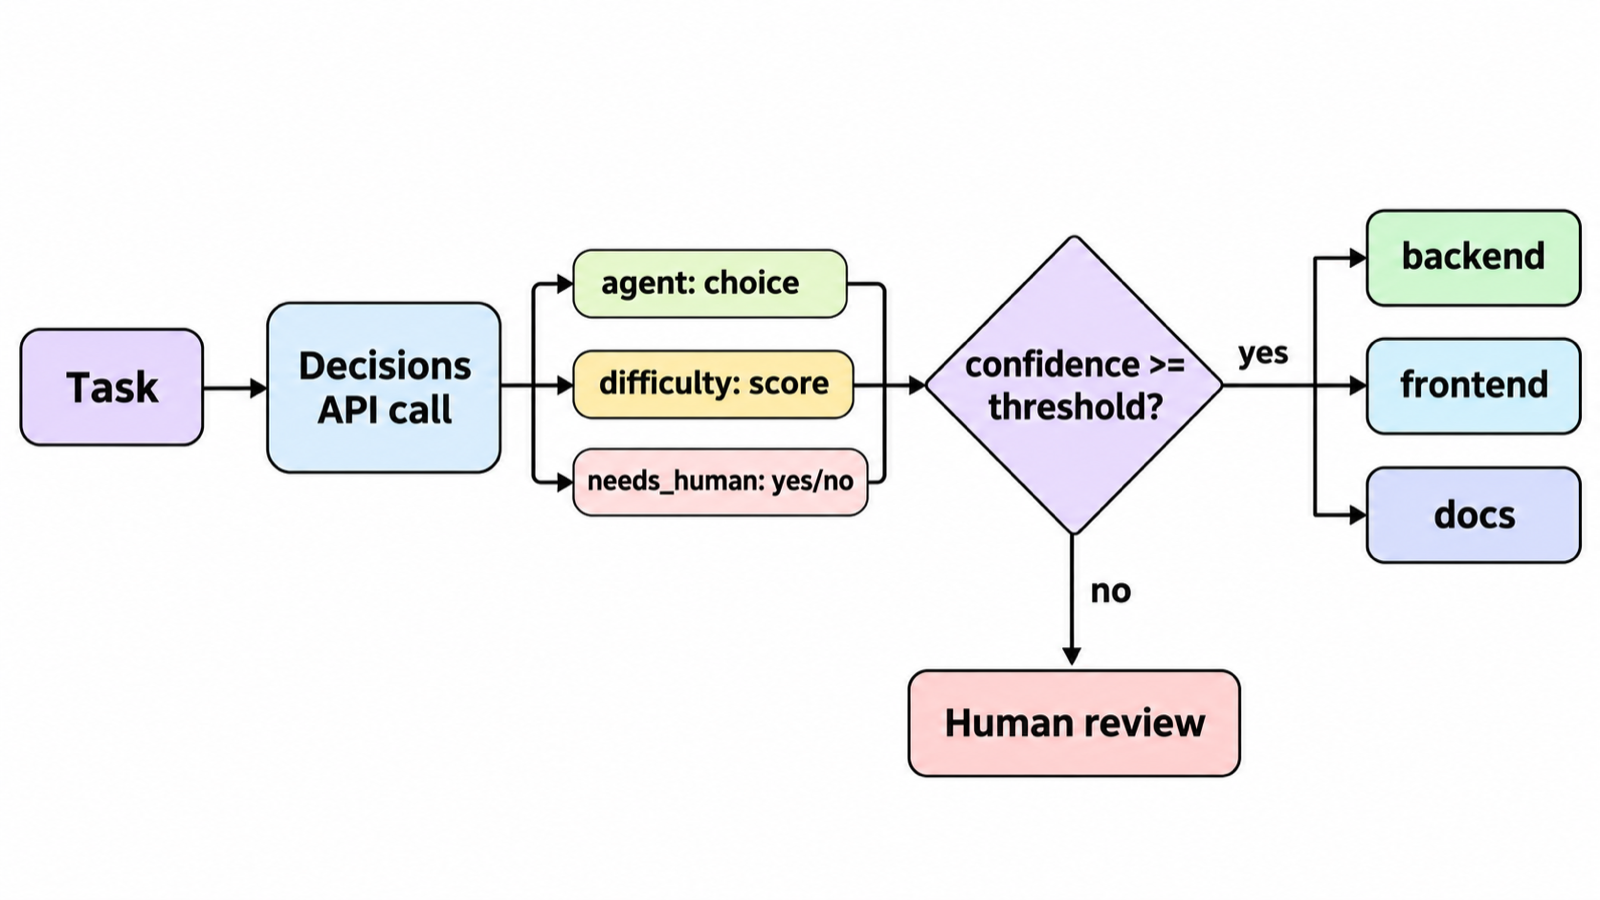
لتوجيه مهام وكلاء الذكاء الاصطناعي باستخدام Gemini Decisions API، أرسل عنوان المهمة ووصفها إلى gemini-decision-1 مصحوبة بثلاثة أسئلة: سؤال اختيار (choice) لتحديد الوكيل المناسب لتوليها، وسؤال تقييم (score) لتقدير مدى صعوبتها، وسؤال منطقي (noul) لتحديد ما إذا كان يلزم تدخل بشري لاتخاذ القرار أولاً. أسند المهمة تلقائياً عندما تتجاوز نسبة الثقة الحد الأدنى الذي حددته، وأحل كل ما دون ذلك إلى المراجعة البشرية.
مقدمة
ينتهي المطاف بكل فريق يعتمد على عدة وكلاء برمجة بمواجهة العبء الروتيني نفسه: شخص ما يضطر لقراءة كل مهمة جديدة وتحديد الجهة المسندة إليها؛ هل هو وكيل الواجهة الخلفية أم وكيل الواجهة الأمامية؟ النموذج الاقتصادي أم النموذج القوي؟ هل المهمة جاهزة للبدء، أم لا تزال تفتقر إلى قرار حاسم؟
أطلقت Google أداة مخصصة لهذه المهمة بالتحديد في 11 نوفمبر 2026. تجيب واجهة Gemini Decisions API عن الأسئلة المغلقة باحتمالات معايرة بدقة بدلاً من توليد نصوص كاملة. وتعتمد عليها Google داخلياً في Gemini Notebook لتوجيه كل استفسار إلى فئة النموذج ومستوى التفكير المناسبين، وتشير إلى أن ذلك أدى إلى تقليل زمن الاستجابة في الاستعلامات اليومية بنسبة تصل إلى 40%.
يشرح هذا المقال كيفية بناء موجّه مهام مماثل للوحة الوكلاء: استدعاء واحد لكل مهمة، وثلاثة أسئلة، وحد ثقة واحد، مع إحالة واضحة للمراجعة البشرية عندما لا يكون الموجّه متأكداً تماماً من قراره. وإذا أردت لوحة مهام لتطبيق ذلك عليها عملياً، فإن Sharkly تتيح لك البدء مجاناً. أما بالنسبة لسياسة التوجيه نفسها (أي المهام تستحق استخدام النموذج القوي)، فننصحك بقراءة مقال توجيه مهام الوكلاء حسب الصعوبة أولاً. يركز هذا المقال تحديداً على الاستدعاء البرمجي الذي يطبق هذه السياسة.
ما هي وظيفة Gemini Decisions API؟
تعتبر Gemini Decisions API نقطة نهاية برمجية تُقيّم أسئلة ذات أنواع محددة مقابل مدخلات مشتركة، وتُرجع احتمالاً ودرجة ثقة لكل سؤال منها. ونظراً لأنها لا تولد أي نص، فإن عدد رموز الإخراج يكون صفراً دائماً، مما يتيح لك بناء شروط تفرع منطقية في كودك اعتماداً على هذه الأرقام مباشرة دون الحاجة لأي خطوة تحليل أو معالجة للنصوص.
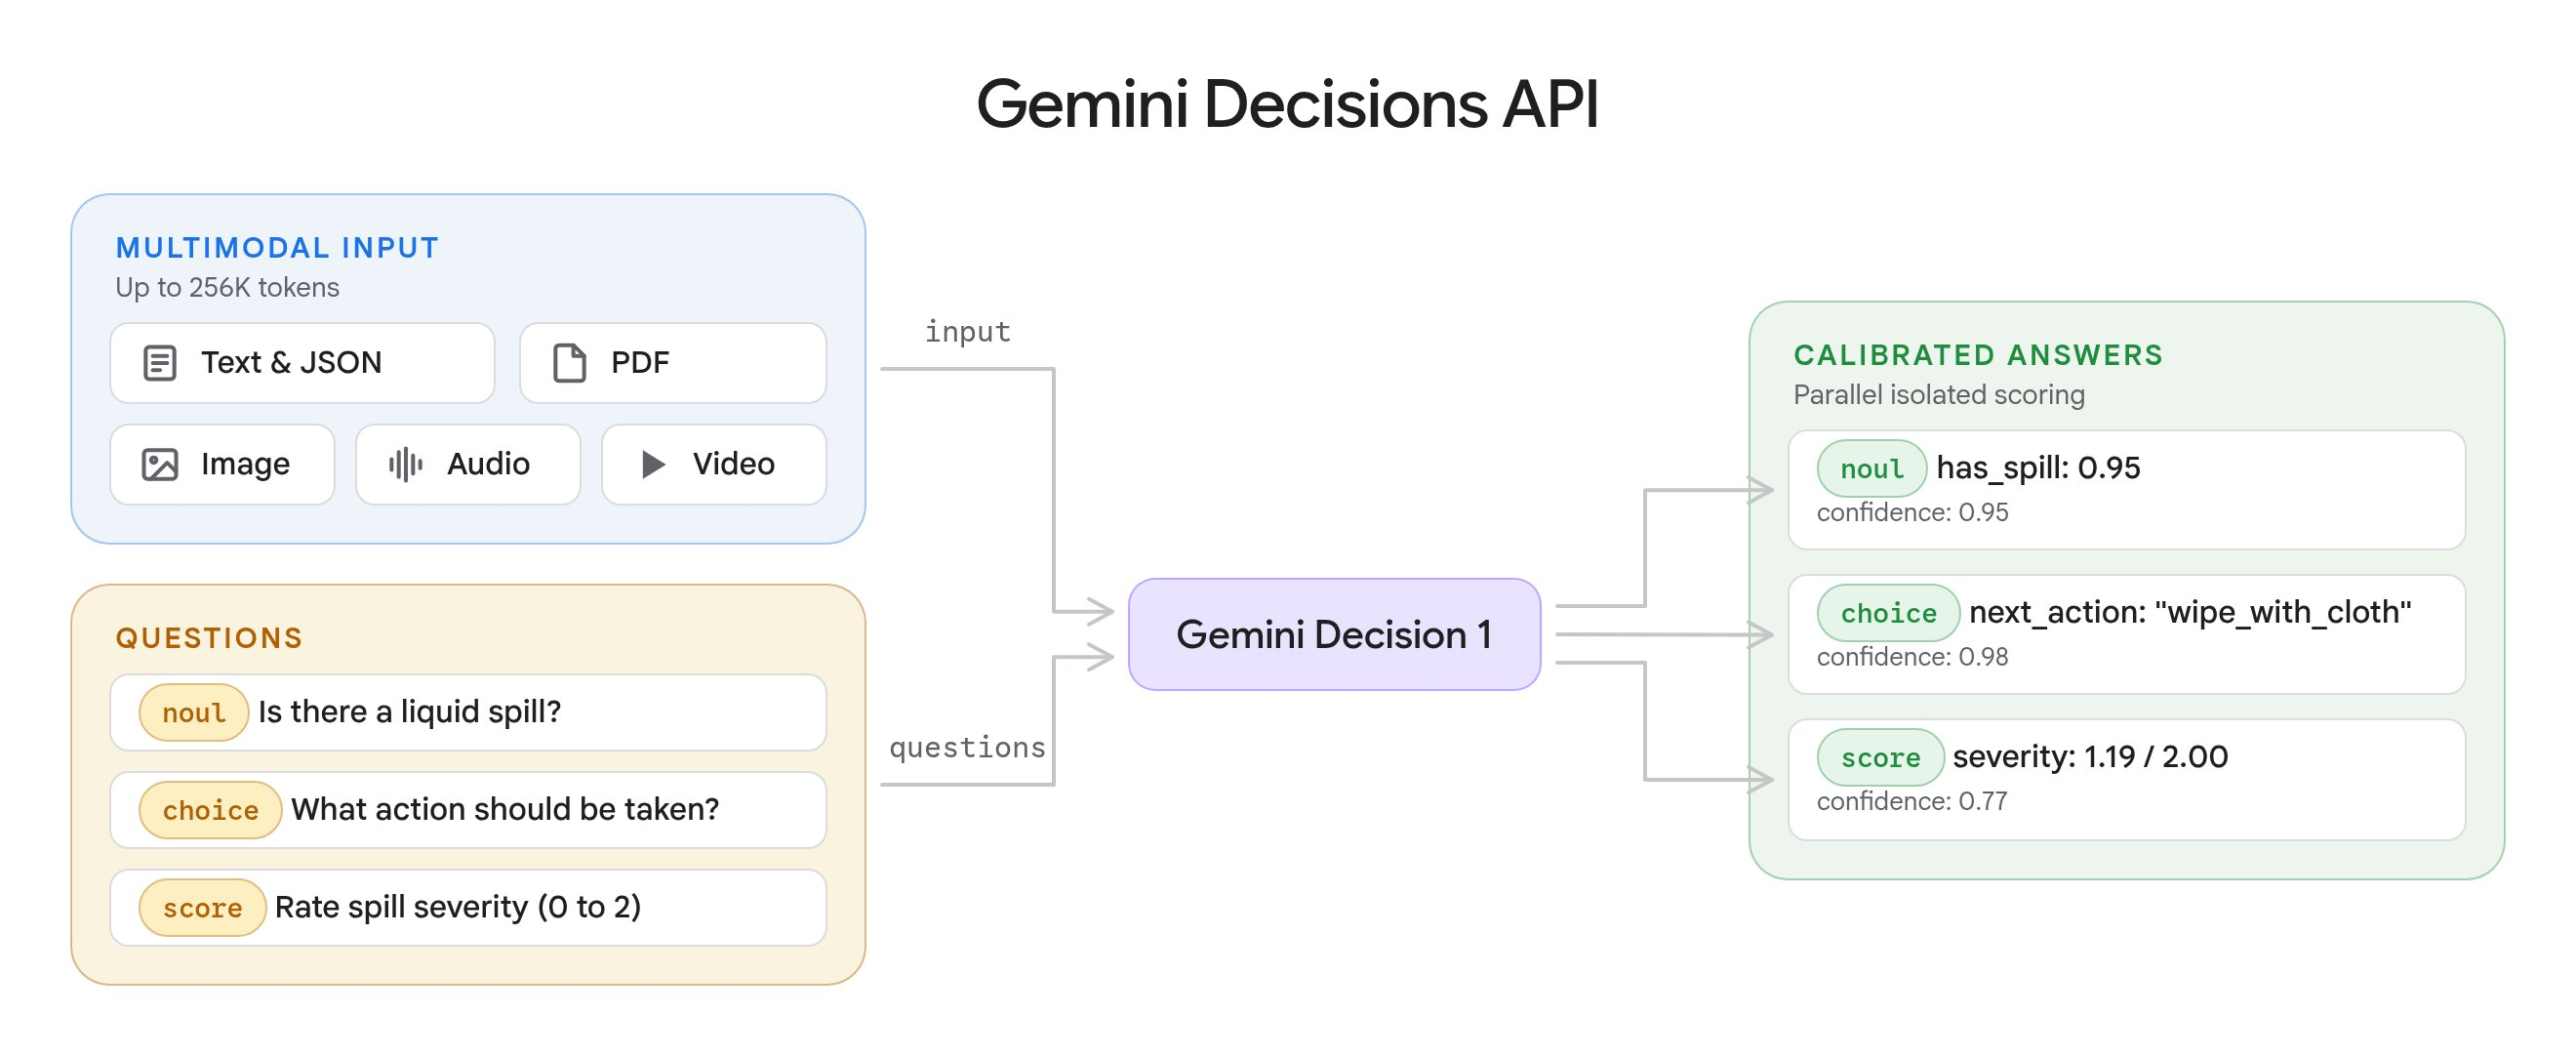
تغطي عمليات التوجيه ثلاثة أنواع من الأسئلة:
| النوع | ما يجيب عنه | ما تُرجعه الواجهة |
|---|---|---|
choice |
اختيار خيار واحد من بين خيارين إلى 255 خياراً | choice, probabilities, confidence |
score |
التقييم وفق معيار متدرج ومرتب | score, probabilities, legend, confidence |
noul |
نعم أو لا | noul (0.01 to 0.99), confidence |
يمكن للطلب الواحد أن يستوعب ما يصل إلى 1,000 سؤال لنفس المدخلات. ووفقاً لـ توثيق Decisions API، تُعالج الأسئلة في تمريرة أمامية واحدة ولا يمكن لأي سؤال رؤية الأسئلة الأخرى، لذا فإن إضافة سؤال لا تؤثر على إجابات بقية الأسئلة. وتُقدّر Google زمن الاستجابة الكلي بما بين 150 و250 مللي ثانية، وهو زمن شبه ثابت سواء كان الطلب يحتوي على سؤال واحد أو 100 سؤال.
إذا كنت قد قرأت مقالنا حول Jev ونماذج اتخاذ القرار لوكلاء البرمجة، فستبدو لك البنية مألوفة. لكن الفارق هنا يكمن في الجانب العملي: نموذج مستضاف لدى Google، وثلاثة أسئلة محددة بوضوح، وربط مباشر بلوحة المهام.
استدعاء التوجيه: ثلاثة أسئلة لكل مهمة
إليك كود موجّه المهام. يتطلب الكود إصدار google-genai 3.2 أو أحدث، ومفتاح GEMINI_API_KEY من Google AI Studio.
import json
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

AGENTS = {
    "backend": "Server code, APIs, database migrations, and backend tests.",
    "frontend": "UI components, styling, client state, and frontend tests.",
    "docs": "README files, docs pages, and changelogs. No code changes.",
    "other": "Work that fits none of the options above.",
}

DIFFICULTY = [
    "Trivial: one file, obvious change, no design decision.",
    "Routine: a few files, follows a pattern already in the repo.",
    "Involved: several modules or a new pattern, needs new tests.",
    "Hard: cross-cutting, touches auth or data migrations, or the spec is thin.",
]

def ask(task):
    state = json.dumps({
        "title": task["title"],
        "description": task["description"][:8000],
    })
    result = client.decisions.create(
        model="gemini-decision-1",
        input=state,
        questions={
            "agent": {
                "type": "choice",
                "instructions": "Which agent should take the task in `title` and `description`?",
                "criteria": AGENTS,
            },
            "difficulty": {
                "type": "score",
                "instructions": "How hard is this task for a coding agent working alone?",
                "criteria": DIFFICULTY,
            },
            "needs_human": {
                "type": "noul",
                "instructions": "Does a person need to make a decision before any agent starts?",
                "criteria": {
                    "true_description": "The spec is ambiguous, contradicts itself, or asks for a product, security, or pricing call.",
                    "false_description": "The spec is clear enough to implement as written.",
                },
            },
        },
    )
    return result.answers
توجد أربع تفاصيل هامة في هذا الكود مستقاة مباشرة من التوثيق ويسهل إغفالها.
النموذج لا يرى مفاتيحك أبداً. فهو يقرأ حقول instructions وcriteria فقط، لذا احرص على صياغة السؤال كاملاً داخل instructions ووصف كل خيار بدقة.
تُرتّب مفاتيح الخيارات أبجدياً. تقوم الواجهة بترتيب مفاتيح الاختيار وفق تسلسل بايتات UTF-8 قبل تقييمها. ولهذا السبب تم استخدام other للخيار الشامل بدلاً من none_of_the_above، التي كانت ستُرتّب أبجدياً قبل الخيارات الفعلية الأخرى.
يجب أن تكون مستويات التقييم متدرجة خطياً. فالقيمة المُرجعة في score هي متوسط مرجح بالاحتمالات لمؤشرات المستويات، أي من 0 إلى 3 في حالتنا هذه؛ لذا احرص على وجود تمايز واضح بين المستويات المتجاورة.
أرسل فقط ما تحتاجه الأسئلة. يشير التوثيق إلى أن المحتوى غير ذي الصلة يقلل من دقة النموذج؛ لذا فإن الاكتفاء بالعنوان والوصف أفضل عادة من تضمين سلسلة التعليقات بأكملها.
تحديد حد الثقة المناسب استناداً إلى مهامك الخاصة
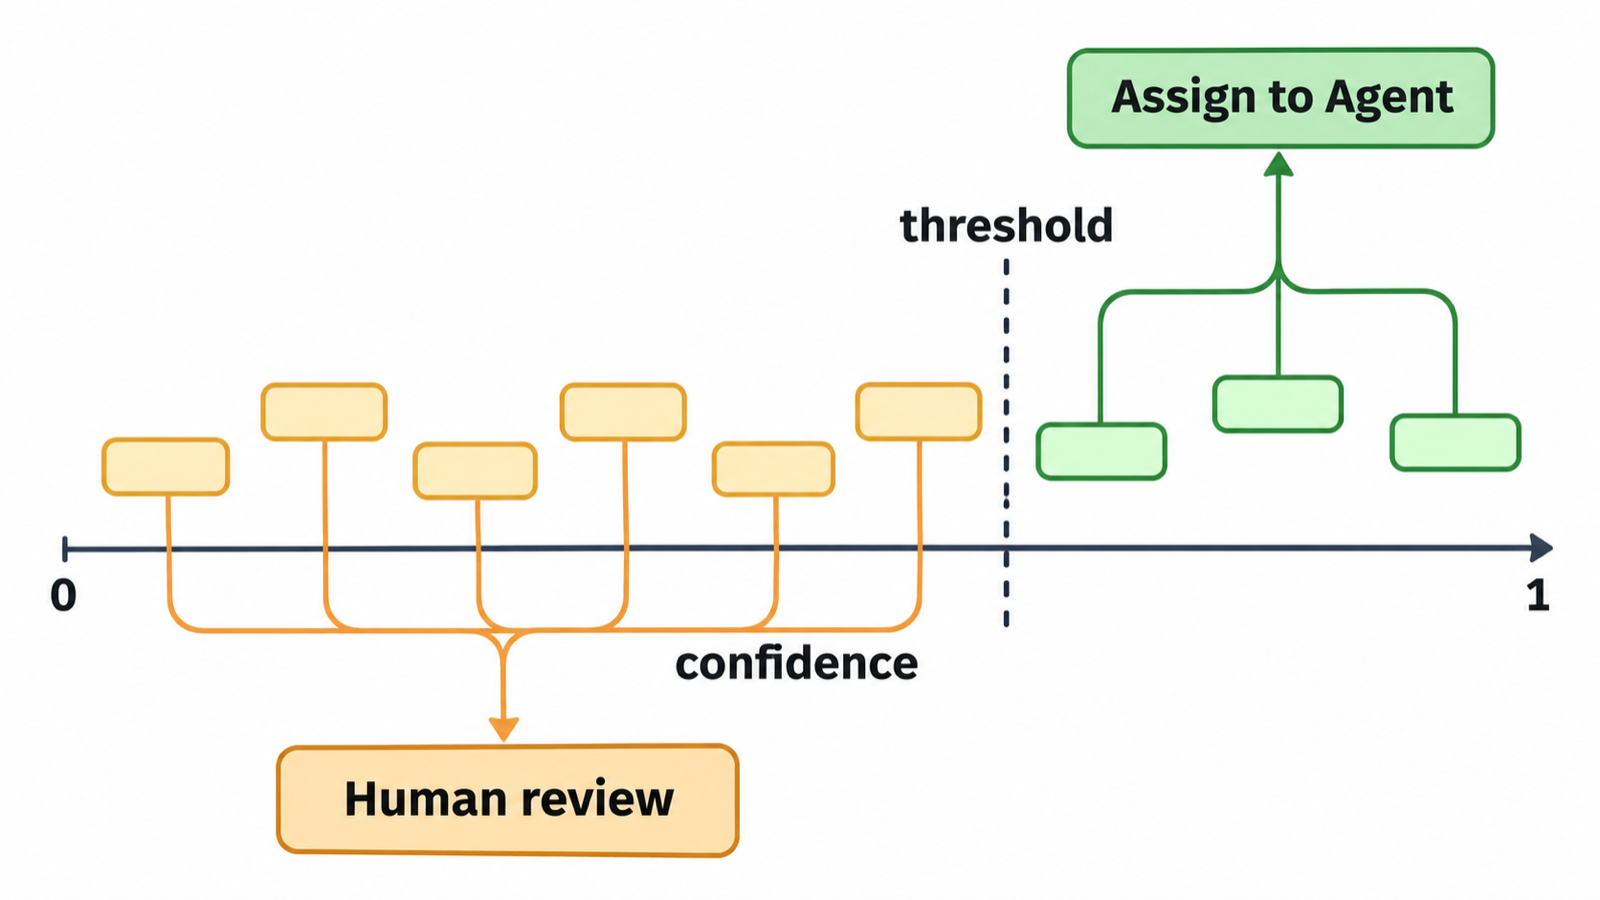
تحدد لك قيمة الإجابة الإجراء المطلوب اتخاذه، بينما تُبيّن لك درجة الثقة ما إذا كان بالإمكان تنفيذه تلقائياً دون استشارة بشرية. ففي أسئلة الاختيار (choice)، تعادل درجة الثقة احتمال الخيار الأعلى. أما في أسئلة (noul)، فهي تساوي max(noul, 1 - noul).
إليك طبقة اتخاذ القرار:
AUTO = 0.75      # assign without a person above this
HARD = 2.4       # difficulty score that earns the strong-model Agent

def decide(a):
    if a["needs_human"].noul >= 0.5:
        return ("human", "needs a decision first")
    if a["agent"].choice == "other" or a["agent"].confidence < AUTO:
        return ("human", f"router unsure ({a['agent'].confidence:.2f})")
    tier = "strong" if a["difficulty"].score >= HARD else "default"
    return (f"{a['agent'].choice}-{tier}", "auto")
لا تعتمد القيمة 0.75 بشكل أعمى؛ إذ توصي Google بضبط حدود الثقة استناداً إلى أمثلة مصنفة من بيانات مهامك الفعلية. اجمع آخر 50 إلى 100 مهمة مكتملة، وسجل الوكيل الذي أنجز كلاً منها، ثم مررها عبر ask(). بعد ذلك، حدد أدنى حد ثقة تتطابق عنده نتائج التوجيه التلقائي مع ما قام به فريقك بالفعل. فتوجيه المهمة تلقائياً بشكل خاطئ سيكلفك تشغيلاً فاشلاً وإعادة إسناد، بينما تعليق المهمة لمراجعة بشرية دون داعٍ لن يكلف سوى بضع دقائق. فوازن بين هذين الاعتبارين بدلاً من الاعتماد على رقم تقريبي عشوائي.
احذر من فخين: أولاً، لا يتجاوز احتمال noul القيمة 0.99 أبداً، مما يعني أن شرطاً مثل > 0.99 لن يتحقق مطلقاً. ثانياً، قد تعني درجة التقييم (score) البالغة 1.5 إما "تأرجحاً متساوياً بين المستويين 1 و2" أو "عدم يقين عبر المستويات الأربعة جميعها"؛ لذا حينما يتطلب الأمر تدقيقاً إضافياً، اطلع على قيم probabilities أيضاً.
ربط الموجّه بلوحة Sharkly
كود الموجّه مكتوب بلغة Python نقية، مما يتيح تشغيله في أي بيئة. وعلى لوحة Sharkly، فإن أنسب لحظة لتشغيل الموجّه هي فور أن تصبح المهمة جاهزة للبدء.
1. أنشئ وكيلاً واحداً لكل مسار وفئة. على سبيل المثال: backend-default وbackend-strong وfrontend-default. ووفقاً لـ توثيق وكلاء Sharkly، يتبع كل وكيل افتراضياً نموذج بيئة التشغيل الخاصة به، ويتيح لك صف النماذج اختيار نموذج آخر من قائمة تلك البيئة. وهنا يتحول تقدير الصعوبة إلى تحديد لنوع النموذج المستخدم.
2. تطبيق القرار عبر أداة سطر الأوامر sharkly.
import subprocess

def apply(task_id, target, reason, a):
    note = (f"Router: agent={a['agent'].choice} ({a['agent'].confidence:.2f}), "
            f"difficulty={a['difficulty'].score:.1f}, "
            f"needs_human={a['needs_human'].noul:.2f}")
    if target == "human":
        subprocess.run(["sharkly", "task", "comment", task_id,
                        "--body", f"{note}. Held for a person: {reason}."], check=True)
        return
    subprocess.run(["sharkly", "task", "edit", task_id,
                    "--delegate-agent", target], check=True)
    subprocess.run(["sharkly", "task", "comment", task_id, "--body", note], check=True)
يؤدي إسناد الوكيل إلى بدء تشغيله فور أن تصبح المهمة في حالة الجاهزية. وتدوين الاحتمالات في تعليق على المهمة أمر بالغ الأهمية يفوق ما يبدو عليه؛ فهذا هو السبيل لتدقيق قرارات الموجّه ومراجعتها بعد شهر من الآن.
3. تشغيل الموجّه عند تغير حالة المهمة. تخزن ميزة الأتمتة (Automation) في Sharkly التعليمات، والوكيل المُسند إليه، ومحفزات التشغيل. امنح وكيلاً صغيراً لتوجيه المهام تعليمة بسيطة: "قم بتشغيل route.py على المهمة التي أطلقت تشغيلك"، ثم أضف محفز حالة مهمة للحالة التي يعتمدها فريقك للإشارة إلى أنها "جاهزة". ترتبط عمليات التشغيل التي يُطلقها هذا المحفز مباشرة بتلك المهمة، مما يحفظ سجل التوجيه جنباً إلى جنب مع العمل المنجز. يمكن تنفيذ ذلك عبر سطر الأوامر كالتالي:
sharkly automation trigger create <automation-id> --kind task_event --to-status "Ready"
تكلفة استدعاء التوجيه
تبلغ تكلفة نموذج Gemini Decision 1 نحو 0.10 دولار لكل مليون رمز إدخال و0 دولار لرموز الإخراج، وفقاً لما أعلنته Google في منشور الإطلاق. وتُحسب تكلفة المدخلات المشتركة مرة واحدة فقط لكل طلب، مهما كان عدد الأسئلة المطروحة.
| العنصر | الرموز (تقدير تقريبي) |
|---|---|
| عنوان المهمة ووصفها | 2,000 |
| ثلاثة أسئلة مع معاييرها | 300 |
| الإجمالي لكل استدعاء توجيه | 2,300 |
| 1,000 مهمة موجّهة | 2.3 مليون، حوالي 0.23 دولار |
تكلفة هذا الموجّه أقل من تكلفة تشغيل وكيل واحد على مهمة واحدة. وتوفر Google أيضاً فئة مجانية في AI Studio لإنشاء النماذج الأولية والتجربة.
قيود يجب معرفتها قبل الاعتماد عليه
تتوفر الواجهة حالياً بإصدار v1beta على Gemini Developer API، مع الإشارة إلى أن دعم Gemini في Google Cloud "قادم قريباً". وتوضح المستندات أنها لا تدعم التخزين المؤقت للسياق أو Batch API أو الاستدلال بوضعي Flex وPriority؛ مما يعني أن المدخلات المتكررة تُحتسب بالكامل في كل مرة. وتتوفر حدود معدل الاستخدام حسب الفئات في صفحة حدود الاستخدام لدى Google؛ فتحقق من الحدود المتاحة لك قبل توجيه كافة المهام عبر مفتاح واحد.
تعامل مع أوصاف المهام كمدخلات غير موثوقة تماماً؛ حيث يحذر التوثيق من أن النصوص المقدمة من المستخدمين قد تتضمن محاولات لتوجيه تصنيفها ذاتياً. فإذا كان هناك أشخاص من خارج فريقك يمكنهم إنشاء مهام، فاحرص على تعليق أي مهمة تمس المصادقة، أو المدفوعات، أو بيانات بيئة الإنتاج للمراجعة البشرية، بغض النظر عن قرار الموجّه.
إن نتائج الاختبارات المعيارية التي تعلنها Google (مثل أدنى خطأ معايرة ضمن فئتها، والتكلفة الأقل بنحو 5 أضعاف مقارنة بنموذج Gemini 3.5 Flash-Lite عبر Interactions API) تمثل أرقام Google الخاصة. وتظل مهامك الفعلية المصنفة هي المقياس الحقيقي الذي يجب التعويل عليه.
متى يكون استدعاء التوجيه أداة غير مناسبة؟
استخدم استدعاء Decisions عندما تتوالى المهام بوتيرة أسرع من قدرة الفريق البشري على فرزها وتصنيفها، وتكون الخيارات محددة مسبقاً: مجموعة من الوكلاء، أو فئات معينة، أو قرار بنعم/لا. ولكن اعتمد على قاعدة برمجية بسيطة إذا كان هناك وسم يحدد الوجهة بالفعل؛ فإذا كانت كل مهمة تحمل وسم docs تُوجّه تلقائياً إلى وكيل التوثيق، فإن جملة شرطية بسيطة مثل if ستكون بلا تكلفة ولن تخطئ أبداً.
في المقابل، استخدم نموذجاً توليدياً إذا كنت بحاجة إلى أن يوضح الموجّه أسباب قراره بنص إنشائي، أو يُعيد صياغة المواصفات، أو يقسم المهمة إلى مهام فرعية؛ إذ تُرجع Decisions API أرقاماً لا نصوصاً. أما إذا أردت توزيع العمل عبر عدة أدوار، فمن الأنسب استخدام طاقم عمل يتولى قائده تقسيم الهدف الرئيسي؛ راجع مقالنا حول توجيه النماذج لفرق الوكلاء.
خاتمة
يُعد توجيه المهام قراراً ذا خيارات محددة ومغلقة، وقد صُممت Gemini Decisions API خصيصاً لمثل هذا النوع من القرارات: استدعاء واحد، وإجابات محددة النوع، ودرجة ثقة يمكن تعيين حد أدنى لها، وتكلفة لا تتجاوز أجزاءً من السنت الواحد. وما تبقى من عمل يقع على عاتقك: اكتب توصيفاً واضحاً للخيارات، واضبط حد الثقة بناءً على مهامك السابقة المكتملة، وأحل الحالات ذات الثقة المنخفضة إلى مراجع بشري.
ابدأ بمسار واحد؛ وجّه مهام الواجهة الخلفية الجديدة لمدة أسبوع، وقارن قرارات الموجّه بما كان سيتخذه فريقك، ثم وسّع نطاق تطبيقه تدريجياً. ولتشغيل الموجّه على لوحة مهام فعلية تجمع بين الوكلاء، والأتمتة، والمراجعة البشرية في مكان واحد، يمكنك البدء مع Sharkly.
الأسئلة الشائعة
ما هي Gemini Decisions API؟
هي نقطة نهاية برمجية ضمن Gemini API أُطلقت في 11 نوفمبر 2026، تجيب عن أسئلة نعم/لا، وأسئلة الاختيار، وأسئلة التقييم المتعلقة بالنصوص، أو الصور، أو المقاطع الصوتية، أو مقاطع الفيديو، أو ملفات PDF. وتُرجع احتمالات ودرجات ثقة معايرة بدقة بدلاً من توليد نصوص، معتمدة على النموذج gemini-decision-1.
كم تبلغ تكلفة Gemini Decision 1؟
حددت Google التكلفة بنحو 0.10 دولار لكل مليون رمز إدخال و0 دولار لرموز الإخراج، مع احتساب تكلفة المدخلات المشتركة مرة واحدة فقط لكل طلب. وتتوفر فئة مجانية في Google AI Studio لبناء النماذج الأولية والتجربة.
كم عدد الأسئلة التي يمكن تضمينها في الطلب الواحد؟
بين سؤال واحد و1,000 سؤال، بحد أقصى لسياق البيانات يبلغ 262,144 رمزاً تشمل المدخلات وكافة الأسئلة مجتمعة. وتستوعب أسئلة الاختيار ما بين خيارين إلى 255 خياراً.
ما هو حد الثقة الذي ينبغي استخدامه لتوجيه المهام؟
لا يوجد رقم موحد يناسب الجميع. توصي Google بتحديد حدود الثقة استناداً إلى أمثلة مصنفة من بيانات مهامك الفعلية؛ أعد اختبار 50 إلى 100 مهمة مكتملة وحدد الحد الذي تتطابق عنده الاختيارات التلقائية مع اختيارات فريقك.
هل يمكن لـ Decisions API اختيار النموذج الذي يستخدمه الوكيل؟
بصورة غير مباشرة؛ حيث يمكنك طرح سؤال تقييم (score) لتحديد مستوى الصعوبة، ثم ربط الدرجات المرتفعة بوكيل تم تهيئته بنموذج أقوى. وفي Sharkly، يمكن ضبط كل وكيل ليعمل بنموذج يتم اختياره من قائمة بيئة التشغيل الخاصة به.
هل واجهة Gemini Decisions API متاحة على Vertex AI؟
ليس بعد؛ فقد أوضح منشور الإطلاق من Google أن الدعم لـ Gemini في Google Cloud قادم قريباً. وتعمل الواجهة حالياً عبر Gemini Developer API بإصدار v1beta.

