
معظم الفرق التي تشغّل عدة وكلاء برمجة تضع في مرحلة ما سقفًا شهريًا للإنفاق على النماذج، عادةً بعد أسبوع سيئ. تختار رقمًا، وتحدّ من التوازي حتى تبقى الفاتورة تحته، ثم تعيد النظر في الربع التالي. وفي 2026-09-22، توقّف ذلك الرقم بهدوء عن حمل المعنى الذي كان يحمله.
أطلقت OpenAI نموذج GPT-6 Sol بسعر دولارين لكل مليون رمز إدخال و10 دولارات لكل مليون رمز إخراج، بمعرّف API هو gpt-6-sol، ونشرت شيئًا أكثر فائدة من سعر الرموز: التكلفة لكل مهمة. على AutomationBench 1.0.6، يسجّل Sol عند مستوى جهد استدلالي مرتفع جدًا نسبة 33.2% بتكلفة 0.27 دولار لكل مهمة. أما Claude Opus 5 عند أقصى جهد فيسجّل 26.9% بتكلفة تعادل 11.1 ضعف تكلفة Sol لكل مهمة على المنصة نفسها.
لذا احسب ما يشتريه سقفك الحالي قبل أن ترفعه. الجواب عند معظم الفرق أنه يشتري بالفعل عددًا من عمليات التشغيل المكتملة أكبر مما يستطيع أي شخص قراءته. وهذا يعني أن السقف لم يكن يحمي الميزانية يومًا. كان يحمي المراجعين لديك، عن غير قصد، وهو على وشك أن يتوقف عن ذلك.
باختصار
التكلفة لكل تغيير مقبول هي ما ينفقه فريقك على استدلال النماذج مقابل كل فرق برمجي (diff) يقرأه شخص فعليًا ويقبله، وهي الرقم الوحيد لتكلفة الوكلاء الذي يتصل بالعمل المُسلَّم فعلًا. وبالأسعار المنشورة، تكلّف الطاقة المراجَعة الشهرية الكاملة لفريق من أربعة مراجعين نحو 136 دولارًا من GPT-6 Sol. لقد انتقل القيد الفعلي من الفاتورة إلى خطوة القبول، ولا يوجد أي إصدار نموذج يمسّ ذلك. الوكلاء يبحثون وينفّذون ويختبرون ويقدّمون التقارير. أما البشر فيحدّدون الاتجاه، ويمنحون الصلاحية، ويقبلون النتيجة.
الأرقام التي نشرتها OpenAI فعلاً
تنشر OpenAI الدرجة إلى جانب التكلفة لكل مهمة، وهو أمر يتّسم بصراحة غير معتادة وأكثر فائدة بكثير من قائمة أسعار.
| النموذج، عند مستوى الجهد الذي استخدمته OpenAI | AutomationBench 1.0.6 | التكلفة لكل مهمة |
|---|---|---|
| GPT-6 Sol، مرتفع جدًا | 33.2% | 0.27 دولار |
| GPT-6 Astra، منخفض | 30.3% | 3.9 ضعف Sol |
| Claude Opus 5، أقصى | 26.9% | 11.1 ضعف Sol |
| Fable 5.1 مع الرجوع إلى Opus 5، أقصى | 31.4% | أكثر من 8.9 ضعف Sol |
ملخّص OpenAI نفسه للصفّين الأول والثالث: يتفوّق Sol عند الجهد المرتفع جدًا على Opus 5 عند أقصى جهد بنحو 9% من تكلفة Opus 5 لكل مهمة. ويتكرّر النمط ذاته في مواضع أخرى من منشورها. على Agents’ Last Exam V1، يسجّل Sol عند أقصى جهد 56.4%، متجاوزًا أفضل نتيجة لـ Opus 5، بتكلفة أقل بنسبة 60% لكل مهمة. وعلى DeepSWE 1.1، يسجّل Sol عند أقصى جهد 68.8%، بفارق 1.1 نقطة مئوية عن Fable 5 عند الجهد المرتفع جدًا (69.9%)، وبسعر أرخص بنحو 80% لكل مهمة.
هناك تحفّظان يرافقان هذه الأرقام ولا يظهران معها عادةً. العنوان الرئيسي عند OpenAI هو أن Sol و Luna أرخص بنسبة 50% لكل منهما من تسعير GPT-5.6 الترويجي، وكلمة «الترويجي» هنا من OpenAI نفسها: فالمقارنة تجري مقابل سعر مخفّض. كما أن OpenAI قاست الأداء مقابل Claude Opus 5، لأن Claude Opus 5.5 صدر بعد ساعات بسعر 4 و20 دولارًا لكل مليون مقابل 5 و25 دولارًا لـ Opus 5. وعمود Opus 5 هو آخر مقارنة منشورة، لا المقارنة الحالية.
كيف تتحوّل الميزانية إلى عمليات تشغيل
اضرب 0.27 دولار في 11.1، وستجد أن Opus 5 عند أقصى جهد يبلغ نحو 3.00 دولارات لكل مهمة على تلك المنصة. وهذه العملية الحسابية من إعدادنا، انطلاقًا من رقمَي OpenAI. اقسم سقفك الشهري على كل منهما وستحصل على الجدول الذي يغيّر طريقة قراءتك للسقف.
| الميزانية الشهرية للنماذج | المهام على Sol، مرتفع جدًا | المهام على Astra، منخفض | المهام على Opus 5، أقصى |
|---|---|---|---|
| 250 دولارًا | نحو 925 | نحو 240 | نحو 83 |
| 1,000 دولار | نحو 3,700 | نحو 950 | نحو 330 |
| 5,000 دولار | نحو 18,500 | نحو 4,750 | نحو 1,660 |
تكلفة المهمة في أي مقياس أداء ليست تكلفتك أنت لكل مهمة. فمهام AutomationBench مصمّمة على شكل اختبارات قياس: محدودة وقصيرة ولا تشبه إطلاقًا تذكرة حقيقية في مستودع برمجي يحمل سنوات من التاريخ. وقد تستهلك مهامك الفعلية عشرة أضعاف الرموز أو مئة ضعف. وما ينتقل بين المقياس ومستودعك هو النسبة بين النماذج، لا الرقم المطلق بالدولار. تعامل مع الجدول باعتباره شكل التغيّر، ثم قِس بنفسك تكلفة التشغيل عبر الوكلاء وأعد القياس وفقها.
وهناك تصحيح ثانٍ يسير في الاتجاه المعاكس. فالتكلفة لكل مهمة تُحسب لكل محاولة، لا لكل نجاح. وعند نسبة المقياس نفسه البالغة 33.2%، تفشل نحو محاولتين من كل ثلاث، ما يعني أن Sol يكلّف نحو 0.81 دولار لكل نجاح في المقياس، وOpus 5 عند أقصى جهد نحو 11.15 دولارًا. وهذا حسابنا نحن أيضًا، وهو تقريبي، لأن معدل النجاح في مقياس أداء ليس معدل القبول لدى فريقك. الاتجاه هو ما يهم: فتكلفة تجربة شيء ما مرتين صارت الآن صغيرة بما يكفي ليصبح أسلوب إعادة المحاولة خيارًا تصميميًا لا قرارًا ميزانيًا.
أين يقع السقف الآن
لنضع جانب المراجعة على الصفحة نفسها. المراجع الذي يقرأ الفرق البرمجي قراءة سليمة، ويفهم ما اختاره الوكيل، ويتحمّل مسؤولية النتيجة، ينجز عددًا معينًا من التغييرات في يوم عمل. لنقُل ستة، وعليك تعديلها بما يناسب فريقك.
| المراجعون | التغييرات المقبولة شهريًا | تكلفة Sol عند 0.27 دولار | تكلفة Opus 5 عند أقصى جهد و3.00 دولارات |
|---|---|---|---|
| 1 | نحو 126 | 34 دولارًا | 378 دولارًا |
| 2 | نحو 252 | 68 دولارًا | 756 دولارًا |
| 4 | نحو 504 | 136 دولارًا | 1,512 دولارًا |
| 8 | نحو 1,008 | 272 دولارًا | 3,024 دولارًا |
ستة تغييرات مقبولة لكل مراجع يوميًا على مدى 21 يوم عمل، وهذا افتراضنا وحسابنا. ضع أرقامك أنت وستبقى النتيجة صامدة: كل ما يستطيع فريق هندسي عادي قبوله فعليًا في شهر يكلّف بضع مئات من الدولارات من الاستدلال، حتى عند الطرف الأغلى. سقف قدره 1,000 دولار لفريق من أربعة أشخاص ليس قيدًا. إنه نحو سبعة أضعاف ما يستطيع الفريق استيعابه من مخرجات الوكلاء.
وهذا هو جوهر خفض الأسعار بالنسبة لفريق يراجع عمله. فهو لم يرفع إنتاجيتك. بل أزال العذر الأخير لبقاء الطابور قصيرًا، وكشف عن اختناق كان دائمًا مرحلة المراجعة البشرية.
الإنفاق الداخلي لدى OpenAI هو المثال المقابل المفيد، لا التناقض. فالباحث الوسيط لديها يستهلك أكثر من 600 دولار يوميًا من الاستدلال عبر وكلاء البرمجة بأسعار API، بينما يبلغ المئين التسعون 7,000 دولار يوميًا. هذه أرقام حقيقية وتتجاوز بكثير الجدول أعلاه، لأن ذلك العمل له شكل مختلف: تشعّب هائل في العمليات، وتقييم آلي، ولا خطوة يقبل فيها شخص محدّد بالاسم كل نتيجة في فرع الإنتاج. وإذا كانت عمليتك تتضمن تلك الخطوة، فستبقى فاتورة النماذج صغيرة ولن تبقى قائمة الانتظار كذلك.
على ماذا تنفق الهامش المتاح
بمجرد ألا تكون الميزانية قيدًا، يتوقف السؤال عن عدد عمليات التشغيل التي تشتريها ليصبح: على ماذا تنفق الفارق؟ وهناك إجابتان تقلّلان العمل الواصل إلى المراجع بدل أن تزيده.
اشترِ الجهد، لا الحجم. مستوى جهد الاستدلال هو مقبض للتحكم في التكلفة، وجدول OpenAI نفسه يستخدم مستويات مختلفة لمقاييس أداء مختلفة. ورقم 0.27 دولار هو صف الجهد المرتفع جدًا، أي أن العلاوة مقابل تشغيل أكثر تمعّنًا مدمجة أصلًا في رقم يعادل 9% من البديل. ودفعها على العدد نفسه من المهام لا يكلّف شيئًا تقريبًا، وينتج فروقًا برمجية تحتاج وقتًا أقل للفحص.
اشترِ الذاكرة المؤقتة، لا الرموز. يمنح GPT-6 خصمًا بنسبة 90% على قراءات الإدخال المخزّنة مؤقتًا، ويحافظ على معدلات إصابة أعلى افتراضيًا، ولم يعد يبطل الذاكرة المؤقتة عند تغيير جهد الاستدلال أو توفّر الأدوات. وتتيح لك نقاط التوقف الصريحة تحديد مكان انتهاء البادئة المخزّنة. وتشير OpenAI إلى أن GitHub شهد انخفاضًا يزيد على 50% في رموز الأوامر التي تحتاج معالجة جديدة عبر مليارات الطلبات. وبالنسبة لـ Crew، يمثّل هذا الفرق بين الوكيل الأول على المستودع والوكيل العاشر: فهي تعيد إرسال البادئة نفسها تقريبًا من البنية والقواعد الداخلية والأعراف، وهذه البادئة تحديدًا هي ما وُجدت الذاكرة المؤقتة من أجله. تكلفة الرموز الخاصة بسياق المستودع هي حيث تقع فاتورة أي أسطول وكلاء فعليًا.
وهذا هو الثنائي الصادق في اتخاذ القرار: ارفع عدد عمليات التشغيل المتزامنة عندما تتقارب العمليات الإضافية في نتيجة واحدة يقبلها شخص، مثل ثلاث محاولات لترحيل واحد تختار فيها مجموعة الاختبارات الفائز. ولا ترفعه عندما تنتج كل عملية تشغيل فرقها البرمجي الخاص وملخّصها الخاص وقرار قبولها الخاص، مهما صارت عمليات التشغيل رخيصة. في الحالة الثانية، لن تجد ما توسّع جيدًا سوى الفاتورة.
اجعل السقف الجديد قابلًا للعد
كانت الميزانية مؤشرًا سيئًا للطاقة الاستيعابية، لكنها تمتعت بميزة واحدة: كانت رقمًا يراقبه أحدهم. استبدلها بالرقم الذي يمثّل القيد الآن، أي عمليات التشغيل المكتملة التي تنتظر شخصًا.
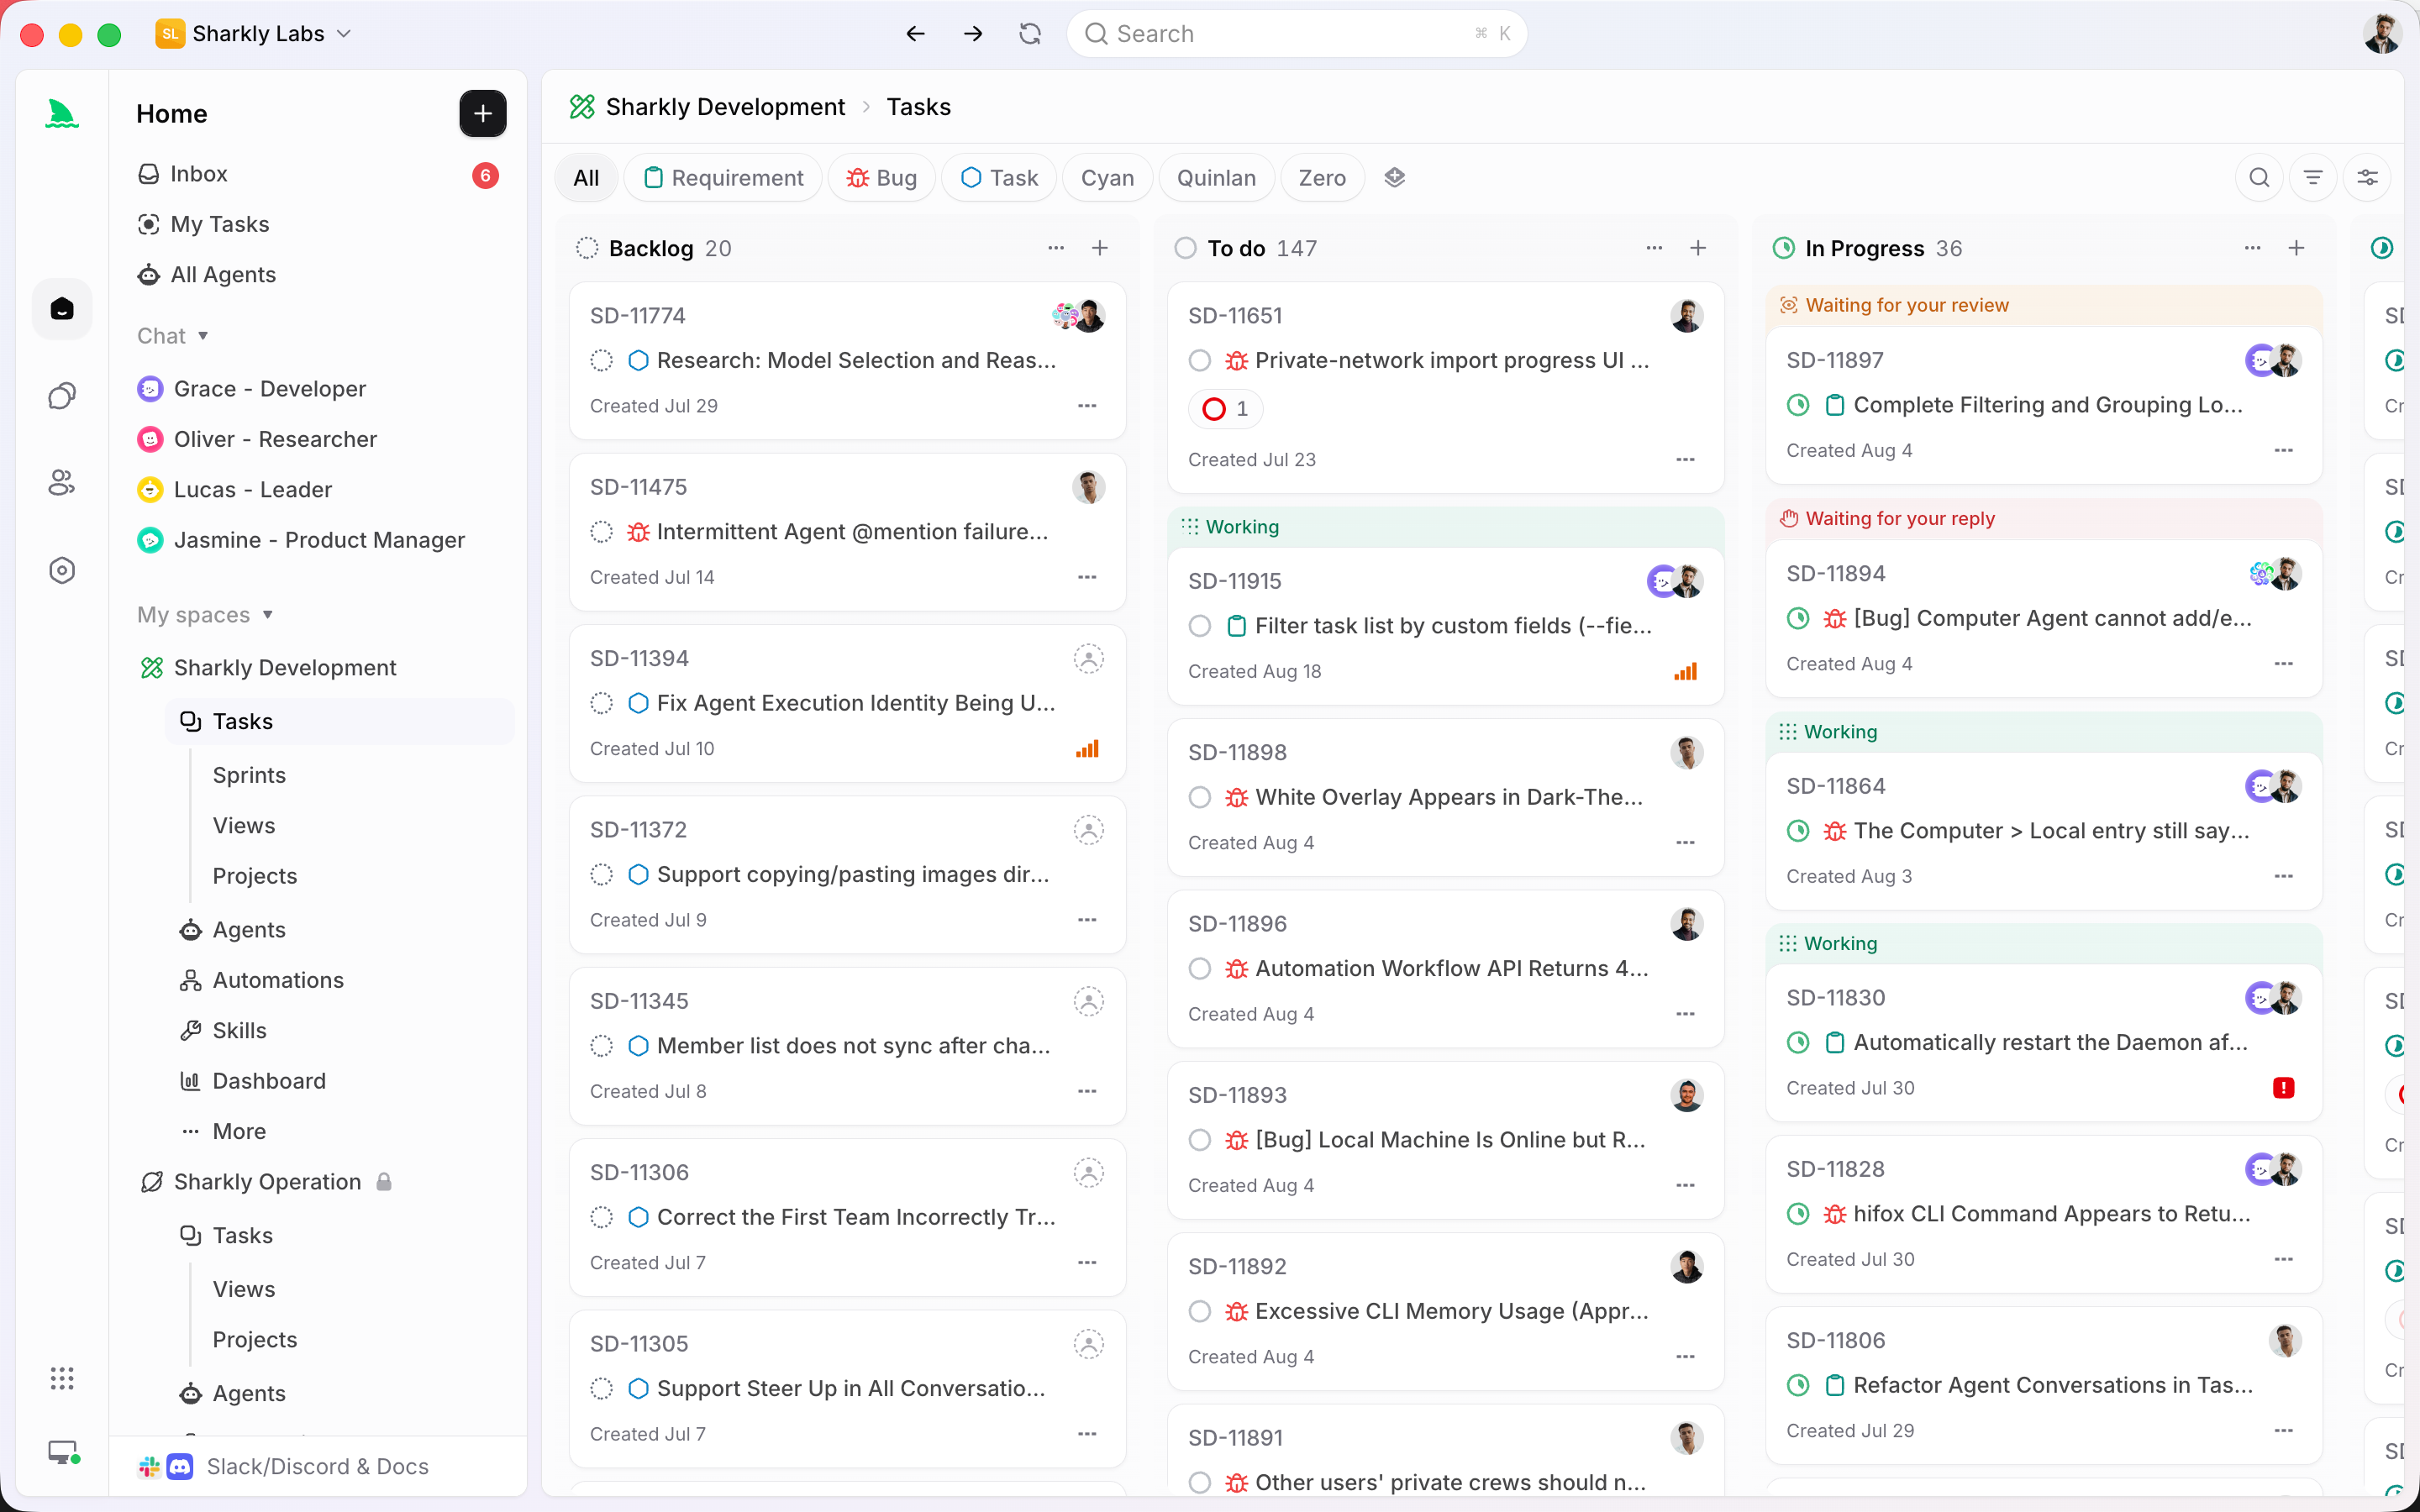
لكن هذا لا يصبح قابلًا للقياس إلا إذا توقفت عمليات التشغيل عن الاحتباس في الطرفيات الخاصة. وSharkly ليست بديلًا عن Codex أو Claude Code أو الأدوات الأخرى التي تشغّل هذه النماذج. إنها الطبقة المحيطة بها، حيث يبقى السياق والتقدم والعوائق والنتائج والمراجعة البشرية ظاهرة من الطلب حتى الإصدار. وتعود عمليات التنفيذ والعوائق إلى المهمة، فيتحوّل «انتظار إنسان» إلى حالة يمكن عدّها على لوحة متابعة بدل أن يكون شعورًا ينتابك مساء الجمعة. ولا تعمل حسابات طاقة المراجعة إلا إذا كنت ترى قائمة الانتظار.
إذا كنت تشغّل بالفعل عدة وكلاء برمجة، فالخطوة المطلوبة هذا الأسبوع ليست رفع السقف، بل معرفة عدد عمليات التشغيل المكتملة التي يقبلها فريقك في أسبوع عادي، وضبط التوازي بناءً على ذلك، وإنفاق الميزانية المتبقية على عمليات تشغيل يسهل قبولها.


