Evaluieren Sie Claude Fable 5.2 anhand repräsentativer Aufgaben aus Ihrem Repository mit festen Akzeptanzkriterien, identischen Umgebungen und einer Baseline, die Sie bereits nutzen. Messen Sie akzeptierte Änderungen, Review-Aufwand, Durchlaufzeit und Gesamtkosten gemeinsam. Wiederholen Sie Durchläufe, dokumentieren Sie Fehlversuche und entscheiden Sie über den produktiven Einsatz nach Aufgabenkategorie statt anhand eines einzelnen Benchmark-Werts.
Anthropic hat Fable 5.2 am 9. November 2026 angekündigt. Die Ankündigung verspricht Verbesserungen beim Coding und beim logischen Schließen (Reasoning). Dabei handelt es sich um Herstellerangaben auf Basis eigener Evaluierungen und Tests. Sie belegen nicht, wie das Modell mit Ihren Abhängigkeiten, Konventionen und Release-Anforderungen zurechtkommt.
Ihre Evaluierung sollte eine konkretere Frage beantworten: Welche Aufgaben können Sie mit einem vertretbaren Review-Aufwand delegieren? Wenn sich bereits mehrere Coding-Agents diese Arbeit teilen, bietet Ihnen Sharkly eine zentrale Plattform, um die Aufgaben und ihren Review-Kontext zu organisieren.
Dieser Leitfaden stellt ein experimentelles Vorgehen vor. Er enthält keine gemessenen Vergleichsergebnisse.
Ein repräsentatives Aufgabenset zusammenstellen
Eine Repository-Evaluierung ist ein kontrollierter Vergleich von Coding-Workflows anhand von Anforderungen aus Ihrer eigenen Entwicklungsarbeit. Die Maßeinheit für Erfolg ist eine akzeptierte Änderung – inklusive ihrer Tests und des Reviews. Ein plausibler Patch, ein erfolgreicher Testlauf oder eine selbstsichere Erfolgsmeldung allein bedeuten noch keine Freigabe.
Beginnen Sie mit zwölf Aufgaben aus aktuellen Wartungsarbeiten. Diese Zahl ist eine Richtgröße für ein Pilotprojekt, keine statistische Garantie. Berücksichtigen Sie Bugfixes, kleinere Erweiterungen, Refactorings und Analyseaufgaben in einem Verhältnis, das Ihrem Backlog entspricht.
Wählen Sie Aufgaben mit einem eindeutigen Ausgangs-Commit und einem Reviewer, der das erwartete Verhalten kennt. Vermeiden Sie es, nur Issues mit offensichtlichen Lösungen auszuwählen. Nehmen Sie mindestens eine Aufgabe auf, bei der die korrekte Reaktion darin besteht, eine Rückfrage zu stellen oder eine fehlende Abhängigkeit aufzuzeigen.
Entfernen Sie bei historischen Issues die Lösung aus dem übergebenen Kontext. Dokumentieren Sie, ob der Fix bereits öffentlich verfügbar war, da das Modell ihn möglicherweise schon im Training gesehen hat. Behalten Sie ein separates Set unveröffentlichter Aufgaben für eine spätere Bestätigungsrunde zurück.
Definieren Sie die Akzeptanzkriterien vor jedem Testlauf. Bei einem Fix für API-Paginierung sollten Sie leere Ergebnisse, Seitengrenzen, ungültige Cursor und die Kompatibilität mit bestehenden Clients festlegen. Bestimmen Sie zudem den zulässigen Umfang der Änderungen sowie die für die Abnahme erforderlichen Prüfungen.
| Kategorie | Beispielaufgabe | Akzeptanznachweis |
|---|---|---|
| Bugfix | Korrektur des Handlings von Cursor-Grenzen | Regressionstest und bestehende Suite erfolgreich |
| Kleine Erweiterung | Optionale Request-Filterung hinzufügen | Contract-Tests und dokumentierte Standardwerte |
| Refactoring | Duplizierte Validierung auslagern | Unverändertes öffentliches Verhalten und Review |
| Analyse | Intermittierenden Timeout diagnostizieren | Reproduktion und fundierte Ursachenerklärung |
Nutzen Sie kleine Aufgaben, wenn Sie einen sauberen Vergleich benötigen. Setzen Sie größere Aufgaben ein, wenn Koordination Teil der Fragestellung ist, und bewerten Sie dieses Experiment separat.
Rahmenbedingungen vor dem Ausführen der Agents fixieren
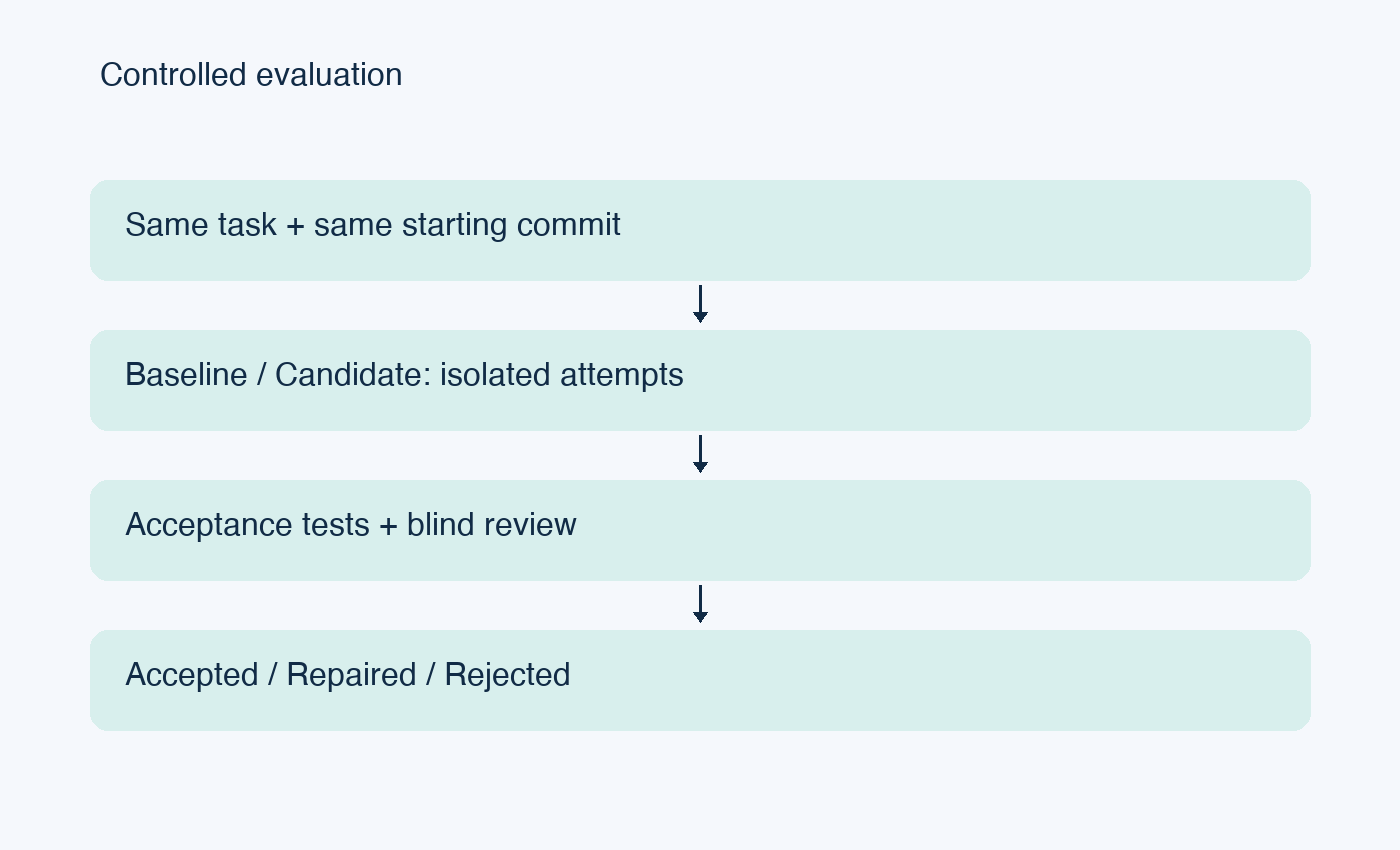
Erfassen Sie den Repository-Commit, das Betriebssystem, Lockfiles der Abhängigkeiten, Tool-Versionen, Modell-Identifier und die Konfiguration. Fixieren Sie auch das Agent-Harness – die Software, die dem Modell Tools, Kontext und Ausführungslogik bereitstellt.
Vergleichen Sie Fable 5.2 mit Ihrem aktuellen Workflow. Ein Modellvergleich erfordert nach Möglichkeit dasselbe Harness. Ein Workflow-Vergleich kann unterschiedliche Tools verwenden, muss in seinem Fazit jedoch die vollständigen Konfigurationen ausweisen.
Halten Sie Berechtigungen, Netzwerkzugriff, Ausgangskontext und Zeitlimits vergleichbar. Legen Sie fest, ob die Installation von Abhängigkeiten zur Durchlaufzeit zählt. Stellen Sie sicher, dass keine Konfiguration geänderte Dateien, Caches mit Teillösungen oder den Konversationsverlauf eines vorherigen Durchlaufs übernimmt.
Verwenden Sie für jeden Versuch einen frischen Checkout oder einen isolierten Worktree. Die Git-Worktree-Dokumentation erklärt, wie sich mehrere Arbeitsverzeichnisse ein Repository teilen. Die Isolation von Dateien trennt jedoch keine Datenbanken, Ports oder externen Dienste – stellen Sie auch dafür separate Testressourcen bereit.
Definieren Sie eine explizite Interventionsregel. Erlauben Sie beispielsweise eine einzige klärende Antwort, die ausschließlich Informationen enthält, die jeder Konfiguration zur Verfügung stehen. Erfassen Sie die gesamte Interventionszeit. Wenn ein Reviewer stillschweigend eine Implementierung korrigiert, verfälscht das die Messergebnisse des Experiments.
Gepaarte Versuche durchführen und Fehlversuche beibehalten
Führen Sie jede Konfiguration für dieselben Aufgaben aus. Wechseln Sie die Ausführungsreihenfolge ab, damit temporäre Service-Verzögerungen nicht systematisch einen Kandidaten begünstigen. Wiederholen Sie Versuche, wenn die Ressourcen es erlauben, und legen Sie die Anzahl der Wiederholungen fest, bevor Sie die Ergebnisse einsehen.
Ein praxisnahes Pilotprojekt könnte drei Versuche pro Konfiguration und Aufgabe umfassen. Betrachten Sie dies als pragmatischen Ausgangspunkt. Eine kleine Stichprobe erlaubt keine präzisen Aussagen über seltene Fehler oder eine generelle Überlegenheit.
Speichern Sie für jeden Versuch den Prompt, die Konfiguration, Zeitstempel, das Transkript, den Patch, Tool-Ausgaben und das endgültige Ergebnis. Erfassen Sie Timeouts und abgebrochene Durchläufe als reguläre Ergebnisse. Würden Sie diese ausschließen, wirken die erfolgreichen Durchläufe günstiger und schneller, als der Workflow im tatsächlichen Einsatz wäre.
Trennen Sie Test-Fixtures und Zugangsdaten strikt von Produktionsumgebungen. Folgen Sie dem etablierten Testprozess Ihres Repositories. Für Python-Repositories beschreibt die pytest-Dokumentation Fixtures und Testausführung; das Framework nimmt Ihnen jedoch nicht die Entscheidung ab, ob Ihre Akzeptanzkriterien die Anforderung vollständig abdecken.
Korrektheit vor Geschwindigkeit prüfen
Lassen Sie den Patch nach Möglichkeit blind prüfen, ohne dass der Reviewer sieht, von welchem Modell er stammt. Nutzen Sie einen festen Kriterienkatalog, der die Erfüllung der Anforderungen, Regressionsrisiken, Wartbarkeit, Testqualität und überflüssigen Code abdeckt.
Erfolgreiche Tests sind erforderlich, wenn die Aufgabe dies verlangt – Tests können jedoch auch falsches Verhalten festschreiben. Prüfen Sie Assertions gegen die ursprüngliche Anforderung. Achten Sie auf deaktivierte Prüfungen, aufgeweichte Toleranzen, unterdrückte Fehler und Änderungen, die den fehlerhaften Pfad schlicht umgehen.
Unterscheiden Sie drei Ergebnisse: unverändert akzeptiert, nach Korrektur akzeptiert und abgelehnt. Erfassen Sie den Reparaturaufwand in Minuten sowie die Art der Korrektur. Entscheiden Sie vorab, ob korrigierte Änderungen in Ihre primäre Akzeptanzrate einfließen.
Bewerten Sie bei Analyseaufgaben die Beweiskette. Ein nützlicher Bericht benennt Beobachtungen, unterscheidet Hypothesen und liefert einen reproduzierbaren nächsten Schritt. Belohnen Sie keine selbstbewusst vorgetragenen Diagnosen ohne Belege.
Kosten pro akzeptierter Änderung berechnen
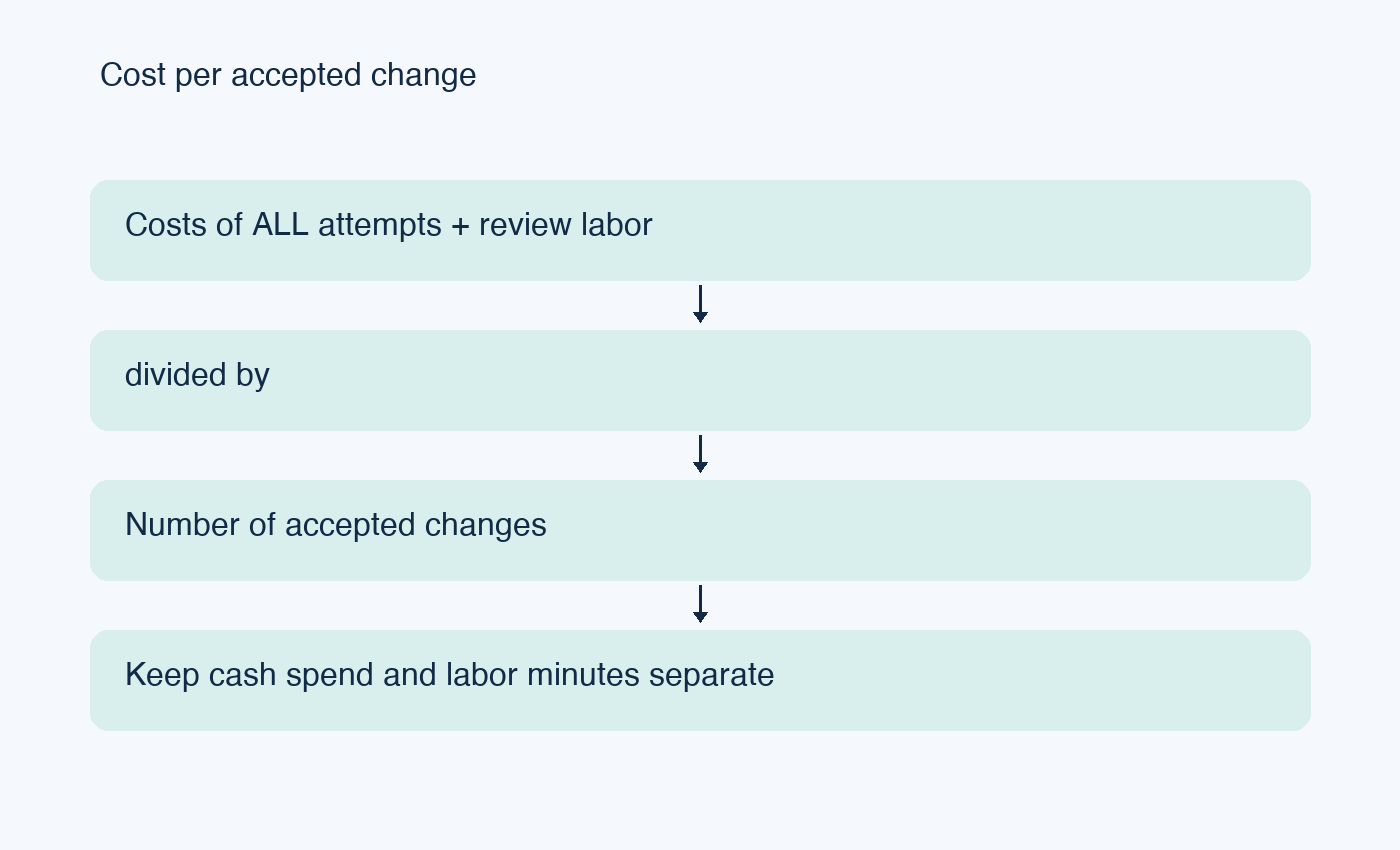
Die Kosten pro akzeptierter Änderung ergeben sich aus den Gesamtkosten der Evaluierung geteilt durch die Anzahl der nach Ihren vorab definierten Kriterien akzeptierten Änderungen. Berücksichtigen Sie fehlgeschlagene Versuche im Zähler. Werden keine Änderungen akzeptiert, weisen Sie die Gesamtkosten und null Abnahmen aus; die Kennzahl besitzt in diesem Fall keinen endlichen Wert.
Erfassen Sie diese Messwerte gemeinsam:
- Akzeptanzrate nach Aufgabenkategorie.
- Echtzeit (Wall-Clock Time) vom Start der Aufgabe bis zum reviewbereiten Ergebnis.
- Manueller Aufwand für Review und Korrekturen in Minuten.
- Modell- und Tool-Kosten für alle Versuche.
- Infrastrukturkosten, sofern relevant.
- Regressionen, die während des Beobachtungszeitraums festgestellt werden.
Dokumentieren Sie den Token-Verbrauch und die zugrundeliegende Preisliste mit Datum zusammen mit den abgerechneten Beträgen. Gecachte Tokens, Wiederholungsversuche und Ausführungstools können die Kosten erheblich beeinflussen. Schätzen Sie die Rechnung nicht allein anhand der Ausgabelänge.
Wenn Sie für die Review-Zeit einen monetären Stundensatz ansetzen, weisen Sie diesen als interne Annahme aus. Stellen Sie direkte Ausgaben und Arbeitsminuten getrennt dar, damit die Berechnung nachvollziehbar bleibt. Eine günstigere Codegenerierung kann dennoch mehr Engineering-Aufwand erfordern.
Evaluierungsdaten direkt am Vorgang hinterlegen
Sharkly koordiniert die Arbeitsabläufe rund um Coding-Agents. Der dokumentierte Workflow verbindet Tasks, Agents, Computers, Ausführungskontexte und menschliche Reviews. Konsultieren Sie die Sharkly-Dokumentation für die aktuelle Produktterminologie und das Setup.
Hinterlegen Sie für dieses Experiment die Akzeptanzkriterien direkt im jeweiligen Task und speichern Sie den Patch, die Testnachweise sowie das Ergebnis im selben Datensatz. Führen Sie die Evaluierungsübersicht in einer Tabelle oder einer versionierten Datei, falls sich dies einfacher analysieren lässt. Gehen Sie nicht davon aus, dass die Plattform Ihre Metriken automatisch ermittelt.
Verwenden Sie für einen abgegrenzten Testlauf einen einzelnen Agent. Setzen Sie eine Crew erst dann ein, wenn die Koordination selbst Gegenstand der Evaluierung ist. Ein Wechsel der Teamstruktur während des Versuchs führt eine zusätzliche Variable ein.
Agents führen Aufgaben aus und liefern Nachweise. Menschen definieren Akzeptanzkriterien, prüfen Änderungen und autorisieren Releases. Diese Aufgabenteilung bleibt auch dann sinnvoll, wenn der Code alle automatisierten Tests besteht.
Entscheidungen über den Einsatz nach Kategorie treffen
Legen Sie die Kriterien für eine Einführung fest, bevor Sie die Ergebnisse analysieren. Setzen Sie eine ausreichende Korrektheit als Grundvoraussetzung an und vergleichen Sie erst danach Kosten und Durchlaufzeit der Konfigurationen, die diese Hürde nehmen. Schließen Sie sicherheitskritische oder unzureichend getestete Bereiche vom anfänglichen Rollout aus.
Geben Sie neben Prozentwerten immer auch absolute Zahlen an. Ein Ergebnis von zwei akzeptierten Aufgaben aus drei hat eine völlig andere Aussagekraft als zweihundert von dreihundert. Beschreiben Sie Unsicherheiten und Fehlermuster, anstatt einen pauschalen Gewinner auszurufen.
Wiederholen Sie die Evaluierung nach wesentlichen Änderungen an Prompts, Harnesses, Modellversionen oder der Repository-Struktur. Bewahren Sie die frühere Konfiguration auf, damit spätere Verbesserungen gegen eine reproduzierbare Baseline verglichen werden können.
Beginnen Sie mit einer repräsentativen Wartungsaufgabe in Sharkly, versehen Sie diese mit eindeutigen Akzeptanzkriterien und vergleichen Sie die gelieferten Ergebnisse mit Ihrem aktuellen Workflow. Weiten Sie das Vorgehen erst aus, wenn Sie sowohl die Erfolge als auch die Fehlversuche nachvollziehen können.
FAQ
Kann ein öffentlicher Coding-Benchmark diese Evaluierung ersetzen?
Er kann bei der Vorauswahl helfen. Er berücksichtigt jedoch weder die Konventionen und Abhängigkeiten Ihres Repositories noch Ihre Review-Standards oder operativen Rahmenbedingungen.
Sollte bei jedem Versuch derselbe Prompt verwendet werden?
Verwenden Sie vergleichbare Aufgabeninformationen und eine vordefinierte Prompting-Richtlinie. Dokumentieren Sie tool-spezifische Wrapper, damit Unterschiede transparent und nachvollziehbar bleiben.
Zählen reparierte Patches als Erfolg?
Legen Sie die Regel vorab fest. Weisen Sie unverändert übernommene und nachgebesserte Abnahmen getrennt aus und beziehen Sie die Korrekturzeit in den Workflow-Vergleich ein.
Wie sollten Timeouts bewertet werden?
Werten Sie sie als Fehlversuche innerhalb des festgelegten Zeitbudgets. Beziehen Sie deren Kosten und Durchlaufzeiten in die Ergebnisse ein.
Wann sollte das Team den Rollout ausweiten?
Weiten Sie den Einsatz aus, sobald eine Aufgabenkategorie die Akzeptanzkriterien über mehrere Durchläufe hinweg zuverlässig erfüllt und die Reviewer typische Fehlermuster verstehen.
Weitere Ressourcen
Lesen Sie die Git-Dokumentation zur Repository-Isolation, den Leitfaden zu pytest-Fixtures für ein kontrolliertes Test-Setup und besuchen Sie Sharkly, um die Arbeit von Agents und manuelle Reviews strukturiert zu organisieren.