
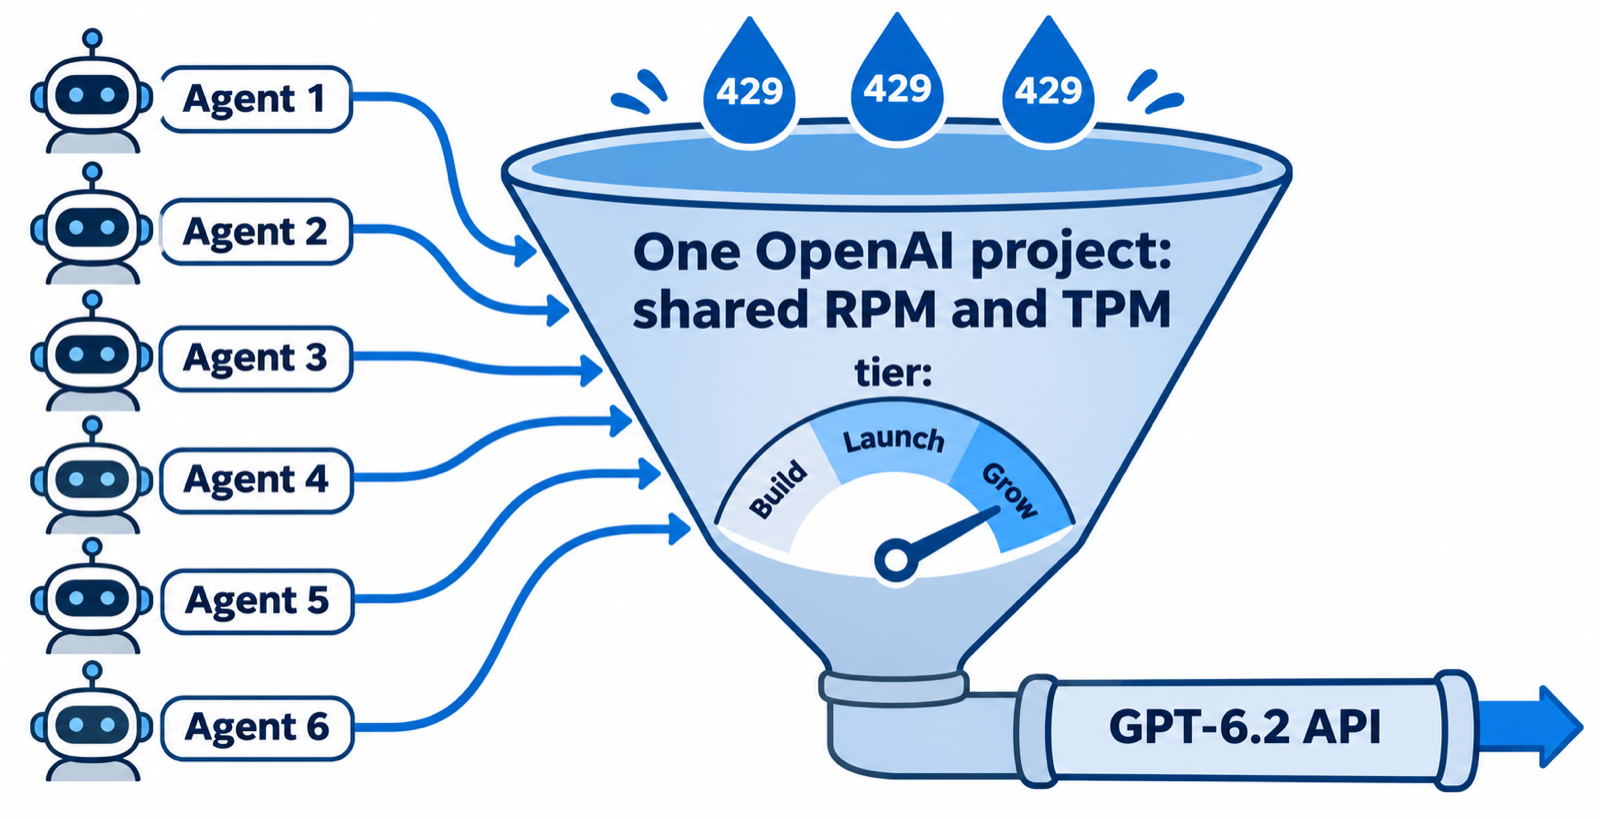
TL;DR: Die Rate Limits von GPT-6.2 sind in der API für Astra und Sol identisch: 5.000 RPM und 1.000.000 TPM auf dem Build-Tier, 10.000 RPM und 4.000.000 TPM auf Launch sowie 15.000 RPM und 40.000.000 TPM auf Grow. Die Limits gelten pro Organisation und pro Projekt, sodass sich alle Agents eines Keys sie teilen. Bei Agent-Teams gehen zuerst die Tokens pro Minute zur Neige, nicht die Requests.
OpenAI hat GPT-6.2 Astra und GPT-6.2 Sol am 17. November 2026 veröffentlicht. Astra ist das Frontier-Modell für die anspruchsvollsten Aufgaben; Sol ist das günstigere Alltagsmodell, das – so OpenAI selbst – für „powering agents at scale" gebaut wurde.
Ein einzelner Agent erreicht ein Limit selten. Sechs Agents auf einem API-Key stoßen schon vor dem Mittagessen daran. Dieser Leitfaden behandelt die Rate Limits von GPT-6.2, die Obergrenzen der Codex-Pläne und wie man ein Agent-Team richtig dimensioniert, damit es Aufgaben in die Warteschlange stellt, statt zu scheitern. Falls Sie bereits mehrere Coding-Agents betreiben, ist Sharkly der Ort, an dem Sie festlegen, wie viele davon gleichzeitig laufen.
GPT-6.2 Rate Limits nach Usage-Tier
GPT-6.2 Astra und GPT-6.2 Sol teilen sich eine gemeinsame Rate-Limit-Tabelle auf OpenAIs Sol-Modellseite und Astra-Modellseite. RPM steht für Requests pro Minute, TPM für Tokens pro Minute. Wovon Sie zuerst erschöpft sind, stoppt Sie.
| Tier | Qualifizierung ab (Krediteinkäufe gesamt) | Monatliches Nutzungslimit | RPM | TPM |
|---|---|---|---|---|
| Build | 5 $ | 500 $ | 5.000 | 1.000.000 |
| Launch | 100 $ | 5.000 $ | 10.000 | 4.000.000 |
| Grow | 500 $ | 200.000 $ | 15.000 | 40.000.000 |
Die Spalten zur Qualifizierung und zum monatlichen Nutzungslimit stammen aus OpenAIs Rate-Limits-Guide. Ihr Tier wird automatisch hochgestuft, sobald die Krediteinkäufe insgesamt die jeweilige Schwelle überschreiten. Das monatliche Nutzungslimit ist eine separate Obergrenze von den Ausgabenlimits, die Sie selbst festlegen.
Astra kostet pro Token das Vierfache (8 $ Input, 40 $ Output pro Million gegenüber 2 $ und 10 $ bei Sol), aber sein Rate Limit ist dasselbe. Woran Sie stoßen, hängt davon ab, wie viele Tokens Ihre Agents verbrauchen.
So funktionieren die GPT-6.2-Nutzungslimits in Codex
Wenn Ihre Agents über Codex mit einem ChatGPT-Plan statt über einen API-Key laufen, gilt ein anderes Limit. OpenAIs Codex-Preisseite gibt lokale Nachrichten pro Fünfstundenfenster als Bereiche an, da die Aufgaben Größe die Kosten jeder Nachricht verändern.
| Modell | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6 bis 50 | 6 bis 50 |
| GPT-6.2 Sol | 17 bis 180 | 17 bis 180 |
| GPT-6.1 Sol | 15 bis 160 | 15 bis 160 |
| GPT-6 Astra | 5 bis 45 | 5 bis 45 |
Vier Details sind für Agent-Teams wichtig:
- Pro-Pläne haben derzeit kein Fünfstundenlimit, aber wöchentliche Limits können weiterhin gelten.
- Lokale Nachrichten und Cloud-Chats teilen sich ein Kontingent. Eine Cloud-Aufgabe kann mehr davon verbrauchen als eine lokale Nachricht.
- Geschwindigkeit kostet Kontingent. Der Fast-Modus verbraucht bei GPT-6.2-Modellen 2x der enthaltenen Nutzung, Ultrafast sogar 6x.
- Lange Sessions kosten mehr pro Nachricht. OpenAI sagt, dass Aufgaben mit mehr Kontext „deutlich mehr" des Kontingents verbrauchen.
Ein Agent, der die Hälfte eines Repositories gelesen hat, sendet bei jedem Zug einen großen Kontext, sodass seine Nachrichtenzahl schnell sinkt. Dasselbe Muster haben wir für Anthropics Pläne in Claude Code usage limits behandelt, und die Reaktion auf die Kürzung des Codex-Pro-Limits folgt derselben Logik.
Warum TPM, nicht RPM, ein Agent-Team begrenzt
Ein Coding-Agent sendet keine tausenden kleinen Requests. Er sendet ein paar große. Bei jedem Zug wird der bisherige Gesprächsverlauf erneut übertragen: Anweisungen, gelesene Dateien, Tool-Ausgaben und die eigene bisherige Argumentation.
Nehmen wir einen beispielhaften Agent: 80.000 Input-Tokens pro Zug und 6 Züge pro Minute. Das sind 6 RPM und etwa 480.000 TPM. Gemessen am Build-Tier:
- RPM: 6 von 5.000 genutzt. Kein Problem.
- TPM: 480.000 von 1.000.000 genutzt. Zwei Agents füllen das Limit.
Ihre Zahlen werden anders aussehen; das Verhältnis nicht. Agents sind Token-lastig und Request-arm. Für diesen Beispiel-Agent liegt das theoretische Maximum bei zwei Agents pro Projekt auf Build und acht auf Launch. Mit dem 30-%-Puffer aus den Dimensionierungsschritten unten sinkt das auf einen Agent auf Build und fünf auf Launch. Auf Grow ist das Rate Limit nicht mehr Ihr Engpass – stattdessen greift das monatliche Limit von 200.000 $ oder Ihr eigenes Budget.
Limits werden organisationweit geteilt
OpenAI definiert Rate Limits auf Organisations- und Projektebene, nicht pro Benutzer. Jeder Agent, der Keys aus einem Projekt verwendet, greift auf denselben Pool zu. Manche Modellfamilien haben zusätzlich ein gemeinsames Limit, das auf Ihrer Limits-Seite aufgeführt ist, sodass Traffic zu einem Modell auch gegen ein anderes angerechnet werden kann.
So passen Sie die Agent-Paralleität an Ihr GPT-6.2-Tier an
Die Lösung: Begrenzen Sie, wie viele Agents gleichzeitig laufen, damit zusätzliche Arbeit in einer Warteschlange wartet, statt an der API zu kollidieren. Diese Reihenfolge hat sich bewährt:
- Finden Sie Ihr Tier unter Settings, Organization, Limits auf der OpenAI-Plattform.
- Messen Sie einen realen Agent-Lauf. Notieren Sie Input-Tokens pro Zug und Züge pro Minute aus der Nutzungsstatistik Ihres Runtimes.
- Teilen Sie Ihr TPM durch das TPM eines Agents und halten Sie 30 Prozent Puffer für Spitzen frei.
- Legen Sie diese Zahl als Paralleitätslimit fest für alle Agents, die auf das Projekt zugreifen.
- Beobachten Sie 429-Fehler eine Woche lang, und erhöhen Sie das Limit dann schrittweise.
In Sharkly hat jeder Agent die Einstellung Max concurrency (assigned tasks), eine Max run duration in Minuten und einen Queue timeout in Stunden. Wenn das Limit erreicht ist, warten neue Aufgaben im Zustand „Queued", bis ein Slot frei wird. Chats können sich dasselbe Limit teilen, sodass sich eine Konversation nicht daran vorbeischleicht.

Auch ein Computer hat sein eigenes Task-Paralleitätslimit. Die Sharkly-Dokumentation weist darauf hin, dass höhere Paralleität mehr CPU, Arbeitsspeicher, Festplattenspeicher, Provider-Kapazität und Repository-Bandbreite beansprucht – erhöhen Sie sie also erst, wenn die aktuelle Last sauber läuft.
Verteilen Sie Agents auf mehrere OpenAI-Projekte
Projektebene-Limits erlauben es, Agent-Gruppen zu trennen. Geben Sie Ihren Review-Agents ein OpenAI-Projekt und Ihren Bulk-Refactoring-Agents ein anderes. Ein außer Kontrolle geratenes Refactoring trifft dann sein eigenes Projektlimit, statt die Review-Agents zu verhungern. Das Organisationslimit begrenzt weiterhin das Gesamtvolumen, sodass dies Prioritäten setzt, aber keine Kapazität hinzufügt.
Bei einem Runtime, der sich mit einem API-Key authentifiziert, legen Sie den Key als Umgebungsvariable auf dem Agent fest. Sharkly injiziert Agent-Umgebungsvariablen beim Start in den Agent-Prozess. Geben Sie jeder Agent-Gruppe einen Key aus ihrem eigenen OpenAI-Projekt, sodass ihr Traffic auf das richtige Limit angerechnet wird.
Behalten Sie Tokens pro Aufgabe im Blick
Der Agent-Header in Sharkly zeigt zugewiesene Aufgaben, Gesamtläufe und verbrauchte Tokens. Lesen Sie die Tokens pro Aufgabe, nicht nur den Monatssumme. Ein Aufgabentyp, der dreimal so viele Tokens verbraucht wie die anderen, ist der erste Kandidat für Sol statt Astra – oder für eine straffere Aufgabenbeschreibung.
Verlagern Sie Massenarbeit in Nebenzeiten
Zu den Runtime-Einstellungen jedes Agents gehört ein Working hours-Schalter, um Arbeit in Nebenzeiten zu planen. Richten Sie ihn auf Testgenerierung, Dependency-Updates und Dokumentationsdurchläufe. Diese Aufgaben laufen über Nacht und lassen die Tageskapazität für die Arbeit frei, auf die Menschen warten.
Umgang mit einem GPT-6.2-429-Fehler
Auch mit einem Limit werden Sie gelegentlich einen 429 sehen. OpenAIs Leitfaden ist konkret, was zu tun ist:
- Folgen Sie dem
Retry-After-Header, wenn er vorhanden ist, und behandeln Sie ihn als Minimum. - Ohne ihn: exponentielles Backoff mit zufälligem Jitter verwenden.
- Lesen Sie
x-ratelimit-remaining-tokensundx-ratelimit-reset-tokens, um zu sehen, wie nah Sie am Limit sind. - Keine verschachtelten Retries: Wenn Ihr Code wiederholt, schalten Sie die eigenen SDK-Retries aus, sonst multiplizieren sich beide.
- Kontingent- oder Abrechnungsfehler nicht wiederholen. Die brauchen einen Menschen.
Ein 503 mit server_is_overloaded bedeutet, dass das Modell beschäftigt ist, nicht Sie. Behandeln Sie ihn mit demselben Backoff.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra oder Sol: Welches Modell schont Ihre Limits stärker
Die Rate Limits sind identisch, daher hängt die Wahl von Tokenverbrauch und Preis ab. Nutzen Sie Astra für Architekturänderungen, schwierige Bugs und lange autonome Läufe. Nutzen Sie Sol für alles Routinemäßige. In Codex auf Plus erhält Sol etwa dreimal so viele Nachrichten pro Fünfstundenfenster wie Astra – das deutlichste Signal des Kostenunterschieds.
Ein gemischtes Team ist die übliche Antwort: Ein Astra-Agent führt, mehrere Sol-Agents erledigen die Einzelteile, wie in GPT-6 Astra as your Crew leader. Routinearbeit gehört auf ein günstigeres Modell – die Logik hinter GPT-6 Luna für die langweiligen 80 Prozent.
Weitere Wege zu mehr GPT-6.2-Durchsatz
- Batch API. Sie läuft außerhalb Ihrer synchronen Rate Limits und kostet 50 Prozent der Standardpreise. Gut für Evaluierungen und Bulk-Klassifizierung; falsch für einen interaktiven Agenten.
- Background-Modus mit
2h- oder8h-Fenster. Er zählt gegen ein separates Batch-/Background-Warteschlangenlimit statt gegen Ihr Live-TPM. - Prompt-Caching. Gecachter Input kostet 0,40 $ pro Million bei Astra und 0,10 $ bei Sol – eine große Ersparnis für Agents, die denselben Kontext erneut senden.
Fazit
Die Rate Limits von GPT-6.2 sind pro Request großzügig und pro Token knapp. Für ein Agent-Team ist das praktikable Limit das TPM Ihres Tiers geteilt durch den Verbrauch eines einzelnen Agents – geteilt von allen Agents im Projekt. Messen Sie einen Lauf, begrenzen Sie die Paralleität unter diese Zahl, trennen Sie laute Agent-Gruppen in eigene Projekte und lassen Sie die Warteschlange den Rest auffangen.
Sie können das mit Skripten und einem Semaphore bauen oder pro Agent in Sharkly einstellen. Verbinden Sie einen Computer, erstellen Sie einen Agent auf Codex mit GPT-6.2 Sol, setzen Sie seine maximale Paralleität auf 2 und weisen Sie ihm etwas Langweiliges zu. Mehr zum parallelen Betrieb von Agents in How to run 10 AI coding agents at once.
FAQ
Was sind die Rate Limits von GPT-6.2?
In der API teilen sich GPT-6.2 Astra und Sol dieselben Limits: 5.000 RPM und 1.000.000 TPM auf Build, 10.000 RPM und 4.000.000 TPM auf Launch sowie 15.000 RPM und 40.000.000 TPM auf Grow.
Hat GPT-6.2 Astra niedrigere Rate Limits als Sol?
Nein. OpenAI listet für beide Modelle auf jedem Tier dieselben RPM und TPM. Astra kostet mehr pro Token, sodass es Ihr Budget schneller erschöpft – nicht Ihr Rate Limit.
Wie komme ich auf einen höheren OpenAI-Usage-Tier?
Die Tiers stufen sich automatisch anhand der Krediteinkäufe gesamt hoch: 5 $ für Build, 100 $ für Launch, 500 $ für Grow.
Gelten Rate Limits pro API-Key oder pro Organisation?
Pro Organisation und pro Projekt. Jeder Key in einem Projekt greift auf denselben Pool zu, sodass zehn Agents auf zehn Keys in einem Projekt weiterhin ein Limit teilen.
Wie viele GPT-6.2-Astra-Nachrichten erhalte ich in Codex?
Auf Plus und Standard Business schätzt OpenAI 6 bis 50 lokale Nachrichten pro Fünfstundenfenster für GPT-6.2 Astra und 17 bis 180 für Sol. Pro-Pläne haben derzeit kein Fünfstundenlimit, wöchentliche Limits können aber gelten.
Warum erhalte meine Agents 429-Fehler, obwohl die RPM in Ordnung aussehen?
Agents senden große Kontexte und erschöpfen daher die Tokens pro Minute lange vor den Requests pro Minute. Prüfen Sie x-ratelimit-remaining-tokens in den Response-Headern.
Fügt Sharkly eigene Modelllimits hinzu?
Nein. Sharkly betreibt die Coding-Agents, die Sie bereits verwenden, und das Modellkontingent hängt von den Tools, Plänen und API-Konten ab, die Ihr Team verbindet. Sharkly steuert, wie viele Aufgaben jeder Agent gleichzeitig ausführt.