
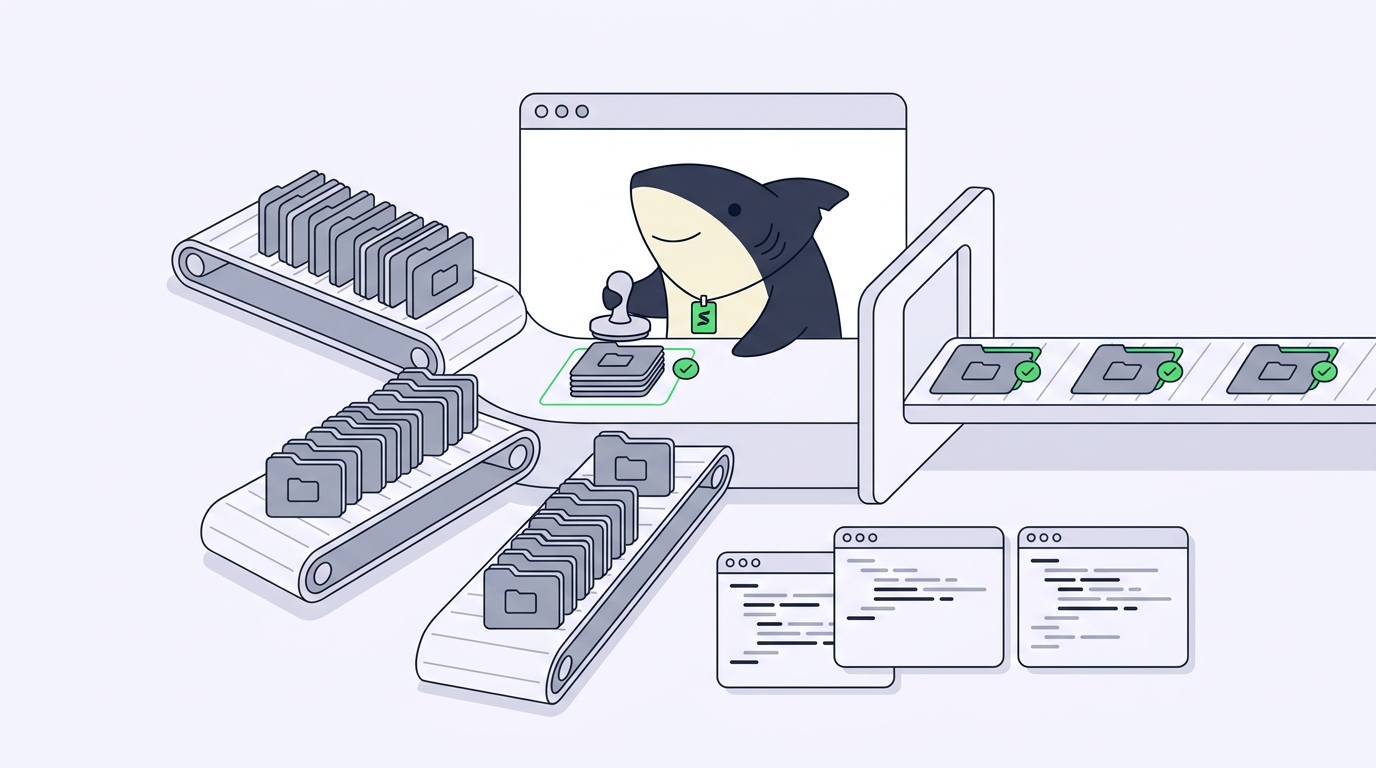
Wenn Sie zum ersten Mal drei Coding-Agents gleichzeitig laufen lassen, ist die Ausführung plötzlich nicht mehr der langsame Teil. Sie übergeben einen Bug an Claude Code, ein Refactoring an Codex und eine Test-Coverage-Lücke an eine dritte Runtime – und vierzig Minuten später sind drei Branches fertig. Dann beginnt das eigentliche Warten, denn alle drei warten jetzt auf Sie. Sie lesen den ersten Diff, geben ihn frei, und die anderen beiden liegen brach. Sie haben parallele Ausführung und serielles Review – die Parallelität bringt Ihnen damit so gut wie nichts.
Das ist die Falle, in die jedes Team tappt, das gut darin wird, Agents parallel laufen zu lassen. Der Engpass verschwindet nicht, er verschiebt sich: von „Wie schnell schreibt ein Agent den Code?“ zu „Wie schnell kann ein Mensch das Ergebnis lesen, beurteilen und akzeptieren?“ Ein vierter Agent macht es schlimmer: eine längere Warteschlange fertiger Arbeit, derselbe einzige Reviewer.
Die Lösung besteht nicht darin, schneller zu reviewen oder mehr zu vertrauen. Sie besteht darin, Review als expliziten Teil des Workflows zu gestalten statt als nachträglichen Gedanken, der nur in Ihrem Kopf existiert. Genau diesen Workflow beschreibt dieser Artikel – und genau darum geht es bei Sharkly: Ziel, Diff, Belege und Review jedes Agent-Runs in einem einzigen Task zusammenzuhalten, sodass die Review-Warteschlange etwas wird, das Sie sehen und steuern können, statt eines Stapels offener Browser-Tabs.
Warum parallele Agents den Engpass zum Review verschieben
Review ist eine Warteschlange. Fertige Agent-Runs kommen mit einer bestimmten Rate an, eine Person arbeitet sie mit einer bestimmten Rate ab – und wenn die Zugänge schneller sind als die Abgänge, wächst die Warteschlange unbegrenzt. Das ist die ganze Geschichte, und deshalb ist der reine Agent-Durchsatz die falsche Kennzahl zum Optimieren. Wenn zehn Agents in einer Stunde fertig werden und Sie drei Änderungen pro Stunde sorgfältig akzeptieren können, haben Sie eine Fabrik gebaut, deren Laderampe aus einer Person mit Klemmbrett besteht.
Die meisten Tools verbergen das. Ein Stapel Pull Requests zeigt Ihnen die Arbeit, aber nicht, welche Einträge wirklich auf eine Entscheidung warten, welche noch laufen und welche schon gemergt sind. Die Warteschlange ist real, aber sie verteilt sich über Tabs, Benachrichtigungen und Ihr Gedächtnis. Das erste Designziel ist, sie sichtbar zu machen, denn einen Engpass, den Sie nicht sehen, können Sie nicht steuern. Ein begleitender Artikel zur Mathematik der Review-Kapazität rechnet durch, was passiert, wenn die Parallelität steigt.
Das Betriebsmodell: Wer weist zu, wer führt aus, wer reviewt, wer akzeptiert
Bevor Sie an den Statuswerten drehen, benennen Sie die vier Rollen. Es sind unterschiedliche Rollen, und ihre Vermischung ist der Grund, warum sich Review chaotisch anfühlt.
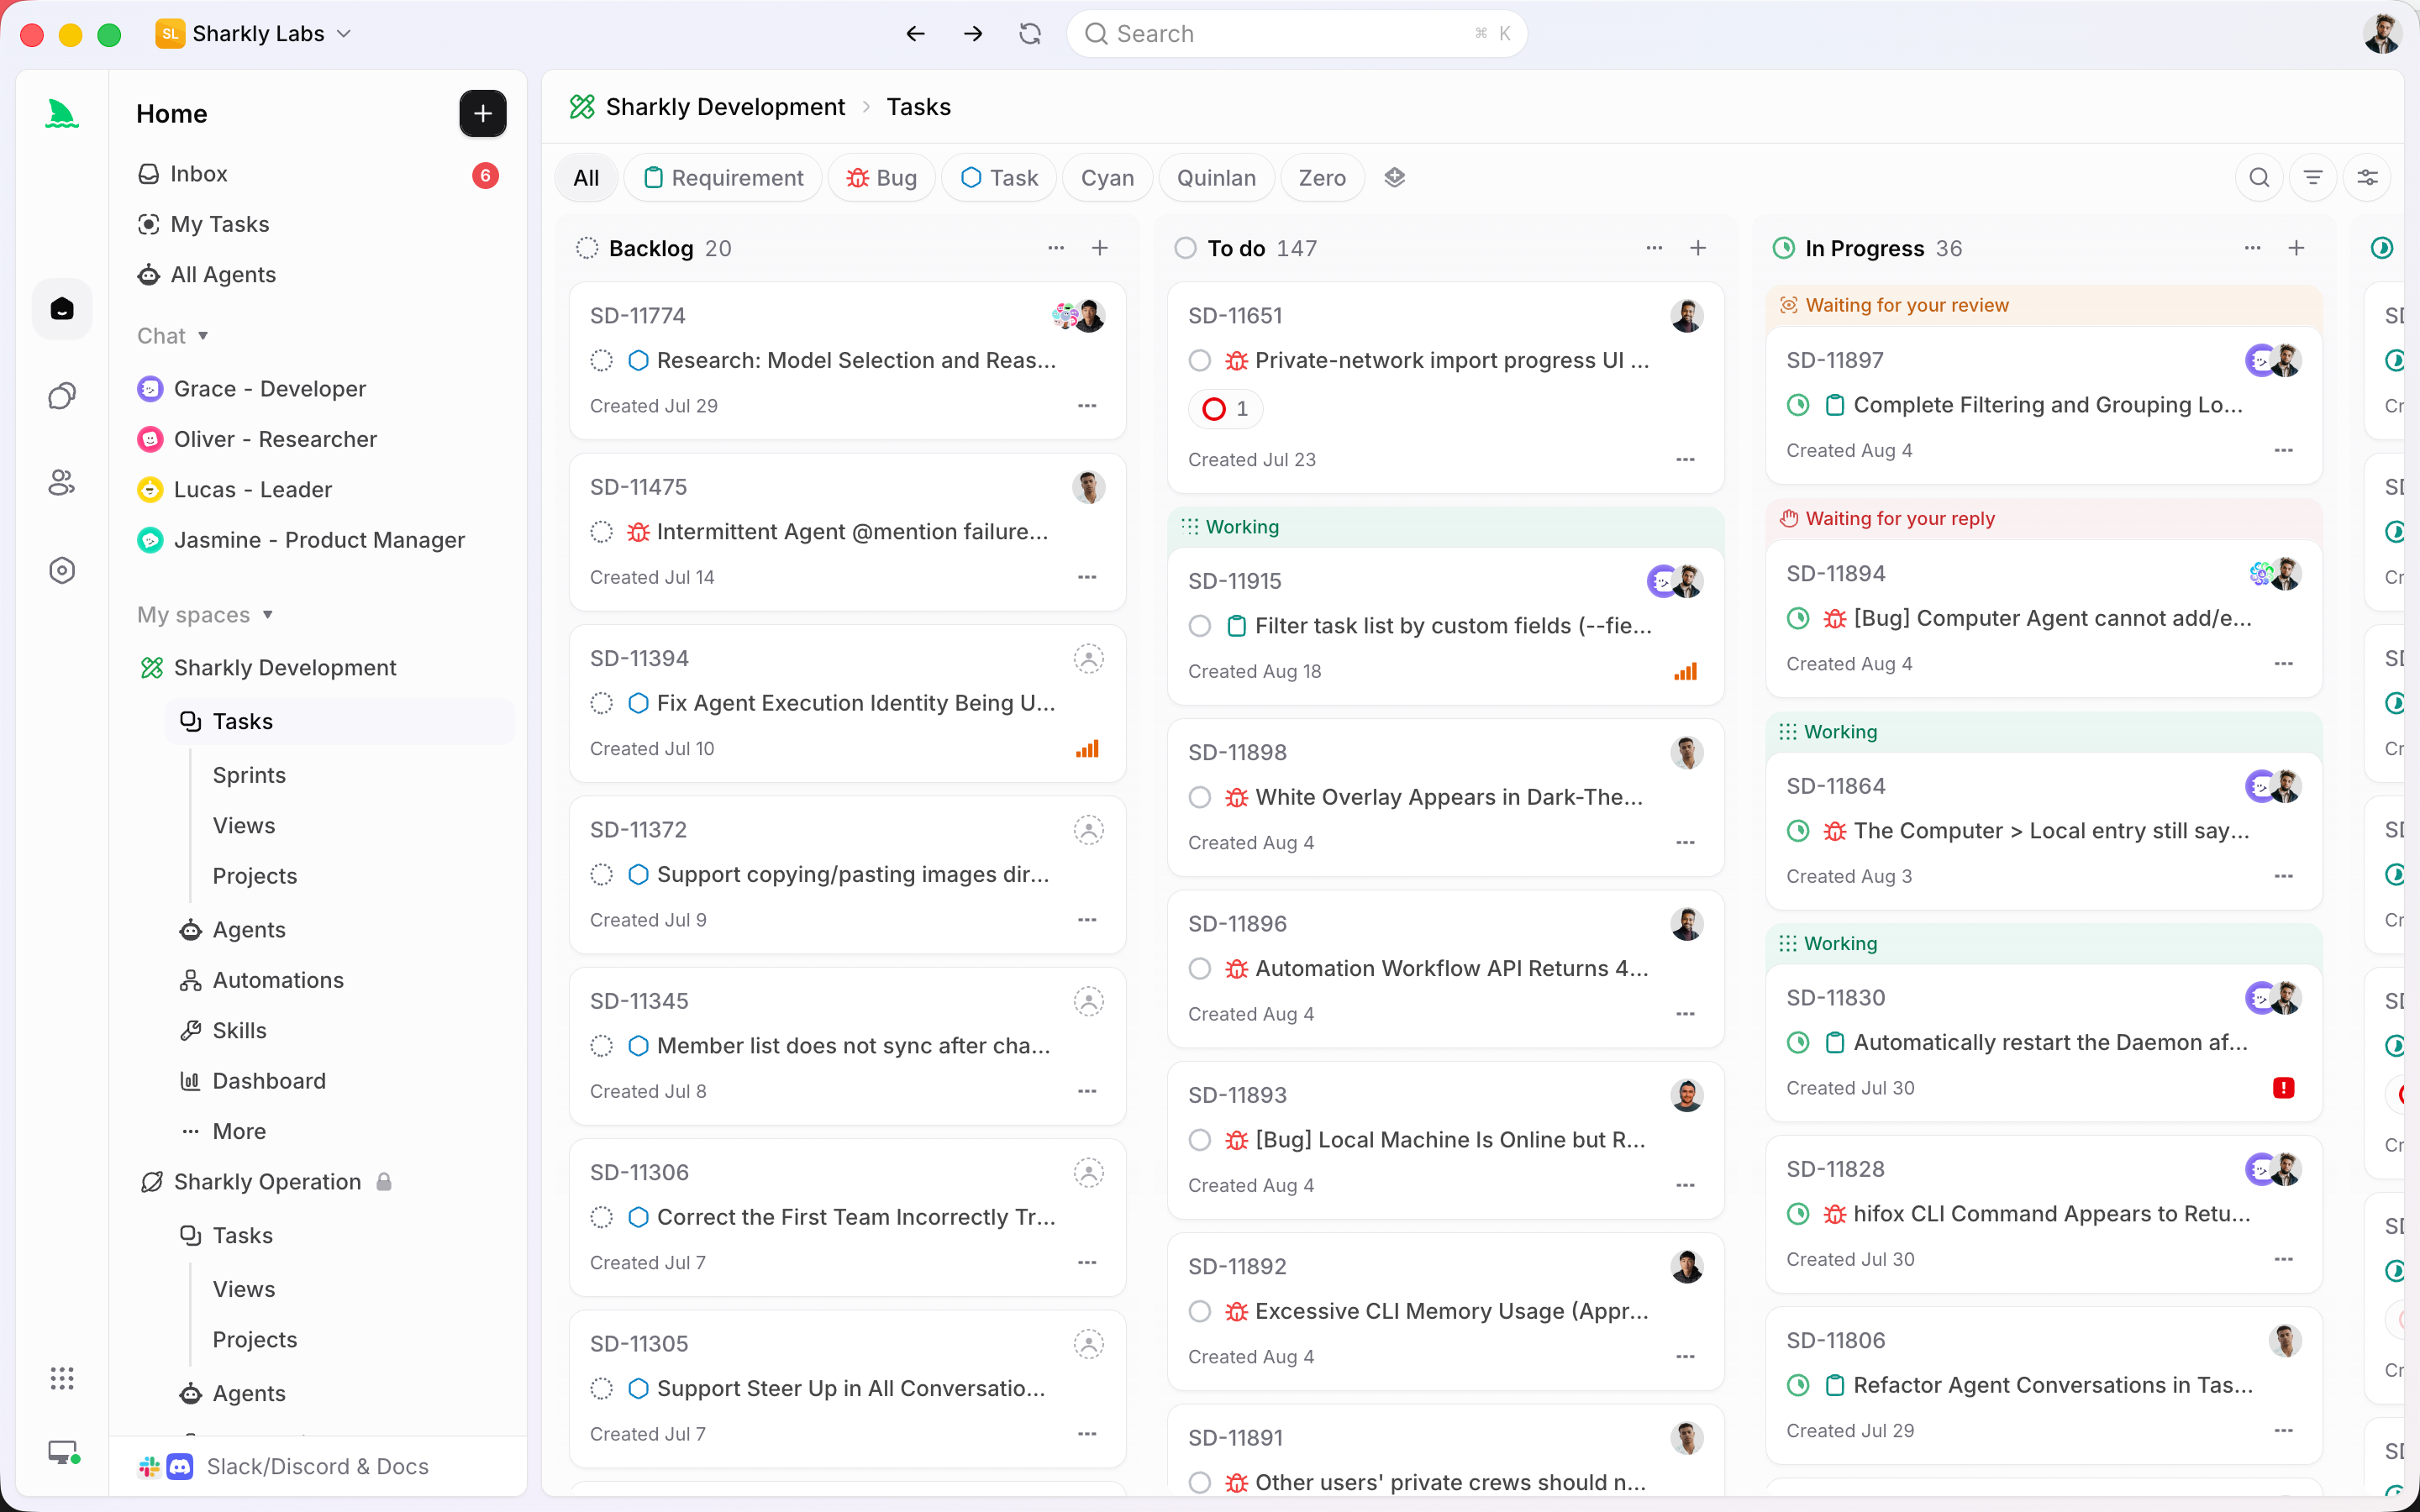
Jemand weist die Arbeit zu: verwandelt eine Absicht in einen abgegrenzten Task mit Akzeptanzkriterien. Etwas führt sie aus: ein Agent auf einem Computer, der in einer Runtime läuft, eine Änderung erzeugt und festhält, was er getan hat. Jemand reviewt das Ergebnis: liest den Diff und die Belege und entscheidet, ob die Kriterien erfüllt sind. Jemand akzeptiert es: trifft die Entscheidung zu mergen und zu veröffentlichen – eine andere Entscheidung als „der Code sieht gut aus“.
Sharkly formuliert den Vertrag in einem Satz, der es wert ist, auf einem Haftzettel zu landen: Agents recherchieren, führen aus, testen und berichten; Menschen geben die Richtung vor, erteilen Befugnisse und akzeptieren das Ergebnis. Automatisierung endet dort, wo das Urteilsvermögen des Teams gefragt ist. Zuweisen und Akzeptieren sind bewusst menschliche Aufgaben. Das Ausführen übernimmt der Agent. Review ist die Aufgabe, die man gezielt konstruieren muss, denn hier bildet sich die Warteschlange.
Eine hilfreiche Grenze: Ein gemergter PR ist nicht dasselbe wie ein akzeptiertes Ergebnis. Mergen ist eine Git-Operation. Akzeptanz bedeutet, dass ein Mensch entscheidet, dass die Änderung das tut, was der Task verlangt hat. Wenn beides zu einem einzigen Klick verschmilzt, sinkt die Review-Qualität auf das Niveau der Energie, die der Reviewer in dieser Minute noch hatte.
Rollen, Statuswerte und Review-Gates
Geben Sie der Warteschlange eine Form, indem Sie Tasks eine kleine Auswahl an Statuswerten geben, zwischen denen Agents und Menschen wechseln. Ein Task ist die zentrale Arbeitseinheit: Er enthält das Ziel, die Konversation und den Run. Der Sinn der Statuswerte ist, dass Agents einen Task bis direkt an das Review-Gate vorantreiben können – und nur ein Mensch ihn darüber hinausbewegen kann.
| Status | Wer ihn hierher verschiebt | Bedeutung |
|---|---|---|
| Backlog | Person | Abgegrenzt, nicht gestartet. Hier findet kein Run statt. |
| Ready | Person | Zur Ausführung freigegeben; ein Agent kann ihn übernehmen. |
| In progress | Agent | Ein Run wird in einem isolierten Worktree ausgeführt. |
| Ready for review | Agent | Run abgeschlossen, Änderung und Belege angehängt, wartet auf eine Person. |
| Changes requested | Person | Mit einem Kommentar zurückgeschickt; ein Folge-Run wird im selben Task fortgesetzt. |
| Done | Person | Akzeptiert, gemergt, veröffentlicht. |
Das Gate ist der Übergang in Ready for review hinein und nach Done hinaus. Agents können das Gate aus eigener Kraft erreichen, aber nicht passieren. Diese eine Regel erlaubt es Ihnen, zehn Agents sicher laufen zu lassen: Sie füllen die Spalte Ready for review parallel, und Sie leeren sie in dem Tempo, das die Qualität ehrlich hält. Die Länge der Spalte ist Ihr Engpass – sichtbar gemacht.
Hier ist das ehrliche Entscheidungspaar. Gaten Sie jede Änderung, die zu Nutzern ausgeliefert wird oder Geld, Authentifizierung, Datenmigrationen oder öffentliche APIs berührt. Gaten Sie keine Wegwerf-Spikes, generierten Boilerplate, den Sie ohnehin neu generieren würden, oder Arbeit hinter einem Flag, das noch niemand erreichen kann. Ein Gate für alles verlagert den Engpass nur zurück auf den Reviewer – für Änderungen, die nie einen Menschen gebraucht hätten. Approval Gates behandelt, wo Sie den Stopp für riskantere Arbeit setzen sollten.
Gestalten Sie Review so, dass es skaliert
Die Ergebnisse paralleler Agents zu reviewen ist nicht dasselbe wie das PR eines Teamkollegen zu reviewen. Es ist mehr davon, es kommt in Schüben, und Sie wissen oft weniger darüber, wie es entstanden ist. Drei Maßnahmen halten die Kosten des Reviewers pro Eintrag niedrig.
Hängen Sie die Belege an den Task, nicht an Ihr Gedächtnis. Ein Run sollte die Zusammenfassung der Änderung, die Typecheck- und Testausgabe, das Build-Ergebnis und die bekannten Einschränkungen zurückgeben – alles dokumentiert. Wenn Sie einen Eintrag mit Ready for review öffnen, lesen Sie eine Fallakte, statt zu rekonstruieren, was passiert ist. Das ist der Unterschied zwischen Review auf Basis von Belegen auf Task-Ebene und dem erneuten Ausführen von allem, nur um Vertrauen zurückzugewinnen.
Reviewen Sie die Entscheidung, nicht die Tastenanschläge. Maschinell prüfbare Eigenschaften – Formatierung, Typsicherheit, ob Tests bestehen – sollten von Maschinen geprüft werden, bevor der Task Sie erreicht. Googles Code-Review-Leitfaden trifft dieselbe Unterscheidung: Automatisieren Sie, was ein Tool verifizieren kann, damit der Mensch seine Aufmerksamkeit auf Design und Passgenauigkeit richtet. Ihr knappes Urteilsvermögen gehört der Frage „Ist das die richtige Änderung?“, nicht „Hat es kompiliert?“
Begrenzen Sie die Arbeit, die gleichzeitig in Bearbeitung ist. Ein hartes Limit dafür, wie viele Tasks gleichzeitig in In progress stehen, verhindert, dass die Spalte Ready for review zu einer Wand wird, die Sie nie bewältigen. Das ist die Kanban-WIP-Limit-Idee, angewandt auf Agents: Einen sechsten Run zu starten, während fünf bereits auf Sie warten, erhöht den Durchsatz nicht, sondern verdeckt die Warteschlange. Außerdem hilft es, die laufenden Agents zu überwachen, damit Sie einen hängenden Run von einem langsamen unterscheiden können, bevor er das Gate erreicht.
Ein durchgerechnetes Beispiel: vom Ticket zum gemergten PR
Nehmen wir einen realistisch wirkenden Task, SH-312: „Rate-Limiting für den öffentlichen Such-Endpunkt.“ Eine Person formt ihn im Backlog mit Akzeptanzkriterien aus (429 nach N Anfragen pro Minute pro Schlüssel, dokumentierter Header, ein Test) und verschiebt ihn nach Ready.
Drei Agents arbeiten parallel im Space. Einer greift SH-312 auf, klont das konfigurierte Repository auf einen Computer und läuft in einem isolierten Worktree, damit sein Branch nie mit den beiden anderen laufenden Runs kollidiert. Er schreibt den Limiter, fügt einen Test hinzu, führt Typecheck und Testsuite aus, öffnet einen PR, dessen Titel die Task-ID trägt, und verschiebt SH-312 nach Ready for review – mit der Zusammenfassung der Änderung, der bestandenen Testausgabe und einer vermerkten bekannten Einschränkung: Der Zähler liegt im Prozess und wird nicht über Instanzen hinweg geteilt.
Sie öffnen den Task, nicht fünfzehn Tabs. Die Belege sind direkt da, und der Hinweis auf die bekannte Einschränkung ist der wertvolle Teil: Die Tests bestehen, aber geteilter Zustand über Instanzen hinweg ist eine Designentscheidung, die Sie treffen müssen. Sie hinterlassen einen Kommentar und verschieben den Task nach Changes requested. Dieser Kommentar startet einen Folge-Run im selben Task; der Agent stellt den Zähler auf einen gemeinsamen Store um und liefert aktualisierte Belege. Diesmal akzeptieren Sie. SH-312 nach Done zu verschieben ist Ihre Entscheidung, festgehalten als Statusänderung mit Ihrem Namen – nicht als stiller Nebeneffekt eines Git-Merges.
Währenddessen warten die beiden anderen Agents in Ready for review. Weil die Warteschlange eine Spalte ist und nicht Ihr Posteingang, arbeiten Sie sie als Nächstes ab – der Reihe nach, ohne den Faden zu verlieren.
Die Grenze, die Sie für Menschen ziehen
Parallele Agents sind eine Durchsatz-Geschichte, bis Review zum limitierenden Faktor wird – dann sind sie eine Warteschlangen-Geschichte. Teams, die aus vielen Agents Nutzen ziehen, behandeln Review als bewusst gestaltete Infrastruktur: explizite Statuswerte, ein Gate, das Agents erreichen, aber nicht passieren können, Belege am Task, maschinelle Prüfungen vor menschlichen und ein Limit dafür, wie viel gleichzeitig unterwegs sein darf.
Sie können das von Hand bauen – mit Worktrees, einer Branch-Namenskonvention und Disziplin. Oder Sie lassen Sharkly den Workflow verwalten: zuweisbare Agents, Tasks, die den Run und seine Belege mitführen, und ein Board, auf dem Ready for review eine Spalte ist, die Sie abarbeiten – sodass Agents recherchieren, ausführen, testen und berichten, während Menschen die letzte Entscheidung behalten. Wenn Sie bereits mehrere Agents laufen lassen, ist das ein Ort, an dem Sie ihre Aufgaben und Ergebnisse verwalten, statt auf Ihr Gedächtnis zu vertrauen.
FAQ
Spart das parallele Ausführen von Agents Zeit, wenn das Review seriell ist? Nur bis zu dem Punkt, an dem fertige Runs schneller eintreffen, als Sie sie akzeptieren können. Darüber hinaus vergrößern zusätzliche Agents die Review-Warteschlange, ohne dass etwas früher ausgeliefert wird. Der Gewinn entsteht daraus, Review sichtbar zu machen und nur das zu gaten, was einen Menschen braucht.
Sollte jede Agent-Änderung von einem Menschen reviewt werden? Nein. Gaten Sie Änderungen, die zu Nutzern ausgeliefert werden oder Authentifizierung, Daten, Geld oder öffentliche APIs berühren. Lassen Sie risikoarme oder regenerierbare Arbeit nur mit maschinellen Prüfungen durch. Ein Gate für alles verlagert den Engpass zurück auf den Reviewer – für Änderungen, die nie eines gebraucht hätten.
Ist das Mergen des PR nicht dasselbe wie das Akzeptieren der Arbeit? Nein. Mergen ist eine Git-Operation; Akzeptanz bedeutet, dass ein Mensch entscheidet, dass die Änderung die Kriterien des Tasks erfüllt. Beides getrennt zu halten, erhält die Review-Qualität bei hohem Volumen. Mehr dazu, wo die menschliche Entscheidung bleiben sollte, finden Sie unter Human-in-the-Loop-Coding-Agents.


