

Jev ist ein neues Modell von TypeSafe AI, und es schreibt weder Code noch Prosa. Man übergibt ihm einen Teil eines Programmzustands, deklariert die Fragen, die beantwortet werden sollen, und erhält typisierte Antworten mit kalibrierten Wahrscheinlichkeiten zurück. TypeSafe nennt es ein System-One-Modell. Es ist am 16. September 2026 im Vercel AI Gateway erschienen – deshalb taucht es plötzlich überall im Feed auf.
Für ein Team, das mehrere Coding-Agents betreibt, ist das Interessante nicht das Modell, sondern die Frage, wo ein Entscheidungsmodell im Stack sitzt. Deine Agents erzeugen die Arbeit. Das schwierige Problem – wie wir in warum menschliches Review der Engpass ist dargelegt haben – ist zu entscheiden, was mit dem Output von fünf gleichzeitigen Runs geschehen soll: Welcher braucht einen Menschen, welcher kann gemergt werden, welcher hängt fest. Genau für diese Art von Frage ist Jev gebaut. Dieser Beitrag erklärt, was es ist, was es nicht ist und wo es oberhalb deiner Agents anzusiedeln ist.
Was Jev ist
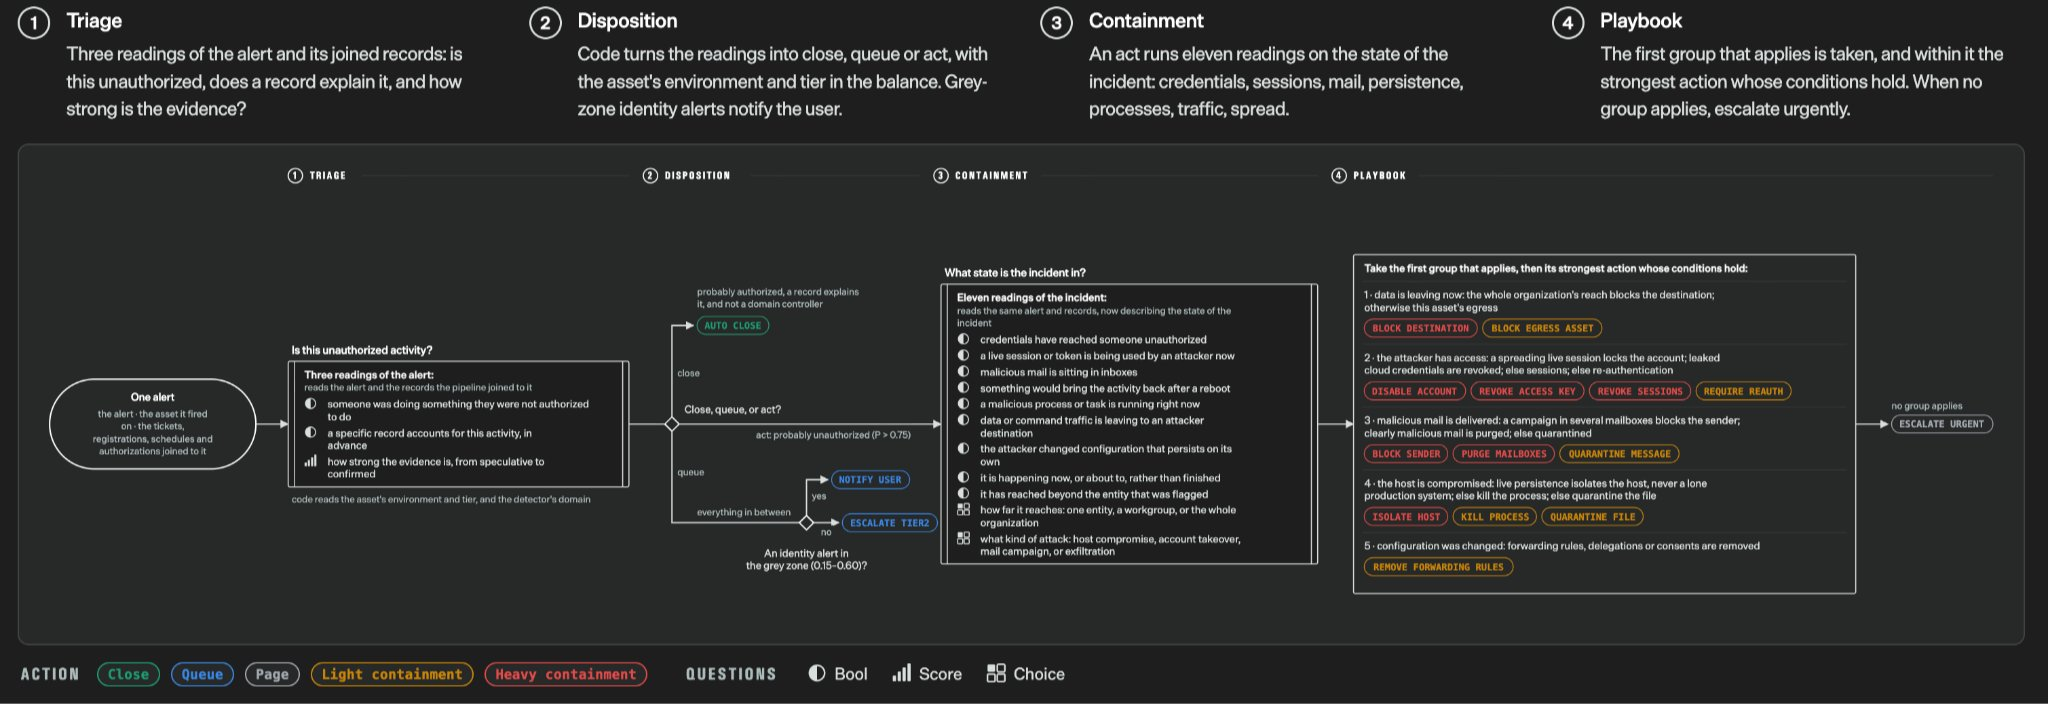
Ein System-One-Modell ist ein Modell, das Entscheidungen statt Text zurückgibt. Der Launch-Beitrag von TypeSafe formuliert es als „unstrukturierter Zustand hinein, typisierte probabilistische Entscheidungen hinaus“. Drei Eigenschaften sind dabei entscheidend.
Die Form des Outputs wird vor dem Aufruf deklariert. Man definiert den Typ jeder Frage im Voraus, und das Modell kann nur innerhalb dieses Typs antworten. Es gibt keinen Text zu parsen und keine Schema-Abweichung abzufangen.
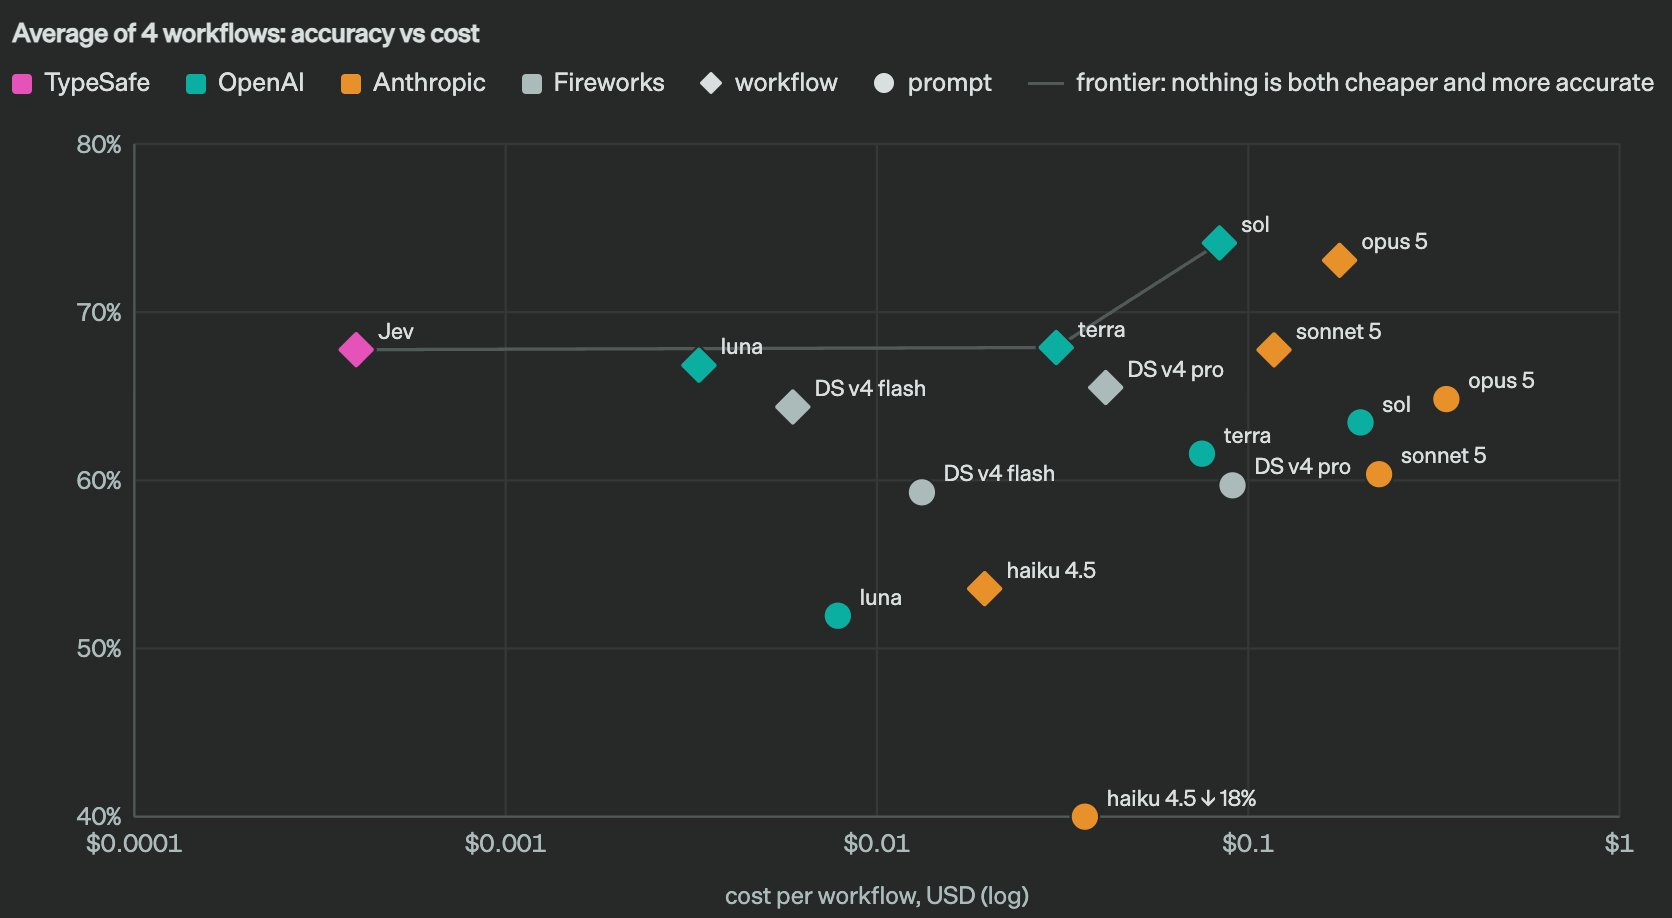
Jede Antwort trägt eine Wahrscheinlichkeit. Eine Ja/Nein-Frage liefert 0.97, nicht true. Eine Auswahl liefert die vollständige Verteilung über die Optionen. TypeSafe hat es mit einer Methode trainiert, die sie Reinforcement Learning for Calibrated Decisions nennen, und die Behauptung lautet, dass höhere Konfidenz eine höhere Genauigkeit bedeutet – man kann also einen Schwellenwert festlegen: oberhalb automatisieren, den Rest an einen Menschen weiterleiten.
Alle Fragen werden parallel in einer einzigen Anfrage beantwortet. Deshalb nennt TypeSafe End-to-End-Zeiten von 70 ms bis 500 ms. Das sind die Zahlen des Anbieters, kein unabhängiger Benchmark, aber die Architektur erklärt sie: Es wird nichts Token für Token generiert.
Die drei Fragetypen
Jevs API stellt drei Primitive bereit. Jedes ist ein JSON-Objekt unter einem Schlüssel, den man selbst wählt, und alle werden gegen denselben state ausgewertet.
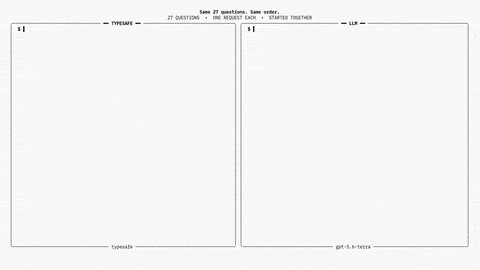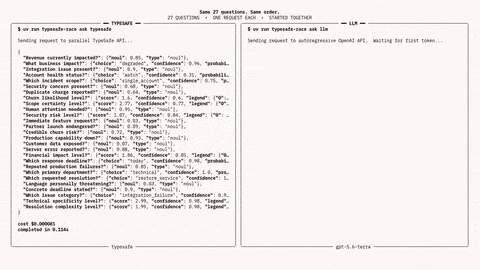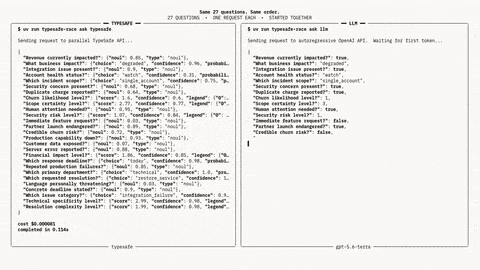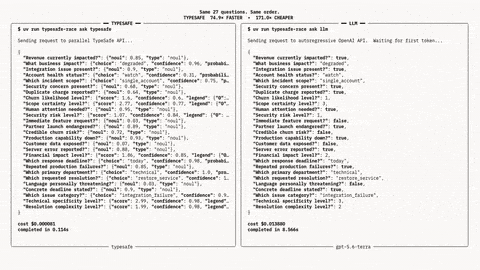
Noul ist eine Ja/Nein-Wahrscheinlichkeit. {"type": "noul", "instructions": "Does this run need a human before merge?"} liefert {"noul": 0.91}. Den Schwellenwert setzt man im Code.
Choice wählt eine Option aus einer benannten Menge von bis zu 255. Man übergibt criteria, die Optionsnamen auf Beschreibungen abbilden, und die Antwort enthält die Auswahl, die vollständige Verteilung und einen Konfidenzwert.
Score ordnet den Zustand auf einer geordneten Skala von 2 bis 10 Stufen ein. Die Antwort ist eine wahrscheinlichkeitsgewichtete Position, sodass ein Bug 1.3 zwischen „Workaround existiert“ und „blockierend“ erreichen kann.
Über das Vercel AI SDK heißt der Ja/Nein-Typ boolean und das Feld probability; gegen den eigenen Endpoint von TypeSafe heißt er noul. Dieselbe Idee, anderer Schlüssel.
Wo ein Entscheidungsmodell oberhalb deiner Agents anzusiedeln ist
Hier ist das mentale Modell, das wir verwenden. Modelle erzeugen Tokens. Coding-Agents (Claude Code, Codex, Gemini CLI, OpenCode) verwandeln Tokens in Änderungen auf einem Computer. Die Management-Ebene entscheidet, wer an was arbeitet und was mit dem Ergebnis geschieht. Jev gehört zu dieser obersten Ebene, nicht zur mittleren. Es ist kein Agent und kann keine Datei bearbeiten. Es ist eine schnelle, typisierte Antwort auf eine Management-Frage.
Auf jedem Board, das Agents parallel laufen lässt, tauchen drei Fragen auf, und jede lässt sich auf ein Jev-Primitiv abbilden.
Welcher Assignee sollte diese Task übernehmen? Eine Choice über deine Agents, mit criteria, die beschreiben, worin jeder gut ist. Der Zustand ist der Titel der Task, die Beschreibung und das verknüpfte Repository. Das ist der Triage-Schritt, den wir in KI-Backlog-Management und Triage beschrieben haben – als ein einziger 100-ms-Aufruf statt einer Person, die vierzig Tickets liest.
Braucht dieser Run einen Menschen, bevor er gemergt wird? Ein Noul über die Diff-Zusammenfassung des Runs, die Testergebnisse und die berührten Pfade. Oberhalb von 0.85 für das Review zurückhalten; unterhalb von 0.15 das Approval Gate passieren lassen; dazwischen markieren. Der Punkt ist nicht, den Reviewer einzusparen. Der Punkt ist, sicherzustellen, dass der Nachmittag des Reviewers den Runs zugutekommt, die ihn brauchen.
Wie riskant ist diese Änderung? Ein Score von „kosmetisch“ bis „berührt Auth oder Payments“, angewendet auf denselben Zustand. Diese Zahl sortiert die Review-Queue – und genau dafür ist das Nachverfolgen von durch Coding-Agents erledigter Arbeit größtenteils da.
Die Community war zuerst da. In der Woche nach dem Launch haben Entwickler einen stufenweisen Code-Review-Workflow auf Basis von Jev veröffentlicht, ein Claude-Code-Plugin, das Compaction-Zusammenfassungen durch Jev-Entscheidungen darüber ersetzt, welche Tool-Aufrufe beibehalten werden, sowie einen „Software-Factory-Foreman“, der damit Arbeit weiterleitet. Jeder davon ist eine Entscheidungsebene oberhalb eines Agents – und das ist das Muster, auf das es ankommt.
Eine ehrliche Entscheidungsregel
Setze Jev ein, wenn die Frage eine feste Menge von Antworten hat und du dazu eine Wahrscheinlichkeit brauchst: Routing, Schweregrad, „braucht Review“, „hängt fest“, „ist diese PR-Beschreibung ehrlich“. Das sind die Fragen, die ein Board hundert Mal am Tag stellt.
Setze Jev nicht ein, wenn die Frage ein Urteil erfordert, das nicht im Zustand enthalten ist. „Ist das die richtige Architektur“ ist keine Choice. „Wird der Kunde das akzeptieren“ ist kein Score. Eine Wahrscheinlichkeit darauf ist eine Zahl, die wie eine Entscheidung aussieht. Halte dafür einen Menschen bereit – oder ein Sprachmodell, das seine Begründung erläutern kann.
Und lass eine Wahrscheinlichkeit niemals das Review-Gate ersetzen. Eine 0.96 bei „sicher zum Mergen“ ist ein starkes Signal, den Run ganz oben in die Queue eines Menschen zu setzen – kein Grund, den Menschen zu überspringen. Die Grenze, die Sharkly zieht, ist die: Automatisierung endet dort, wo Team-Urteilsvermögen gefragt ist, und ein Entscheidungsmodell verschiebt diese Linie nicht. Es macht die Queue auf der menschlichen Seite dieser Linie kürzer und besser geordnet.
So ruft man es auf
Direkt: POST https://api.typesafe.ai/v1/systemone mit einem Bearer-Key von console.typesafe.ai, Modell jev-latest (aktuell jev-1.13.0). Über das Vercel AI Gateway: Modell typesafe-ai/jev via experimental_evaluate im AI SDK 7 – und beachte, dass die Gateway-Dokumentation besagt, dass Evaluation nur über das AI SDK verfügbar ist, nicht über die OpenAI-kompatiblen Endpoints.
Ein Triage-Aufruf, der alle drei Fragen auf einmal beantwortet:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
Preise laut Modellseite von TypeSafe: 0,042 $ pro Million Input-Tokens, Output wird nicht berechnet, 64k Tokens pro Anfrage, davon 32k für den Zustand, nur Text. Zu diesem Preis kostet der obige Triage-Aufruf einen Bruchteil eines Cents – und genau das macht es plausibel, ihn bei jeder Task und jedem Run auszuführen.
Wie das mit Sharkly zusammenhängt
Sharkly ruft Jev nicht für dich auf, und es ist kein Entscheidungsmodell. Es ist die gemeinsame Task-, Computer-, Kontext- und Review-Ebene rund um die Agents, die du bereits betreibst. Was ein Modell wie Jev dir gibt, ist ein günstiger, typisierter Weg, die Routing- und Review-Entscheidungen zu treffen, die diese Ebene sichtbar macht: welcher Assignee, welche Queue, wie dringend. Verdrahte es in eine Automation, die eine Task erstellt und den Agent auswählt, oder führe es auf dem Output eines abgeschlossenen Runs aus, bevor das Ergebnis einen Reviewer erreicht. In beiden Fällen landet die Entscheidung an einer Stelle, an der ein Mensch sie sehen kann – und das ist der Teil, der wahr bleiben muss, egal was die Wahrscheinlichkeit sagt.
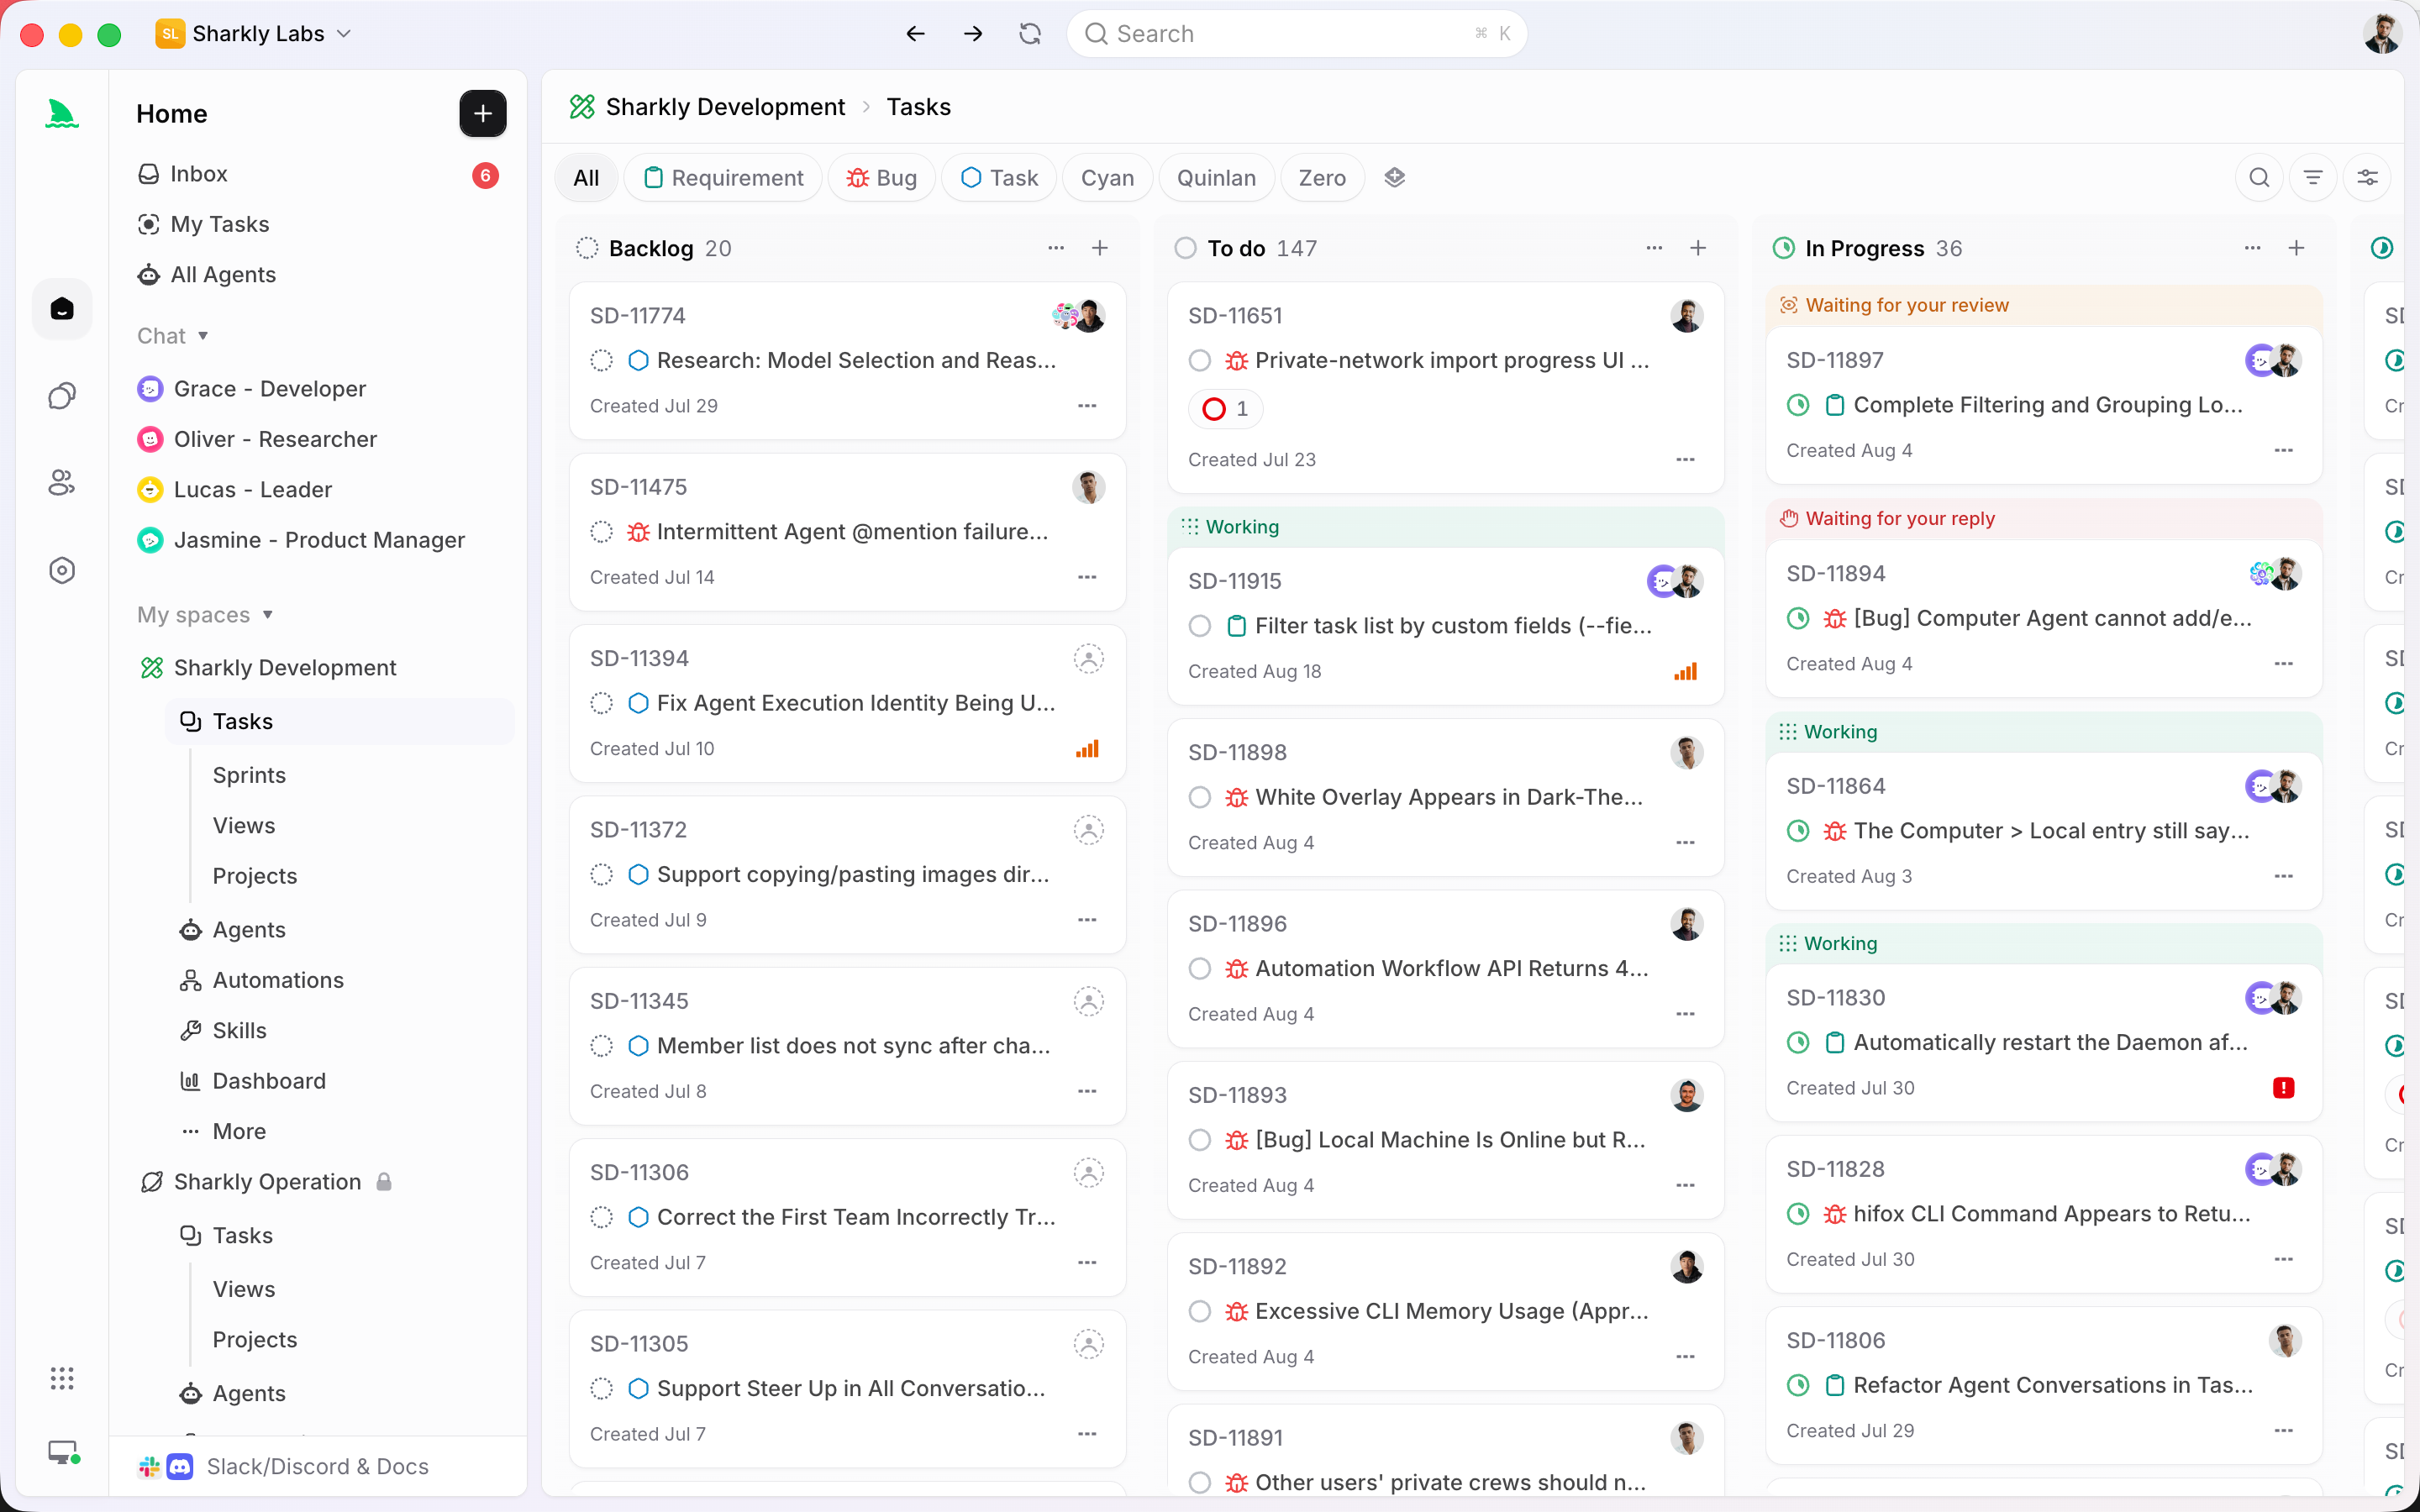
Wenn du mehr als einen Agent betreibst und die Review-Queue der Punkt ist, der schmerzt, dann behandelt Erste Schritte mit Sharkly das Board, die Computers und den Review-Flow, in den ein Entscheidungsmodell eingehängt wird.
FAQ
Ist Jev ein Coding-Agent?
Nein. Es kann keinen Code generieren und keine Datei bearbeiten. Es beantwortet deklarierte Fragen über einen Zustand, den du ihm gibst, mit einer Wahrscheinlichkeit. Agents erzeugen die Arbeit; Jev hilft zu entscheiden, was damit geschieht.
Kann es Code-Review ersetzen?
Nein, und das sollte es auch nicht. Es kann die Review-Queue sortieren und die eindeutigen Fälle herausholen. Die Entscheidung zu mergen bleibt bei einem Menschen – das ist die Grenze, von der dieser ganze Workflow abhängt.
Was bedeutet kalibriert?
Wenn Jev 0.9 sagt, sollte es bei dieser Art von Frage in etwa 90 % der Fälle richtig liegen. Teste das an deinen eigenen Runs, bevor du einem Schwellenwert vertraust: ein paar Dutzend gelabelte Diffs reichen aus, um zu sehen, ob die Zahl hält, was sie verspricht.
Brauche ich Vercel, um es zu nutzen?
Nein. Die direkte API funktioniert mit einem Bearer-Key. Das Gateway ist eine Erleichterung, wenn du ohnehin schon das AI SDK verwendest.


