
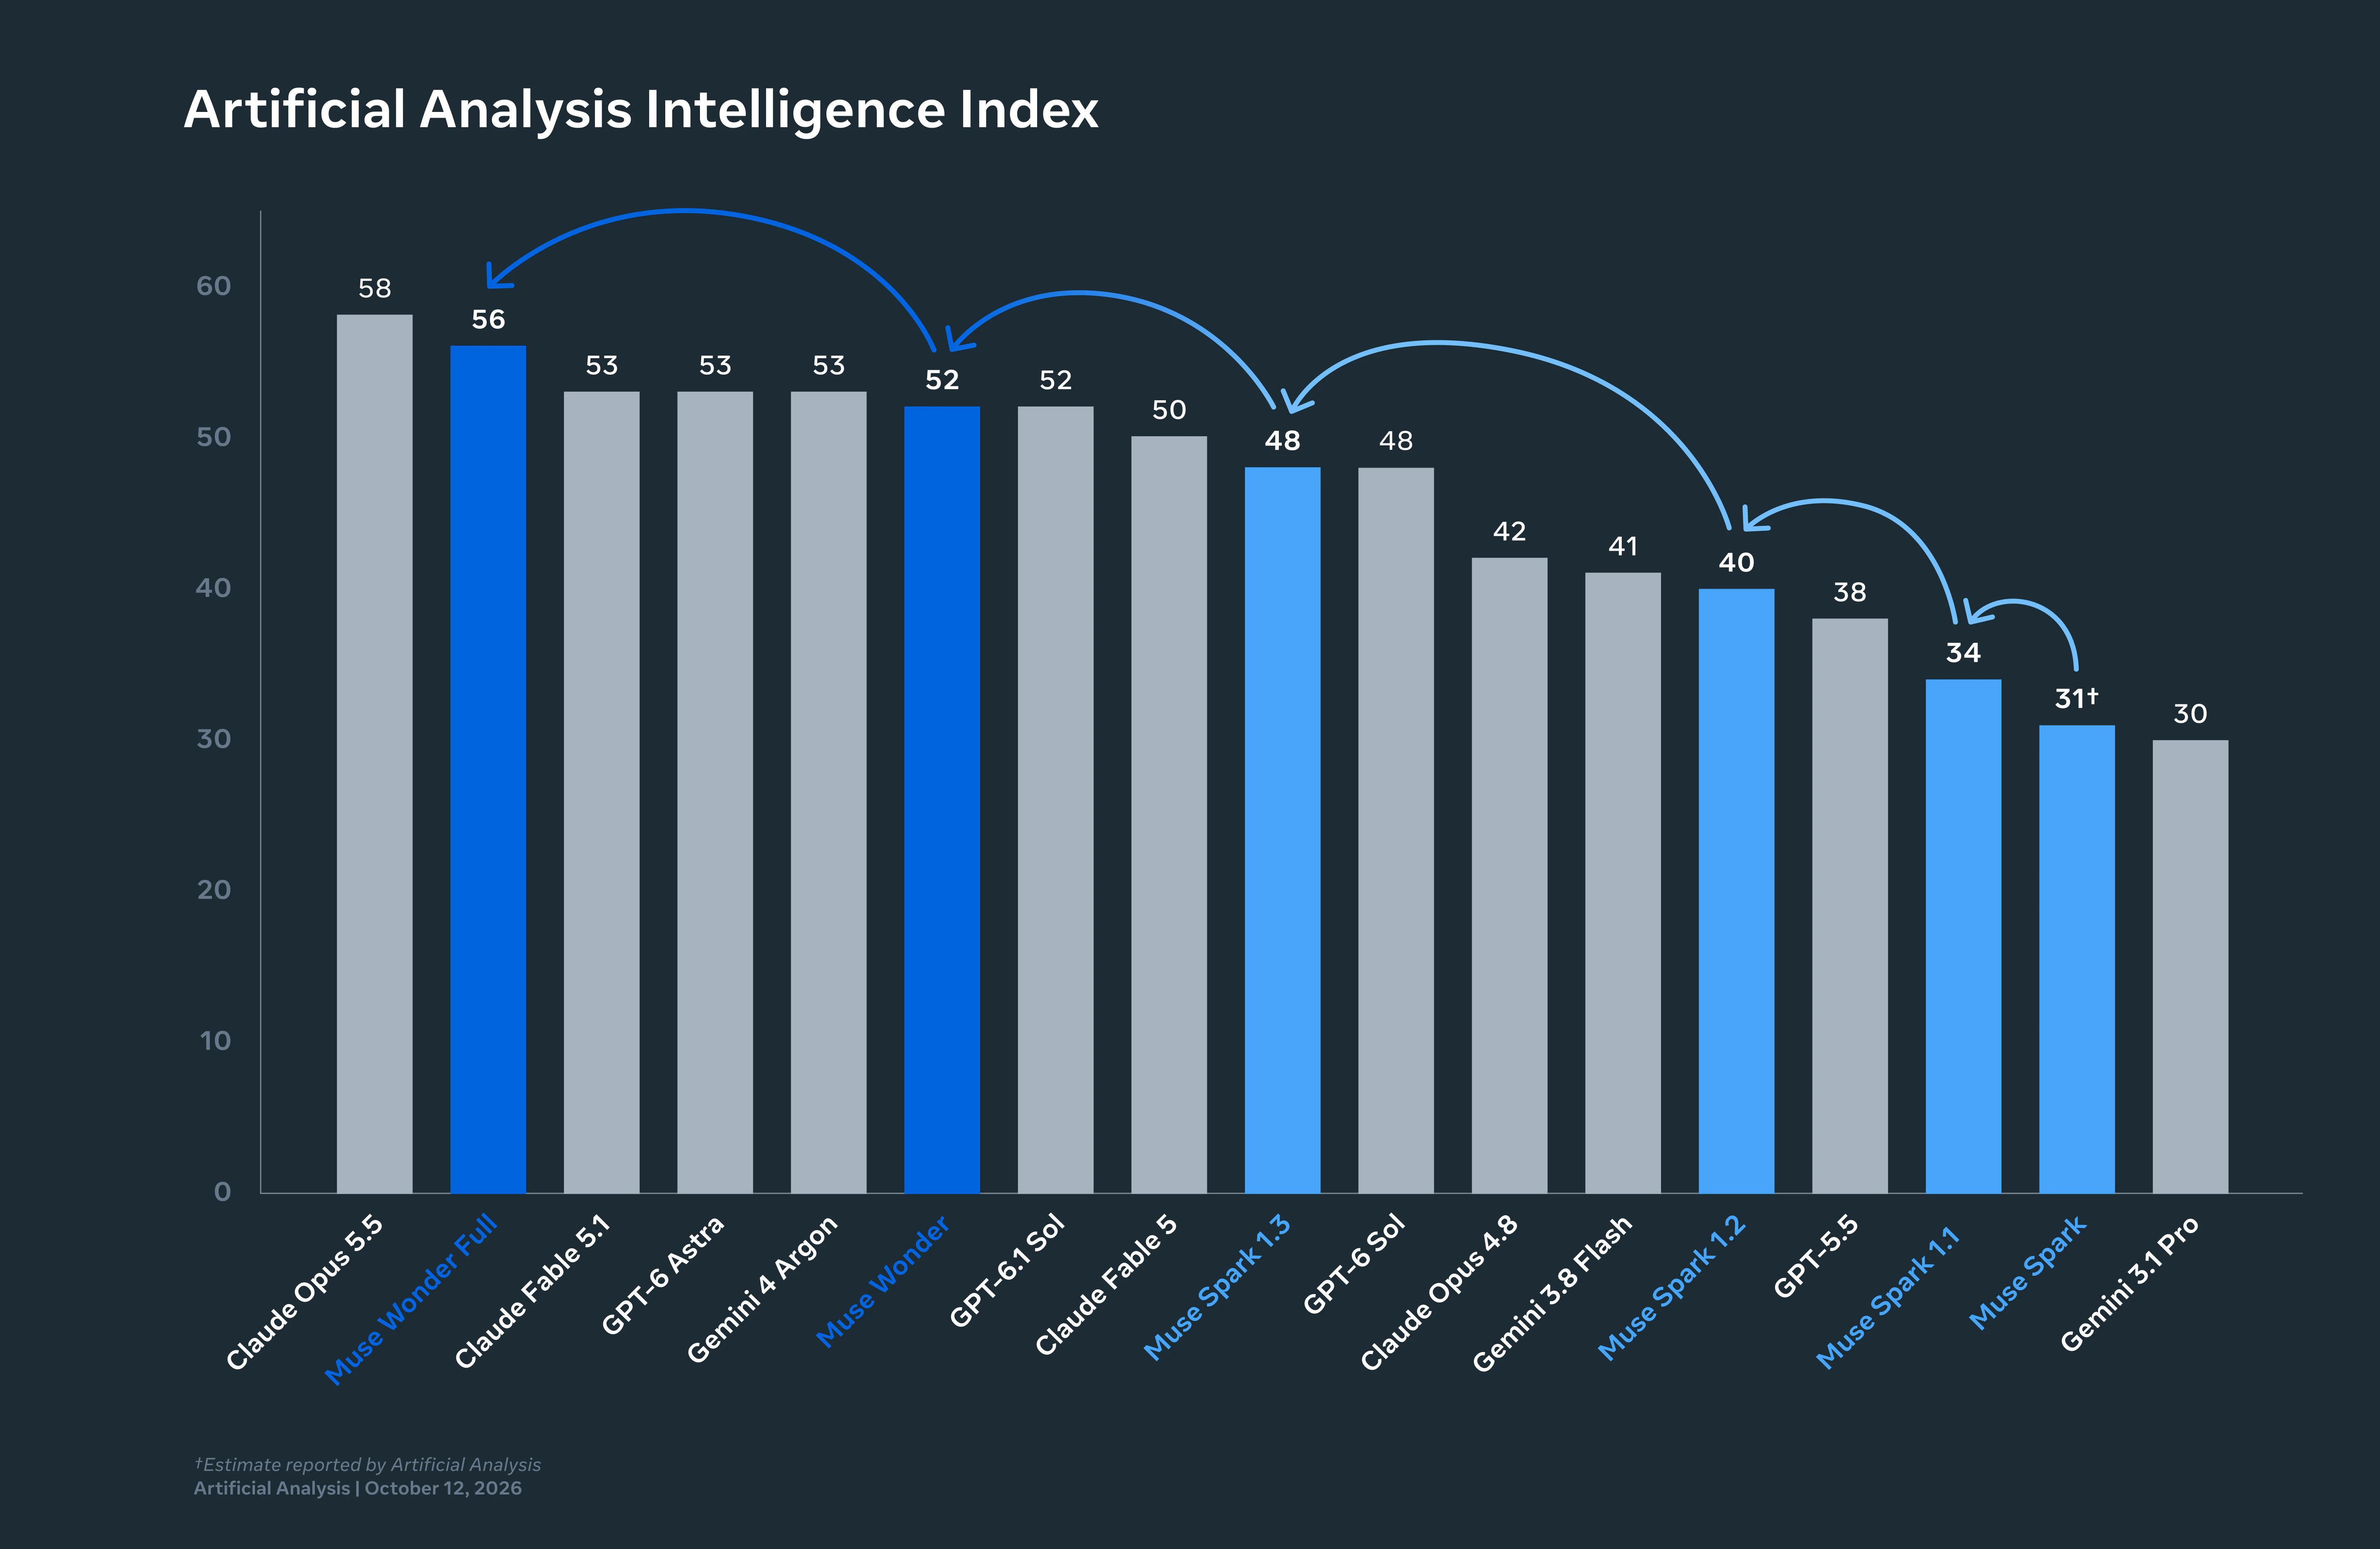
Muse Wonder und Claude Opus 5.5 kosten exakt dasselbe: 4 $ pro Million Input-Tokens und 20 $ pro Million Output-Tokens. Für eine Crew ist die Entscheidung zwischen beiden Modellen daher keine Frage des Budgets, sondern eine Routing-Regel. Metas Model Card sieht Wonder bei Benchmarks für langwierige Programmieraufgaben vorn (SWE-Marathon: 53,1 zu 46,3), während Opus bei Terminal-Arbeiten (59,6 zu 52,0), allgemeiner Intelligenz (58 zu 52 im unabhängigen Index) und Wissen (46 zu 25) die Nase vorn hat. Diese vier Kennzahlen beschreiben zwei grundverschiedene Agenten – und ein Board, das Aufgaben anhand dieser Werte zuweist, holt aus beiden Modellen deutlich mehr heraus als eines, das stur auf einen Standard setzt.
Dieser Beitrag übersetzt diese Zahlen in konkrete Zuweisungen: Welche Tasks an einen Muse Wonder Agent gehen, welche bei Opus 5.5 bleiben, wie sich das auf die Review-Queue auswirkt und woran Sie nach einer Woche erkennen, ob die Regel aufgeht. Die Einrichtung der Meta-Lane finden Sie in der Anleitung how to run Muse Wonder agents in Sharkly.
Die Kennzahlen, auf die es beim Routing ankommt
| Metrik | Muse Wonder | Claude Opus 5.5 | Quelle |
|---|---|---|---|
| SWE-Marathon (lange Programmierläufe) | 53,1 | 46,3 | Meta model card |
| DeepSWE 1.1 | 78,8 | 74,2 | Meta model card |
| Terminal-Bench 4.0 | 52,0 | 59,6 | Meta model card |
| AA-Omniscience (Wissen) | 25 | 46 | Artificial Analysis |
| Halluzinationsrate | 27 % | niedriger laut AA-Ranking | Artificial Analysis |
| Intelligence Index | 52 | 58 | Artificial Analysis |
| Coding Agents Index | 63 | 66 (Claude Code) | Artificial Analysis |
| Kosten pro Index-Task | 4,52 $ | 5,98 $ | Artificial Analysis |
| Inputs | Text, Bild, Video, Audio | Text, Bild, PDF | Herstellerdokumentation |
Betrachten Sie die Tabelle als zwei unterschiedliche Profile. Wonder: beharrlich, günstiger pro Task durch prägnantere Ausgaben, schwächer beim Faktenabruf, verarbeitet Video und Audio. Opus: in der Gesamtheit intelligenter, souveräner in der Shell, wissensstärker, aber teurer pro Task. Keines der Profile ist per se besser – sie eignen sich schlicht für unterschiedliche Tasks.
Tasks für den Muse Wonder Agent
Der gemeinsame Nenner sind langwierige Abläufe mit unerwarteten Hürden. Meta hat das Modell auf sogenanntes „Active Focus“ trainiert – das systematische Ausprobieren alternativer Lösungswege und das Überwinden von Blockern. SWE-Marathon ist genau der Benchmark, der entwickelt wurde, um diese Fähigkeit zu messen.
- Dateiübergreifende Refactorings, bei denen die Testsuite grün bleiben muss. Viele Einzelschritte, von denen jeder überprüfbar ist, und Fehlschläge, die einen zweiten oder dritten Anlauf erfordern.
- Dependency- und Framework-Migrationen. Der klassische Dauerlauf: aktualisieren, scheitern, reparieren, wiederholen – wobei die Aufgabe des Modells darin besteht, auch bei Schritt elf nicht aufzugeben.
- Fix-and-Verify-Schleifen bei unzuverlässigen („flaky“) Testsuites. Durchläufe, bei denen der Agent eigene Fehler von bestehenden Problemen der Testsuite unterscheiden können muss.
- Tasks mit Video- oder Audio-Inputs. Eine Bildschirmaufnahme eines Bugs oder der Mitschnitt eines Gesprächs mit Anforderungen. Opus 5.5 kann solche Eingaben nicht verarbeiten.
Formulieren Sie das Akzeptanzkriterium so, dass der Durchlauf es eigenständig überprüfen kann. Wonder brilliert, wenn der Task lautet: „Alle Tests in packages/api laufen erfolgreich durch und das Changelog enthält einen Eintrag.“ Das Modell stößt dagegen an seine Grenzen, wenn es selbst entscheiden muss, wann eine Aufgabe als erledigt gilt.
Tasks, die bei Opus 5.5 bleiben
- Terminal-lastige Arbeiten. Infrastruktur-Skripte, Deployment-Pipelines und alles, worin sich der Agent primär in einer Shell bewegt. Ein Vorsprung von siebeneinhalb Punkten im Terminal-Bench ist ein spürbarer Unterschied.
- Alles, was auf fundiertem Wissen basiert. Ein Omniscience-Wert von 25 gegenüber 46 bedeutet, dass Wonder mit doppelt so hoher Wahrscheinlichkeit ein entscheidendes Detail fehlt. Bei unbekannten Bibliotheks-APIs, obskuren Fehlercodes oder speziellem Domänenwissen antwortet Opus direkt aus dem Gedächtnis, während Wonder nachschlagen oder raten muss.
- Die Reviewer-Rolle. Der Agent, der den Diff eines anderen Agenten prüft und beurteilt, ob er korrekt ist, sollte das intelligenteste Modell sein, das Ihnen zur Verfügung steht. Im kombinierten Gesamtindex ist das Opus – und das Mixed-Model-Crew-Muster setzt das teurere Modell ohnehin an genau diese Stelle.
- Kurze, präzise Tasks. Bei DeepSWE liegen beide Modelle eng beieinander; bei der allgemeinen Intelligenz führt Opus. Wenn ein Durchlauf nur zehn Minuten dauert, kommt der Ausdauervorteil von Wonder gar nicht erst zum Tragen.
Auswirkungen auf die Review-Queue
Das Routing verändert, was letztlich bei den Reviewern landet – und genau hier entstehen die wahren Kosten.
Ein Wonder-Durchlauf bei einem langen Task hinterlässt eine längere Spur: mehr Versuche, mehr verworfene Ansätze, mehr Commits. Das zeigt lediglich, dass das Modell seine Arbeit macht, bedeutet aber auch, dass der reine Diff nicht die ganze Geschichte erzählt. Der Reviewer benötigt das Ausführungsprotokoll – deshalb sollte die Instruktion des Agenten vorsehen, dass er lückenlos dokumentiert, was er ausprobiert hat. Das Prinzip Human Review als Engpass greift hier mit besonderer Härte: Ein beharrlicheres Modell erzeugt pro Task mehr Review-Aufwand, nicht weniger.
Wonders Wissenslücken äußern sich in selbstsicher formulierten, aber falschen Details: ein Flag, das es gar nicht gibt, oder eine Methode, die vor zwei Versionen umbenannt wurde. Die Halluzinationsrate ist mit 27 % nach der Messung von Artificial Analysis zwar niedrig für seine Modellklasse, aber 27 % sind eben nicht null. Weisen Sie den Agenten an, alles, worüber er sich nicht sicher ist, direkt im Repository gegenzuprüfen und offenzulegen, wenn ihm das nicht möglich war. Der Reviewer sollte dann genau diese Zeilen stichprobenartig kontrollieren.
Ein Opus-Durchlauf beim selben Task führt in der Regel zu einem kürzeren, zielgerichteteren Ablauf und höheren Kosten pro Task. Der Review-Aufwand pro Durchlauf fällt geringer aus. Wenn eine Aufgabe jedoch langwierig und voller Hürden ist, gibt Opus eher vorzeitig auf. Das führt zu einer anderen Art von Problem in der Queue: einem unvollständig bearbeiteten Task, dessen Scope neu abgesteckt werden muss.
Drei Beispiel-Tasks und ihr Routing
Konkrete Beispiele erleichtern die Zuweisung in der Praxis.
„Das ORM über alle Services hinweg von v5 auf v7 aktualisieren; alle Integrationstests müssen erfolgreich durchlaufen.“ Wonder. Dutzende Einzelschritte, eine Testsuite, die bei jeder Stufe neue Fehler meldet, und eine klar definierte Ziellinie. Hier ist die Ausdauer des Modells der entscheidende Trumpf, und der Durchlauf kann das Akzeptanzkriterium eigenständig validieren.
„Den Terraform-Code für die neue Staging-Umgebung schreiben und ausführen.“ Opus. Sehr shell-lastig, erfordert spezifisches Infrastrukturwissen und beinhaltet Aktionen mit weitreichenden Konsequenzen. Terminal-Bench spricht für Opus; der potenzielle Schadensradius verlangt zudem, dass der Agent vor dem Ausführen von apply innehält und nachfragt – ganz gleich, welches Modell im Einsatz ist.
„Erklären, warum der Payment-Webhook doppelt auslöst, und einen Fix vorschlagen.“ Opus für die Erklärung, da hierfür das Verständnis der Retry-Semantik des Anbieters erforderlich ist – also reiner Wissensabruf. Falls der vorgeschlagene Fix in eine dateiübergreifende Codeänderung inklusive Tests mündet, kann dieser Folge-Task an Wonder übergeben werden.
Das Grundmuster lautet: Wonder für Tasks mit klar messbarem Ziel, Opus für Tasks, die tiefes Vorwissen erfordern. Wenn eine Aufgabe beides verlangt, teilen Sie sie auf. Sharkly ist genau auf diese Aufteilung ausgelegt: ein Task pro Agent pro Lane, wobei die Übergabe transparent auf dem Board festgehalten wird, anstatt in den Köpfen der Beteiligten zu verbleiben.
Beide Modelle einsetzen und die Ergebnisse auswerten
Wenden Sie diese Regel eine Woche lang auf Ihrem Board an und lassen Sie die Tasks entscheiden.
- Erstellen Sie den Muse Wonder Agent und behalten Sie den Opus 5.5 Agent. Weisen Sie beide Agenten per Instruktion an, die Modell-ID oben im Report auszugeben, da Sharkly diese nicht anzeigt.
- Weisen Sie Tasks nach den oben genannten Regeln zu, nicht nach persönlicher Vorliebe: Langwieriges und Blockierendes an Wonder, Terminal- und Wissensaufgaben an Opus, Reviews ebenfalls an Opus.
- Werten Sie nach einer Woche die von den jeweiligen Agenten abgeschlossenen Tasks aus und prüfen Sie drei Faktoren: Wie viele Tasks lieferten eine Rückfrage statt eines Ergebnisses, wie viele benötigten einen zweiten Durchlauf und wie viele Review-Kommentare fielen jeweils an?
Wenn Wonders lange Tasks mit weniger Re-Runs abgeschlossen werden und die Terminal-Tasks von Opus mit weniger Korrekturen auskommen, hat sich die Regel bewährt. Wenn Wonders Tasks jedoch mehr Review-Kommentare nach sich ziehen, als durch eingesparte Re-Runs gewonnen wird, grenzen Sie die Aufgabenauswahl weiter ein. Die Zahlen in der Tabelle sind Durchschnittswerte aus Benchmarks – ausschlaggebend sind allein Ihre tatsächlichen Tasks.
Nichts davon landet auf Ihrer Sharkly-Rechnung. Die Modellnutzung läuft über die auf dem Computer hinterlegten API-Keys von Meta und Anthropic. Bei identischen Listenpreisen besteht der einzige Kostenunterschied in dem Betrag, den der usage-Block pro Durchlauf ausweist.
Die Modelle haben sich in diesem Monat weiterentwickelt. Kontext, Fortschritt, Blocker, Ergebnisse und das menschliche Review bleiben von der Anforderung bis zum Release lückenlos sichtbar. Sie können dies manuell mit Worktrees aufsetzen – oder Sharkly nutzen, um den Workflow zu verwalten.


