

Sie starten drei Runs vor dem Mittagessen. Neunzig Sekunden später haben zwei der drei Terminals überhaupt nichts ausgegeben. Eines davon arbeitet sich gerade durch das Repository. Eines ist beim Rausgehen in einen 504 gelaufen und kommt nie wieder zurück. Von Ihrem Platz aus sind sie dasselbe Rechteck Scrollback mit einem Cursor darin.
Das ist kein neues Problem, aber die Launches vom 22.09.2026 haben es in einer konkreten, messbaren Weise verschlimmert. Die höchsten Reasoning-Einstellungen der neuen Modelle erkaufen sich Genauigkeit dadurch, dass sie lange nachdenken, bevor sie überhaupt etwas sagen. Artificial Analysis hat für die „max“-Reasoning-Variante von GPT-6 Sol 102,15 Sekunden bis zum ersten Token gemessen, bei GPT-6 Luna 124,23 Sekunden. Das sind Drittanbieter-Messungen auf einer bestimmten Konfiguration, keine Herstellerangaben, und dieser Vorbehalt ist wichtig, aber die Richtung steht außer Zweifel: Die Stille zu Beginn eines Runs ist inzwischen lang genug, um nicht mehr von einem Fehlschlag zu unterscheiden zu sein.
TL;DR
Die Zeit bis zum ersten Token ist die Verzögerung zwischen dem Absenden einer Anfrage und dem Eintreffen des ersten Zeichens der Antwort, und bei einem Reasoning-Modell mit hohem Effort-Aufwand findet genau in dieser Verzögerung der größte Teil des Denkens statt. Ein Terminal kann Ihnen nicht sagen, wo der Unterschied liegt zwischen einem Run, der nachdenkt, einem Run, der auf einen Menschen wartet, und einem Run, der vor zwei Minuten gestorben ist – denn alle drei geben nichts aus. Ein Status kann das. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab. Damit dieser Vertrag funktioniert, braucht es einen Run-Status, der sichtbar ist, ohne dass jemand danach Ausschau hält: Sharkly hält Kontext, Fortschritt, Blocker, Ergebnisse und Human Review am Task fest – von der Anfrage bis zum Release –, damit ein langer Gedanke und ein toter Run nicht mehr gleich aussehen.
Die Wartezeit ist länger geworden, und das günstige Modell ist nicht das schnelle
Das sagen die Drittanbieter-Messungen über die beiden neuen GPT-6-Modelle auf ihrer maximalen Reasoning-Einstellung.
| Modell | API-ID | Ausgabegeschwindigkeit | Zeit bis zum ersten Token | Input / Output pro 1 Mio. Token |
|---|---|---|---|---|
| GPT-6 Sol (max) | gpt-6-sol |
115,2 Token/s | 102,15 s | $2 / $10 |
| GPT-6 Luna (max) | gpt-6-luna |
153,9 Token/s | 124,23 s | $0,10 / $0,50 |
Lesen Sie die letzten beiden Spalten zusammen. Luna kostet ein Zwanzigstel von Sol pro Token und lässt Sie länger warten, bevor es spricht. Kosten und Latenz sind getrennte Achsen, und die Intuition, ein günstigeres Modell sei auch ein flotteres Modell, ist hier schlicht falsch.
Zwei ehrliche Einschränkungen, bevor jemand auf Basis dieser Zahlen ein Dashboard baut. Erstens stammen sie von Artificial Analysis und nicht von OpenAI, und sie beschreiben speziell die „max“-Reasoning-Varianten. Die niedrigeren Effort-Einstellungen sind ein anderes Kaliber, und Ihre eigenen Werte werden sich mit der Prompt-Größe, der Verfügbarkeit von Tools und dem Weg Ihres Traffics verschieben. Zweitens ist die Zeit bis zum ersten Token nicht dasselbe wie die Ausgabegeschwindigkeit. Anthropic gibt an, dass Claude Opus 5.5 etwa 30 % schneller Ausgaben produziert als Opus 5 – eine Aussage über die Token nach dem ersten. Ein Modell kann schnell streamen und Sie trotzdem eineinhalb Minuten lang auf nichts starren lassen.
Ein stilles Terminal ist kein Status
Stille in einem Terminal hat mindestens vier Ursachen, und das Terminal stellt sie alle identisch dar:
- Die Runtime arbeitet. Es findet Reasoning statt, noch keine Ausgabe.
- Der Run ist vor einer Weile fertig geworden und wartet darauf, dass ein Mensch eine Frage beantwortet.
- Die Anfrage ist fehlgeschlagen. Die Sharkly-Dokumentation ist unmissverständlich, wie leicht dieser Fall zu verwechseln ist: „Timeout / 408 / 504 bedeutet, dass die Anfrage langsam war, abgebrochen wurde oder durch ein Gateway verzögert wurde. Das ist nicht dasselbe wie ein Computer, der offline ist.“
- Der Computer ist tatsächlich weg, oder das Verzeichnis, das der Run brauchte, war nie frei.
Ein Agent, ein Terminal – und Sie lösen das, indem Sie noch eine Minute warten. Fünf Agenten über drei Repositories und zwei Computer – und Sie lösen es, indem Sie zwischen Fenstern hin- und herwechseln und raten. Das ist die gewöhnliche Ausprägung des Agenten-Chaos: kein dramatischer Fehlschlag, sondern ein Team, das mehrmals pro Stunde seine Aufmerksamkeit auf die Frage „Ist der hier noch am Leben?“ verwendet.
Der Reflex, zu dem viele greifen, ist: abschießen und neu starten. Bei hohem Reasoning-Aufwand ist dieser Reflex doppelt teuer. Sie zahlen die gesamte Wartezeit auf das erste Token erneut, und Sie werfen das Denken weg, das gerade dabei war anzukommen.
Was ein Status auseinanderhalten muss
Sharklys eigenes Modell lohnt sich zu übernehmen, ob Sie Sharkly nutzen oder nicht, weil es zwei Dinge trennt, die ein Terminal verschmilzt. Es ist dieselbe Trennung, die Run-Status, Logs und Fehlersignale überhaupt erst lesbar macht. Ein Run hat einen Ausführungszustand: Queued, Dispatched, Waiting for local directory, Running, Completed, Failed oder Canceled. Ein Task hat einen Lifecycle-Status, und ein Agent hat obendrein einen Arbeitszustand: Working, Waiting for human reply, Waiting for human review oder Error. Die Dokumentation benennt die Grenze klar: Diese Run-Zustände „bedeuten nicht automatisch, dass der Task denselben Workflow-Status hat“.
Genau diese Trennung ist die ganze Antwort auf die Frage „hängt er oder denkt er nach?“.
| Was das Terminal zeigt | Was es tatsächlich sein kann | Woran man sie unterscheidet | Wer als Nächstes handelt |
|---|---|---|---|
| Nichts, nach 100 s | Running, vor dem ersten Token | Run-Status ist Running, das Log enthält einen Dispatch-Zeitstempel | Niemand. Laufen lassen. |
| Nichts, nach 10 Min. | Waiting for human reply | Arbeitszustand hat gewechselt, der Task wirft ein Attention-Item im Inbox auf | Der Assignee antwortet im Kontext |
| Nichts, für immer | Failed | Run-Status ist Failed, das Ausführungs-Log enthält den Titel und die ursprüngliche Antwort des Model-Service | Der Assignee liest das Log, bevor er erneut startet |
| Nichts, nie gestartet | Queued oder Waiting for local directory | Run-Status, plus welcher Verzeichnis-Pool belegt ist | Ein Verzeichnis freigeben oder die parallele Kapazität erhöhen |
Keine dieser vier Zeilen erfordert, dass in dem Moment, in dem sie sich ändert, jemand zusieht. Das ist der Punkt. Der Zustand wird festgehalten, und die Frage „denkt er nach oder hängt er?“ wird zu etwas, das man nachschlägt, statt zu etwas, das man aussitzt.
Der Timeout pro Task, den Sie im März eingestellt haben
Ein Agent in Sharkly trägt eine maximale Anzahl parallel laufender Tasks und einen Timeout pro Task. Die meisten Teams setzen diesen Timeout einmal, früh, und zwar danach, wie lange sie bereit waren, auf ein Terminal zu starren. Wenn diese Zahl zwei Minuten beträgt und Sie inzwischen einen Agenten auf eine Max-Reasoning-Einstellung umgestellt haben, haben Sie eine Richtlinie konfiguriert, die Runs mitten in der Denkphase abbricht und sie als Fehlschläge meldet.
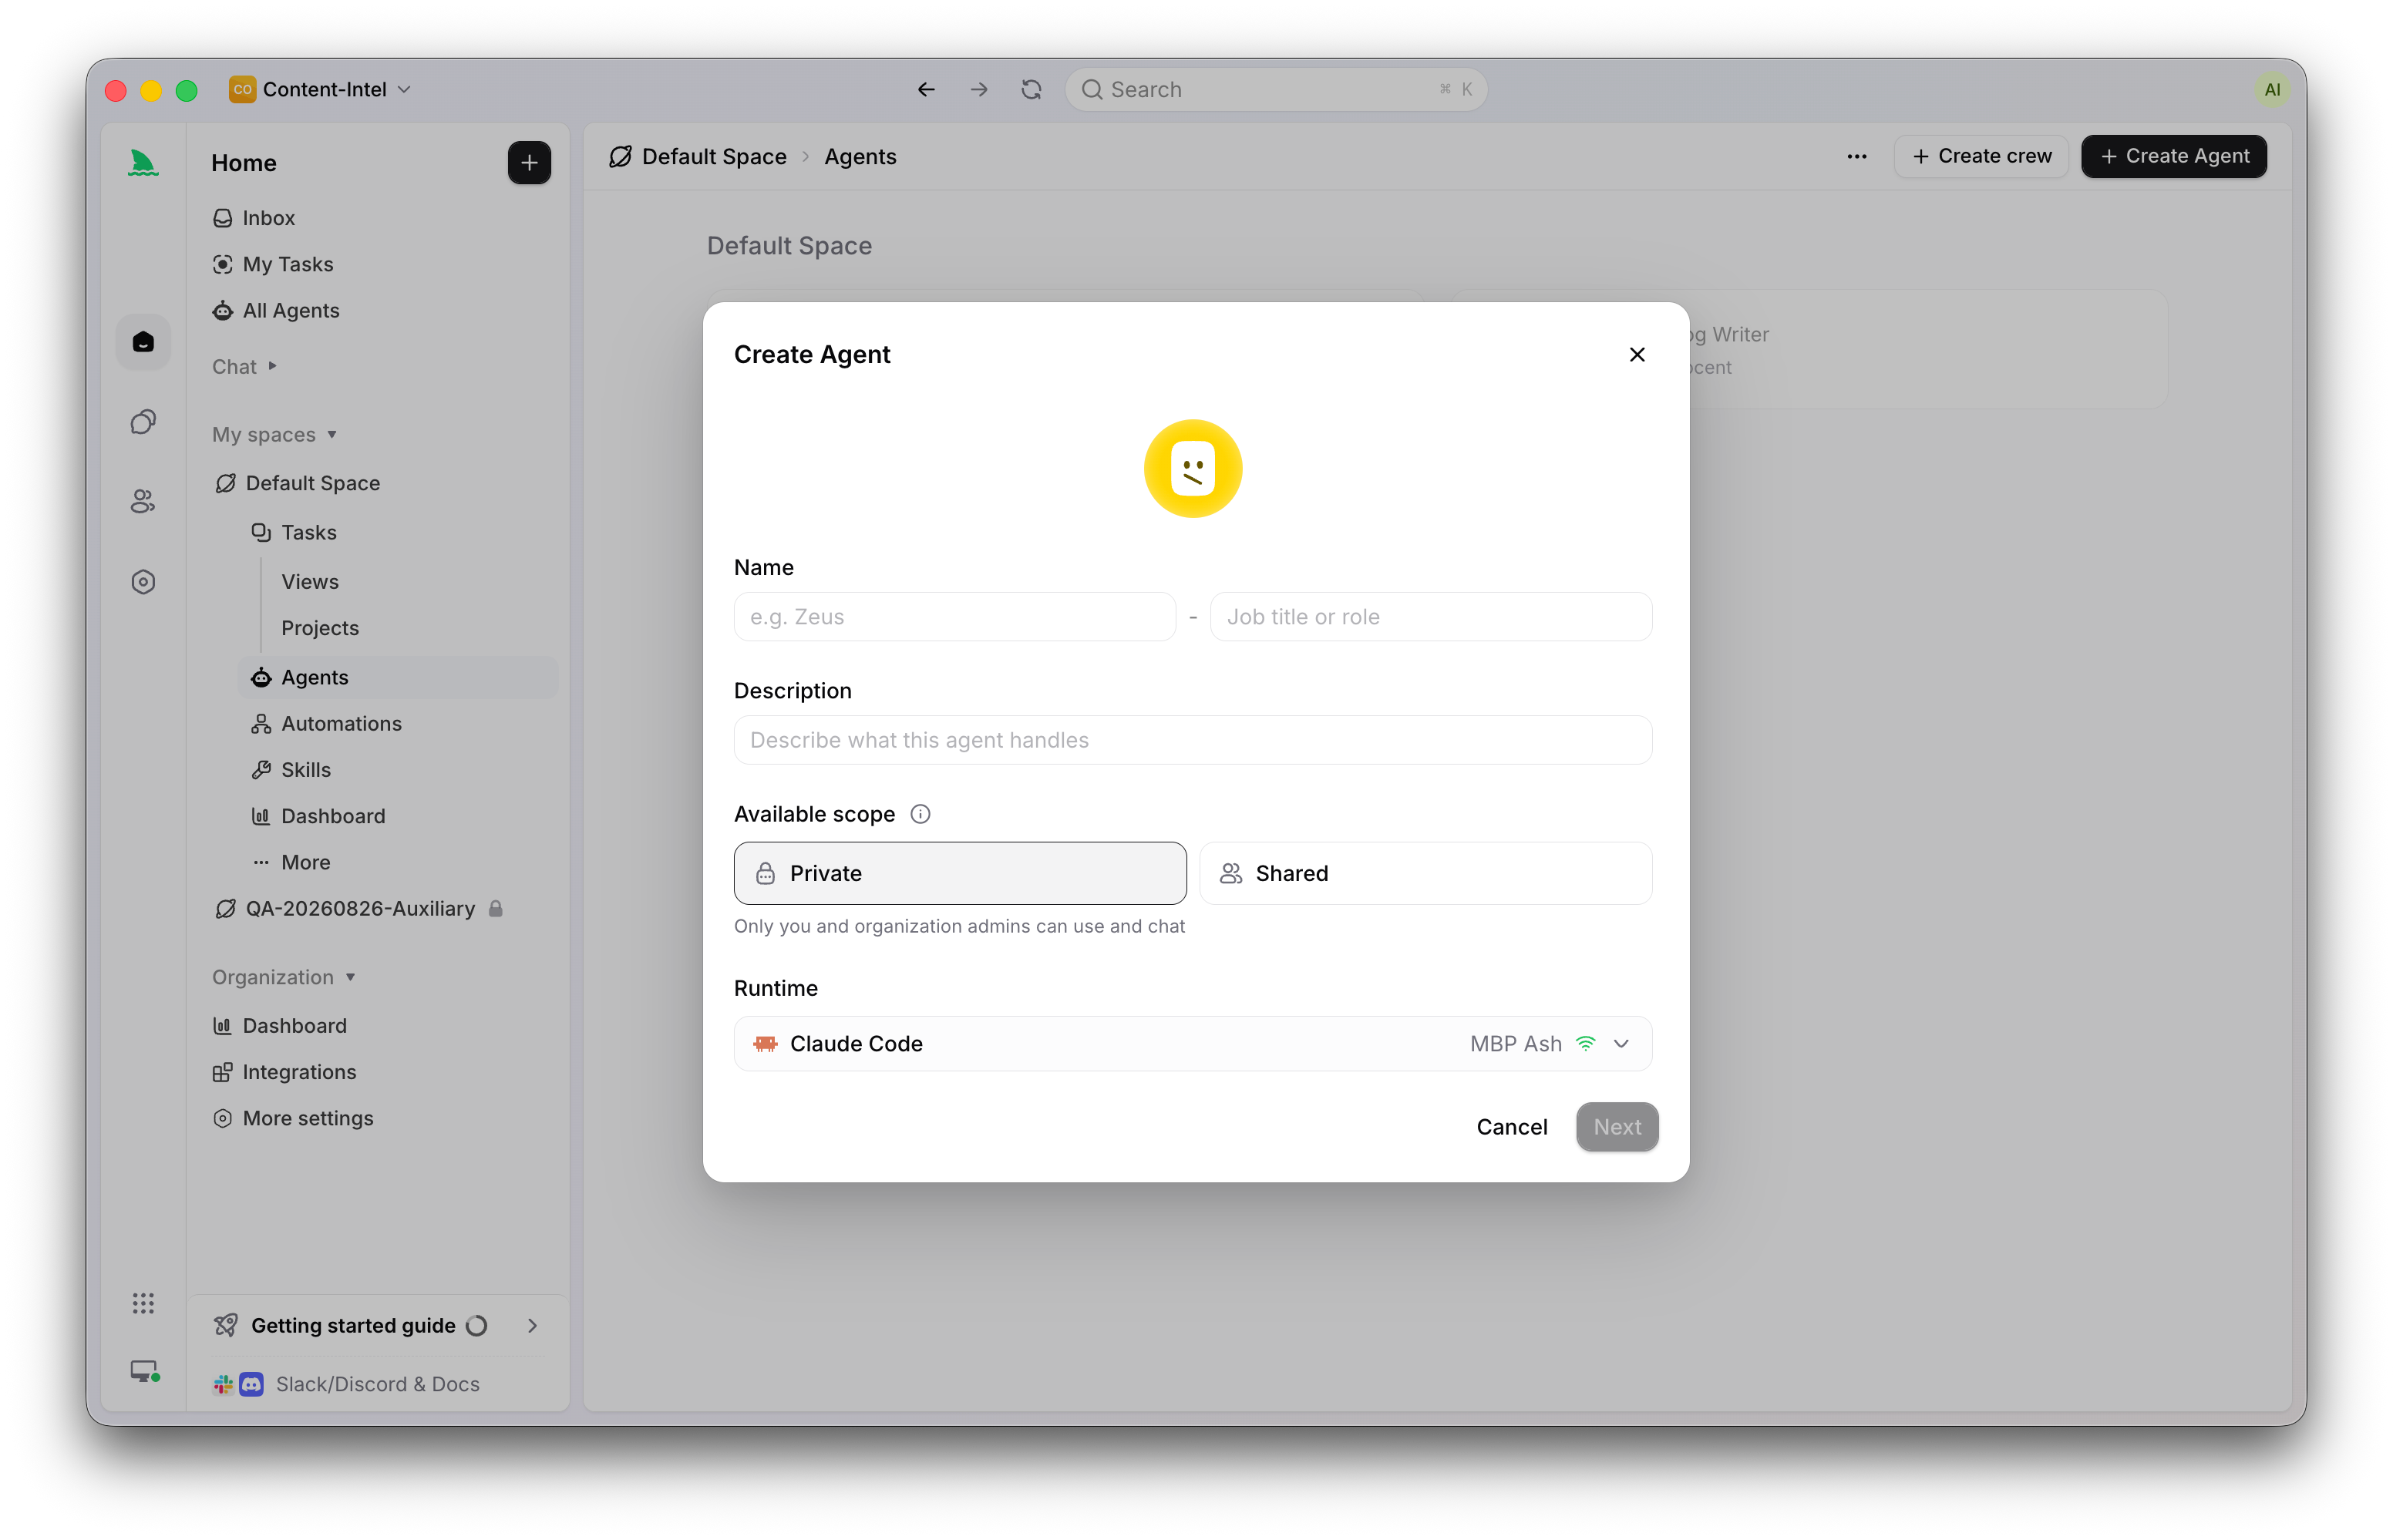
Sehen Sie sich Ihre in dieser Woche an. Die Untergrenze ist nicht „Wie lange bin ich bereit zu warten“, sondern „Wie lange braucht diese Runtime bei dem Effort-Level, das ich tatsächlich nutze, plus die Arbeit selbst“. Bei einem Run, dessen erstes Token allein über hundert Sekunden brauchen kann, ist ein Timeout unter fünf Minuten ein Münzwurf, der sich als Richtlinie verkleidet hat.
Zwei verwandte Einstellungen verdienen denselben Durchgang. Die maximale Anzahl parallel laufender Tasks ist Ihr tatsächliches Concurrency-Limit, und wenn jedes konfigurierte Verzeichnis belegt ist, bleiben neue Runs in Waiting for local directory stehen, statt fehlzuschlagen – korrektes Verhalten, das wie ein Hänger aussieht, wenn Sie nur ein Terminal beobachten.
Behebt Caching das Problem?
Teilweise, und nicht den Teil, den Sie wollen. OpenAIs Prompt-Caching für GPT-6 bietet 90 % Rabatt auf gecachte Input-Reads mit standardmäßig höheren Hit-Rates, ergänzt explizite Breakpoints, mit denen Sie festlegen, wo ein gecachter Prefix endet, und bricht den Cache nicht mehr, wenn Sie den Reasoning-Aufwand oder die Verfügbarkeit von Tools ändern. GitHub meldet über Milliarden von Anfragen hinweg mehr als 50 % weniger Prompt-Token, die neu verarbeitet werden müssen. Das ist ein echter Kosten- und Latenzgewinn beim Prompt, und die Korrektur für Effort-Änderungen ist für Agenten, die einen Task mitten im Ablauf von einer günstigen auf eine teure Einstellung hochstufen, wirklich nützlich.
Den Reasoning-Durchlauf entfernt das nicht. Ein warmer Cache bedeutet, dass weniger Ihres Prompts von Grund auf verarbeitet wird. Es bedeutet nicht, dass das Modell bereits über Ihren Bug nachgedacht hat. Kalkulieren Sie die Wartezeit trotzdem ein.
Wann sich die Wartezeit lohnt und wann nicht
Verwenden Sie eine maximale Reasoning-Einstellung, wenn es sich um einen Task handelt, den Sie nicht zweimal ausführen wollen: eine Migration, ein querschnittliches Refactoring, alles, wo eine falsche Antwort mehr kostet als neunzig Sekunden. OpenAI meldet für Sol auf seiner xhigh-Einstellung 33,2 % auf AutomationBench 1.0.6 bei $0,27 pro Task – das ist die Form dieses Tauschs. Genauigkeit ist heute günstig in Geld und teuer in Wanduhrzeit.
Verwenden Sie eine niedrigere Effort-Einstellung, wenn ein Mensch danebensitzt und auf die Antwort wartet. Interaktive Arbeit, eine kurze Frage zu einer Datei, ein kleiner abgegrenzter Fix: Bei niedrigerem Aufwand verschwindet das Stille-Problem weitgehend, weil das erste Token auftaucht, während Sie noch wissen, was Sie gefragt haben.
Und die ehrliche Grenze: Wenn Sie einen Agenten auf einem Task laufen lassen, brauchen Sie dafür kein Board. Dann hängen Sie sich ans Log. Das Statusproblem beginnt in dem Moment, in dem die Zahl der Runs die Zahl der Terminals übersteigt, die Sie sinnvoll beobachten können – und das sind für die meisten Menschen etwa drei.
Was das nicht behebt
Ein Status sagt Ihnen, dass ein Run arbeitet. Er sagt Ihnen nicht, dass der Run etwas Nützliches tut, und ein selbstsicher falscher Agent zeigt denselben grünen Status wie ein guter, solange der Run dauert – bei Opus 5.5 können das 18 Stunden oder mehr sein. „Läuft“ von „läuft gut“ zu unterscheiden, bleibt ein Review-Problem, und Review bleibt Aufgabe eines Menschen. Automatisierung endet dort, wo das Urteilsvermögen des Teams gefragt ist.
Wenn Sie bereits mehrere Agenten gleichzeitig laufen lassen, ist die kleinste sinnvolle Änderung in dieser Woche kein neues Modell. Es ist, den Status jedes Runs lesbar zu machen, ohne ein Terminal zu öffnen – damit die nächsten neunzig Sekunden Stille eine Information sind statt einer Frage.

