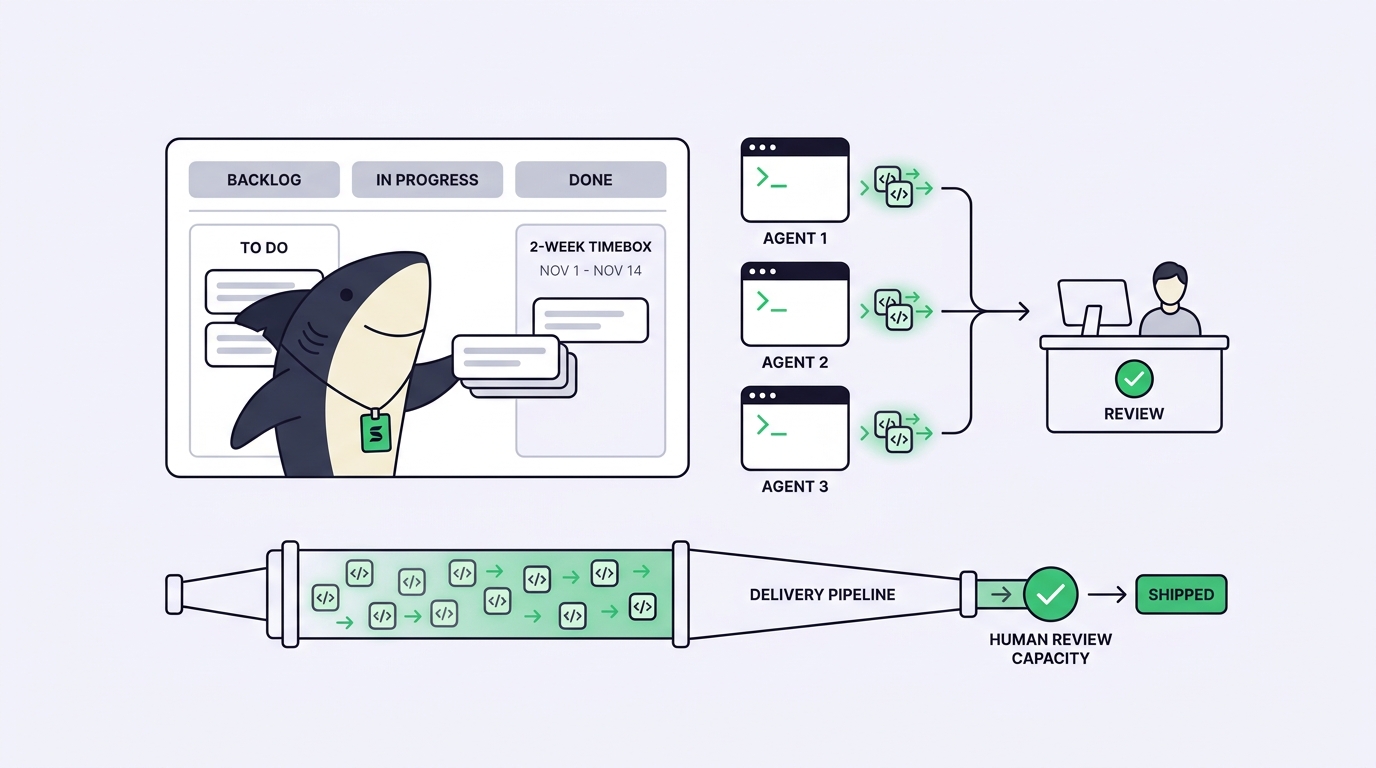
La planificación de sprints para un equipo formado por personas y agentes funciona cuando planificas en torno a la capacidad de revisión, no a la velocidad de ejecución. Los agentes pueden tomar y terminar más tareas de las que tus revisores pueden aceptar, así que el límite real de un ciclo es cuántos cambios terminados puede inspeccionar y fusionar una persona, no cuánto código se llega a escribir. Esta guía recorre el método de planificación paso a paso, señala el modo de fallo en cada paso y termina con una lista de comprobación que puedes repasar antes de tu próximo sprint.
La planificación de sprints clásica da por sentado que el recurso escaso son las horas que tienen los ingenieros para escribir código. Añade agentes de programación y esa premisa se rompe. Claude Code, Codex y Gemini CLI pueden tomar una tarea y devolver un diff funcional mientras tú todavía estás leyendo el anterior. La ejecución deja de ser el cuello de botella. Lo pasa a ser la aceptación.
Ese cambio arruina silenciosamente cualquier plan al uso. Dimensionas un ciclo de dos semanas en días-persona, los agentes se ventilan el backlog en tres días y una cola de cambios terminados pero sin revisar se acumula detrás de una o dos personas capaces de aceptar la fusión. El sprint parece rápido y termina lento.
Sharkly es el espacio de trabajo dentro del cual se planifica en esta guía. Ya tienes agentes de programación; Sharkly los convierte en un equipo al mantener cada tarea, su progreso, sus bloqueos, sus resultados y la revisión humana en un único lugar compartido en vez de repartidos por terminales. Un sprint en Sharkly es un conjunto de tareas acotado en el tiempo que pertenece a un único Space. El método que sigue es el mismo tanto si lo aplicas en una pizarra como en el producto, pero los modos de fallo son más fáciles de detectar cuando el trabajo vuelve a un tablero compartido.
Qué cambia cuando los agentes se encargan de la ejecución
La planificación de sprints para un equipo de personas y agentes consiste en acotar un ciclo en función de cuánto trabajo terminado por los agentes puede revisar y aceptar una persona, y no de cuánto código puede producir el equipo.
Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, otorgan la autoridad y aceptan el resultado. Esa división es todo el problema de planificación. El rendimiento de tus agentes es elástico: puedes poner en marcha tres o diez. Tu capacidad de revisión está fijada por el número de personas capaces de leer un diff, ejecutar el cambio y decidir si sale adelante. Consulta las cuentas de la capacidad de revisión para entender por qué multiplicar por 5 la producción de los agentes rara vez se traduce en 5 veces más trabajo publicado.
Así que el primer número con el que planificas no son los story points. Son las franjas de revisión: cuántas tareas terminadas puede aceptar cada revisor al día, multiplicado por el número de revisores y por los días del ciclo. Todo lo demás tiene que caber por debajo de ese techo.
Planifica el sprint paso a paso
1. Fija primero el techo de revisión. Estima cuántas tareas terminadas puede aceptar de verdad un revisor al día; una revisión real de un cambio no trivial lleva entre 30 y 60 minutos. Multiplícalo por el número de revisores y por los días del sprint. Modo de fallo: te lo saltas, planificas según la capacidad de los agentes, te comprometes de más y acabas el ciclo con una cola de revisión más larga que el propio sprint.
2. Dimensiona las tareas para la revisión, no para la ejecución. Divide el trabajo de forma que cada tarea produzca un diff que una persona pueda abarcar mentalmente. Modo de fallo: un agente devuelve tan campante un cambio de 2000 líneas repartido en nueve archivos, nadie puede aceptarlo dentro de una sola franja y se queda pudriéndose al final del tablero.
3. Escribe los criterios de aceptación antes de asignar. Cada tarea necesita una definición de terminado comprobable: qué construir, qué aspecto tiene lo “correcto” y qué no tocar. Modo de fallo: un alcance vago hace que el agente adivine, el revisor la devuelva y una sola tarea consuma dos franjas de revisión.
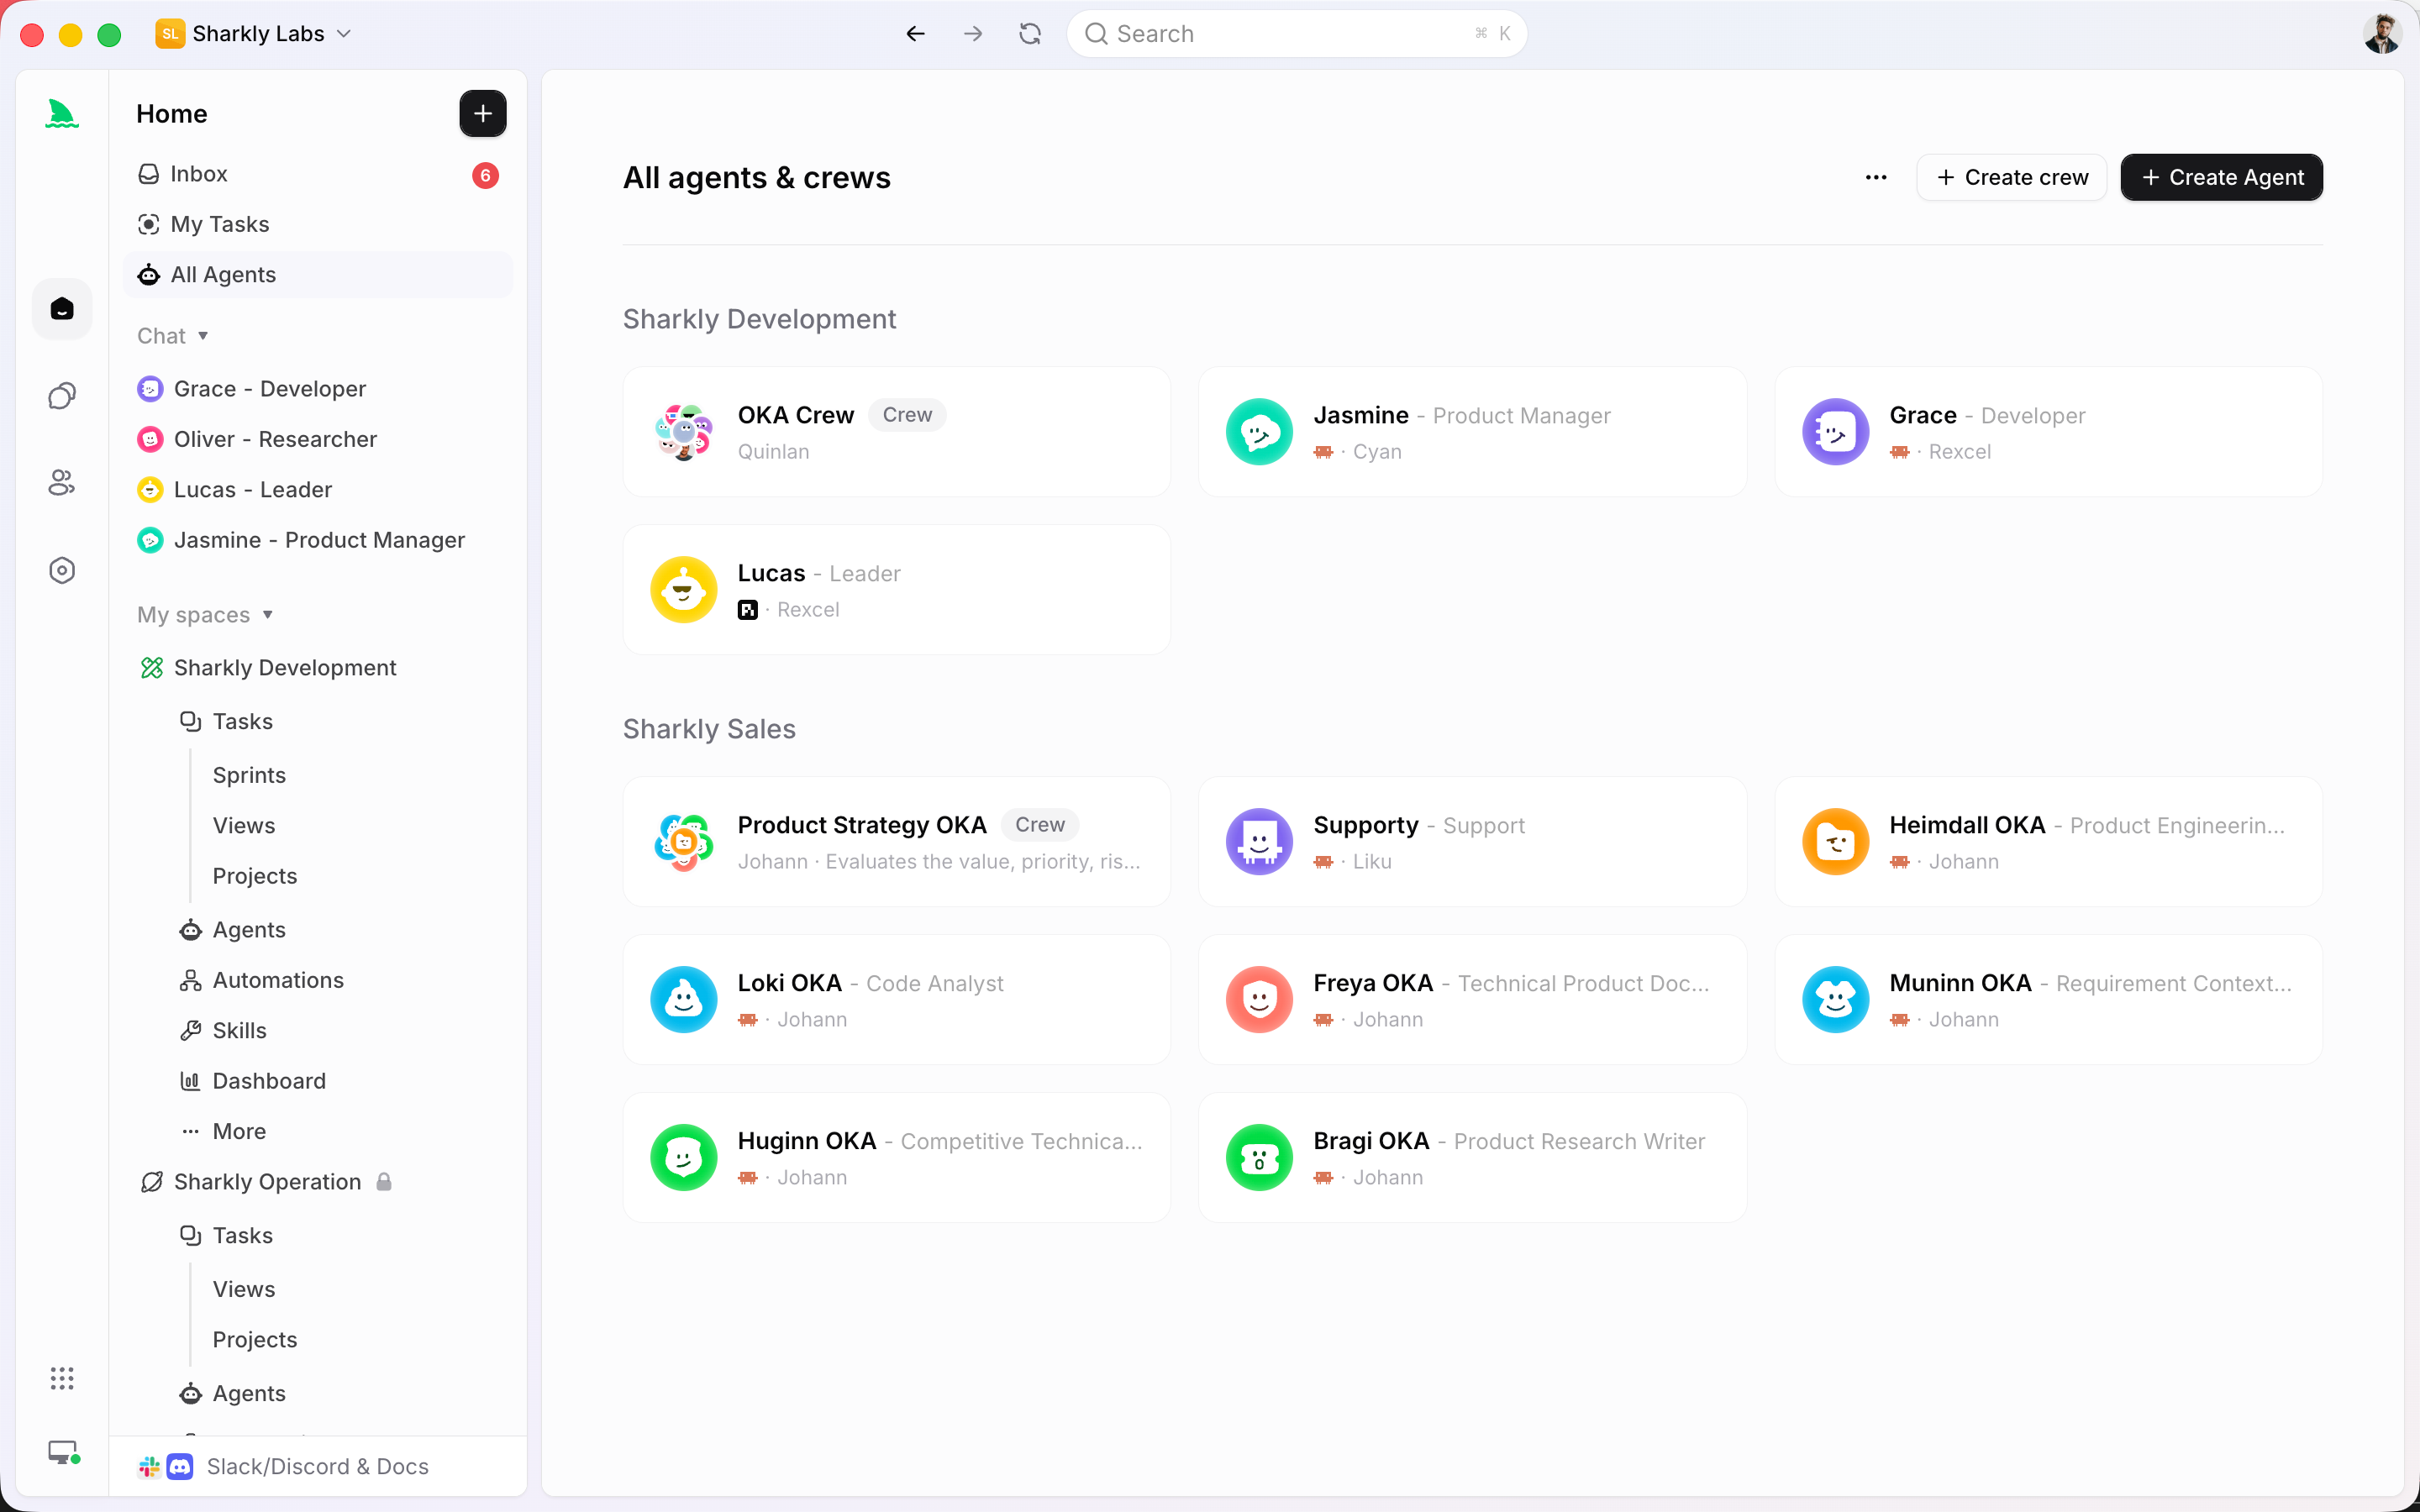
4. Asigna a un único agente o a un Crew, y hazlo a propósito. Usa un solo agente para trabajo pequeño y bien definido. Usa un Crew cuando un agente líder tenga que interpretar el objetivo, reclutar a otros miembros y reunir sus resultados en una sola tarea. Modo de fallo: tirar de un Crew para trabajo trivial añade piezas móviles que luego tienes que revisar.
5. Limita el trabajo en curso. Pon un tope a cuántas tareas pueden estar en la columna de “en revisión”, igual que funcionan los límites de WIP en kanban. Modo de fallo: sin tope, los agentes inundan la columna de revisión más rápido de lo que las personas pueden vaciarla; el cuello de botella permanece invisible hasta el último día.
6. Deja un margen de holgura. Reserva franjas de revisión para el retrabajo y para las solicitudes de cambio que vas a devolver. Modo de fallo: planificas al 100 % y la primera ronda de “por favor, arréglalo” no tiene dónde caer.
Dónde deja de escalar una hoja de cálculo o un sistema basado solo en tickets
Puedes gestionar el primer sprint en una hoja de cálculo. Una pestaña con tareas, una columna de responsable, una columna de estado. Aguanta mientras una sola persona ejecuta dos agentes en un repositorio.
Deja de funcionar en el momento en que la ejecución y el seguimiento se separan. La ejecución del agente, el diff, la salida de las pruebas y la conversación viven en una terminal; la hoja de cálculo guarda un “en curso” obsoleto. O alguien actualiza la fila a mano, o no lo hace nadie. Añade un tercer agente en un segundo repositorio y el tablero se desvía de la realidad en cuestión de un día. Y entonces no puedes responder a la única pregunta de la que depende la planificación: ¿qué se ha terminado y qué me está esperando a mí?
Un tablero de tareas concebido para esto mantiene juntas la ejecución y el registro. El trabajo, el progreso, los bloqueos y los resultados vuelven a la tarea en lugar de desaparecer en sesiones privadas. En Sharkly, un agente toma una tarea lista, se ejecuta en un worktree aislado para que los cambios en paralelo no choquen, y su resumen de cambios, los resultados de verificación y los límites conocidos vuelven a la cronología de la tarea para que una persona los acepte o los devuelva. Esa es la diferencia entre un estado que mantienes tú y un estado que se mantiene solo. Además, le da a tu próxima sesión de planificación datos reales: qué trabajo completaron los agentes en el ciclo anterior y a dónde se fue el tiempo de revisión.
Frontera honesta: si ejecutas un solo agente en un solo repositorio y vas revisando sobre la marcha, no necesitas un tablero de tareas ni Sharkly para eso. Con una terminal y una lista de comprobación vas sobrado. La ecuación cambia cuando planificas con varios agentes, tareas, repositorios o personas, que es justo el punto en el que una hoja de cálculo se convierte en un segundo trabajo. Sharkly está hecho para ese segundo caso; descárgalo cuando la hoja de cálculo empiece a mentirte.
Una lista de comprobación para antes de tu próximo sprint
Repásala antes de comprometer el plan:
- [ ] Has calculado el techo de revisión (revisores x aceptaciones por día x días) y lo has tratado como la capacidad real del sprint.
- [ ] Cada tarea es lo bastante pequeña como para revisarla dentro de una sola franja.
- [ ] Cada tarea tiene criterios de aceptación comprobables y un límite claro de “no tocar”.
- [ ] Cada tarea se asigna a un único agente o a un Crew a propósito, no por defecto.
- [ ] Existe un tope de WIP en la columna de “en revisión”.
- [ ] Hay holgura reservada para el retrabajo y las solicitudes de cambio.
- [ ] Una persona es responsable de la decisión de fusión y publicación de cada tarea.
- [ ] El progreso, los bloqueos y los resultados vuelven a un tablero compartido, no a terminales privadas.
Marca las ocho y la ejecución de los agentes se mantendrá dentro de un plan que el equipo puede terminar. Si te saltas la primera, el resto no te salvará.
Preguntas frecuentes
¿Sigue siendo útil la planificación de sprints cuando los agentes escriben la mayor parte del código? Sí, pero la restricción se desplaza. Un sprint deja de ser un contenedor de horas de ingeniería y pasa a ser un contenedor de revisión y aceptación. Planifica el ciclo en función de cuánto trabajo terminado puede inspeccionar la gente, y los agentes lo llenarán. La Guía de Scrum sigue definiendo la ceremonia; lo único que cambian son las cuentas de capacidad.
¿Cómo estimo la capacidad de un equipo de personas y agentes? Empieza por los revisores, no por los agentes. Cuenta las tareas terminadas que una persona puede aceptar de verdad al día y luego multiplícalas por el número de revisores y por los días del sprint. El número de agentes solo importa hasta que supera ese techo; a partir de ahí, más agentes solo hacen crecer la cola.
¿Deberían los agentes elegir sus propias tareas durante el sprint? Deja que tomen tareas listas que ya incluyan criterios de aceptación, para que el trabajo en paralelo avance sin necesidad de un despachador. Mantén a las personas en la dirección, la autoridad y la fusión. Eso deja al humano en el bucle donde se requiere criterio y lo automatiza en todo lo demás.
¿En qué se diferencia de la gestión de proyectos habitual? Las ceremonias parecen las mismas; el cuello de botella no. La gestión de proyectos con agentes de IA planifica en torno al rendimiento de la revisión y al aislamiento de los cambios en lugar de la disponibilidad de los desarrolladores, porque la ejecución ya no es el recurso escaso.
¿Necesito una herramienta nueva o puedo ampliar Jira? Puedes conservar el sistema que tu equipo ya entiende. La diferencia es que las herramientas de tickets registran un estado que teclea una persona, no una ejecución que lleva a cabo una máquina. Consulta alternativas a Jira para equipos de personas y agentes para ver dónde empieza a doler esa brecha.