Evalúe Claude Fable 5.2 en tareas representativas de su repositorio con criterios de aceptación fijos, entornos idénticos y una línea base que ya utilice. Mida de forma conjunta los cambios aceptados, el esfuerzo de revisión, el tiempo transcurrido y el coste total. Repita las ejecuciones, conserve los fallos y decida la adopción por categoría de tarea en lugar de basarse en una única puntuación de benchmark.
Anthropic anunció Fable 5.2 el 9 de noviembre de 2026. En su comunicado se destacan mejoras en programación y razonamiento. Sin embargo, se trata de afirmaciones del propio proveedor sobre sus evaluaciones y pruebas. No determinan cómo rinde el modelo frente a sus dependencias, convenciones y requisitos de lanzamiento.
Su evaluación debería responder a una pregunta más concreta: ¿qué trabajo puede delegar manteniendo una carga de revisión aceptable? Si varios agentes de programación ya comparten esa carga, Sharkly le ofrece un espacio para organizar las tareas y el contexto necesario para su revisión.
Esta guía propone un experimento. No incluye resultados comparativos medidos.
Crear un conjunto representativo de tareas
Una evaluación sobre el repositorio consiste en una comparación controlada de flujos de trabajo de desarrollo frente a requisitos extraídos de su propia actividad. La unidad de éxito es un cambio aceptado, incluidas sus pruebas y su revisión. Un parche plausible, un comando de pruebas que pase o un mensaje de finalización convincente no bastan por sí solos para considerar aceptado un cambio.
Comience con doce tareas extraídas de labores de mantenimiento recientes. Esta cifra es un tamaño sugerido para un piloto, no una garantía estadística. Incluya correcciones de errores, pequeñas mejoras, refactorizaciones y tareas de investigación en proporciones similares a las de su backlog.
Seleccione tareas con un commit inicial bien definido y un revisor que comprenda el comportamiento esperado. Evite elegir únicamente incidencias con soluciones obvias. Incluya al menos una tarea cuya respuesta correcta exija plantear una duda o explicar la ausencia de una dependencia.
En el caso de incidencias pasadas, elimine la solución del contexto facilitado. Registre si la solución ya era pública: es posible que el modelo la haya visto con anterioridad. Reserve un conjunto independiente de tareas no publicadas para una fase de confirmación posterior.
Defina los criterios de aceptación antes de cada ejecución. Para una corrección en la paginación de una API, especifique casos como resultados vacíos, límites de página, cursores no válidos y compatibilidad con clientes existentes. Incluya el alcance permitido de los cambios y las comprobaciones requeridas para su aceptación.
| Categoría | Tarea de ejemplo | Evidencia de aceptación |
|---|---|---|
| Corrección de errores | Corregir el control de límites del cursor | Prueba de regresión y paso de la suite existente |
| Pequeña funcionalidad | Añadir filtrado opcional de peticiones | Pruebas de contrato y valores predeterminados documentados |
| Refactorización | Extraer validación duplicada | Comportamiento público sin cambios y revisión aprobada |
| Investigación | Diagnosticar un timeout intermitente | Reproducción y explicación causal fundamentada |
Utilice tareas pequeñas cuando necesite una comparación limpia. Recurra a tareas más amplias si la coordinación forma parte de la evaluación, y puntúe ese experimento por separado.
Congelar las condiciones antes de ejecutar los agentes
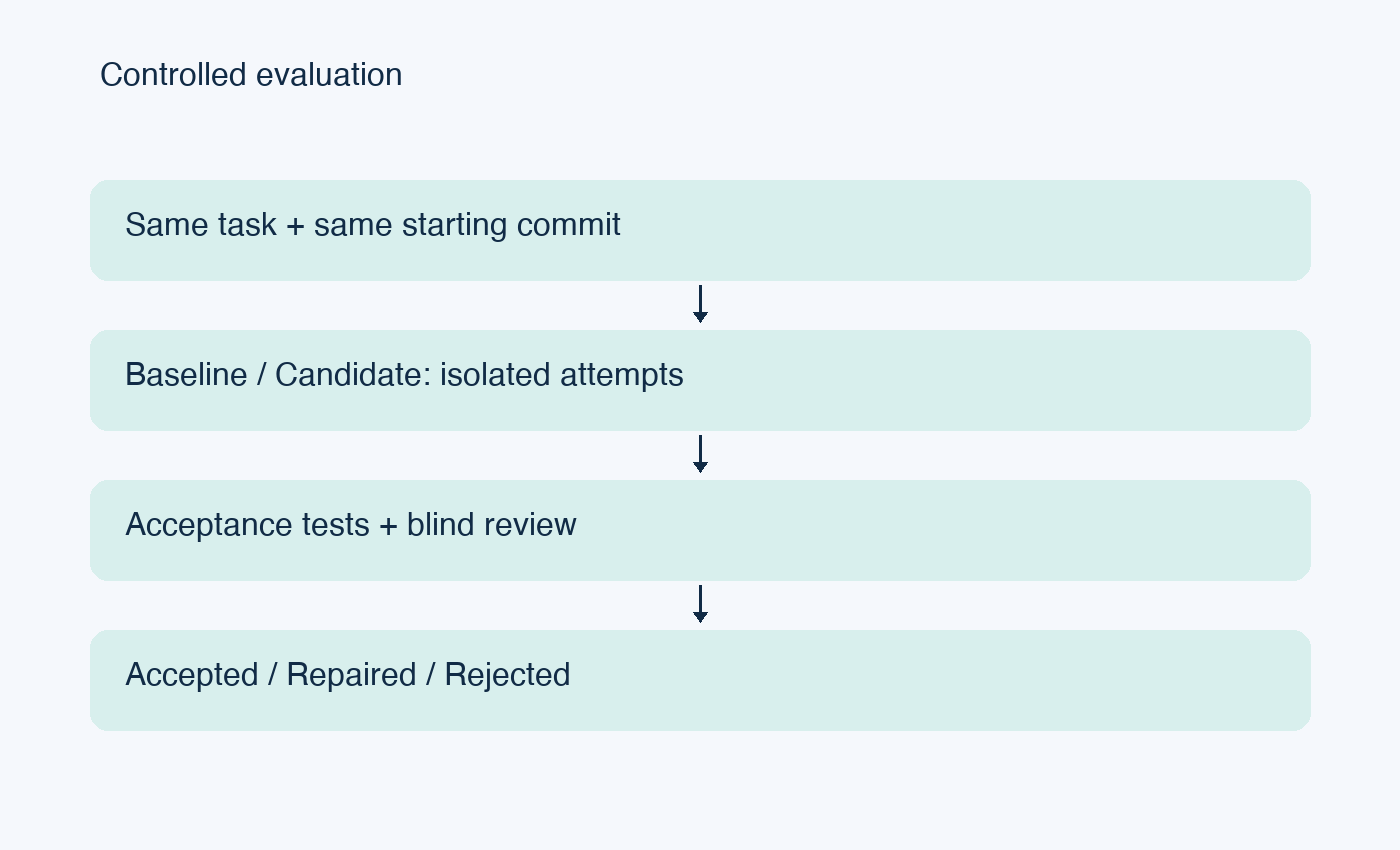
Registre el commit del repositorio, el sistema operativo, los archivos de bloqueo de dependencias (lockfiles), las versiones de las herramientas, el identificador del modelo y la configuración. Fije también el harness del agente: el harness es el software que proporciona las herramientas, el contexto y el comportamiento de ejecución en torno al modelo.
Compare Fable 5.2 con su flujo de trabajo actual. Una comparación entre modelos requiere el mismo harness siempre que sea compatible. Una comparación entre flujos de trabajo puede emplear herramientas distintas, pero sus conclusiones deben detallar dichas configuraciones completas.
Mantenga equivalentes los permisos, el acceso a la red, el contexto inicial y los límites de tiempo. Defina si la instalación de dependencias computa dentro del tiempo transcurrido. Evite que una configuración herede archivos modificados, cachés con respuestas o el historial de conversación de otra ejecución.
Utilice un checkout limpio o un worktree aislado para cada intento. La documentación sobre worktree de Git explica cómo varios árboles de trabajo comparten un mismo repositorio. El aislamiento de archivos no aísla bases de datos, puertos ni servicios externos; asigne también a estos recursos de prueba independientes.
Establezca una regla de intervención explícita. Por ejemplo, permita una única respuesta de aclaración que contenga exclusivamente información disponible para todas las configuraciones. Registre todo el tiempo dedicado a las intervenciones. Si un revisor corrige discretamente una implementación, alterará lo que realmente mide la prueba.
Ejecutar intentos emparejados y conservar los fallos
Ejecute cada configuración frente a las mismas tareas. Alterne el orden de ejecución para que una ralentización temporal del servicio no favorezca de manera sistemática a un candidato. Repita los intentos siempre que los recursos lo permitan, utilizando un número fijo de repeticiones definido antes de analizar los resultados.
Un piloto práctico podría contemplar tres intentos por configuración para cada tarea. Tómelo como un punto de partida a nivel de ingeniería. Una muestra reducida no permite fundamentar conclusiones precisas sobre fallos poco frecuentes ni sobre una superioridad absoluta.
Guarde el prompt, la configuración, las marcas de tiempo, la transcripción, el parche, la salida de las herramientas y el dictamen final de cada intento. Registre los tiempos de espera agotados (timeouts) y las ejecuciones abandonadas como resultados. Si los excluye, las ejecuciones satisfactorias parecerán más económicas y rápidas de lo que realmente sería el flujo de trabajo en producción.
Mantenga los fixtures de prueba y las credenciales al margen de producción. Respete el proceso de pruebas existente en su repositorio. En el caso de repositorios en Python, la documentación de pytest detalla el funcionamiento de los fixtures y la ejecución de pruebas; el framework no determina si sus criterios de aceptación cubren adecuadamente el requisito.
Priorizar la corrección sobre la velocidad
Procure que un revisor examine el parche sin conocer el modelo que lo generó, siempre que sea viable. Aplique una rúbrica predefinida que evalúe el cumplimiento de los requisitos, el riesgo de regresiones, la mantenibilidad, la calidad de las pruebas y el alcance innecesario.
Superar las pruebas resulta indispensable cuando la tarea así lo exige, pero las pruebas pueden reflejar un comportamiento erróneo. Valide las aserciones frente al requisito original. Preste atención a comprobaciones deshabilitadas, tolerancias ampliadas, errores silenciados y cambios que esquiven la ruta defectuosa.
Distinga tres dictámenes: aceptado sin cambios, aceptado tras corrección y rechazado. Registre los minutos dedicados a la reparación y la naturaleza de cada arreglo. Determine con antelación si los cambios corregidos sumarán a su tasa de aceptación principal.
En el caso de las tareas de investigación, evalúe la solidez de la cadena de evidencias. Un informe útil identifica observaciones, distingue hipótesis y proporciona un paso reproducible para continuar. No recompense diagnósticos tajantes que carezcan de pruebas.
Calcular el coste por cambio aceptado
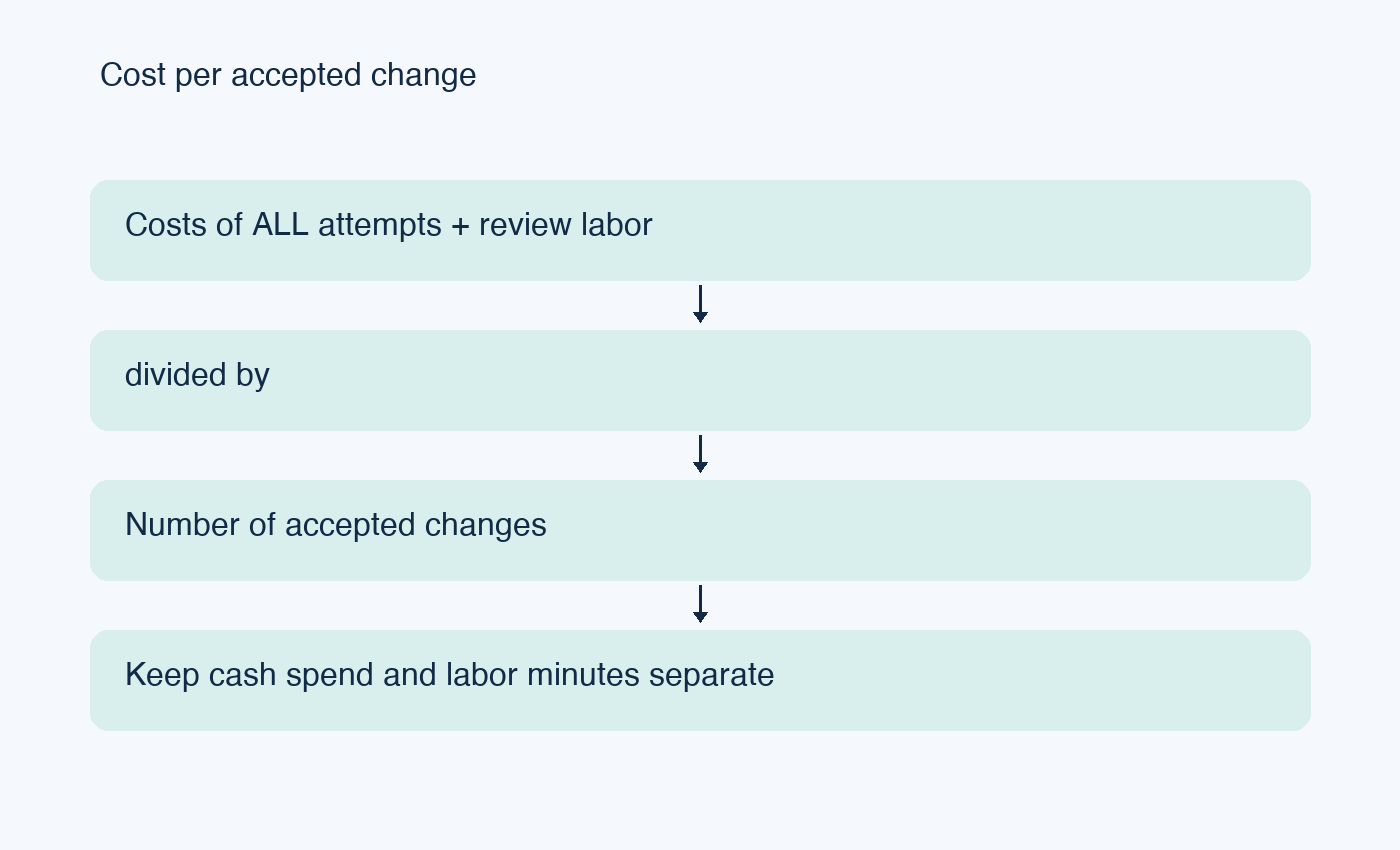
El coste por cambio aceptado resulta de dividir el coste total de la evaluación entre el número de cambios aceptados según su criterio predefinido. Incluya los intentos fallidos en el numerador. Si no se acepta ningún cambio, indique el coste y cero aceptaciones; la proporción carece de un valor finito.
Haga un seguimiento conjunto de estas métricas:
- Tasa de aceptación por categoría de tarea.
- Tiempo transcurrido desde el inicio de la tarea hasta la entrega lista para revisión.
- Minutos dedicados a la revisión y corrección humana.
- Gastos de modelo y herramientas para todos los intentos.
- Costes de infraestructura, si resultan significativos.
- Regresiones detectadas durante el periodo de observación.
Registre el consumo de tokens y la fuente de tarifas con fecha junto con los importes facturados. El uso de tokens en caché, los reintentos y las herramientas de ejecución pueden modificar los costes. No calcule la factura basándose únicamente en la longitud de las respuestas.
Si asigna una tarifa monetaria al tiempo del revisor, indíquela como una estimación interna. Desglose por separado el gasto económico y los minutos de trabajo para que el lector pueda recalcular la comparación. Una generación más barata puede seguir requiriendo mayor atención por parte del equipo de ingeniería.
Vincular las evidencias de evaluación al trabajo realizado
Sharkly gestiona el flujo de trabajo en torno a los agentes de programación. Su flujo documentado conecta Tasks, Agents, Computers, contexto de ejecución y revisión humana. Consulte la documentación de Sharkly para conocer la terminología actual del producto y su configuración.
Para este experimento, incluya los criterios de aceptación en cada Task y registre el parche, las evidencias de las pruebas y el resultado en el mismo registro de trabajo. Mantenga el control de la evaluación en una hoja de cálculo o en un archivo de datos versionado si le resulta más sencillo de analizar. No asuma que la plataforma calculará automáticamente sus métricas experimentales.
Utilice un único Agent para una prueba acotada. Incorpore un Crew únicamente cuando la propia coordinación forme parte de la evaluación. Modificar la estructura del equipo a mitad del proceso introduce una variable adicional.
Los agentes ejecutan y aportan evidencias. Las personas definen la aceptación, inspeccionan los cambios y autorizan el lanzamiento. Esa separación sigue siendo fundamental incluso cuando el código supera todas las comprobaciones automáticas.
Decidir la adopción por categoría
Defina la regla de adopción antes de consultar los resultados. Exija primero una corrección técnica aceptable y, a continuación, compare el coste y el tiempo transcurrido entre las configuraciones que alcancen dicho nivel. Deje fuera del despliegue inicial las categorías sensibles para la seguridad o con escasa cobertura.
Indique las cifras absolutas junto a los porcentajes. Un resultado de dos tareas aceptadas sobre tres transmite una realidad muy distinta a doscientas sobre trescientas. Detalle la incertidumbre y los patrones de fallo en lugar de proclamar un vencedor indiscutible.
Repita la evaluación tras cualquier modificación relevante en los prompts, harnesses, versiones del modelo o estructura del repositorio. Conserve la configuración anterior para que cualquier mejora futura disponga de una línea base reproducible.
Comience con una tarea de mantenimiento representativa en Sharkly, asocie criterios de aceptación explícitos y compare las evidencias obtenidas con su flujo de trabajo habitual. Amplíe el alcance una vez que sea capaz de explicar tanto los éxitos como los fallos.
Preguntas frecuentes
¿Puede un benchmark público de programación sustituir a esta evaluación?
Puede ayudarle a seleccionar candidatos, pero no contempla las convenciones, dependencias, expectativas de revisión ni restricciones operativas de su repositorio.
¿Deberían utilizarse prompts idénticos en cada intento?
Utilice información de tarea equivalente y una política de prompting predefinida. Registre los wrappers específicos de cada herramienta para que las diferencias se puedan auditar.
¿Cuentan los parches corregidos como éxitos?
Defina el criterio con antelación. Desglose por separado las aceptaciones con correcciones y las directas sin cambios, e incluya el tiempo de reparación en la comparación del flujo de trabajo.
¿Cómo deben puntuarse los tiempos de espera agotados (timeouts)?
Considérelos como fallos dentro del margen de tiempo establecido. Incluya su gasto económico y el tiempo transcurrido en los resultados.
¿Cuándo debería el equipo ampliar el despliegue?
Amplíelo cuando una categoría de tareas cumpla con su criterio de aceptación a lo largo de varias pruebas repetidas y los revisores comprendan sus patrones de fallo habituales.
Recursos adicionales
Consulte la documentación de Git sobre aislamiento de repositorios, la guía de fixtures de pytest para configurar pruebas controladas, y Sharkly para organizar el trabajo de los agentes y la revisión humana.