
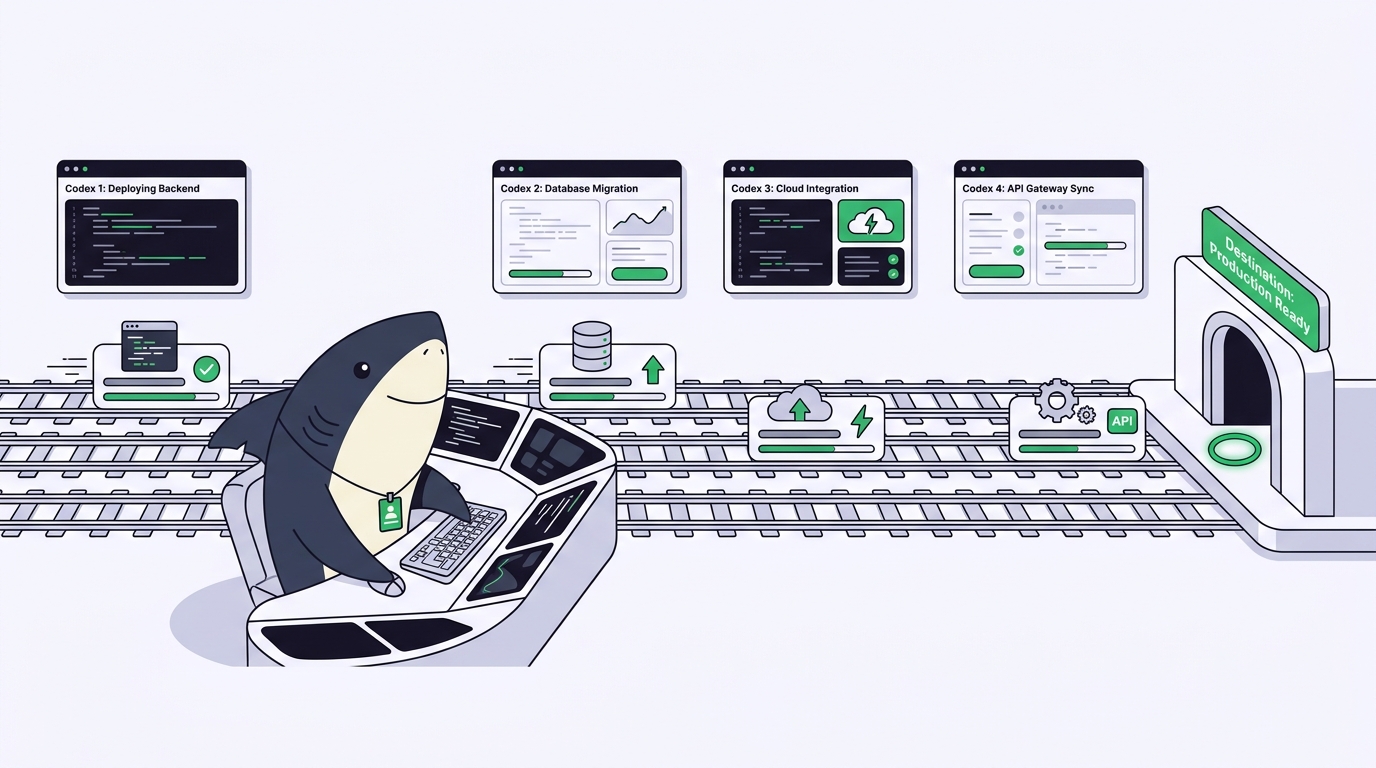
Tienes una tarea de Codex en marcha, una corrección de errores que quieres delegar, una suite de pruebas que necesita cobertura y una refactorización que no dejas de posponer. Las cuatro son independientes. No hay ninguna razón para que no puedan ejecutarse al mismo tiempo, salvo una de índole práctica: apunta dos sesiones de Codex al mismo checkout y empezarán a sobrescribir las ediciones de la otra. El paralelismo que querías se convierte en un merge que no pediste.
Ejecutar varias tareas de Codex a la vez es menos una función que se activa y más una configuración que se prepara. Hay tres vías: las tareas en la nube de Codex, varias sesiones locales de la CLI y los subagentes dentro de una misma sesión. Cada una aporta concurrencia real y cada una tiene un modo de fallo que aparece en el momento en que las escrituras se solapan. Esta guía repasa las tres, con los comandos y el fallo señalados en cada paso, y después muestra dónde entra en juego un tablero de tareas.
Ese tablero de tareas es Sharkly. Ya tienes Codex. Sharkly se sitúa por encima: ejecuta Codex como Runtime y convierte cada ejecución en paralelo en una Task con su propio checkout aislado, su propio log y su propio revisor. El artículo cubre primero la configuración manual, porque conviene entender lo que vas a automatizar antes de automatizarlo.
TL;DR
Los agentes paralelos de Codex consisten en ejecutar varias tareas de Codex a la vez en lugar de una tras otra. Hay tres formas de hacerlo: las tareas en la nube de Codex (cada una en un entorno aislado, según la documentación de OpenAI), varias sesiones locales de la CLI de codex o subagentes dentro de una misma sesión. La regla que gobierna todas ellas es una copia de trabajo por unidad de trabajo: dale a cada tarea su propio git worktree para que las ediciones concurrentes nunca toquen los mismos archivos. Eso escala sin problemas hasta un puñado de tareas. A partir de ahí, llevar la cuenta de qué agente hizo qué y revisar cada resultado por separado se convierte en el cuello de botella, que es la capa que añade Sharkly.
Las tres formas de ejecutar Codex en paralelo
Elige la vía según dónde se ejecute el trabajo y cuánto necesites ver, no según cuál suene más potente.
| Vía | Cómo se ejecuta | Aislamiento | Ideal para |
|---|---|---|---|
| Tareas en la nube de Codex | Cada tarea en su propio entorno en la nube | Fuerte, por tarea | Tareas delegadas y autónomas que revisas después |
| Varias sesiones de la CLI | Varios procesos de codex en tu máquina |
Ninguno por defecto; checkout compartido | Trabajo local que quieres seguir en directo |
| Subagentes en una sesión | Una sesión despacha hilos generados | Directorio de sesión compartido | Trabajo con mucha lectura: exploración, triaje, pruebas |
Usa las tareas en la nube de Codex cuando el trabajo esté bien acotado y no te importe revisarlo a posteriori. Usa sesiones locales de la CLI cuando quieras dirigir cada ejecución sobre la marcha. Usa subagentes cuando la tarea consista sobre todo en leer, ya que los agentes generados comparten un único directorio de trabajo y, según el comportamiento de los subagentes de Codex, la sesión espera a todos ellos y devuelve una única respuesta consolidada. Esa última forma no sirve para escritura en paralelo: los agentes que editan código a la vez crean conflictos, y un único resumen no se puede revisar pieza por pieza.
Paso a paso: ejecutar varias tareas de Codex en local sin colisiones
La vía local es la que la mayoría de la gente elige primero y la que se rompe primero. Esta es la configuración que sobrevive.
Paso 1. Dale a cada tarea su propio checkout. Un git worktree es un segundo directorio de trabajo respaldado por el mismo repositorio, en su propia rama. Crea uno por tarea:
git worktree add ../app-authfix -b fix/token-refresh
git worktree add ../app-tests   -b test/checkout-coverage
git worktree add ../app-refactor -b refactor/api-client
Fallo si te lo saltas: dos sesiones de codex en la misma carpeta editan los mismos archivos, la escritura posterior gana en silencio y ambas informan de éxito. Descubres la pérdida en la revisión, o en producción.
Paso 2. Inicia una sesión de Codex por worktree. Abre una terminal en cada directorio y ejecuta Codex allí:
cd ../app-authfix && codex
Fallo si te lo saltas: una sesión con cuatro objetivos en su contexto se desvía entre ellos y pierde la noción de qué cambio pertenece a qué tarea.
Paso 3. Automatiza con scripts las que no necesiten a una persona delante del teclado. Para una tarea autónoma, el modo no interactivo se ejecuta hasta completarse sin pedir confirmación:
cd ../app-tests && codex exec "add tests for the checkout flow until coverage passes"
Fallo si te lo saltas: te quedas vigilando sesiones que nunca te necesitaron, lo que anula el sentido de ejecutarlas en paralelo.
Paso 4. Haz merge de forma deliberada, una rama a la vez. Cada worktree es una rama, así que revísalas y fusíonalas por separado. Nunca dejes que los agentes fusionen el trabajo de los demás. Fallo si te lo saltas: tres ramas aterrizan a la vez, surge un conflicto en el commit de merge y ya no puedes saber qué cambio de qué agente lo provocó.
Para conocer la mecánica de podar los worktrees limpiamente después, consulta gestionar worktrees para agentes de programación sin el dolor de la limpieza. El mismo patrón de worktrees da vida a ejecutar varios agentes de Claude Code; es neutral respecto al runtime por diseño.
Dónde deja de escalar la configuración casera
Los worktrees resuelven las colisiones. No lo resuelven todo, y el muro está más cerca de lo que parece.
Con tres o cuatro tareas, la configuración aguanta. Con ocho, la rejilla de terminales deja de ser un espacio de trabajo y se convierte en un ejercicio de memoria. Los fallos no son dramáticos; se acumulan:
- Pierdes el mapa. ¿Qué ventana es la corrección de autenticación? ¿Cuál ha terminado? ¿Cuál falló hace veinte minutos y lleva desde entonces inactiva? El estado solo existe en tu cabeza y desaparece de la pantalla en cuanto haces scroll.
- La revisión no tiene costuras. La salida de cada sesión es un muro de historial. No hay un registro por tarea de qué tocó, qué ejecutó y dónde se detuvo, así que no puedes aceptar un resultado y rechazar otro con limpieza.
- Nada se comparte. En el momento en que un compañero necesita ver el progreso, estás copiando diffs en un hilo de Slack. El trabajo es real, pero invisible.
Son los mismos tres problemas en los que converge todo flujo de trabajo con agentes en paralelo, y son la razón por la que los equipos recurren a herramientas específicas para gestionar agentes de programación en paralelo cuando el número aumenta. El aislamiento es un problema resuelto. La visibilidad y la revisión no lo están, al menos no con una rejilla de terminales.
Qué aporta un tablero de tareas
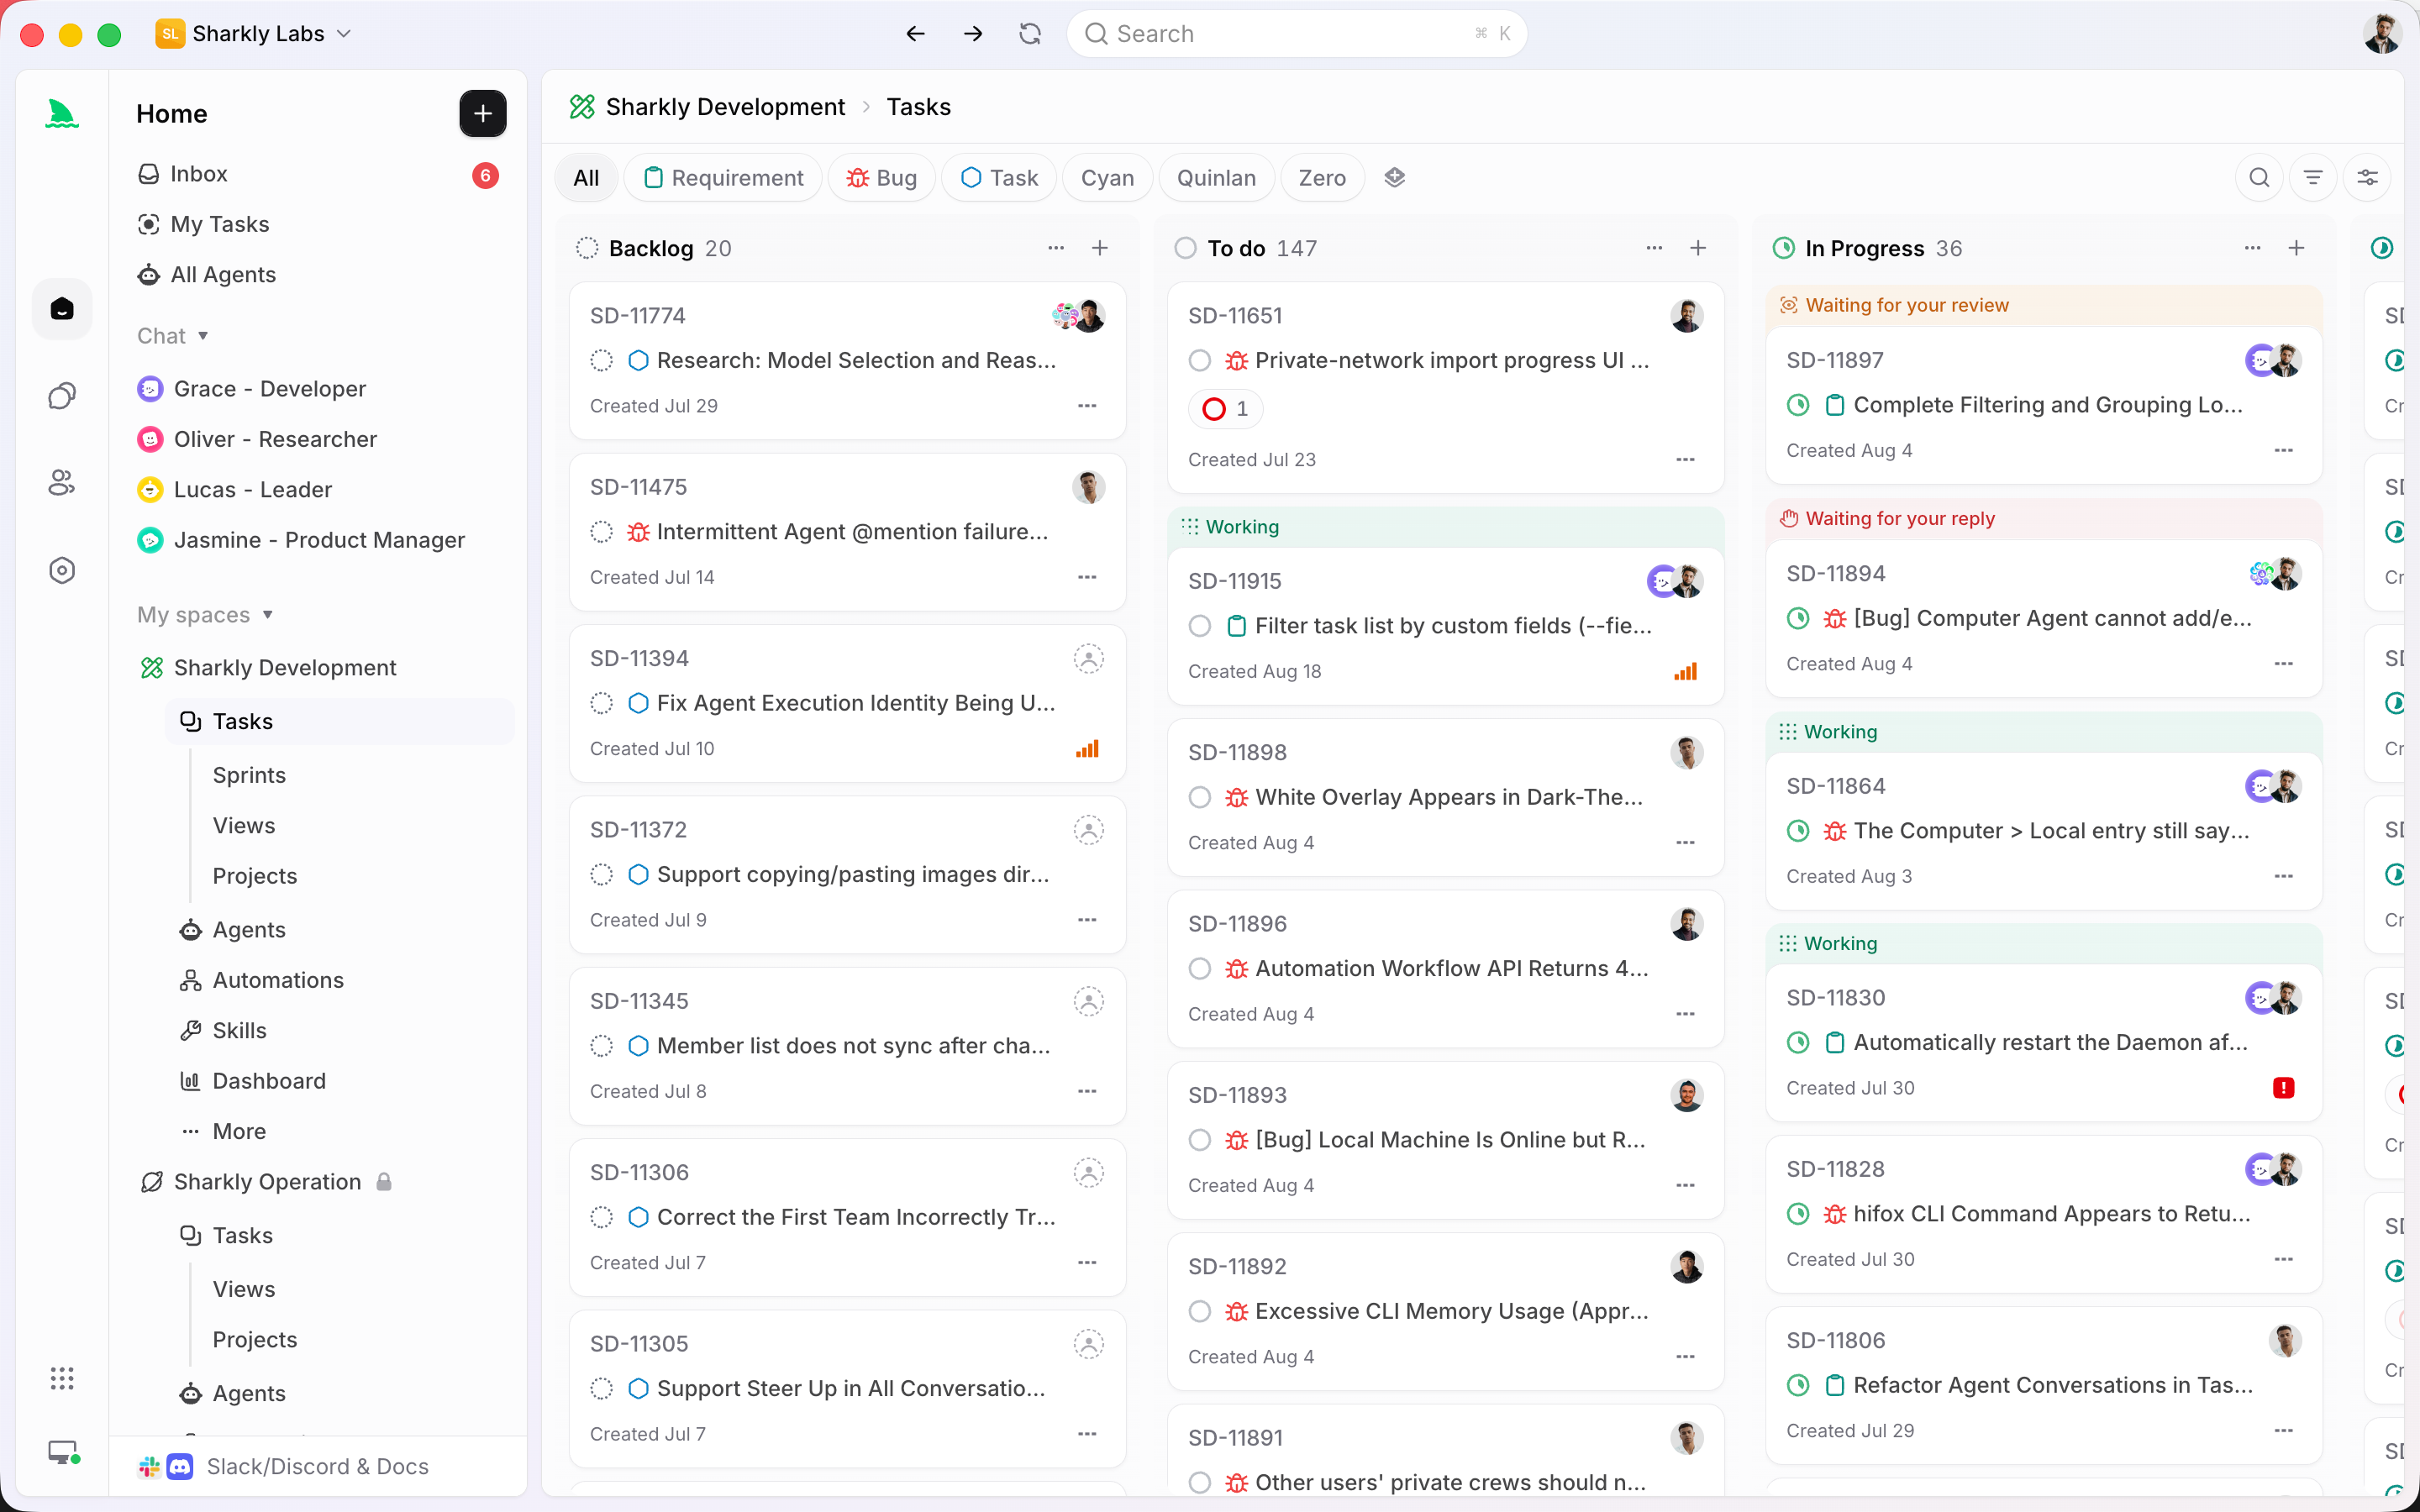
Aquí es donde la capa que se sitúa por encima del agente se gana su lugar. Una Task es el registro compartido de una unidad de trabajo en Sharkly, y ejecutar tareas de Codex en paralelo se convierte en ejecutar Tasks en paralelo.
Cada Task reclama automáticamente un git worktree aislado, de modo que los agentes en paralelo en worktrees aislados dejan de ser algo que programas con scripts y pasan a ser lo predeterminado. Diez Tasks contra un mismo repositorio, cero estado compartido, ningún git worktree add escrito a mano. El Runtime que hace las ediciones sigue siendo Codex; el aislamiento se proporciona a su alrededor.
La división del trabajo es lo esencial. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, otorgan autoridad y aceptan el resultado. La automatización se detiene allí donde se requiere el criterio del equipo. Así, cada ejecución conserva su propio log con el desencadenante, las llamadas a herramientas y el punto donde se detuvo, y su resultado final vuelve a la Task en lugar de pasar de largo en una terminal. El contexto, el progreso, los bloqueos, los resultados y la revisión humana permanecen visibles desde la solicitud hasta la entrega, y revisas cada uno por su cuenta en vez de leer un resumen de resúmenes. Para la parte de informes, consulta cómo hacer seguimiento del trabajo completado por agentes de programación con IA.
Sharkly no sustituye a Codex. Añade la capa compartida de tareas, checkout, contexto y revisión alrededor del agente que ya utilizas. Si nunca ejecutas más de una sesión de Codex a la vez, no lo necesitas. Si ejecutas varias contra una misma base de código y estás perdiendo el hilo, ese es el problema para el que está pensado. Puedes montar a mano la configuración de worktrees descrita arriba, o pasar tus tareas de Codex actuales por Sharkly y dejar que el flujo de trabajo mantenga el estado por ti.
Una lista de comprobación que puedes aplicar hoy
- Un git worktree por tarea, cada uno en su propia rama. Ninguna tarea comparte checkout con otra.
- Una sesión de Codex por worktree, o
codex execpara las tareas que no te necesitan. - Usa subagentes solo para trabajo con mucha lectura; mantén las escrituras concurrentes en checkouts separados.
- Fusiona una rama a la vez y revisa cada una antes de que aterrice.
- Lleva un registro de qué tarea es cuál, qué tocó cada una y su resultado, en un lugar donde un compañero pueda verlo.
- Cuando la rejilla de terminales ya no te quepa en la cabeza, traslada el seguimiento y la revisión a un tablero de Tasks para que cada ejecución devuelva su resultado a un único lugar compartido.
Preguntas frecuentes
¿Puede Codex ejecutar varias tareas al mismo tiempo? Sí. Codex en la nube ejecuta las tareas en entornos aislados, según la documentación de OpenAI, y en local puedes ejecutar varias sesiones de codex a la vez. La limitación está en el checkout, no en Codex: dale a cada tarea local su propio git worktree para que sus ediciones no colisionen.
¿Cuántos agentes de Codex puedo ejecutar en paralelo? Todos los que permitan tu máquina y tu cuota de modelo. El techo práctico es más bajo: es el número de resultados simultáneos que una persona puede revisar de verdad. A partir de un puñado, el límite lo marcan el seguimiento y la revisión, no la capacidad de cómputo.
¿Necesito worktrees o basta con abrir más terminales? Más terminales en el mismo directorio suponen escrituras concurrentes en los mismos archivos y sobrescrituras silenciosas. Los worktrees dan a cada sesión su propio directorio y su propia rama, que es lo que hace seguro el paralelismo local. Consulta git worktrees para agentes de programación con IA.
¿Cuál es la diferencia entre los subagentes de Codex y las tareas en paralelo? Los subagentes se ejecutan dentro de una misma sesión, comparten su directorio de trabajo y devuelven una única respuesta consolidada, lo que encaja con la lectura y el triaje. Las tareas en paralelo son ejecuciones independientes con checkouts separados, que es lo que quieres para escrituras concurrentes y revisiones independientes.


