
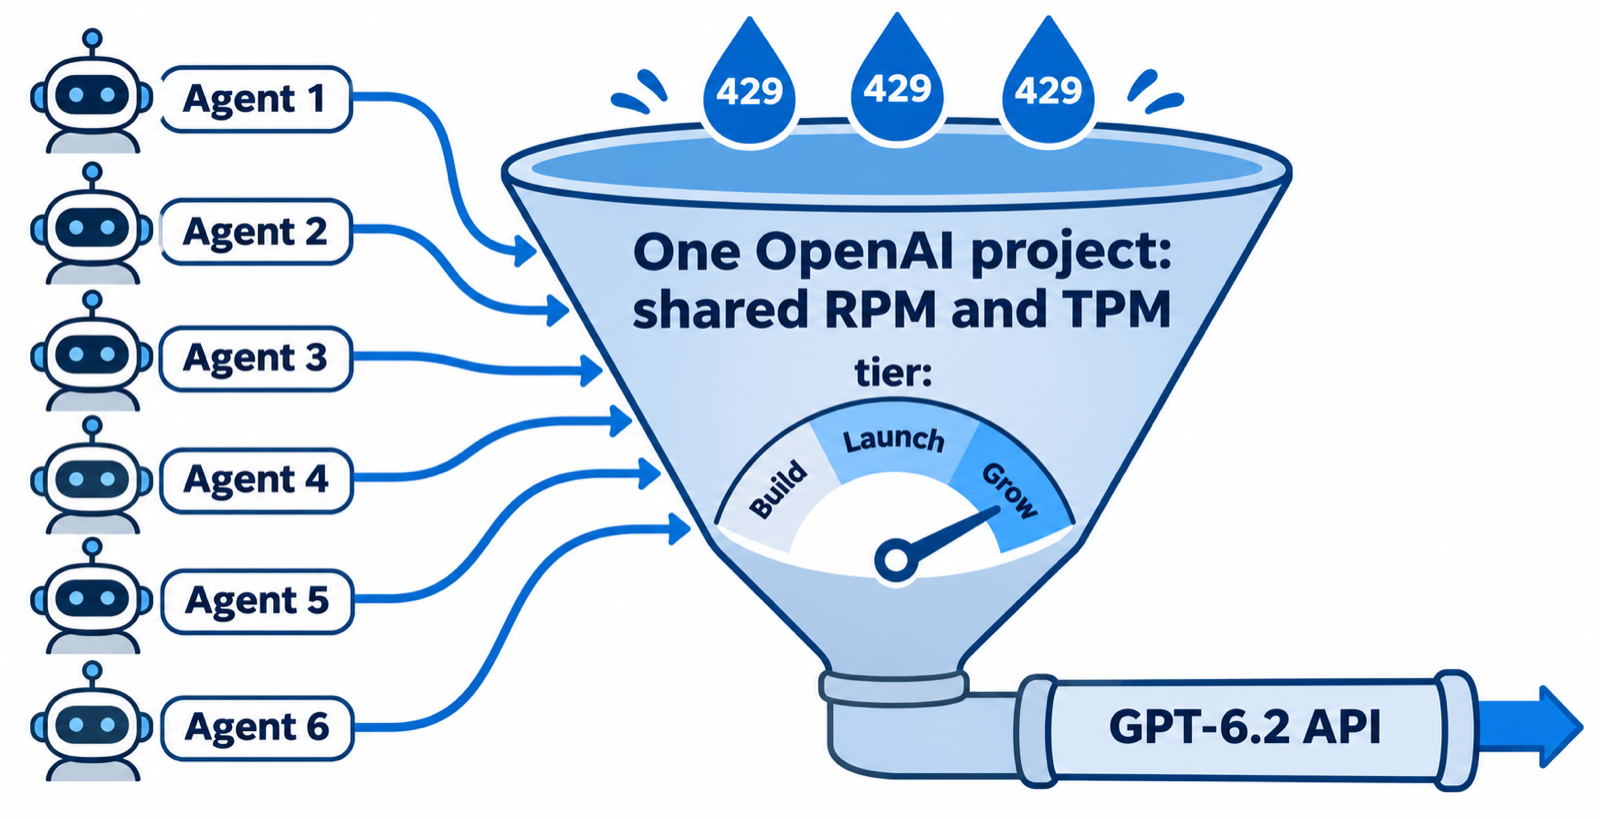
En resumen: los límites de velocidad de GPT-6.2 son los mismos para Astra y Sol en la API: 5000 RPM y 1.000.000 de TPM en el nivel Build, 10.000 RPM y 4.000.000 de TPM en Launch, y 15.000 RPM y 40.000.000 de TPM en Grow. Los límites se aplican por organización y por proyecto, así que todos los agentes de una misma clave comparten los mismos. Para equipos de agentes, el límite que se agota primero es el de tokens por minuto, no el de solicitudes.
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Astra es el modelo frontera para los trabajos más difíciles; Sol es el modelo cotidiano más barato, creado para “impulsar agentes a escala”, en palabras de la propia OpenAI.
Un solo agente rara vez alcanza un límite. Seis agentes sobre una misma clave de API lo alcanzan antes del almuerzo. Esta guía cubre los límites de velocidad de GPT-6.2, los topes de los planes de Codex y cómo dimensionar un equipo de agentes para que haga cola en lugar de fallar. Si ya ejecutas varios agentes de programación, Sharkly es donde defines cuántos de ellos se ejecutan a la vez.
Límites de velocidad de GPT-6.2 por nivel de uso
GPT-6.2 Astra y GPT-6.2 Sol comparten una única tabla estándar de límites de velocidad en la página del modelo Sol y la página del modelo Astra de OpenAI. RPM significa solicitudes por minuto; TPM significa tokens por minuto. El que agotes primero te detiene.
| Nivel | Se alcanza con (compras totales de crédito) | Límite de uso mensual | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5,000 | 1,000,000 |
| Launch | $100 | $5,000 | 10,000 | 4,000,000 |
| Grow | $500 | $200,000 | 15,000 | 40,000,000 |
Las columnas de calificación y de uso mensual provienen de la guía de límites de velocidad de OpenAI. Tu nivel sube automáticamente cuando las compras totales de crédito cruzan cada umbral. El límite de uso mensual es un tope independiente de los límites de gasto que tú mismo configures.
Astra cuesta cuatro veces más por token ($8 de entrada, $40 de salida por millón, frente a $2 y $10 de Sol), pero su límite de velocidad es el mismo. Lo que alcances depende de cuántos tokens empujen tus agentes.
Cómo funcionan los topes de uso de GPT-6.2 en Codex
Si tus agentes se ejecutan a través de Codex con un plan de ChatGPT en lugar de una clave de API, se aplica un tope diferente. La página de precios de Codex de OpenAI presenta los mensajes locales por ventana de cinco horas como rangos, porque el tamaño de cada tarea cambia el costo de cada mensaje.
| Modelo | Plus | Business estándar |
|---|---|---|
| GPT-6.2 Astra | 6 a 50 | 6 a 50 |
| GPT-6.2 Sol | 17 a 180 | 17 a 180 |
| GPT-6.1 Sol | 15 a 160 | 15 a 160 |
| GPT-6 Astra | 5 a 45 | 5 a 45 |
Cuatro detalles importan para los equipos de agentes:
- Los planes Pro no tienen límite de cinco horas por ahora, aunque pueden aplicar límites semanales.
- Los mensajes locales y los chats en la nube comparten una misma asignación. Una tarea en la nube puede consumir más de esa asignación que un mensaje local.
- La velocidad cuesta asignación. El modo rápido consume 2 veces el uso incluido en los modelos GPT-6.2; el modo Ultrafast consume 6 veces.
- Las sesiones largas cuestan más por mensaje. OpenAI indica que las tareas que mantienen más contexto usan “significativamente más” de la asignación.
Un agente que ya leyó la mitad de un repositorio envía un contexto enorme en cada turno, así que su conteo de mensajes cae rápido. Cubrimos el mismo patrón para los planes de Anthropic en límites de uso de Claude Code, y la respuesta al recorte del límite de Codex Pro sigue la misma lógica.
Por qué el TPM, y no el RPM, es lo que limita a un equipo de agentes
Un agente de programación no envía miles de solicitudes pequeñas. Envía pocas solicitudes grandes. En cada turno reenvía toda la conversación hasta el momento: instrucciones, archivos que ha leído, salida de herramientas y su propio razonamiento anterior.
Toma como ejemplo ilustrativo un agente con 80.000 tokens de entrada por turno y 6 turnos por minuto. Eso son 6 RPM y unos 480.000 TPM. Frente al nivel Build:
- RPM: 6 de 5,000 usados. Ni cerca.
- TPM: 480,000 de 1,000,000 usados. Dos agentes lo llenan.
Tus números serán distintos; la proporción no. Los agentes son intensivos en tokens y ligeros en solicitudes. Para este agente de ejemplo, el techo bruto es de dos agentes por proyecto en Build y ocho en Launch. Si aplicas el margen del 30 por ciento de los pasos de dimensionamiento que vienen abajo, queda en un agente en Build y cinco en Launch. En Grow, el límite de velocidad deja de ser tu cuello de botella y el tope mensual de $200,000 o tu propio presupuesto toman el relevo.
Los límites se comparten en toda la organización
OpenAI define los límites de velocidad a nivel de organización y de proyecto, no por usuario. Cada agente que usa claves de un mismo proyecto toma del mismo grupo. Además, algunas familias de modelos tienen un límite compartido que aparece en tu página de límites, de modo que el tráfico hacia un modelo puede descontar de otro.
Cómo ajustar la concurrencia de agentes a tu nivel de GPT-6.2
La solución es limitar cuántos agentes se ejecutan a la vez, para que el trabajo extra espere en una cola en lugar de chocar contra la API. Este es el orden que funciona:
- Encuentra tu nivel en Settings, Organization, Limits de la plataforma de OpenAI.
- Mide una ejecución real de un agente. Anota los tokens de entrada por turno y los turnos por minuto a partir de la salida de uso de tu Runtime.
- Divide tu TPM entre el TPM de un agente y conserva un margen del 30 por ciento para picos.
- Configura ese número como tu tope de concurrencia para cada agente que use el proyecto.
- Observa los errores 429 durante una semana y luego sube el tope de a un paso a la vez.
En Sharkly, cada agente tiene una configuración de Concurrencia máxima (tareas asignadas), una Duración máxima de ejecución en minutos y un Timeout de cola en horas. Cuando el tope está lleno, las nuevas tareas esperan en estado En cola hasta que se libere un espacio. Los chats pueden compartir el mismo límite, así que una conversación no se cuela.

Un Computer también tiene su propio límite de concurrencia de tareas. La documentación de Sharkly señala que una mayor concurrencia consume más CPU, memoria, disco, capacidad del proveedor y ancho de banda del repositorio, así que súbelo solo cuando la carga actual se ejecute sin problemas.
Reparte los agentes entre proyectos de OpenAI
Los límites a nivel de proyecto te permiten separar grupos de agentes. Asigna a tus agentes de revisión un proyecto de OpenAI y a tus agentes de refactorización masiva otro. Así, una refactorización descontrolada alcanza el límite de su propio proyecto en lugar de dejar sin recursos a la revisión. El límite de la organización sigue capando el total, así que esto establece prioridad; no añade capacidad.
Para un Runtime que se autentica con una clave de API, define la clave como variable de entorno en el agente. Sharkly inyecta las variables de entorno del agente en el proceso del agente cuando arranca. Dale a cada grupo de agentes una clave de su propio proyecto de OpenAI, para que su tráfico caiga en el límite correcto.
Vigila los tokens por tarea
El encabezado del agente en Sharkly muestra las tareas asignadas, las ejecuciones totales y los tokens usados. Lee los tokens por tarea, no solo el total mensual. Un tipo de tarea que quema el triple de tokens que las demás es tu primer candidato para Sol en lugar de Astra, o para una descripción de tarea más ajustada.
Mueve el trabajo masivo a horas valle
Las configuraciones del Runtime de cada agente incluyen un interruptor de Horario laboral para programar trabajo en horas valle. Apúntalo a la generación de pruebas, la actualización de dependencias y las pasadas de documentación. Esas tareas se ejecutan de noche y dejan capacidad diurna para el trabajo que la gente está esperando.
Cómo manejar un error 429 de GPT-6.2
Incluso con un tope, verás algún 429 ocasional. La guía de OpenAI es específica sobre qué hacer:
- Sigue el encabezado
Retry-Aftercuando esté presente, y trátalo como un mínimo. - Sin él, usa backoff exponencial con jitter aleatorio.
- Lee
x-ratelimit-remaining-tokensyx-ratelimit-reset-tokenspara ver qué tan cerca estás. - No anides reintentos: si tu código reintenta, desactiva los reintentos propios del SDK, o los dos se multiplicarán.
- No reintentes errores de cuota o de facturación. Necesitan una persona.
Un 503 con server_is_overloaded significa que el modelo está ocupado, no tú. Manejalo con el mismo backoff.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra o Sol: qué modelo estira más tus límites
Los límites de velocidad son idénticos, así que la elección depende del uso de tokens y del precio. Usa Astra para cambios de arquitectura, errores difíciles y ejecuciones autónomas largas. Usa Sol para todo lo rutinario. En Codex con Plus, Sol obtiene aproximadamente el triple de mensajes por ventana de cinco horas que Astra, lo cual es la señal más clara de la brecha de costos.
Un equipo mixto es la respuesta habitual: un agente Astra lidera y varios agentes Sol hacen las piezas, como en GPT-6 Astra como líder de tu Crew. El trabajo rutinario corresponde a un modelo más barato; esa es la lógica detrás de GPT-6 Luna para el aburrido 80 por ciento.
Otras formas de obtener más rendimiento de GPT-6.2
- Batch API. Se ejecuta fuera de tus límites de velocidad síncronos y cuesta el 50 por ciento de las tarifas estándar. Buena para evals y clasificación masiva; mala para un agente interactivo.
- Modo background con una ventana de
2hu8h. Cuenta contra un límite de cola Batch/Background separado en lugar de tu TPM en vivo. - Almacenamiento en caché de prompts. La entrada cacheada cuesta $0.40 por millón en Astra y $0.10 en Sol, un gran ahorro para agentes que reenvían el mismo contexto.
Conclusión
Los límites de velocidad de GPT-6.2 son generosos por solicitud y ajustados por token. Para un equipo de agentes, el límite práctico es el TPM de tu nivel dividido entre lo que quema un agente, compartido por todos los agentes del proyecto. Mide una ejecución, fija la concurrencia por debajo de ese número, separa los grupos de agentes ruidosos en sus propios proyectos y deja que la cola absorba el resto.
Puedes construir esto con scripts y un semáforo, o configurarlo por agente en Sharkly. Conecta un Computer, crea un agente en Codex con GPT-6.2 Sol, pon su concurrencia máxima en 2 y asígnale algo aburrido. Más sobre ejecutar agentes en paralelo en Cómo ejecutar 10 agentes de programación con IA a la vez.
Preguntas frecuentes
¿Cuáles son los límites de velocidad de GPT-6.2?
En la API, GPT-6.2 Astra y Sol comparten los mismos límites: 5000 RPM y 1.000.000 de TPM en Build, 10.000 RPM y 4.000.000 de TPM en Launch, y 15.000 RPM y 40.000.000 de TPM en Grow.
¿GPT-6.2 Astra tiene límites de velocidad más bajos que Sol?
No. OpenAI lista los mismos RPM y TPM para ambos modelos en cada nivel. Astra cuesta más por token, así que alcanza tu presupuesto más rápido, no tu límite de velocidad.
¿Cómo paso a un nivel de uso más alto de OpenAI?
Los niveles suben automáticamente según las compras totales de crédito: $5 para Build, $100 para Launch, $500 para Grow.
¿Los límites de velocidad son por clave de API o por organización?
Por organización y por proyecto. Cada clave de un proyecto toma del mismo grupo, así que diez agentes con diez claves en un mismo proyecto siguen compartiendo un solo límite.
¿Cuántos mensajes de GPT-6.2 Astra tengo en Codex?
En Plus y Business estándar, OpenAI estima de 6 a 50 mensajes locales por ventana de cinco horas para GPT-6.2 Astra y de 17 a 180 para Sol. Los planes Pro actualmente no tienen límite de cinco horas, aunque pueden aplicar límites semanales.
¿Por qué mis agentes reciben errores 429 si el RPM parece estar bien?
Los agentes envían contextos grandes, así que agotan los tokens por minuto mucho antes que las solicitudes por minuto. Revisa x-ratelimit-remaining-tokens en los encabezados de la respuesta.
¿Sharkly añade sus propios límites de modelo?
No. Sharkly ejecuta los agentes de programación que ya usas, y la cuota de modelo depende de las herramientas, planes y cuentas de API que conecte tu equipo. Sharkly controla cuántas tareas ejecuta cada agente a la vez.