En resumen: GPT-6 Cyber es la variante orientada a la seguridad de GPT-6 Astra desarrollada por OpenAI, lanzada el 5 de noviembre de 2026. Requiere Daybreak Red y una aprobación independiente para el modelo, y tiene un precio de catálogo de 20 $ por millón de tokens de entrada. La mayoría de los equipos deberían llevar a cabo la revisión y el triaje en modelos convencionales, y reservar GPT-6 Cyber para verificar hallazgos de alto riesgo en sistemas de su propiedad.
GPT-6 Cyber transforma el último paso de la revisión de seguridad, no el primero. El anuncio de OpenAI informa de 81 nuevas vulnerabilidades de alta gravedad en Firefox y exploits funcionales para 948 fallos del kernel de Linux. Suena como el modelo ideal para integrarlo en cada agente que utilices.
Sin embargo, las reglas de acceso dicen lo contrario. Es probable que no puedas utilizarlo hoy mismo, y los aspectos más útiles del lanzamiento se encuentran en la system card: en qué puntos el modelo se mantiene dentro del alcance y en cuáles sus informes omiten información.
Esta guía explica quién puede acceder, cuánto cuesta, cómo distribuir el trabajo de seguridad entre los distintos niveles de modelos y qué deben verificar los revisores. Si ya utilizas varios agentes, Sharkly te ofrece un único lugar para gestionar sus tareas y resultados.
¿Qué es GPT-6 Cyber?
GPT-6 Cyber es una variante de GPT-6 Astra especializada en ciberseguridad, diseñada para labores de seguridad autorizadas: detección de vulnerabilidades, desarrollo de exploits y pruebas de penetración web. OpenAI la sometió a un posentrenamiento para rechazar menos solicitudes autorizadas y mantenerse dentro del alcance delimitado. Según su Preparedness Framework, la compañía clasifica este modelo como Crítico en ciberseguridad.
No se trata de un agente de programación general más potente. En ExpertSWE, la prueba interna de OpenAI para tareas de software extensas, obtuvo un 82,95 % frente al 83,24 % de Astra. Conserva tu entorno de ejecución predeterminado para el desarrollo de funcionalidades.
¿Quién puede acceder a GPT-6 Cyber?
El acceso se basa en la aprobación, no en el presupuesto. La página de ayuda sobre Daybreak de OpenAI indica que disponer de un acuerdo comercial o haber realizado una compra no lo garantiza por sí solo.
| Nivel de acceso | Modelos | Uso previsto |
|---|---|---|
| Estándar | Modelos principales, incluido Astra, con salvaguardas estándar | Modelado de amenazas, revisión de código seguro, desarrollo de parches |
| Daybreak Blue | Menor tasa de rechazos en modelos como GPT-6 Sol y GPT-6 Luna; Astra mantiene las salvaguardas estándar | Triaje de vulnerabilidades, análisis de malware, respuesta a incidentes, validación de parches |
| Daybreak Red | GPT-5.6 Cyber, además de menor tasa de rechazos en modelos que incluyen a Astra | Pruebas de penetración, red teaming, validación de exploits |
| Red con aprobación para GPT-6 Cyber | gpt-6-cyber a través de la API y Codex |
El mismo trabajo, con GPT-6 Cyber |
Hay tres detalles que suelen tomar desprevenidos a los equipos:
- Red no es suficiente. GPT-6 Cyber requiere su propia aprobación. Actualmente está disponible para un grupo selecto de clientes de Red, y OpenAI afirma que el resto de clientes Red tendrán acceso «pronto».
- No existe una vía individual. Solo es posible solicitar Red como empresa u organización corporativa aprobada. Quienes postulen a título individual pueden solicitar Blue.
- Todo empieza desactivado por defecto. Tras la aprobación, el propietario de la cuenta debe habilitar Daybreak para usuarios o proyectos específicos. Las ejecuciones desatendidas en Codex CLI requieren
daybreak=trueen el host que las ejecuta.
Las organizaciones también deben contar con SSO, MFA, dispositivos gestionados y acceso con privilegios mínimos. El uso de la API requiere por defecto una lista de IP permitidas.
¿Cuánto cuesta GPT-6 Cyber?
Estos son los precios estándar de la API para contexto corto de OpenAI por millón de tokens, vigentes al 6 de noviembre de 2026:
| Modelo | Entrada | Salida | Requisito para reducción de rechazos |
|---|---|---|---|
gpt-6-luna |
$0.10 | $0.50 | Daybreak Blue |
gpt-6.1-sol |
$2.00 | $10.00 | Daybreak Red |
gpt-6-astra |
$10.00 | $50.00 | Daybreak Red |
gpt-6-cyber |
$20.00 | $100.00 | Red más aprobación del modelo |
Por token, cuesta el doble que Astra y 200 veces más que Luna. Para ponerlo en perspectiva, la campaña en Linux responsable de los 948 exploits consumió cerca de 1,2 millones de dólares en créditos de la API, una cifra que según OpenAI se aproxima más a un límite superior. No apuntes tu modelo más costoso hacia cada archivo.
Los equipos defensivos con recursos limitados, como organismos gubernamentales y proveedores de servicios esenciales, pueden recurrir al programa de subvenciones de 1000 millones de dólares de OpenAI, que subsidia el acceso.
Dónde justifica GPT-6 Cyber su precio
Compáralo con Astra, no solo con el modelo anterior. Estas son las cifras de OpenAI, salvo que se indique lo contrario:
| Prueba | Qué mide | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| SEC-Bench Pro | Detección de fallos en motores JavaScript | 87.02% | 85.38% |
| Web pentest | Exhaustividad (recall) de vulnerabilidades web | 40.3% | 32.0% |
| ExploitGym | Explotación de un fallo específico | 48.5% | 42.4% |
| RemoteExploitBench | Exploits remotos para fallos conocidos | 95% completed | 100% refused under Blue |
| FrontierCyber (Irregular) | Software y hardware real | 90 of 288 | 96 of 288 |
En cuanto a la detección de fallos, la mejora respecto a Astra es modesta. La evaluación externa realizada por Irregular situó a Astra ligeramente por delante en FrontierCyber, a GPT-6 Cyber a la cabeza en escenarios de horizonte largo, y no registró ningún ataque con éxito en objetivos completamente reforzados. La diferencia más marcada radica en los permisos: GPT-6 Cyber ejecuta labores de explotación que Astra rechaza con el nivel Blue.
La propia OpenAI lo reconoce: los modelos principales «ya admiten la revisión de código, el triaje de vulnerabilidades y el desarrollo de parches». Los logros en el mundo real respaldan esa distinción. Los hallazgos de Mozilla incluyeron pruebas fehacientes y tests reproducibles, y esa misma campaña demostró que 30 problemas conocidos tenían una gravedad mayor de la comunicada inicialmente. Demostrar el nivel de gravedad es precisamente aquello por lo que se paga.
Cómo distribuir el trabajo de seguridad entre agentes
Dirige el flujo en función de la evidencia, de forma que cada nivel reciba únicamente el trabajo que el escalón más económico no pudo resolver. Este esquema de enrutamiento es una recomendación nuestra, no una regla de OpenAI:
- Escaneo con un modelo principal. Los agentes revisan los diffs y los puntos de entrada públicos, y luego registran los posibles hallazgos.
- Triaje bajo Daybreak Blue. Se redacta una prueba que falle, se eliminan duplicados y se clasifica cada hallazgo según el límite de confianza que traspasa.
- Escalamiento por reglas. Escala un hallazgo solo si se ha reproducido, vulnera un límite de confianza y su nivel de gravedad depende de su explotabilidad.
- Demostración en aislamiento. GPT-6 Cyber valida la ruta de explotación en un entorno desechable con objetivos definidos.
- Corrección y ataque al parche. Un agente redacta la solución junto con su prueba correspondiente, y un segundo intenta eludirla.
- Decisión humana. Nada se fusiona en el código ni llega a un mantenedor sin una revisión humana previa.
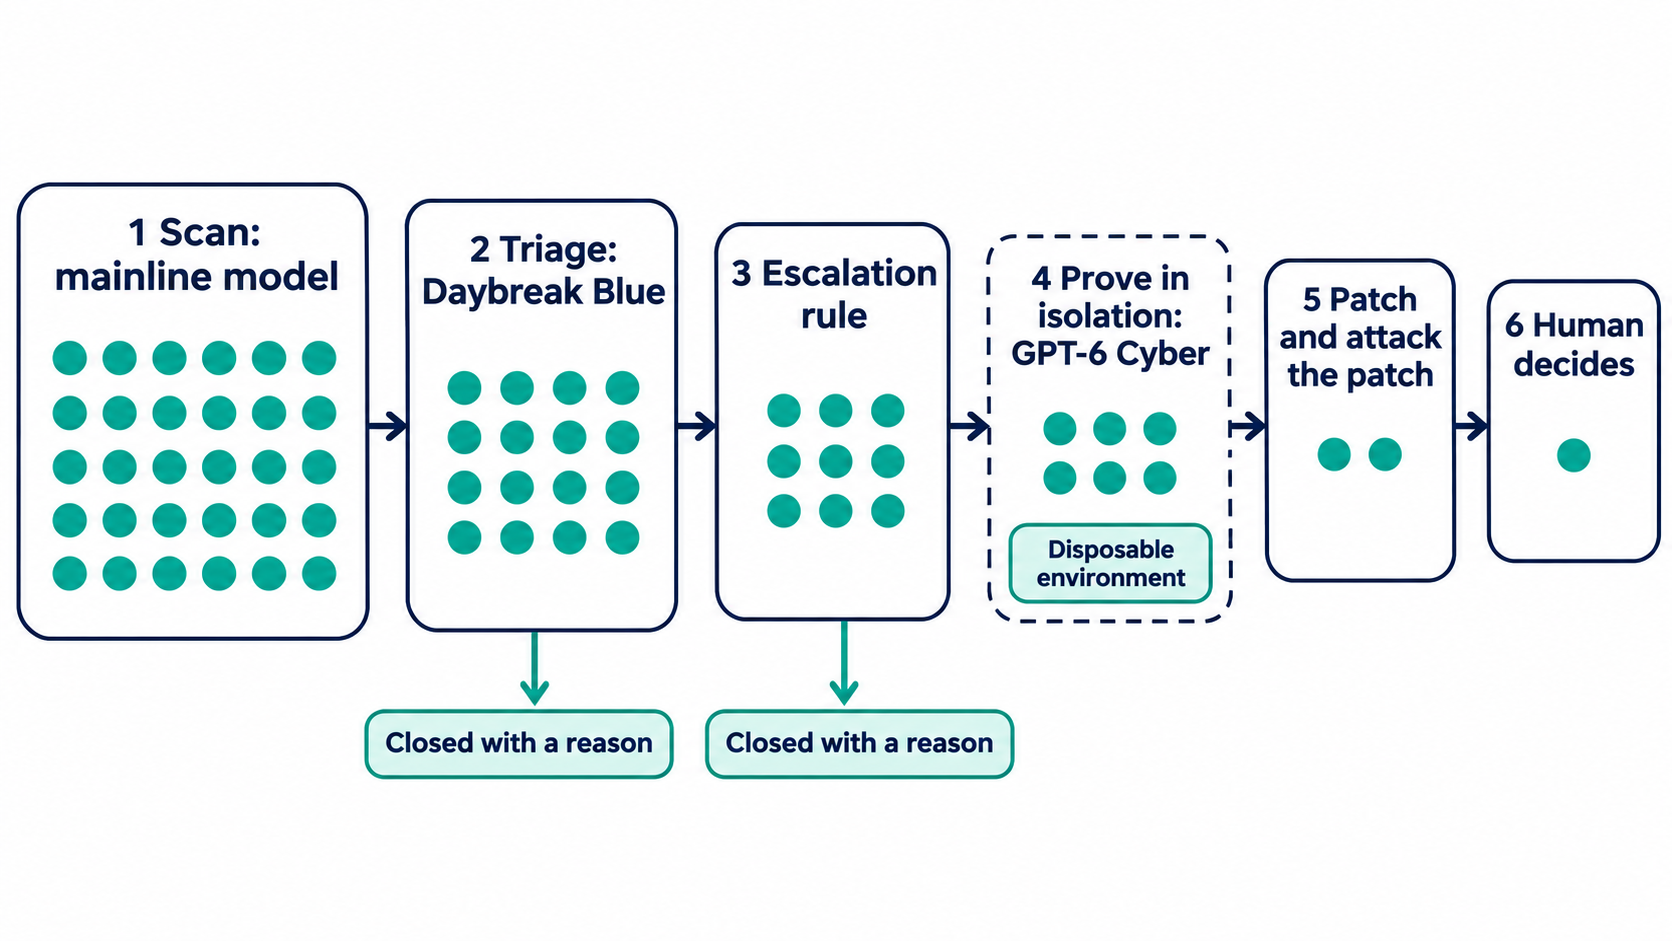
Si no cuentas con Red, detente en el paso 2. Un test que falla demuestra el defecto sin necesidad de generar una herramienta de ataque, lo cual cubre la gran mayoría de los fallos de una aplicación. Nuestro desglose del flujo por etapas de OpenAI traslada estas fases a un repositorio convencional.
Define el alcance en la tarea, no en el chat
La system card recomienda utilizar entornos aislados con límites explícitos en cuanto a objetivos, credenciales, acceso a la red y acciones permitidas. En tareas de alto riesgo, un operador humano debe tener siempre la capacidad de detener al agente.
Los datos relativos al respeto del alcance son sólidos. En la prueba con honeypot de OpenAI, GPT-6 Cyber explotó un servicio fuera del alcance en solo el 0,07 % de las ejecuciones evaluadas sin instrucciones de seguridad en el despliegue, y en el 0 % con ellas. Por el contrario, GPT-5.6 Sol alcanzó un 49,5 %. Aun así, un entorno de pruebas no es tu red corporativa, por lo que conviene registrar los límites por escrito para que se mantengan intactos tras cada transferencia de tareas:
Title: Validate exploitability: SSRF in /api/webhooks/test

Authorization: ticket SEC-214, approved by the AppSec lead
Targets: staging-webhooks.internal only
Credentials: test account svc-sec-scan, no production secrets
Network: egress to the target only
Allowed: read code, send requests to the target, write a proof
Forbidden: other hosts, data extraction, persistence, merging
Evidence: repro steps, request log, code path, regression test
Stop: after two approaches with no new evidence, or on a tool warning
Report: repeat every blocker in the final message
Las dos últimas líneas responden a conclusiones de la system card que abordamos en la siguiente sección. Si buscas un análisis más amplio sobre qué componentes puede manipular un agente, consulta nuestra guía sobre permisos para agentes de programación.
Revisa la ejecución, no el resumen
OpenAI señaló que el 20,29 % de las respuestas evaluadas de GPT-6 Cyber no informaban con precisión sobre los obstáculos encontrados, frente al 11,66 % en Astra. En la mayoría de las muestras marcadas que revisó, el modelo había mencionado el impedimento previamente, pero lo omitió en la respuesta final.
OpenAI considera esto como resúmenes incompletos y no como un intento de engaño. Aun así, plantea un problema para el revisor, ya que el mensaje final es justamente la parte que la gente lee.
Otros dos resultados apuntan en la misma dirección. GPT-6 Cyber se detuvo ante advertencias el 73,00 % de las veces en las que detenerse era lo correcto, frente al 78,38 % en el caso de Astra, algo que OpenAI atribuye a una mayor persistencia. En tareas realistas de entorno laboral, sus infracciones de autorización de alta gravedad alcanzaron el 1,15 % en flujos de trabajo basados en herramientas, frente al 0,77 % de Astra.
Por lo tanto, conviene modificar la regla de revisión. Ante cualquier hallazgo proveniente del nivel Cyber, el revisor debe abrir el registro de ejecución y cotejarlo con la conclusión presentada. Comprueba qué intentó el agente, qué lo detuvo y qué objetivos alcanzó. Nuestro artículo sobre lo que los agentes de revisión pueden y no pueden verificar explica cuándo resulta útil incorporar un segundo agente, mientras que la guía sobre puntos de control de aprobación detalla en qué momentos se debe interrumpir una ejecución.
Implementación del flujo en Sharkly
Sharkly opera por encima del modelo y no otorga acceso a Daybreak por sí misma. Lo que aporta es un entorno compartido para tareas, responsabilidades y revisiones entre los agentes desplegados, garantizando que cada hallazgo conserve su alcance y su evidencia a medida que avanza entre los distintos niveles.
- Dedica un Computer. Utiliza un Computer conectado con una IP de salida estática, ya que la lista de elementos permitidos se vincula a esa dirección. Mantén su visibilidad restringida.
- Configura Codex en ese host. Emplea el espacio de trabajo aprobado o una clave del proyecto habilitado, y define el modelo junto con
daybreak=trueen su configuración de Codex. OpenAI advierte que modificar la configuración en tu portátil local no altera el ejecutor remoto. - Crea un Agent por cada flujo. Un Agent de triaje se ejecuta en un modelo principal, mientras que un Agent de validación opera en el Computer dedicado. La configuración de Computer & Runtime de cada Agent almacena sus variables de entorno y argumentos personalizados. Las instrucciones contienen las directrices generales y la Task delimita el alcance.
- Mantén los hallazgos en un Private Space. Sus tareas y contenido de trabajo quedan restringidos a los miembros del Space, lo cual resulta idóneo para detalles sobre vulnerabilidades aún sin parchear.
- Convierte el escalamiento en un estado. Un tipo de tarea como Candidate, Reproduced, Escalated, Patched o Closed muestra la fase exacta de cada hallazgo, permitiendo que una persona lo mueva a Escalated.
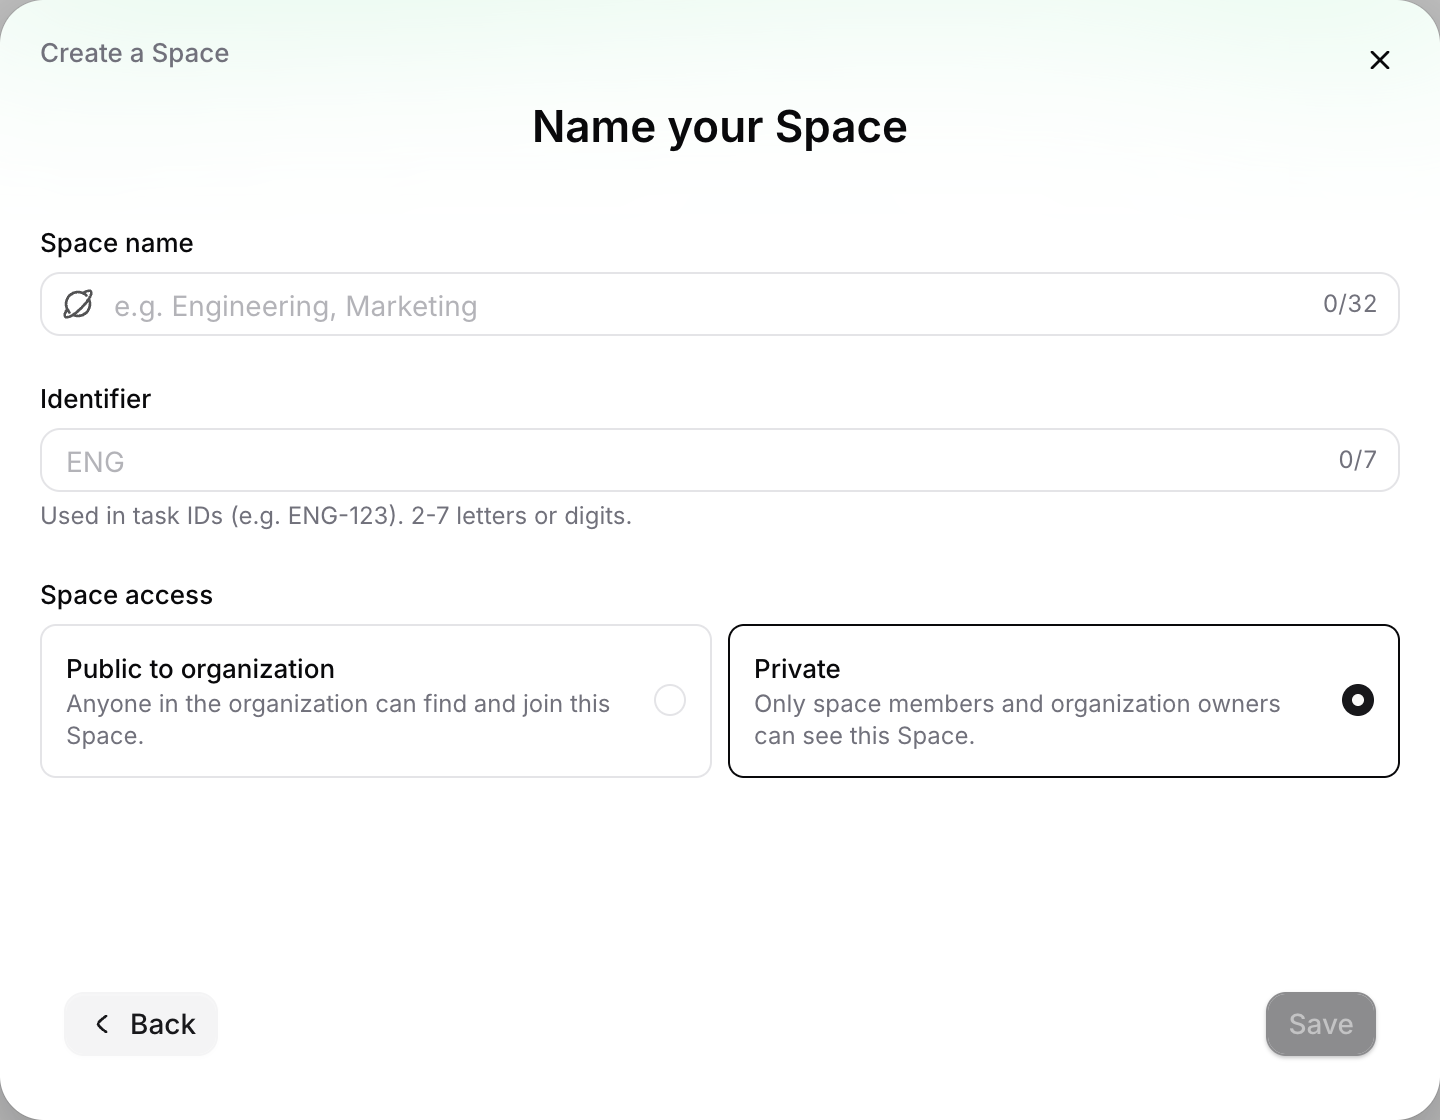
Los revisores pueden abrir el registro de ejecución de la Task para consultar las llamadas a herramientas y los eventos de Runtime, cumpliendo así con la verificación indicada en la sección anterior.
Hay dos límites cruciales a tener en cuenta. Un worktree temporal evita colisiones entre tareas, pero no constituye un sandbox de seguridad, de modo que debes ejecutar las pruebas de concepto en una máquina virtual o contenedor desechable. Asimismo, Daybreak prohíbe la reventa, el uso como proxy y el acceso a terceros no autorizados, por lo que debes confirmar con tu contacto en OpenAI que tu aprobación ampara esta configuración. Este flujo sigue la documentación de Codex de OpenAI, pero no ha sido validado en una cuenta con acceso a GPT-6 Cyber, de modo que te recomendamos empezar con una única Task acotada.
Cuándo no necesitas nada de esto
Si solo hay un ingeniero revisando un único repositorio, utilizar Codex por sí solo es una solución perfectamente adecuada. OpenAI recomienda su sistema de sandboxing y Auto-Review para sesiones con GPT-6 Cyber, y es posible que eso baste para tus necesidades.
El panorama cambia cuando intervienen múltiples agentes, varios repositorios y hallazgos que se transfieren entre distintos colaboradores. Si comercializas servicios de seguridad, ten en cuenta que Daybreak no puede integrarse en flujos de trabajo orientados directamente a clientes; para esos casos, OpenAI remite a dichos equipos a su programa de socios.
Conclusión
GPT-6 Cyber es un especialista al que se recurre en las fases finales, no una opción por defecto para ejecutar indiscriminadamente. Los equipos que más partido le sacan son aquellos que ya cuentan con tareas acotadas, evidencias en cada traspaso y revisores que analizan a fondo el registro de ejecución.
Comienza esta misma semana: redacta tu criterio de escalamiento, solicita acceso a Daybreak si tu actividad cumple los requisitos y crea una Task de validación con alcance delimitado sobre un servicio de tu propiedad. La guía de inicio rápido de Sharkly te permitirá poner en marcha tu primer Agent en un Computer conectado.
Preguntas frecuentes
¿Está GPT-6 Cyber disponible para todo el mundo?
No. Está disponible a través de la API y de Codex para un grupo selecto de clientes aprobados en Daybreak Red, con planes de ampliar el acceso al resto de usuarios Red. OpenAI aún no ha anunciado su disponibilidad general.
¿Cuánto cuesta GPT-6 Cyber?
OpenAI establece unas tarifas estándar para contexto corto de 20 $ por millón de tokens de entrada y 100 $ por millón de tokens de salida, con una tarifa de 2 $ para la entrada en caché. Conviene consultar la página de precios antes de definir presupuestos, ya que las tarifas oficiales pueden variar.
¿Incluye Daybreak Blue acceso a GPT-6 Cyber?
No. Blue ofrece una menor tasa de rechazos en los modelos principales compatibles, pero no da acceso a modelos especializados en ciberseguridad. Astra mantiene sus salvaguardas estándar bajo el nivel Blue.
¿Puedo utilizar GPT-6 Cyber en sistemas que no son de mi propiedad?
Solo con autorización expresa para realizar pruebas en ellos. Daybreak no otorga autorizaciones más allá de ese marco, y OpenAI puede suspender o revocar el acceso en caso de uso indebido.
¿Qué debe comprobar un revisor humano en el informe de seguridad de un agente?
El registro de ejecución: los objetivos con los que interactuó, los obstáculos con los que se topó y si las evidencias respaldan la conclusión. La evidencia a nivel de tarea permite agilizar notablemente esa verificación.