
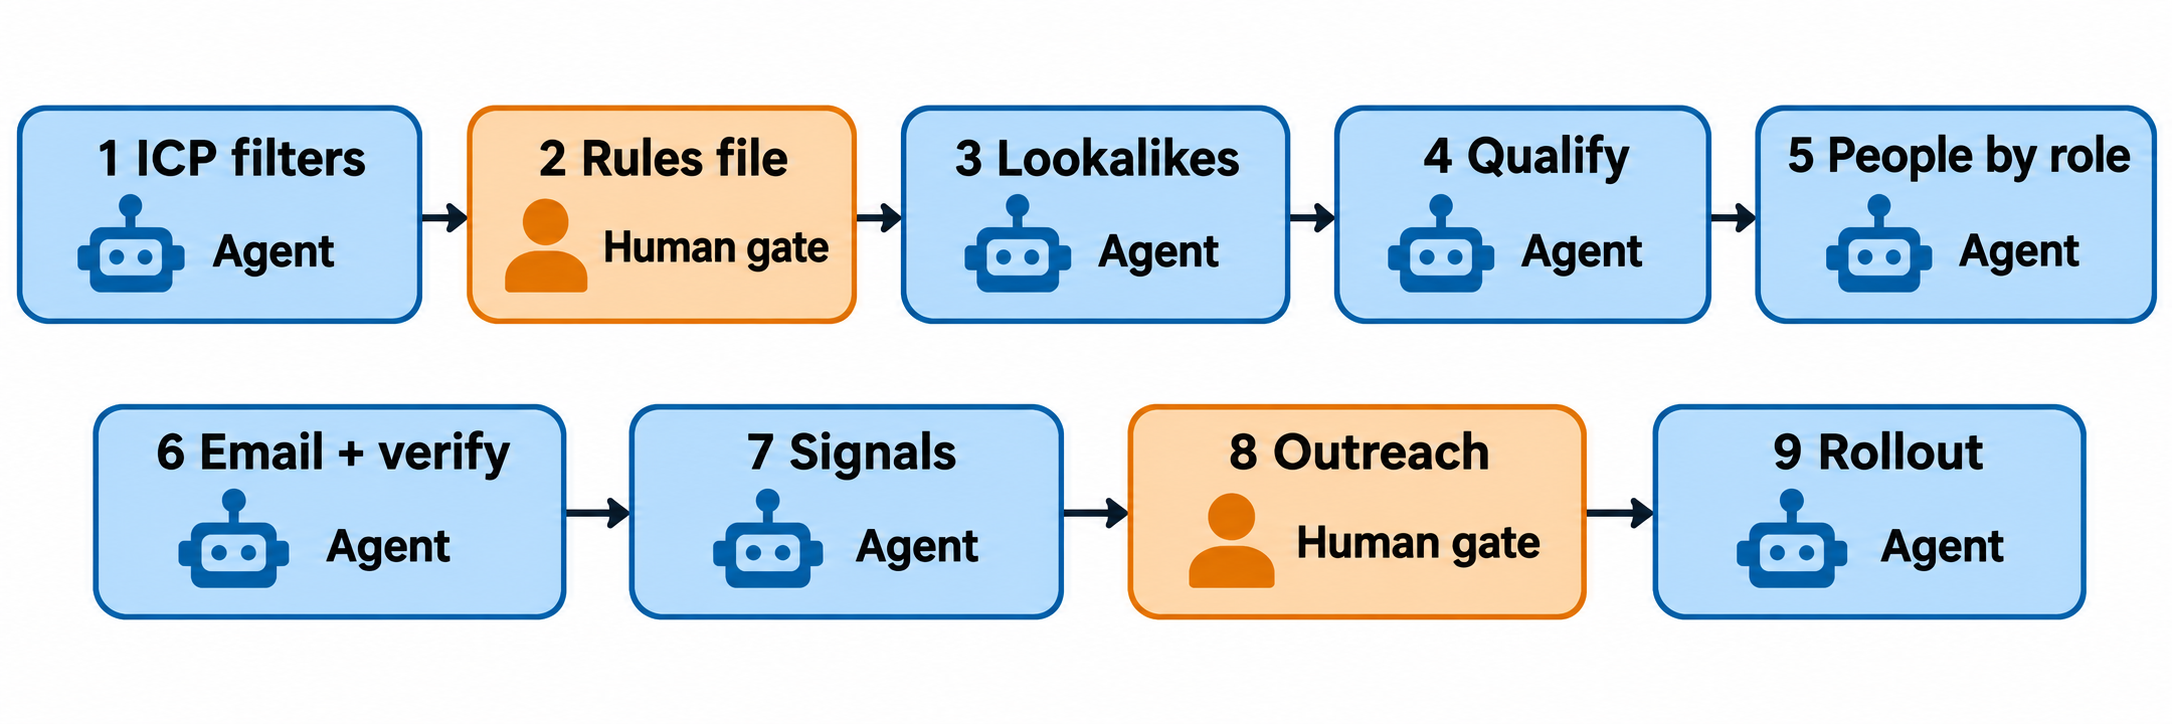
TL;DR: Puedes ejecutar GTM en Claude Code dividiendo el trabajo en una tarea de tablero por cada etapa: filtros de ICP, un archivo de reglas, calificación, búsqueda de personas, localización y verificación de correos, señales y prospección. Un agente ejecuta cada tarea de datos utilizando Treg como capa de datos. Una persona es responsable del archivo de reglas y aprueba cada primera línea antes de que se envíe nada.
Ejecutar GTM en Claude Code suena como un único prompt kilométrico: «búscame 50 cuentas buenas y escríbele al comprador». Funciona para una demo. Se rompe la semana en que una herramienta de búsqueda agota su capacidad o nadie sabe decir quién aprobó un correo.
El playbook de ingeniería de GTM de Treg cubre la parte de los datos: 16 capítulos desde el ICP hasta el despliegue, basados en seis ejecuciones registradas, 502 llamadas monitorizadas y un coste medido de 5,03 $. Cada cifra mostrada aquí es un resultado registrado por la propia Treg, aún no reproducido de forma independiente, así que pruébalo con tus propias filas.
La otra mitad es la coordinación: un responsable para detener el proceso, una persona a cargo de la prospección y recuentos de filas por etapa. Una sola sesión no puede abarcar todo eso. Este artículo muestra cómo estructurar el playbook como tareas en Sharkly, con agentes ejecutando cada etapa en Claude Code o Codex y un humano en los dos puntos de control que exige el playbook.
Por qué GTM en Claude Code necesita un tablero y no una sola sesión
Una sesión larga de agente oculta tres fallos que el trabajo de GTM no se puede permitir.
- Gasto sin puntos de control. Enriquecimiento de pago en filas que deberían haberse descartado.
- Interrupciones silenciosas. Treg detalla lo que falló en sus propias ejecuciones sin llegar a detenerlas: una herramienta de búsqueda sin capacidad, un endpoint de grupos de compra sin capacidad, 3 cuentas con límites de peticiones y un error de parseo que costó una reejecución de 1,08 $.
- Falta de responsable en los envíos. La regla de prospección del playbook es tajante: «no se envía nada que una persona no haya leído».
Cada uno de estos problemas afecta al equipo y se soluciona asignando responsables, estados y un registro por cada etapa. Es el modelo de responsabilidad humana en el trabajo con agentes aplicado a una lista de leads.
El stack: dónde se ejecuta cada pieza
Tres capas, cada una con una función concreta.
| Layer | Tool | Job |
|---|---|---|
| Ejecución | Claude Code o Codex | Ejecuta los prompts, lee el archivo de reglas y genera los CSV |
| Datos | Treg | Búsqueda de empresas y personas, enriquecimiento, localización y verificación de correos, señales de contratación y financiación, tarificado por llamada |
| Coordinación | Sharkly | Una tarea por etapa, un responsable (Assignee) por tarea, estados de revisión y el registro de ejecución |
Configura Treg una sola vez en el Computer donde se ejecutan tus agentes. A partir del archivo de configuración de Treg:
# install the CLI and the treg skill for every agent it detects
curl -fsSL https://treg.to/install.sh | sh

# browser sign-in (GitHub, Google, or an emailed code)
treg login

# headless Computer: pass a token instead of a browser
curl -fsSL https://treg.to/install.sh | sh -s -- --token "$TREG_TOKEN"
O pega una sola línea en el agente: set up treg - https://treg.to/llms.txt. Según Treg, las nuevas cuentas verificadas reciben 1,00 $ de crédito gratuito por única vez, las llamadas se facturan a la tarifa propia del proveedor con un 0 % de margen y los registros no encontrados facturan 0,00 $.
El pipeline de GTM estructurado en tareas de tablero
Aquí tienes el playbook distribuido en tareas. La tercera columna muestra la ejecución registrada por Treg en cada etapa.
| Task (playbook chapter) | Assignee | Treg’s recorded run |
|---|---|---|
| ICP como filtros + recuento gratuito (1-2) | Agente | CompanyEnrich, B2B+SaaS, 51-200 empleados, EE. UU.: 10 403; financiación 2024+: 1357 |
| Archivo de reglas (3) | Persona | Punto de control humano: umbrales, descartes, límites de gasto y quién puede detener la ejecución |
| Lookalikes (4) | Agente | 71 candidatas por 0,006 $; 8 de 71 superaron el control de ICP al 50 % |
| Calificar antes de pagar (5) | Agente | 50 empresas: 27 aprobadas, 21 descartadas; 2,33 $ en total, 0,12 $ por lead entregable |
| Personas por cargo (6) | Agente | «marketing» en 8 cuentas: 20 personas, 0,00 $ (los datos de contacto son el paso de pago) |
| Waterfall de correos + verificación (7-8) | Agente | 60 personas: 32 entregables, 16 arriesgados, 4 desconocidos, 8 no válidos, 0,65 $ |
| Señales (9-10) | Agente | 27 cuentas: 16 tenían vacantes abiertas de GTM en los últimos 60 días, 1,35 $ |
| Prospección (11-12) | El agente redacta, la persona aprueba | 4 de 19 primeras líneas basadas en noticias se calificaron como aceptables o mejores |
| Etiquetado, métricas y despliegue (14-16) | Agente + persona | Recuentos de filas por etapa, respuestas en bruto almacenadas, límite de gasto por ejecución |
¿Cómo definir un ICP sobre el que un agente pueda aplicar filtros?
Divídelo en filtros y verificaciones. Los filtros son campos que un proveedor puede buscar: país, número de empleados, categoría o financiación. Las verificaciones son evaluaciones de criterio fila por fila y se ejecutan antes de cualquier paso de pago.
La descripción de la tarea puede incluir el prompt de Treg: «Usando treg, convierte el ICP de icp.md en filtros para dos proveedores de búsqueda de empresas. Utiliza únicamente sus endpoints de recuento gratuito». Los criterios de aceptación provienen del playbook: no se compra ninguna lista hasta que dos recuentos gratuitos coincidan aproximadamente y diez filas de muestra se vean correctas.
¿Por qué el archivo de reglas necesita un responsable humano?
El umbral altera por completo la lista. En la ejecución de Treg, 27 de 48 empresas superaron un umbral de ICP del 50 %; al 60 %, solo lo habrían logrado 14. Se trata de una decisión de negocio, por lo que una persona debe ser la responsable de la tarea que lo defina.
Ubica las reglas donde cada etapa pueda leerlas. Una Skill de Sharkly empaqueta instrucciones reutilizables para el trabajo de los agentes, de modo que el archivo de reglas se convierte en una sola Skill vinculada a cada agente de GTM, en lugar de ser un párrafo pegado en nueve prompts distintos.
# gtm-rules.md (owner: the person who can stop the run)
icp_threshold: 0.50
max_spend_per_run_usd: 3.00
drop_if: [no_usable_domain, headcount_outside_51_200]
send_only: verifier_verdict == "deliverable"
stop_owner: "growth lead"
every_stage_reports: [rows_in, rows_out, metered_cost]
Etapas 3 a 7: calificar antes de pagar
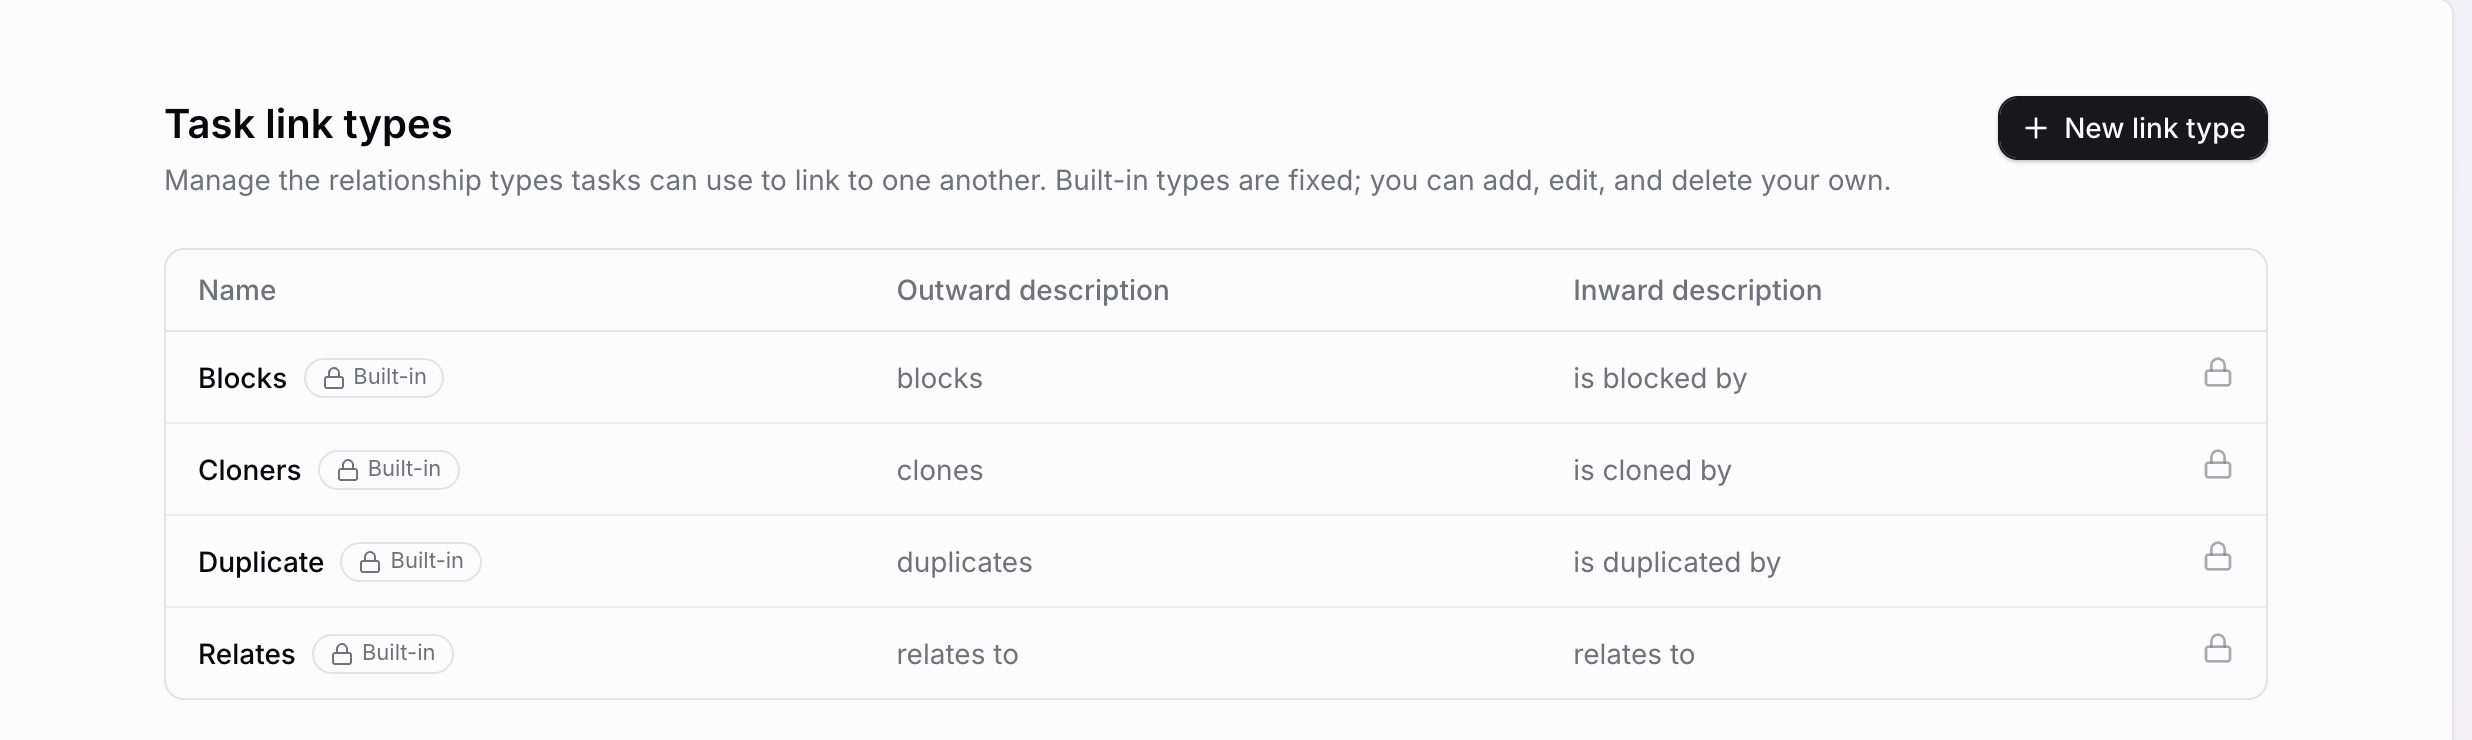
Estas son las tareas de datos que priorizan el menor coste. Enlázalas mediante la relación bloquea / está bloqueada por (blocks / is blocked by) para que la calificación termine antes de que comience la búsqueda de personas. El orden es fundamental para controlar el gasto: Treg calificó 50 empresas por 2,33 $ y calculó un coste de 4,12 $ para enriquecer las 48 con un dominio válido.
Dos reglas del playbook se convierten en criterios de aceptación. Las cuentas similares (lookalikes) deben superar el mismo filtro de tamaño y la misma comprobación de ICP que cualquier otra fila. Además, únicamente las direcciones verificadas como entregables entran en la secuencia: en el estudio de 60 personas de Treg, el buscador devolvió 60 direcciones y el verificador solo validó 32.
Cada tarea de datos finaliza con un comentario del agente: filas de entrada, filas de salida y coste medido de Treg. Junto con el registro de ejecución, ese es el comprobante de la etapa.
¿Cómo mantener a una persona a cargo del botón de envío?
La tarea de prospección es el punto en el que el agente investiga, redacta un borrador y se detiene. En la ejecución de Treg, solo 4 de 19 primeras líneas basadas en noticias obtuvieron una calificación aceptable o superior. Por ello, el agente deja la tarea en estado en espera de revisión humana (waiting for human review), y el revisor aprueba, edita o reescribe. Ya abordamos este patrón en agentes de programación con intervención humana (human-in-the-loop); se aplica a los correos electrónicos exactamente de la misma manera.
Cómo garantiza Sharkly el cumplimiento de las reglas del playbook
- Una tarea por etapa: asigna a cada etapa un estado, un responsable o Assignee (agente, Crew o persona) y criterios de aceptación.
- Estados de revisión: canalizan la atención. Un agente puede dejar una tarea esperando respuesta humana o pendiente de revisión humana, y esas señales alimentan el Inbox de la persona responsable.
- El registro de ejecución: muestra cuándo comenzó y finalizó una ejecución, sus llamadas a herramientas y eventos de Runtime, junto con el detalle de los errores: el registro de auditoría que exige el capítulo de despliegue.
- Tareas principales (Parent tasks): albergan el resultado global. «Lista de compradores de marketing del T4» es la tarea principal; las nueve etapas son subtareas.
Si prefieres no repartir nueve tareas manualmente, un líder de Crew puede dividir la tarea principal y delegar las etapas, tal como se describe en Sharkly Crews. Empezar con Sharkly es gratis, y el consumo de modelos se carga al plan de Claude Code o Codex ya vinculado a tu Runtime.
Señales: sin enlace a la fuente, no hay señal
La tarea de señales requiere los criterios de aceptación más estrictos. Treg encontró 16 de 27 cuentas con vacantes abiertas de GTM en los últimos 60 días, pero 355 de las 675 ofertas devueltas ya estaban cerradas.
Los cambios de puesto son todavía más delicados. En el estudio de Treg sobre 148 personas que habían anunciado un nuevo cargo, las bases de datos de contactos no detectaron la nueva empresa el 68 % de las veces en promedio. La lectura en directo de perfiles solo identificó a 49 de las 148 personas, pero acertó en 47 de ellas. Se mantiene la regla del playbook: sin enlace a la fuente, no hay prospección.
La prueba de Treg sobre contrataciones previas a una ronda de financiación no logró diferenciar los grupos, así que valida cualquier señal de temporalidad con tus propias operaciones ganadas y perdidas antes de asignarle un peso.
Lo que dicen las cifras de Treg y lo que no
Treg publica dos comparativas que vale la pena analizar en detalle en su página de búsqueda de personas.
- Coste por correo electrónico correcto: sobre 100 leads en octubre de 2026, Treg reporta 92 correos de trabajo correctos a 0,58 $ por cada 100 aciertos, frente a 84 a 3,77 $ en Clay.
- Precisión del agente: en las tareas de prospección B2B del benchmark de 119 tareas People Search Bench de LessieAI, Treg reporta que Claude Code en solitario alcanza un 43 % y Claude Code con Treg llega al 78,2 %, completando la lista en 1,4 minutos en lugar de 2,8.
Se trata de resultados obtenidos por el propio proveedor a precios de lista en ese momento, y la propia Treg señala que una diferencia de pocas filas se considera un empate técnico. Utilízalos como referencia para elegir qué probar en 50 filas de tus propios datos.
Despliega como si fuera software
La regla del último capítulo: nada pasa a ser autónomo antes de haberse ejecutado en modo shadow (a la sombra). En un tablero, esto se traduce en tres fases:
- Shadow. Los agentes ejecutan cada tarea de datos; la tarea de prospección permanece en revisión y no se envía nada.
- Segmento reducido. Un nivel, una semana. Supervisa el recuento de filas y el coste por lead entregable frente a lo estipulado en el archivo de reglas.
- Autonomía para los datos, nunca para los envíos. Las tareas de datos se ejecutan de forma programada mediante una automatización (Automation). El envío sigue siendo una decisión exclusivamente humana.
Para monitorizar varias ejecuciones simultáneamente, consulta cómo monitorizar agentes de programación que se ejecutan en paralelo.
Empieza con una sola etapa
El GTM en Claude Code funciona cuando cada etapa es acotada, tiene un coste definido y un responsable claro, y el tablero indica quién detiene la ejecución y quién aprueba los envíos. Empieza poco a poco: crea la tarea de ICP y la del archivo de reglas en Sharkly, realiza el recuento gratuito y solo entonces abre las etapas de pago.
FAQ
¿Qué es la ingeniería de GTM?
El playbook de Treg la define como el diseño, la creación y el mantenimiento de sistemas que transforman una estrategia de salida al mercado (go-to-market) en flujos de trabajo repetibles: selección de cuentas objetivo, enriquecimiento de leads, puntuación (scoring), monitorización de señales, investigación y enrutamiento inbound, siempre con revisión humana antes de enviar mensajes salientes.
¿Cuánto cuesta Treg por lead?
En la propia ejecución de Treg del 23 de septiembre de 2026, los leads calificados costaron 0,12 $ por lead entregable y 2,33 $ para la lista completa. Las llamadas se tarifican por uso y los registros no encontrados facturan 0,00 $.
¿Debería un agente de IA enviar correos en frío sin revisión?
No. El playbook de Treg establece que no se debe enviar nada que una persona no haya leído, y en su ejecución solo 4 de 19 primeras líneas investigadas por el agente obtuvieron una calificación aceptable o mejor.
¿Dónde residen las reglas de un agente de GTM?
En un archivo de reglas con umbrales numéricos, criterios de descarte explícitos, un límite de gasto y una persona designada como responsable de detener el proceso. En Sharkly puedes empaquetarlo como una Skill para que todos los agentes lean las mismas reglas.
¿Funciona esto con Codex en lugar de Claude Code?
Sí. La configuración de Treg es compatible con Claude Code, Codex y Cursor, y un agente de Sharkly puede ejecutarse en cualquiera de esos Runtime desde el mismo tablero. Consulta gestor de tareas con IA: asignar, supervisar y revisar el trabajo de los agentes para la configuración general.