
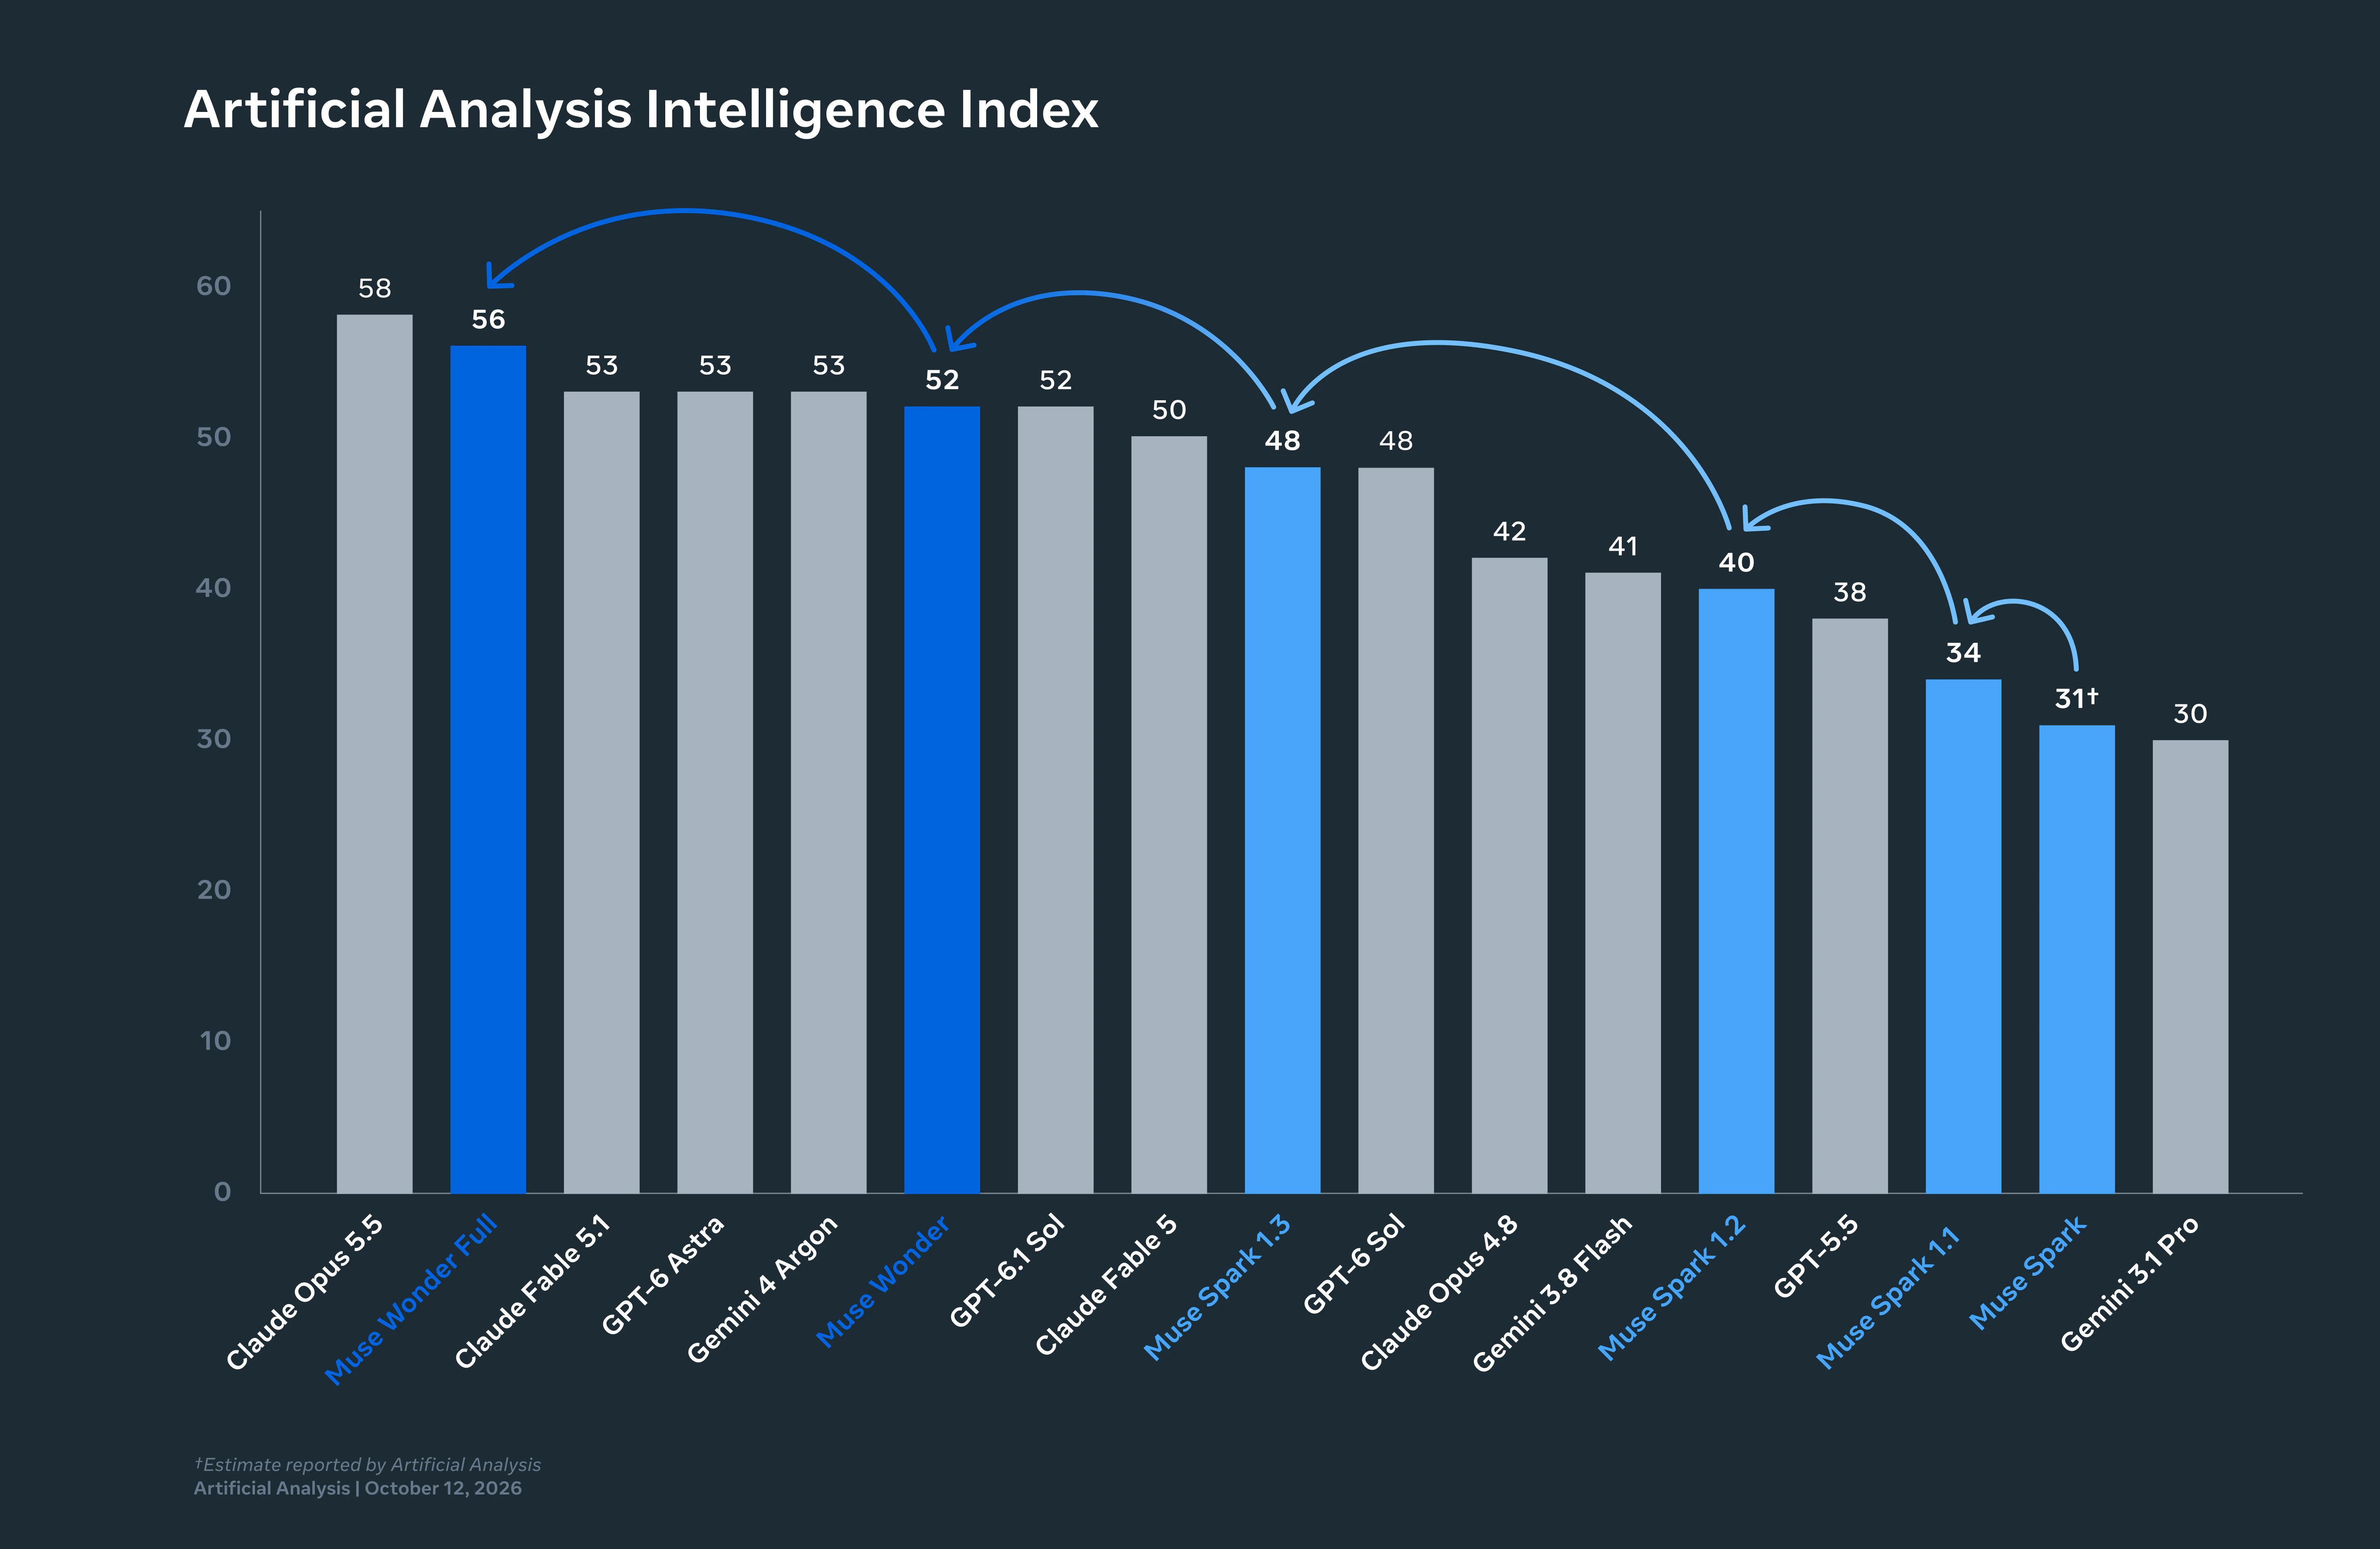
Muse Wonder y Claude Opus 5.5 cuestan lo mismo: 4 $ por millón de tokens de entrada y 20 $ por millón de tokens de salida. Por lo tanto, para un Crew, elegir entre uno u otro no es una cuestión de presupuesto, sino una regla de enrutamiento. La ficha técnica del modelo de Meta sitúa a Wonder por delante en el benchmark que evalúa sesiones de programación de larga duración (SWE-Marathon: 53,1 frente a 46,3), mientras que Opus lidera en tareas de terminal (59,6 frente a 52,0), inteligencia general (58 frente a 52 en el índice independiente) y conocimientos (46 frente a 25). Estas cuatro cifras describen a dos Agents muy diferentes, y un panel que enrute las tareas según estos criterios aprovechará mejor ambos modelos que uno que simplemente elija una opción por defecto.
Este artículo traduce esas cifras en asignaciones prácticas: qué Tasks deben asignarse a un Agent de Muse Wonder, cuáles deben quedarse en Opus 5.5, qué impacto tiene cada uno en la cola de revisión y cómo comprobar tras una semana si la regla está funcionando. La configuración para el carril de Meta se detalla en cómo ejecutar agentes Muse Wonder en Sharkly.
Las cifras clave para el enrutamiento
| Métrica | Muse Wonder | Claude Opus 5.5 | Fuente |
|---|---|---|---|
| SWE-Marathon (ejecuciones largas de código) | 53.1 | 46.3 | Ficha del modelo de Meta |
| DeepSWE 1.1 | 78.8 | 74.2 | Ficha del modelo de Meta |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Ficha del modelo de Meta |
| AA-Omniscience (conocimiento) | 25 | 46 | Artificial Analysis |
| Tasa de alucinación | 27% | más baja, según el ranking de AA | Artificial Analysis |
| Índice de inteligencia | 52 | 58 | Artificial Analysis |
| Índice de agentes de código | 63 | 66 (Claude Code) | Artificial Analysis |
| Coste por tarea de índice | $4.52 | $5.98 | Artificial Analysis |
| Entradas | Texto, imagen, vídeo y audio | Texto, imagen y PDF | Documentación del proveedor |
Interprete la tabla a partir de dos perfiles. Wonder: persistente, más económico por tarea gracias a que sus respuestas son concisas, con menor capacidad de retención de información y compatible con vídeo y audio. Opus: más inteligente en conjunto, más competente en la terminal, con mayores conocimientos y más costoso por tarea. Ningún perfil es intrínsecamente superior al otro; simplemente se adaptan a diferentes Tasks.
Tasks ideales para el Agent Muse Wonder
El factor común son las tareas extensas que presentan bloqueos. Meta entrenó el modelo para lo que denomina Enfoque Activo (Active Focus): probar enfoques alternativos y superar obstáculos sobre la marcha. SWE-Marathon es, precisamente, el benchmark diseñado para medir esta capacidad.
- Refactorizaciones en múltiples archivos manteniendo la suite de pruebas en verde. Tareas con muchos pasos, todos verificables, y con fallos que exigen un segundo o tercer intento.
- Migraciones de dependencias y frameworks. La clásica ejecución larga: actualizar, romper, arreglar y repetir; donde el trabajo del modelo consiste en no rendirse en el undécimo paso.
- Ciclos de corrección y verificación frente a suites inestables (flaky tests). Ejecuciones que requieren distinguir entre un fallo propio y un error inherente a la suite.
- Tasks con entradas de vídeo o audio. La grabación de pantalla de un bug o el audio de una reunión con requisitos. Opus 5.5 no admite estos formatos.
Defina los criterios de aceptación de manera que el modelo pueda verificarlos de forma autónoma. Wonder rinde al máximo cuando la Task especifica: «todos los tests de packages/api pasan y el changelog incluye una nueva entrada», y muestra su peor desempeño cuando debe decidir por sí mismo qué significa haber terminado.
Tasks que deben mantenerse en Opus 5.5
- Trabajo intensivo en terminal. Scripts de infraestructura, pipelines de despliegue o cualquier tarea en la que el agente opere principalmente en una shell. Una diferencia de siete puntos y medio en Terminal-Bench es una ventaja considerable.
- Cualquier tarea que dependa de conocimientos previos. Una puntuación en Omniscience de 25 frente a 46 implica que Wonder tiene el doble de probabilidades de ignorar un dato relevante. Ante APIs de librerías desconocidas, códigos de error poco habituales o conocimientos de dominio muy específicos, Opus responde de memoria, mientras que Wonder debe consultar fuentes externas o deducirlo.
- El rol de revisor. El Agent encargado de revisar el diff generado por otro Agent y dictaminar si es correcto debe ser el más inteligente disponible. Según el índice compuesto, ese es Opus; además, el patrón de Crew con modelos mixtos ya asigna a este rol el modelo más avanzado.
- Tasks breves y puntuales. En DeepSWE ambos modelos obtienen resultados similares, pero en inteligencia general Opus lleva la delantera. Si la ejecución va a durar diez minutos, la ventaja de persistencia de Wonder ni siquiera llega a manifestarse.
El impacto de cada modelo en la cola de revisión
El enrutamiento modifica de forma directa lo que llega a manos de los revisores, y ahí radica el coste real.
Una ejecución de Wonder en una Task extensa genera un recorrido más largo: más intentos, más enfoques revertidos y más commits. Esto demuestra que el modelo está cumpliendo con su función, pero también implica que el diff no cuenta toda la historia. El revisor necesita acceder al registro de ejecución; por ello, las instrucciones del Agent deben indicarle que mantenga un registro detallado de todo lo que ha intentado. El principio de que la revisión humana es el cuello de botella cobra aquí todavía más fuerza: un modelo persistente genera más material para revisar por cada Task, no menos.
La brecha de conocimientos de Wonder se manifiesta en afirmaciones muy seguras pero incorrectas: un flag inexistente o un método que cambió de nombre hace dos versiones. Aunque su tasa de alucinación es baja dentro de su categoría (un 27 % según las métricas de Artificial Analysis), un 27 % no es cero. Indique al Agent que verifique en el repositorio cualquier dato del que no esté completamente seguro y que declare explícitamente cuándo no pudo hacerlo, permitiendo así que el revisor inspeccione de forma puntual esas líneas en concreto.
Una ejecución de Opus en la misma Task suele trazar un camino más corto y resolutivo, con un coste superior por tarea. En consecuencia, la revisión por cada ejecución es más ligera. Sin embargo, cuando la Task es larga y presenta múltiples bloqueos, es más probable que Opus se detenga antes de tiempo, lo que introduce un tipo distinto de problema en la cola: una Task que regresa a medio terminar y exige replantear su alcance.
Tres Tasks y cómo enrutarlas
Los ejemplos concretos facilitan la aplicación de estas reglas al asignar las tareas.
«Actualizar el ORM de la v5 a la v7 en todos los servicios asegurando que pasen todos los tests de integración». Wonder. Decenas de pasos, una suite de pruebas que arrojará fallos distintos en cada etapa y una línea de meta bien definida. La persistencia del modelo es su mayor virtud y la propia ejecución puede validar el criterio de aceptación.
«Escribir los archivos de Terraform para el nuevo entorno de staging y aplicarlos». Opus. Uso intensivo de la terminal, conocimiento específico de infraestructura y una acción con consecuencias reales. Terminal-Bench apunta a Opus; y el radio de impacto exige que el Agent se detenga a pedir confirmación antes de ejecutar apply, independientemente del modelo elegido.
«Explicar por qué el webhook de pagos se dispara dos veces y proponer una solución». Opus para la explicación, ya que requiere comprender la semántica de reintentos del proveedor, lo cual depende de la recuperación de conocimientos. Si la solución propuesta deriva en modificaciones en múltiples archivos con tests asociados, esa Task posterior puede derivarse a Wonder.
El patrón es claro: Wonder para Tasks definidas por una línea de meta clara; Opus para Tasks que dependen de conocimientos específicos. Si una Task combina ambas exigencias, divídala. Sharkly está diseñado precisamente para facilitar esa división: una Task por Agent en cada carril, registrando el traspaso en el panel y no en la memoria de alguien.
Cómo ejecutar ambos y evaluar los resultados
Aplique esta regla en el panel durante una semana y deje que las Tasks confirmen los resultados.
- Cree el Agent de Muse Wonder y mantenga el de Opus 5.5. Configure las instrucciones de ambos Agents para que incluyan el identificador del modelo en la parte superior del informe, ya que Sharkly no lo muestra de forma nativa.
- Asigne el trabajo siguiendo la regla anterior y no por preferencia personal: las tareas largas y propensas a bloqueos a Wonder; las de terminal y conocimiento a Opus; y la revisión a Opus.
- Al cabo de una semana, revise las Tasks resueltas por cada Agent y evalúe tres aspectos: cuántas devolvieron una pregunta en lugar de un resultado, cuántas requirieron una segunda ejecución y cuántos comentarios de revisión generó cada una.
Si las Tasks extensas de Wonder se completan con menos reejecuciones y las Tasks de terminal de Opus requieren menos correcciones, la regla está funcionando. En cambio, si las Tasks de Wonder generan más comentarios de revisión de los que compensan las reejecuciones evitadas, reduzca el tipo de tareas que le delega. Las cifras de la tabla son promedios obtenidos en benchmarks; sus propias Tasks son la verdadera prueba de fuego.
Nada de esto repercute en la factura de Sharkly. El consumo de los modelos se gestiona a través de las claves de API de Meta y Anthropic configuradas en el Computer y, al tener precios de catálogo idénticos, la única variación en el gasto vendrá reflejada en el bloque de usage de cada ejecución.
Los modelos cambiaron este mes, pero el contexto, el progreso, los bloqueos, los resultados y la revisión humana permanecen visibles desde la solicitud inicial hasta el lanzamiento. Puede implementar esta dinámica de forma manual mediante worktrees o apoyarse en Sharkly para gestionar todo el flujo de trabajo.


