

TL;DR
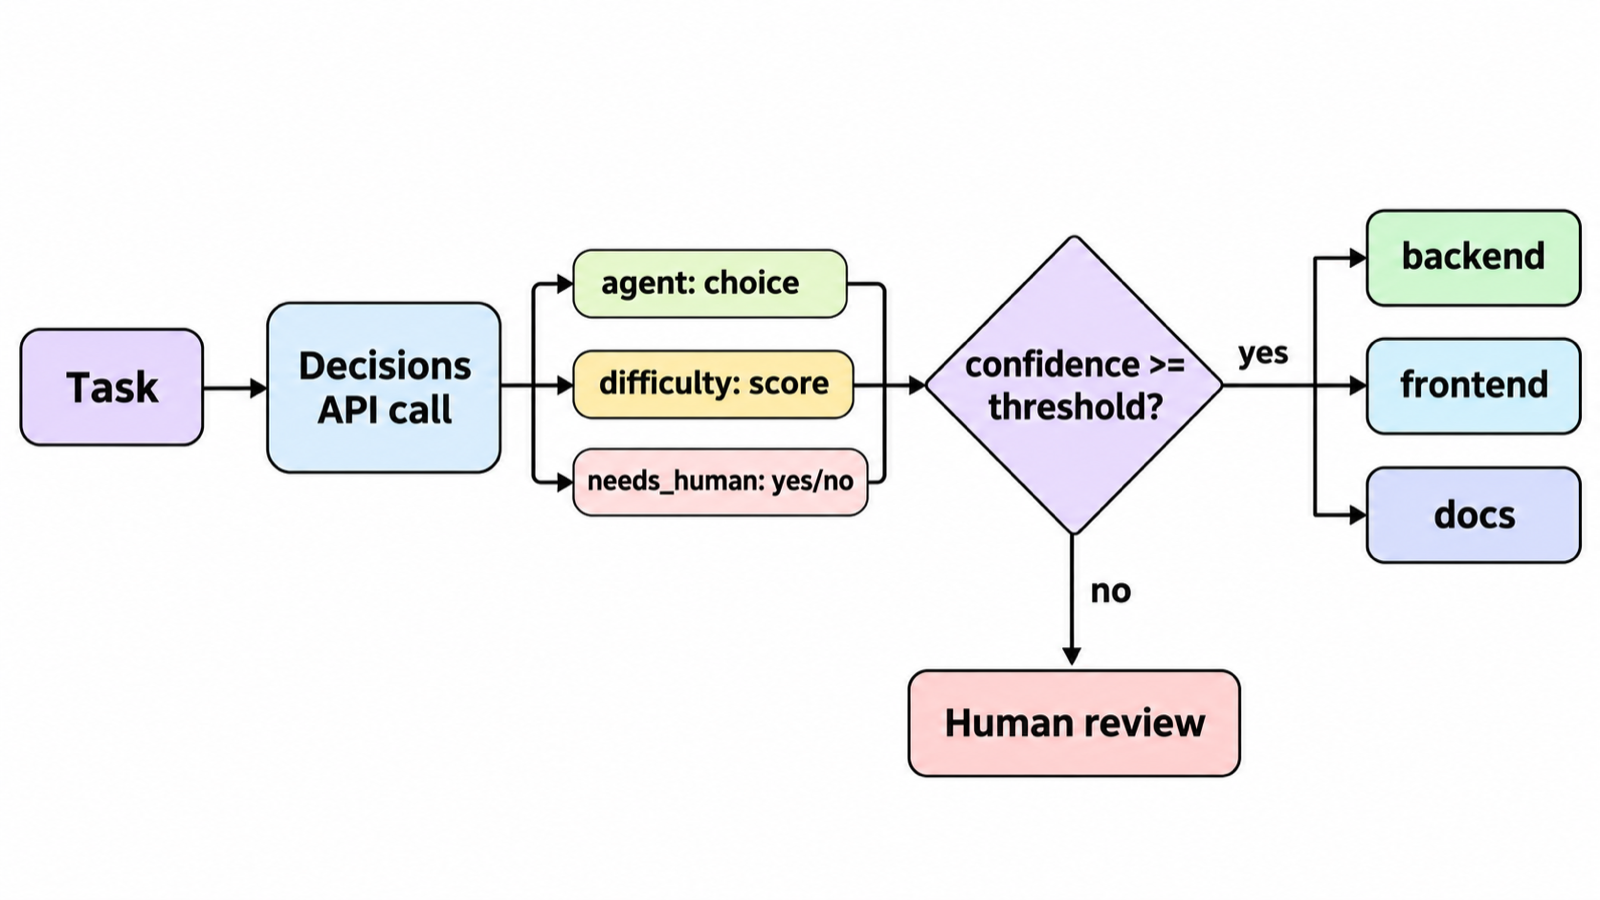
Para enrutar tareas de agentes de IA con la Gemini Decisions API, envía el título y la descripción de la tarea a gemini-decision-1 con tres preguntas: una de tipo choice para definir qué agente la asume, una de tipo score para evaluar su dificultad y una de tipo noul para saber si una persona debe decidir primero. Asigna la tarea automáticamente cuando la confianza supere tu umbral y retén el resto para revisión humana.
Introducción
Cualquier equipo que trabaje con varios agentes de programación termina lidiando con la misma tarea rutinaria: alguien debe leer cada nueva tarea y decidir quién se encarga de ella. ¿El agente de backend o el de frontend? ¿El modelo económico o el más potente? ¿Está lista para empezar o todavía falta tomar una decisión?
El 11 de noviembre de 2026, Google lanzó una herramienta diseñada específicamente para esta labor. La Gemini Decisions API responde preguntas cerradas con probabilidades calibradas en lugar de generar texto. Google la utiliza internamente en Gemini Notebook para enviar cada consulta al nivel de modelo y profundidad de razonamiento adecuados, afirmando que esto redujo la latencia en consultas cotidianas hasta en un 40%.
En este artículo construiremos ese mismo enrutador para un tablero de agentes: una llamada por tarea, tres preguntas, un umbral y una derivación clara a un humano cuando el enrutador no esté seguro. Si necesitas un tablero para probarlo, puedes comenzar gratis con Sharkly. En cuanto a la política de enrutamiento propiamente dicha (qué tareas ameritan el modelo más potente), te recomendamos leer primero cómo enrutar tareas de agentes según su dificultad. Este post se centra en la llamada que aplica dicha política.
Qué hace la Gemini Decisions API
La Gemini Decisions API es un endpoint que evalúa preguntas tipadas a partir de una entrada compartida y devuelve una probabilidad y una puntuación de confianza para cada una. No genera texto, por lo que los tokens de salida son siempre cero. Tu código puede bifurcarse directamente a partir de los números, sin necesidad de parsear respuestas.
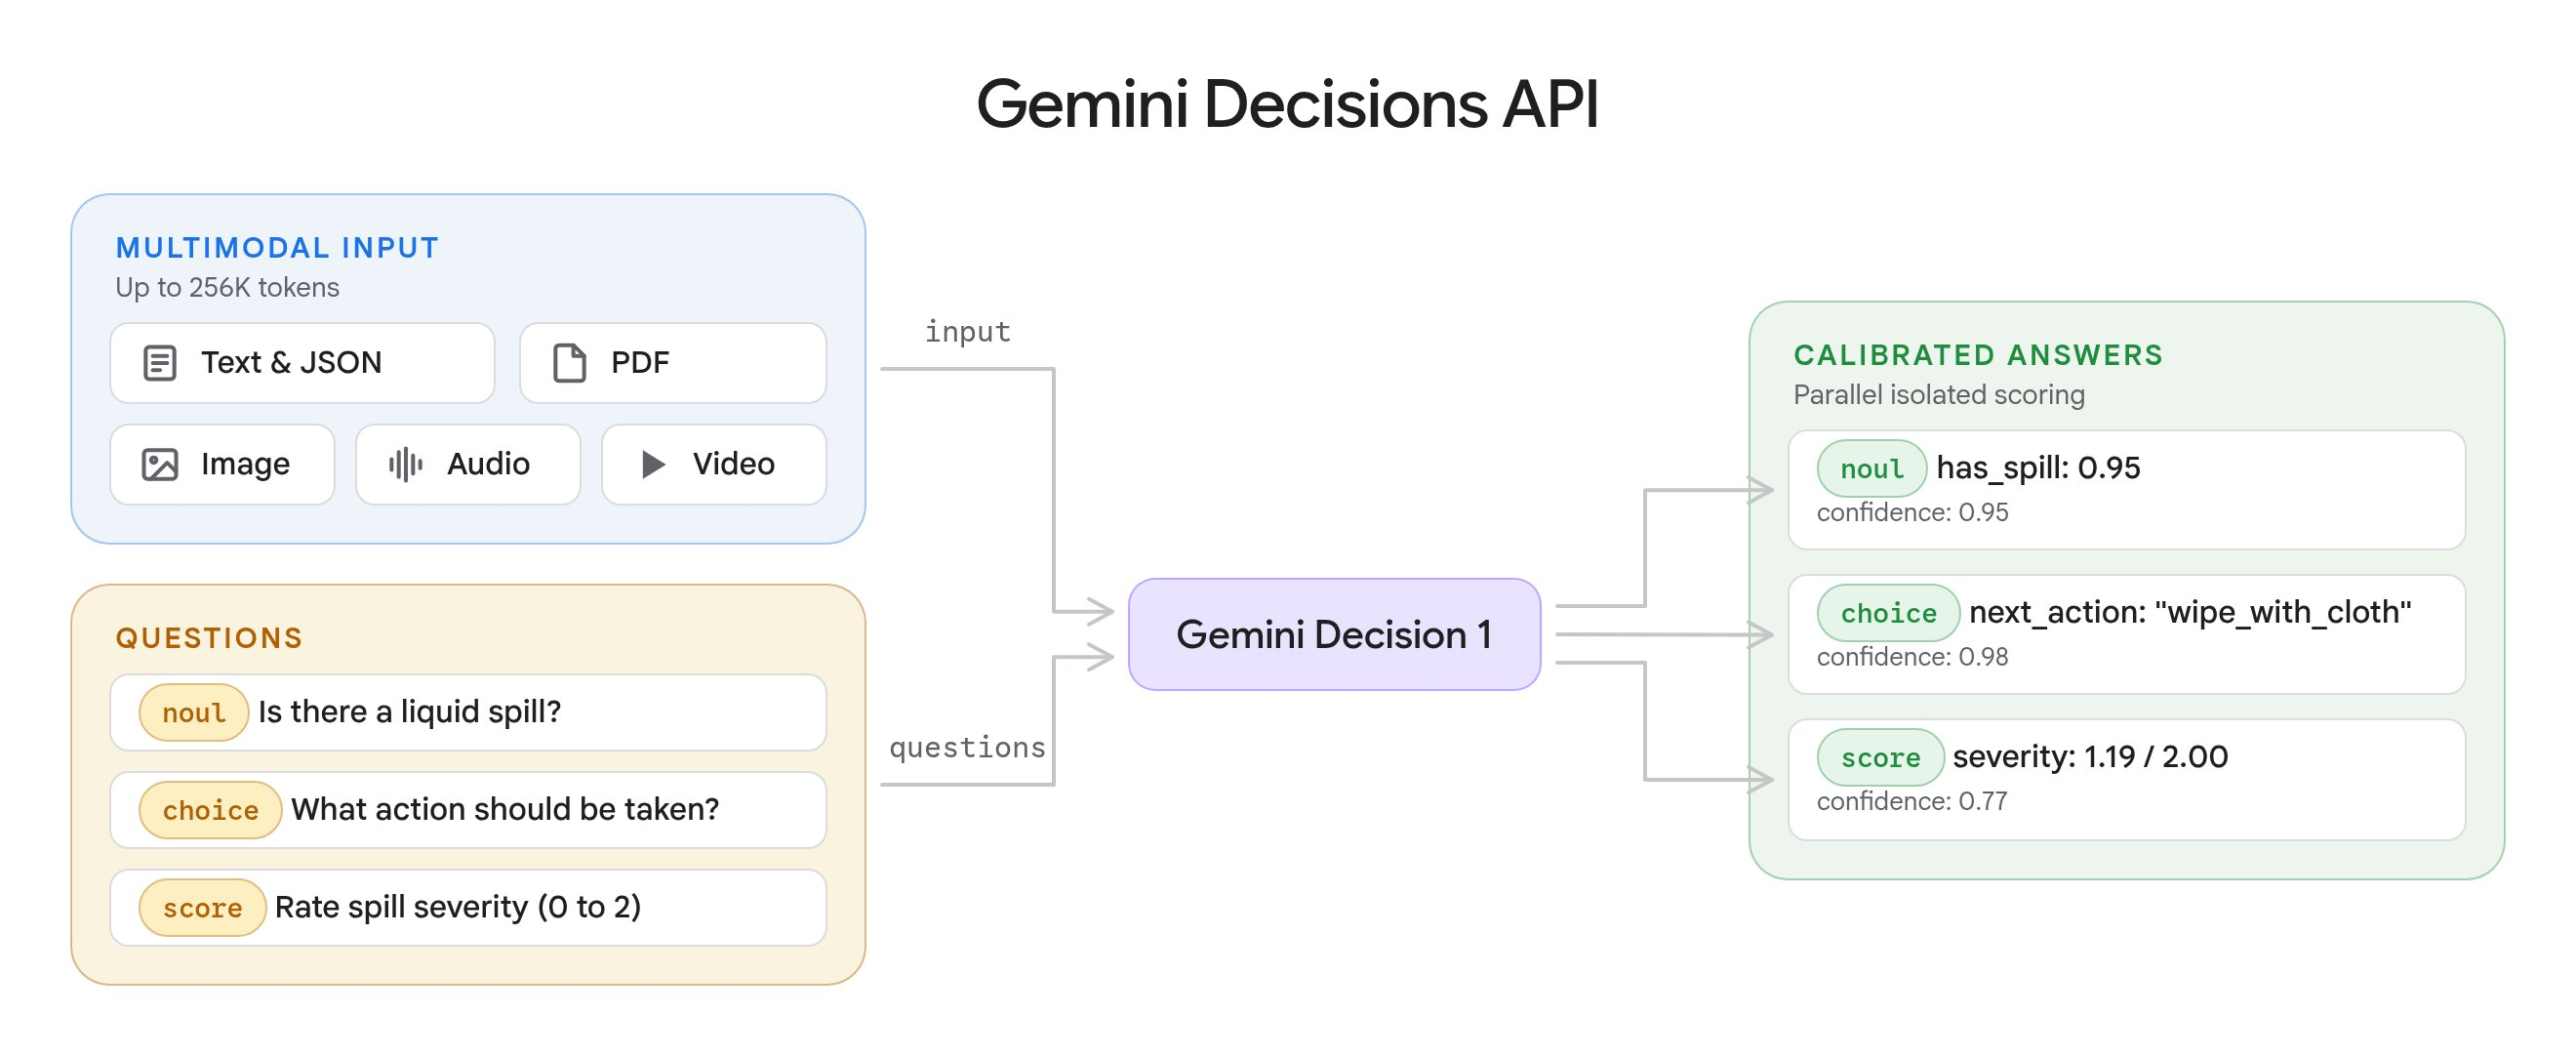
Existen tres tipos de preguntas para resolver el enrutamiento:
| Tipo | Qué responde | Qué devuelve |
|---|---|---|
choice |
Elige una opción entre 2 y 255 | choice, probabilities, confidence |
score |
Evalúa según una rúbrica ordenada | score, probabilities, legend, confidence |
noul |
Sí o no | noul (0.01 a 0.99), confidence |
Una sola solicitud puede incluir hasta 1.000 preguntas sobre la misma entrada. Según la documentación de la Decisions API, las preguntas se evalúan en una sola pasada hacia adelante (forward pass) y de forma aislada, por lo que añadir una pregunta no altera las respuestas de las demás. Google sitúa la latencia de extremo a extremo entre 150 y 250 ms, manteniéndose prácticamente plana desde 1 hasta 100 preguntas.
Si leíste nuestro artículo sobre Jev y las capas de decisión para agentes de programación, la estructura te resultará familiar. La diferencia aquí es práctica: un modelo alojado por Google, tres preguntas definidas explícitamente y la integración directa con un tablero.
La llamada de enrutamiento: tres preguntas por tarea
Aquí tienes el enrutador. Requiere google-genai 3.2 o posterior y una GEMINI_API_KEY de Google AI Studio.
import json
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

AGENTS = {
    "backend": "Server code, APIs, database migrations, and backend tests.",
    "frontend": "UI components, styling, client state, and frontend tests.",
    "docs": "README files, docs pages, and changelogs. No code changes.",
    "other": "Work that fits none of the options above.",
}

DIFFICULTY = [
    "Trivial: one file, obvious change, no design decision.",
    "Routine: a few files, follows a pattern already in the repo.",
    "Involved: several modules or a new pattern, needs new tests.",
    "Hard: cross-cutting, touches auth or data migrations, or the spec is thin.",
]

def ask(task):
    state = json.dumps({
        "title": task["title"],
        "description": task["description"][:8000],
    })
    result = client.decisions.create(
        model="gemini-decision-1",
        input=state,
        questions={
            "agent": {
                "type": "choice",
                "instructions": "Which agent should take the task in `title` and `description`?",
                "criteria": AGENTS,
            },
            "difficulty": {
                "type": "score",
                "instructions": "How hard is this task for a coding agent working alone?",
                "criteria": DIFFICULTY,
            },
            "needs_human": {
                "type": "noul",
                "instructions": "Does a person need to make a decision before any agent starts?",
                "criteria": {
                    "true_description": "The spec is ambiguous, contradicts itself, or asks for a product, security, or pricing call.",
                    "false_description": "The spec is clear enough to implement as written.",
                },
            },
        },
    )
    return result.answers
Cuatro detalles de este código provienen directamente de la documentación y son fáciles de pasar por alto.
El modelo nunca ve tus claves. Solo lee instructions y criteria, así que redacta la pregunta completa en instructions y describe cada opción.
Las claves de las opciones se ordenan alfabéticamente. La API ordena las claves de selección según el orden de bytes UTF-8 antes de evaluarlas. Por esta razón, la opción genérica es other y no none_of_the_above, ya que esta última se posicionaría antes que las opciones reales.
Los niveles de puntuación deben ser lineales. El score devuelto es un promedio ponderado por probabilidad de los índices de cada nivel (aquí de 0 a 3). Asegúrate de que los niveles adyacentes sean claramente diferenciables.
Envía únicamente lo que las preguntas necesitan. La documentación advierte que el contenido irrelevante reduce la precisión. El título y la descripción suelen funcionar mucho mejor que incluir todo el hilo de comentarios.
Define el umbral de confianza a partir de tus propias tareas
El valor de la respuesta indica qué hacer; la confianza determina si conviene hacerlo sin intervención humana. En una respuesta de tipo choice, la confianza equivale a la probabilidad de la opción principal. En una de tipo noul, es max(noul, 1 - noul).
Esta es la capa de decisión:
AUTO = 0.75      # assign without a person above this
HARD = 2.4       # difficulty score that earns the strong-model Agent

def decide(a):
    if a["needs_human"].noul >= 0.5:
        return ("human", "needs a decision first")
    if a["agent"].choice == "other" or a["agent"].confidence < AUTO:
        return ("human", f"router unsure ({a['agent'].confidence:.2f})")
    tier = "strong" if a["difficulty"].score >= HARD else "default"
    return (f"{a['agent'].choice}-{tier}", "auto")
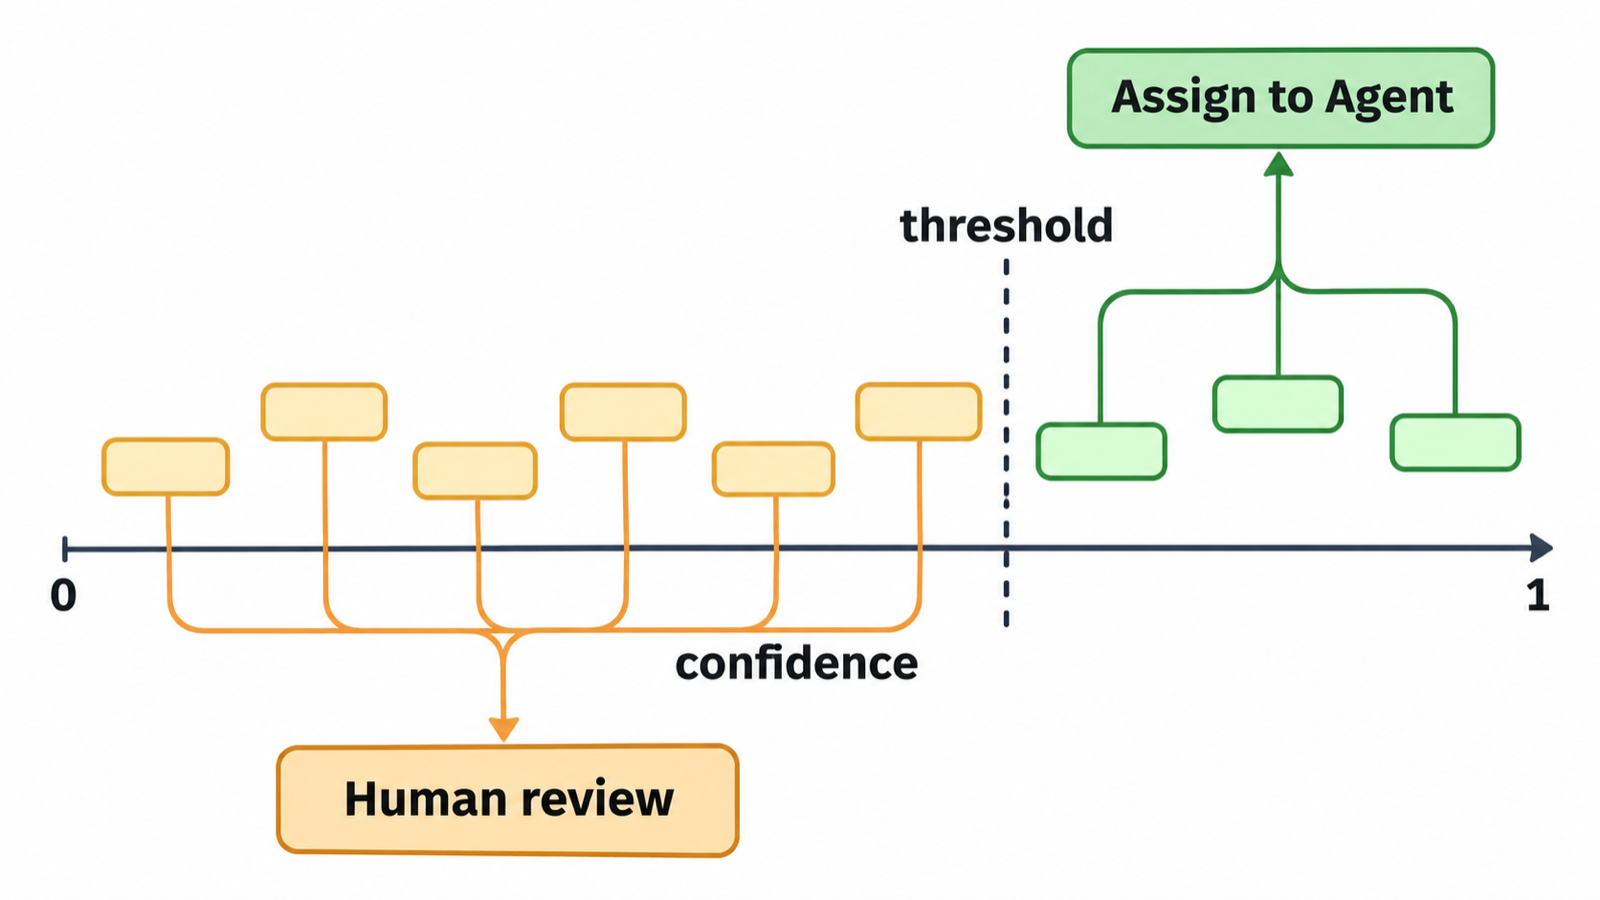
No copies el 0.75 a ciegas. La recomendación de Google es calibrar los umbrales usando ejemplos etiquetados de tu propio flujo de trabajo. Toma entre 50 y 100 de tus tareas cerradas más recientes, anota qué agente completó cada una y pásalas por ask(). Elige el umbral más bajo con el que las tareas enrutadas automáticamente coincidan con las decisiones de tu equipo. Un enrutamiento erróneo cuesta una ejecución fallida y una reasignación; una retención humana innecesaria cuesta unos pocos minutos. Sopesa ambos factores entre sí, en lugar de fijar un número redondo arbitrario.
Dos trampas a tener en cuenta: la probabilidad de un noul nunca supera 0.99, por lo que una comprobación como > 0.99 jamás se cumplirá. Y un score de 1.5 puede significar tanto «dividido entre los niveles 1 y 2» como «indeciso entre los cuatro». Cuando la precisión sea crítica, consulta también probabilities.
Conecta el enrutador a un tablero de Sharkly
El enrutador está escrito en Python estándar, por lo que puede ejecutarse en cualquier entorno. En un tablero de Sharkly, el disparador más limpio es el momento en que una tarea pasa a estar lista para trabajar.
1. Crea un agente por carril y nivel. Por ejemplo backend-default, backend-strong, frontend-default. Según la documentación de agentes de Sharkly, cada agente utiliza por defecto el modelo de su entorno de ejecución (Runtime), y la fila Model te permite elegir otro modelo del catálogo de ese Runtime. Ahí es donde la dificultad se traduce en la elección del modelo.
2. Aplica la decisión mediante la CLI de sharkly.
import subprocess

def apply(task_id, target, reason, a):
    note = (f"Router: agent={a['agent'].choice} ({a['agent'].confidence:.2f}), "
            f"difficulty={a['difficulty'].score:.1f}, "
            f"needs_human={a['needs_human'].noul:.2f}")
    if target == "human":
        subprocess.run(["sharkly", "task", "comment", task_id,
                        "--body", f"{note}. Held for a person: {reason}."], check=True)
        return
    subprocess.run(["sharkly", "task", "edit", task_id,
                    "--delegate-agent", target], check=True)
    subprocess.run(["sharkly", "task", "comment", task_id, "--body", note], check=True)
Asignar un agente inicia su ejecución una vez que la tarea pasa al estado «ready». Dejar asentadas las probabilidades en un comentario es más importante de lo que parece: es lo que te permitirá auditar el comportamiento del enrutador dentro de un mes.
3. Actívalo ante un cambio de estado. Una automatización (Automation) de Sharkly almacena instrucciones, un agente asignado y disparadores. Dale a un pequeño Router Agent la instrucción «ejecuta route.py en la tarea que te activó» y luego agrega un disparador de estado de tarea para el estado que tu equipo utilice como «ready». Las ejecuciones iniciadas por este disparador quedan vinculadas a dicha tarea, manteniendo el registro de enrutamiento junto con el trabajo. Desde la CLI:
sharkly automation trigger create <automation-id> --kind task_event --to-status "Ready"
Cuánto cuesta una llamada de enrutamiento
Gemini Decision 1 cuesta 0,10 $ por cada millón de tokens de entrada y 0 $ por los de salida, según el artículo de presentación de Google. La entrada compartida se factura una sola vez por solicitud, sin importar cuántas preguntas hagas.
| Elemento | Tokens (estimación) |
|---|---|
| Título y descripción de la tarea | 2.000 |
| Tres preguntas con criterios | 300 |
| Total por llamada de enrutamiento | 2.300 |
| 1.000 tareas enrutadas | 2,3 M, aprox. 0,23 $ |
El enrutador cuesta menos que una sola ejecución de un agente en una tarea. Además, Google ofrece un nivel gratuito en AI Studio para crear prototipos.
Límites que debes conocer antes de implementarlo
La API se lanza como v1beta en la Gemini Developer API, figurando Gemini en Google Cloud como «próximamente». La documentación indica que no admite almacenamiento en caché de contexto (context caching), la Batch API ni inferencia Flex o Priority, por lo que las entradas repetidas se contabilizan completas en cada llamada. Los límites de velocidad por nivel se detallan en la página de límites de velocidad de Google; revísalos antes de enrutar todas las tareas con una única clave de API.
Trata las descripciones de las tareas como entradas no confiables. La documentación advierte que el texto suministrado por los usuarios puede intentar condicionar su propia clasificación. Si personas externas a tu equipo pueden crear tareas, mantén la retención para revisión humana en todo lo que afecte autenticación, pagos o datos de producción, sin importar lo que decida el enrutador.
Los resultados de referencia publicados por Google (el menor error de calibración de toda su suite y casi cinco veces más económico que Gemini 3.5 Flash-Lite a través de la Interactions API) son cifras de Google. Las tareas etiquetadas de tu propio equipo son el único punto de referencia que realmente cuenta.
Cuándo una llamada de enrutamiento no es la herramienta adecuada
Utiliza una llamada a Decisions cuando las tareas lleguen más rápido de lo que una persona puede clasificarlas y las opciones estén predefinidas: un conjunto de agentes, un conjunto de niveles, un filtro de sí/no. Emplea una regla simple cuando una etiqueta ya determine el destino: si cada tarea etiquetada como docs va al agente de documentación, una instrucción if es más económica y no fallará nunca.
En cambio, recurre a un modelo generativo cuando necesites que el enrutador explique sus motivos en texto, reescriba la especificación o divida la tarea en subtareas. La Decisions API devuelve números, no texto. Para repartir el trabajo entre varios roles, resulta más apropiado un Crew cuyo líder descomponga el objetivo principal; consulta enrutamiento de modelos para Crews de agentes.
Conclusión
El enrutamiento es una decisión de conjunto cerrado, y la Gemini Decisions API fue creada precisamente para eso: una sola llamada, respuestas tipadas, una puntuación de confianza sobre la que aplicar umbrales y un coste que se mide en fracciones de centavo. El trabajo restante está de tu lado: redacta descripciones claras para cada opción, calibra el umbral con tus propias tareas cerradas y deriva los casos de baja confianza a una persona.
Comienza con un solo carril. Enruta las nuevas tareas de backend durante una semana, compara las elecciones del enrutador con lo que habría hecho tu equipo y luego amplía el alcance. Si deseas probar el enrutador en un tablero real con agentes, automatizaciones y revisión humana en un solo lugar, consulta cómo empezar con Sharkly.
Preguntas frecuentes
¿Qué es la Gemini Decisions API?
Es un endpoint de la API de Gemini, lanzado el 11 de noviembre de 2026, que responde a preguntas de tipo sí/no, selección (choice) y puntuación (score) sobre texto, imágenes, audio, vídeo o archivos PDF. Devuelve probabilidades calibradas y niveles de confianza en lugar de texto generado, utilizando el modelo gemini-decision-1.
¿Cuánto cuesta Gemini Decision 1?
Google indica un precio de 0,10 $ por cada millón de tokens de entrada y 0 $ por los tokens de salida, facturándose la entrada compartida una sola vez por solicitud. También existe un nivel gratuito en Google AI Studio para crear prototipos.
¿Cuántas preguntas se pueden incluir en una sola solicitud?
Entre 1 y 1.000, con un límite fijado por una ventana de contexto de 262.144 tokens que abarca tanto la entrada como todas las preguntas. Las preguntas de tipo opción múltiple (choice) admiten entre 2 y 255 opciones.
¿Qué umbral de confianza debo utilizar para el enrutamiento?
No existe un número universal. Google recomienda definir los umbrales a partir de ejemplos etiquetados de tu propio tráfico. Vuelve a procesar entre 50 y 100 tareas cerradas y elige el umbral en el que las decisiones automáticas coincidan con las de tu equipo.
¿Puede la Decisions API elegir qué modelo utiliza un agente?
De forma indirecta. Puedes formular una pregunta de tipo score para evaluar la dificultad y luego asignar las puntuaciones altas a un agente configurado con un modelo más potente. En Sharkly, cada agente puede vincularse a un modelo del catálogo de su Runtime.
¿Está disponible la Gemini Decisions API en Vertex AI?
Todavía no. El artículo de lanzamiento de Google menciona que la compatibilidad con Gemini en Google Cloud llegará próximamente. Actualmente se ejecuta en la Gemini Developer API como v1beta.

