
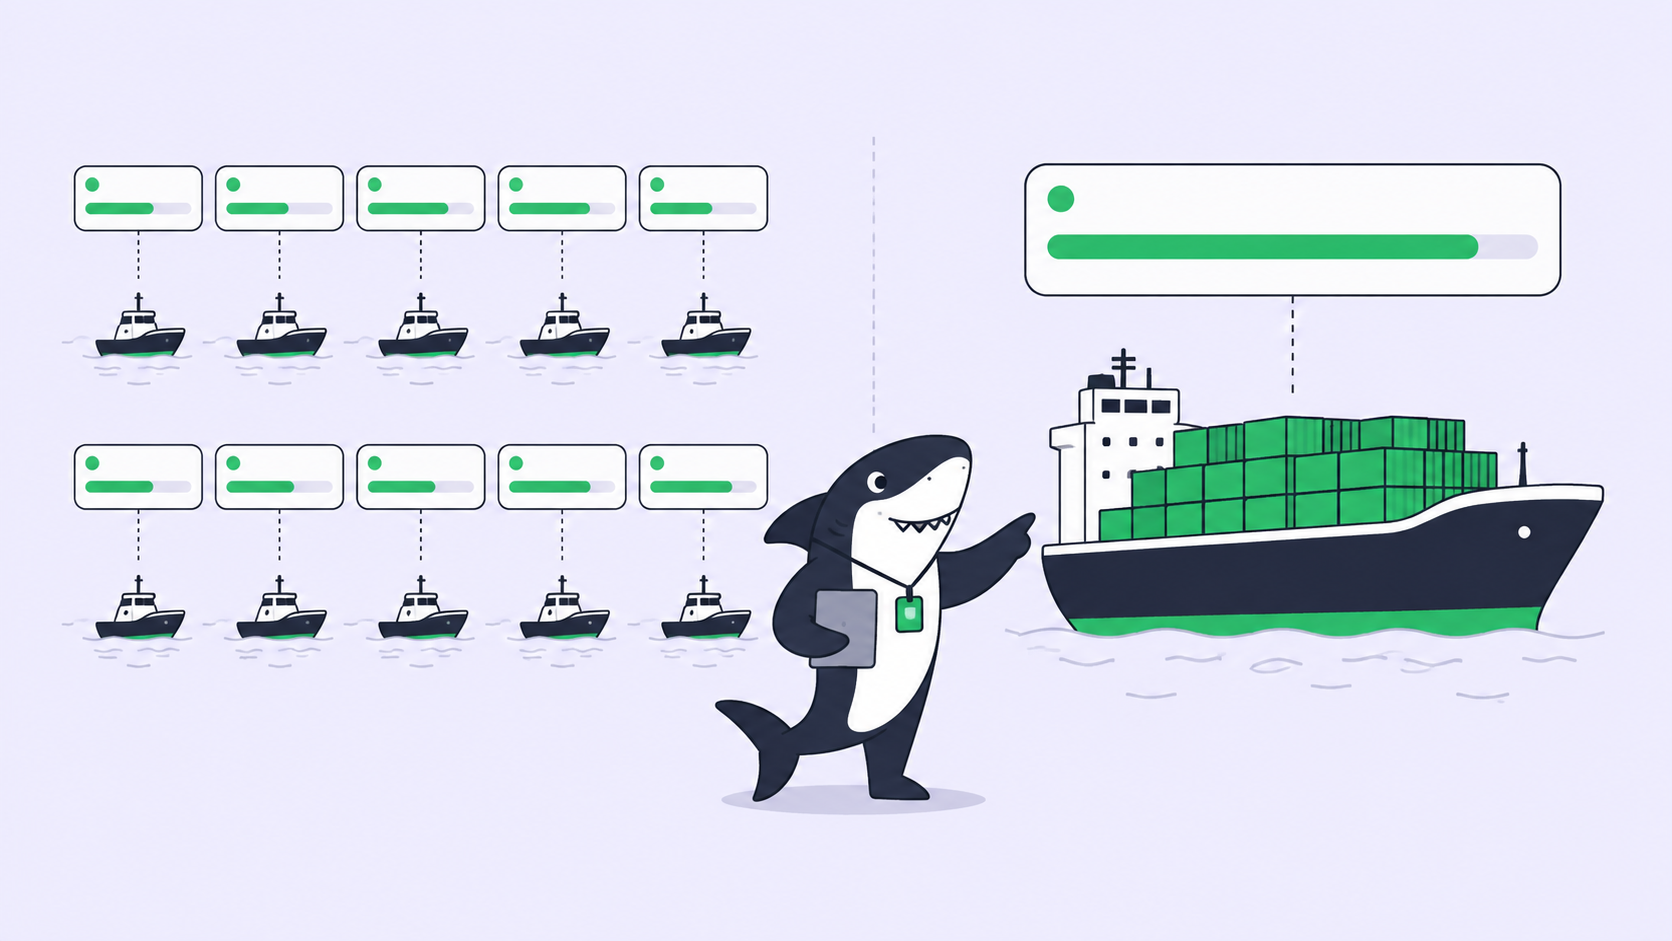
Tienes un número fijo de revisores y, desde el 22 de septiembre de 2026, una factura de modelos que ya no decide nada por ti. GPT-6 Luna se anuncia a 0,10 $ por millón de tokens de entrada y 0,50 $ por millón de salida, con id de API gpt-6-luna. Claude Opus 5.5 se anuncia a 4 $ y 20 $, con id de API claude-opus-5-5. Eso supone una diferencia de 40 veces a ambos lados del contador, según nuestros cálculos a partir de los precios de lista de los propios proveedores, y convierte una pregunta que antes era teórica en una decisión de planificación semanal. Por el mismo dinero, ¿ejecutas diez agentes baratos o uno caro?
Las dos configuraciones no son intercambiables. Lo que las separa no es la calidad del modelo, y se nota al final de la ejecución, no al principio: cada una pone una cantidad distinta de trabajo delante de una persona.
La aritmética que hace que la pregunta siga viva
OpenAI publica el coste por tarea junto a la puntuación, lo cual resulta más útil que una lista de precios. En DeepSWE 1.1, Luna con el máximo esfuerzo de razonamiento obtiene un 66,6 %, que OpenAI describe como comparable a Claude Opus 5 y Fable 5 con esfuerzo medio, con un coste por tarea un 93 % inferior al de Opus 5 y un 96 % inferior al de Fable 5.
Si despejamos a partir de la primera cifra, una tarea de Opus 5 equivale a unas catorce tareas de Luna. Por lo tanto, diez ejecuciones de Luna cuestan aproximadamente siete décimas de una sola ejecución de Opus 5 en ese harness. Esa multiplicación es nuestra, a partir del 93 % que declara OpenAI.
Anthropic afirma que ejecutar Opus 5.5 cuesta un 40 % menos que Opus 5. Si aplicamos ese dato, la proporción baja hasta cerca de nueve a uno. Esa cifra encadena mediciones de dos proveedores distintos, tomadas con harnesses diferentes, así que tómala como una orientación y no como un número exacto: diez intentos baratos y un intento caro cuestan ahora más o menos lo mismo, se calcule como se calcule.
| GPT-6 Luna | Claude Opus 5.5 | |
|---|---|---|
| Id de API | gpt-6-luna |
claude-opus-5-5 |
| Entrada / salida por 1M | 0,10 $ / 0,50 $ | 4 $ / 20 $ |
| Entrada en caché | 90 % de descuento en lecturas | 0,20 $ lectura, 5 $ escritura |
| Ventana de contexto | 1M | 1M |
| Afirmación del proveedor sobre horizonte largo | ninguna declarada | se mantiene en la tarea 18 horas o más |
| Índice de Artificial Analysis | 37 | 58, clasificado n.º 1 de 212 |
Hay dos advertencias que acompañan a esa tabla. El titular de OpenAI es que Sol y Luna son cada uno un 50 % más baratos que el precio promocional de GPT-5.6, y “promocional” es palabra de la propia OpenAI: la comparación se hace contra una tarifa con descuento, no contra el precio de lista. Y las dos publicaciones de lanzamiento no son una comparación cara a cara. Ambos proveedores publican una puntuación de AutomationBench, con versiones de harness y niveles de esfuerzo distintos, el mismo día. Meter esos dos porcentajes en una misma fila daría lugar a una comparación que ningún laboratorio llevó a cabo. Las proporciones de coste por tarea anteriores se mantienen porque proceden de la medición de un único proveedor.
Tres configuraciones que parecen una sola disyuntiva
“Diez agentes o uno” son en realidad tres disposiciones distintas, y se comportan de forma diferente en el paso de revisión.
| Configuración | Qué llega a la revisión | Quién elige al ganador | Funciona cuando |
|---|---|---|---|
| Diez agentes baratos, diez tareas | Diez diffs, diez decisiones | Una persona, diez veces | El backlog es amplio y cada elemento es aceptable de forma independiente |
| Diez agentes baratos, una tarea | Un diff, una decisión | Tu suite de tests | Una máquina puede clasificar los intentos sin que nadie los lea |
| Un agente caro, una tarea | Un diff, una decisión | Una persona, una vez | Horizonte largo, señal automática débil o un cambio que exige criterio en todo momento |
La fila central es la que realmente desbloquea la rebaja de precios, y es la que la mayoría de los equipos se salta. Ejecutar la misma tarea diez veces y quedarse con el intento que supera el typecheck, los tests y el build es una estrategia que solo se volvió asequible cuando un intento dejó de costar dinero real. Con una tasa de éxito en el benchmark cercana a dos tercios, un tercio de los intentos individuales fracasa. Si los intentos fallaran de forma independiente, diez intentos casi nunca fallarían todos. No fallan de forma independiente: una tarea con un requisito ambiguo o una fixture que falta derrota a todos los intentos de la misma manera. El fan-out te compra la varianza, no una garantía.
La primera fila es la que la mayoría de los equipos elige en la práctica, y es la cara. No en dólares. Diez agentes sobre diez tareas producen diez diffs, y cada uno de ellos necesita que una persona lo lea, entienda qué eligió el agente y asuma la responsabilidad de fusionarlo. Ese coste no bajó el 22 de septiembre de 2026 y ninguna publicación de modelo lo toca. Hemos escrito sobre por qué la revisión humana es el cuello de botella en el trabajo con agentes en paralelo y sobre cuántos días de trabajo de agente puede absorber un día de trabajo humano; la aritmética de ahí no cambia por tener tokens más baratos.
Diez agentes con Luna no son diez veces más producción. Son diez veces más trabajo entrante. Un modelo más barato compra intentos. No compra capacidad de revisión, y es fácil confundir ambas cosas cuando la factura es el único número que se mira.
El coste por cambio aceptado es la cifra que se puede trasladar
El coste por cambio aceptado es lo que tu equipo gasta en inferencia por cada diff que una persona lee y acepta de verdad. Es la única cifra de coste de agentes que conecta con el trabajo entregado, porque un intento que nadie revisa no ha entregado nada.
Esa definición ordena las tres configuraciones de inmediato. El fan-out sobre una tarea reparte diez intentos entre una sola decisión de revisión, así que unos intentos más baratos reducen el coste por cambio aceptado en línea recta. La amplitud sobre diez tareas reparte un intento entre una decisión de revisión diez veces, así que unos intentos más baratos reducen la línea de inferencia mientras la línea de revisión se mantiene plana y pasa a ser la restricción. La profundidad sobre un agente caro aumenta la probabilidad de que el único intento que llega a tu revisor sea el que merece la pena fusionar.
Hay un segundo efecto que solo se manifiesta en la práctica. Trabajar con diez intentos baratos y con un intento caro no se siente igual. Artificial Analysis mide las variantes de razonamiento máximo de estos modelos en 124,23 segundos hasta el primer token para Luna y 102,15 segundos para Sol, cifras de terceros específicas de las variantes max y que conviene confirmar antes de planificar en torno a ellas. Diez agentes que pasan dos minutos en silencio antes de producir un solo carácter no son un pipeline rápido. Son diez ejecuciones que parecen colgadas a la vez, lo cual es un problema de estado y no un problema del modelo.
El par de decisiones
Usa diez agentes baratos cuando decide una máquina. Eso significa que la tarea tiene una señal de aceptación real que se ejecuta sin una persona: un test que hoy falla y debe pasar, un typecheck, un build, una regla de lint, un script de reproducción. El triaje, el etiquetado, el andamiaje de tests y los refactors mecánicos cumplen ese requisito. También cualquier cambio en el que “¿funcionó?” sea un comando y no una opinión.
Usa un agente caro cuando decide una persona. Si aceptar el cambio exige leer el código y formarse una opinión, los intentos adicionales no ayudan, multiplican la lectura. Lo mismo vale para el trabajo de horizonte largo: Anthropic afirma que Opus 5.5 se mantiene en la tarea durante 18 horas o más, y una ejecución que sostiene un objetivo a lo largo de una tarde vale más que diez ejecuciones que reinician cada una desde la misma comprensión parcial.
No uses el fan-out para evitar escribir la señal de aceptación. Diez diffs plausibles sin un juez automático son peores que un solo diff, porque elegir entre diez diffs plausibles es un trabajo más difícil que revisar uno, y es un trabajo que recae sobre la persona a la que intentabas proteger.
Qué necesita la configuración amplia de la capa superior
Diez agentes ejecutándose a la vez es un problema de coordinación antes que un problema de coste. Las piezas son conocidas: cada ejecución en su propio worktree para que dos agentes editando el mismo archivo no sean un incidente, un único Assignee por tarea para que la responsabilidad nunca sea ambigua, y un estado que distinga en ejecución de en espera y de fallido.
El agente define cómo debe gestionarse el trabajo. El ordenador proporciona el host y los recursos locales. El runtime ejecuta la sesión. La tarea sigue siendo el registro compartido. Cuando diez ejecuciones terminan con una hora de diferencia entre ellas, esa última parte es lo que evita que esa hora se convierta en una búsqueda del tesoro por diez terminales.
Una ejecución de Luna terminada debería devolver algo así a su tarea, y no a un registro de sesión privado:
SH-312  Add retry with backoff to the webhook dispatcher
Runtime   gpt-6-luna (fan-out, 8 attempts, 3 passed the suite)
Selected  attempt 6, smallest diff of the passing set
Evidence  typecheck ok, 214 tests pass, build ok, coverage +0.4%
Known limit  no test for the 429 path, dispatcher is not idempotent yet
Status    Ready for review, waiting on a human
La línea de selección es la parte que importa. Dice qué decidió, de modo que el revisor sabe si está confirmando la elección de una máquina o tomando él la decisión. Diez intentos sin un registro de selección son diez veces el trabajo disfrazado de una sola tarea.
La respuesta
Diez agentes baratos entregan más cuando decide una suite y el backlog es lo bastante amplio para mantenerlos ocupados. Un agente caro entrega más cuando la decisión de aceptación es humana, el horizonte es largo o la señal automática es débil. La mayoría de los equipos quiere ambas cosas, enrutadas según el tipo de tarea y no según las preferencias, que es el argumento de asignar modelos a roles de agente.
Ninguna de las dos configuraciones cambia el último paso. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, otorgan autoridad y aceptan el resultado. Los precios de los modelos se movieron 40 veces en un día, y el número de cambios que tu equipo puede aceptar de forma responsable no se movió lo más mínimo.
Si ya ejecutas varios agentes, Sharkly te ofrece un único lugar donde mantener el contexto, el progreso, los bloqueos, los resultados y la revisión humana a la vista desde la solicitud hasta la entrega, sea cual sea el runtime que produjo el diff.


