

Lanzas tres ejecuciones antes de comer. Noventa segundos después, dos de los tres terminales no han impreso absolutamente nada. Uno de ellos está razonando sobre el repositorio. Otro se topó con un 504 de salida y no va a volver jamás. Desde donde estás sentado, los tres son el mismo rectángulo de scrollback con un cursor dentro.
No es un problema nuevo, pero los lanzamientos del 22/09/2026 lo empeoraron de una forma concreta y medible. Los ajustes de razonamiento más altos de los nuevos modelos compran precisión pensando durante mucho tiempo antes de decir nada. Artificial Analysis cronometró la variante de razonamiento «max» de GPT-6 Sol en 102,15 segundos hasta el primer token, y la de GPT-6 Luna en 124,23 segundos. Son mediciones de terceros sobre una configuración concreta, no cifras del proveedor, y esa salvedad importa, pero la dirección no admite dudas: el silencio al inicio de una ejecución ya es lo bastante largo como para resultar indistinguible de un fallo.
TL;DR
El tiempo hasta el primer token es el retraso entre enviar una petición y la llegada del primer carácter de la respuesta, y en un modelo de razonamiento de alto esfuerzo ese retraso es donde ocurre la mayor parte del pensamiento. Un terminal no puede distinguirte entre una ejecución que está pensando, una que espera a una persona y otra que murió hace dos minutos, porque las tres no imprimen nada. Un estado sí puede. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, otorgan autoridad y aceptan el resultado. Lo que ese contrato necesita para funcionar es un estado de ejecución visible sin que haya alguien vigilándolo: Sharkly mantiene el contexto, el progreso, los bloqueos, los resultados y la revisión humana en la Task desde la petición hasta la entrega, para que un pensamiento largo y una ejecución muerta dejen de parecerse.
La espera se alargó, y el modelo barato no es el rápido
Esto es lo que dicen las mediciones de terceros sobre los dos nuevos modelos GPT-6 en su ajuste de razonamiento máximo.
| Model | API id | Output speed | Time to first token | Input / output per 1M tokens |
|---|---|---|---|---|
| GPT-6 Sol (max) | gpt-6-sol |
115.2 tokens/s | 102.15s | $2 / $10 |
| GPT-6 Luna (max) | gpt-6-luna |
153.9 tokens/s | 124.23s | $0.10 / $0.50 |
Lee las dos últimas columnas juntas. Luna cuesta una vigésima parte que Sol por token y te hace esperar más antes de hablar. El coste y la latencia son ejes distintos, y la intuición de que un modelo más barato es un modelo más ágil aquí es sencillamente falsa.
Dos matices honestos antes de que nadie construya un panel sobre esas cifras. Primero, provienen de Artificial Analysis y no de OpenAI, y describen específicamente las variantes de razonamiento «max». Los ajustes de esfuerzo inferiores son otro animal, y tus propias cifras variarán según el tamaño del prompt, la disponibilidad de herramientas y dónde acabe tu tráfico. Segundo, el tiempo hasta el primer token no es la misma medición que la velocidad de salida. Anthropic afirma que Claude Opus 5.5 produce salida un 30 % más rápido que Opus 5, lo cual es una afirmación sobre los tokens posteriores al primero. Un modelo puede transmitir rápido y, aun así, dejarte mirando la nada durante minuto y medio.
Un terminal en silencio no es un estado
El silencio en un terminal tiene al menos cuatro causas, y el terminal las representa todas de forma idéntica:
- El Runtime está trabajando. Hay razonamiento en curso, todavía sin salida.
- La ejecución terminó hace un rato y espera que una persona responda a una pregunta.
- La petición falló. La documentación de Sharkly es tajante sobre lo fácil que es malinterpretar este caso: «Timeout / 408 / 504 significa que la petición fue lenta, se canceló o un gateway la retrasó. Eso no es lo mismo que decir que el Computer esté desconectado».
- El Computer realmente ya no está, o el directorio que la ejecución necesitaba nunca quedó libre.
Un agente, un terminal, y esto lo resuelves esperando otro minuto. Cinco agentes repartidos entre tres repositorios y dos Computers, y lo resuelves saltando entre ventanas y adivinando. Esa es la forma habitual del caos de agentes: no un fallo dramático, solo un equipo que dedica su atención a la pregunta «¿este sigue vivo?» varias veces por hora.
El reflejo al que la gente recurre es matarlo y volver a ejecutarlo. Con un esfuerzo de razonamiento alto, ese reflejo es caro por partida doble. Pagas otra vez toda la espera hasta el primer token y tiras el pensamiento que estaba a punto de llegar.
Lo que un estado tiene que separar
El modelo propio de Sharkly merece la pena copiarlo, uses Sharkly o no, porque separa dos cosas que un terminal funde en una. Es la misma división que hace que el estado de ejecución, los logs y las señales de fallo sean legibles. Una ejecución tiene un estado de ejecución: Queued, Dispatched, Waiting for local directory, Running, Completed, Failed o Canceled. Una Task tiene un estado de ciclo de vida, y un Agent tiene encima un estado de trabajo: Working, Waiting for human reply, Waiting for human review o Error. La documentación define la frontera con claridad: estos estados de ejecución «no implican automáticamente que la Task tenga el mismo estado de flujo de trabajo».
Esa división es la respuesta completa a la pregunta de si está atascado o pensando.
| What the terminal shows | What it may actually be | What tells them apart | Who acts next |
|---|---|---|---|
| Nothing, 100s in | Running, pre-first-token | Run state is Running, log has a dispatch timestamp | Nobody. Leave it. |
| Nothing, 10 min in | Waiting for human reply | Working state changed, Task raises an attention item in Inbox | The Assignee answers in context |
| Nothing, forever | Failed | Run state is Failed, execution log carries the title and the original model-service response | The Assignee reads the log before retrying |
| Nothing, never started | Queued or Waiting for local directory | Run state, plus which directory pool is busy | Free a directory or raise parallel capacity |
Ninguna de esas cuatro filas exige que haya una persona mirando en el momento en que cambia. Esa es la cuestión. El estado queda registrado, y la pregunta «¿está pensando o está atascado?» pasa a ser algo que consultas en lugar de algo que aguantas sentado.
El timeout por Task que configuraste en marzo
Un Agent en Sharkly lleva un número máximo de Tasks en ejecución en paralelo y un timeout por Task. La mayoría de los equipos configura ese timeout una vez, al principio, en función de cuánto estaban dispuestos a mirar fijamente un terminal. Si ese número son dos minutos y desde entonces has pasado un Agent a un ajuste de razonamiento máximo, tienes configurada una política que cancela ejecuciones durante la fase de pensamiento y las reporta como fallos.
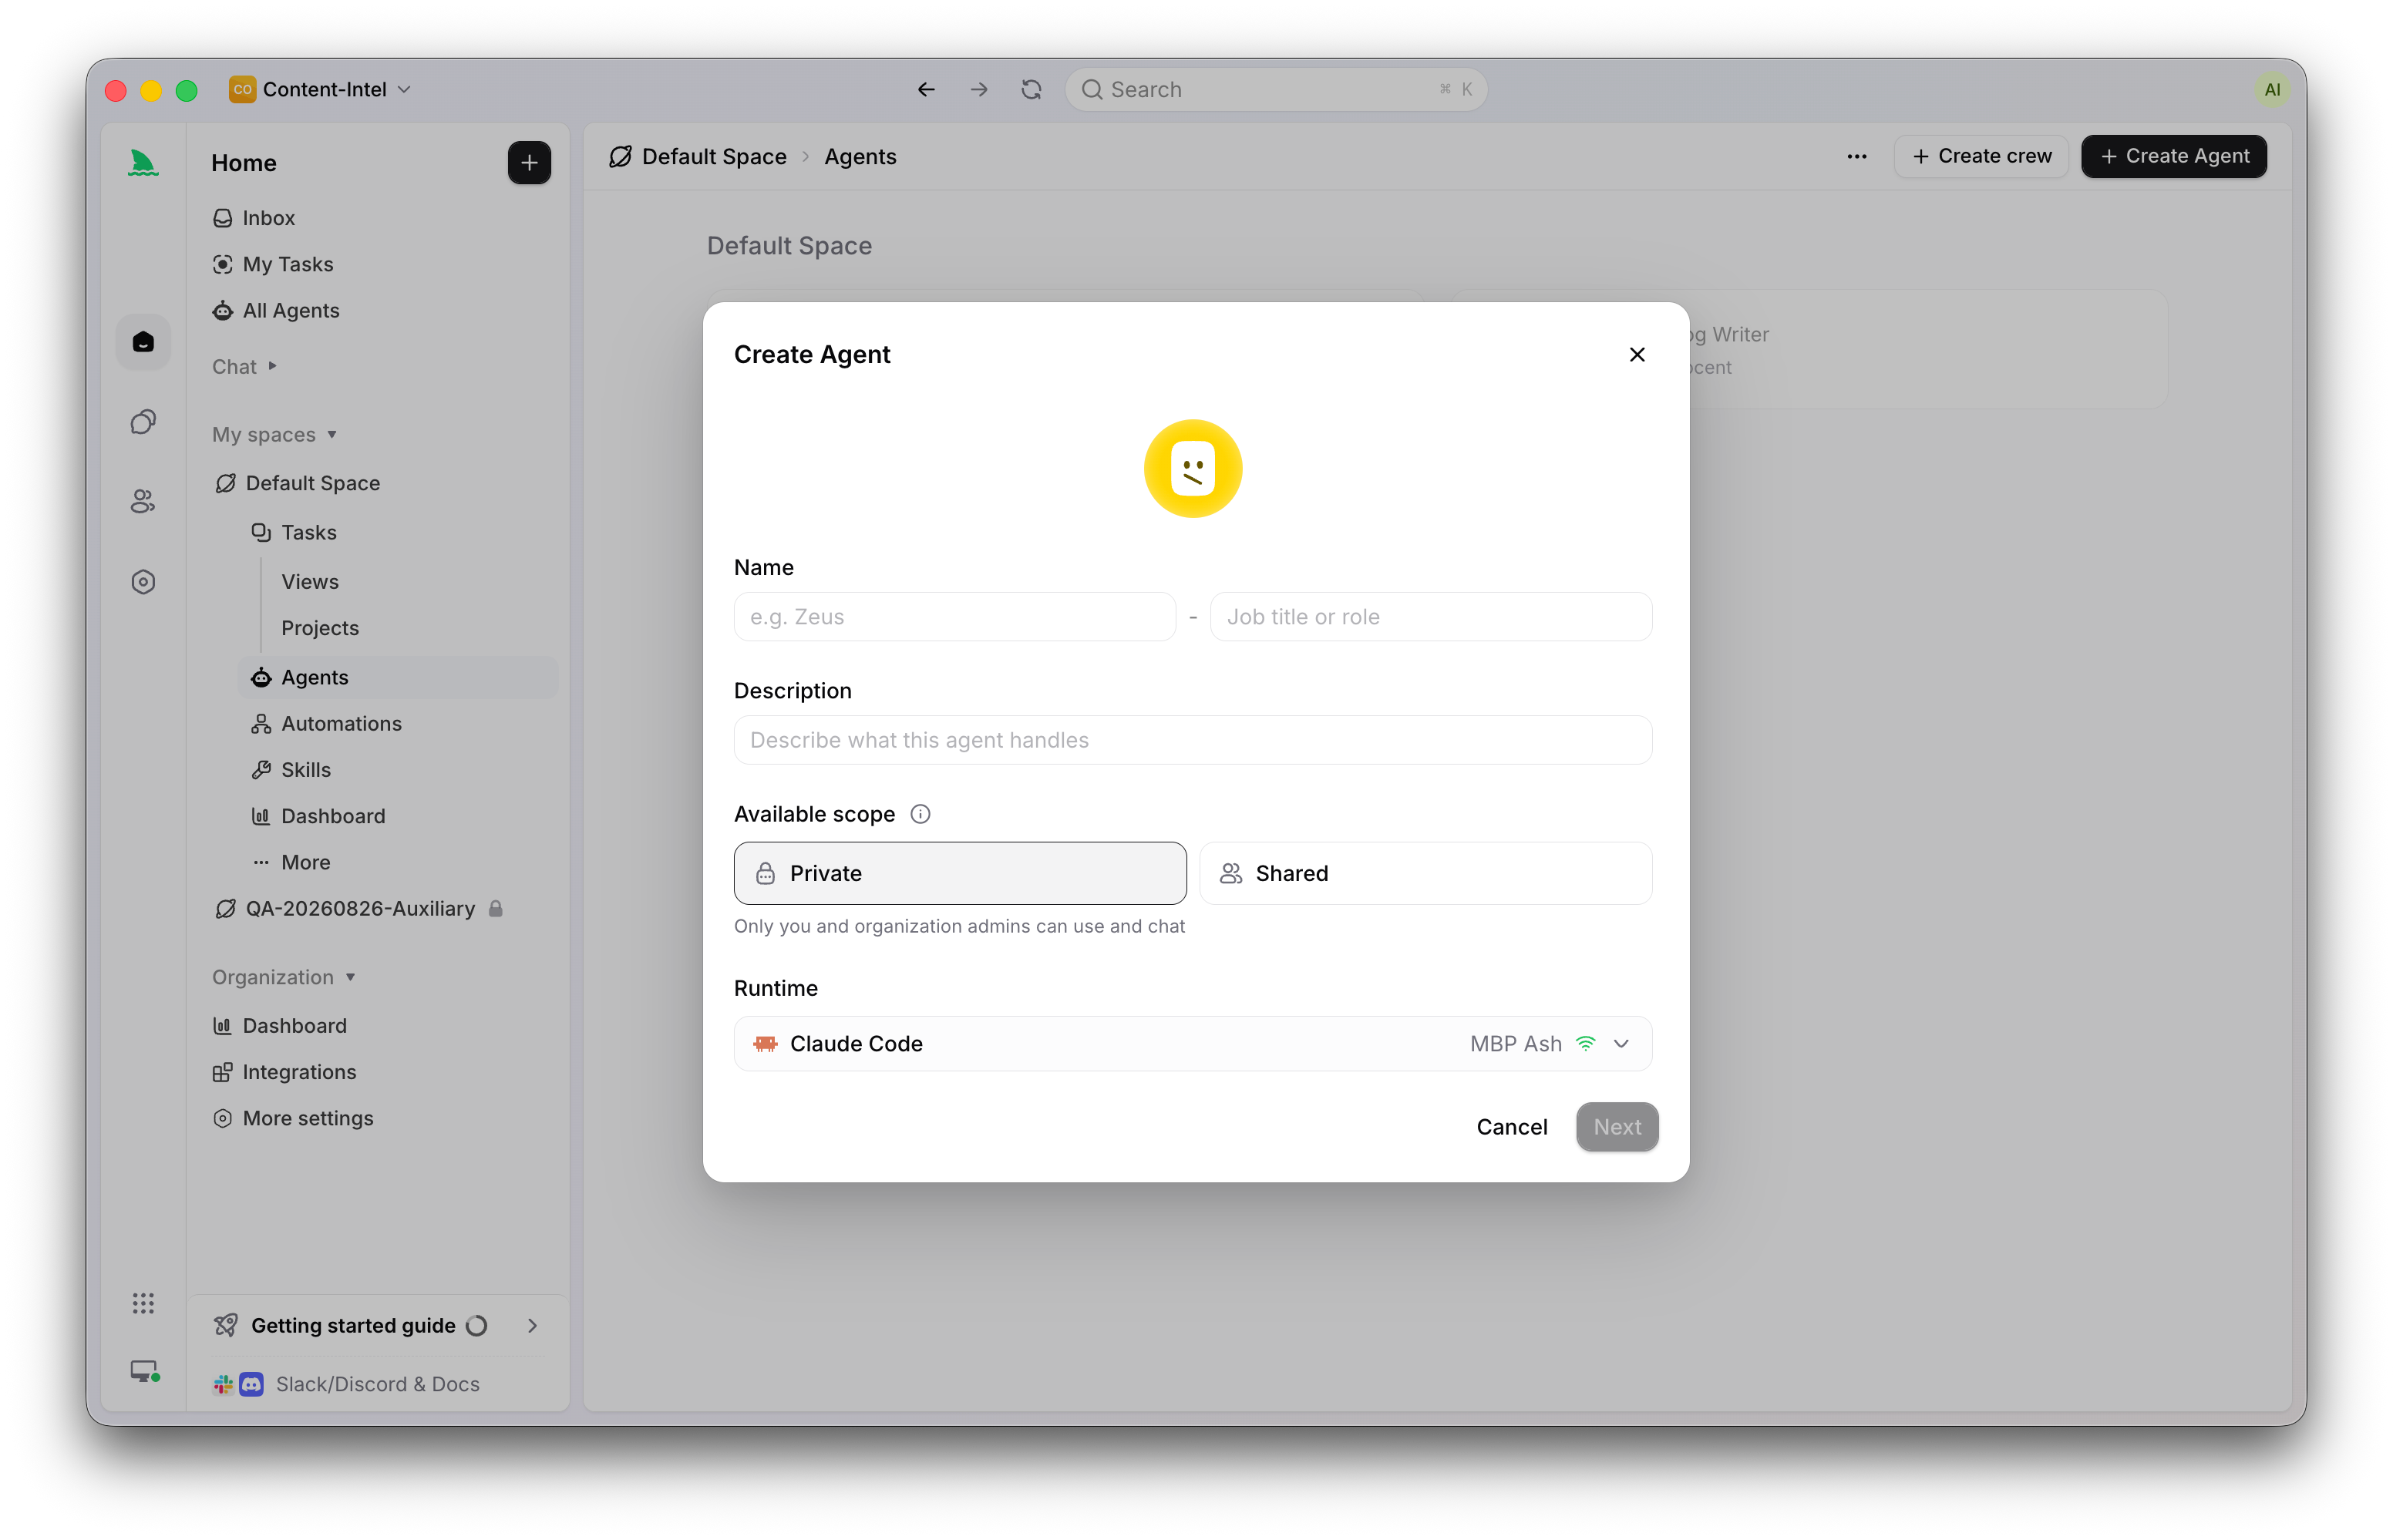
Ve a mirar el tuyo esta semana. El suelo no es «cuánto estoy dispuesto a esperar», sino «cuánto tarda este Runtime en el nivel de esfuerzo que realmente uso, más el trabajo en sí». Para una ejecución cuyo primer token por sí solo puede tardar más de cien segundos, un timeout por debajo de cinco minutos es una moneda al aire disfrazada de política.
Hay dos ajustes relacionados que merecen la misma revisión. El máximo de Tasks en ejecución en paralelo es tu límite real de concurrencia, y cuando todos los directorios configurados están ocupados, las nuevas ejecuciones se quedan en Waiting for local directory en lugar de fallar, lo cual es el comportamiento correcto, pero parece un cuelgue si solo estás mirando un terminal.
¿Lo arregla el caché?
En parte, y no en la parte que te interesa. El prompt caching de OpenAI para GPT-6 ofrece un 90 % de descuento en lecturas de entrada en caché, con tasas de acierto mayores por defecto, añade breakpoints explícitos para que tú elijas dónde termina un prefijo cacheado y ya no rompe la caché cuando cambias el esfuerzo de razonamiento o la disponibilidad de herramientas. GitHub informa de más de un 50 % menos de tokens de prompt que necesitan procesamiento nuevo en miles de millones de peticiones. Es una victoria real de coste y latencia sobre el prompt, y el arreglo del cambio de esfuerzo es de verdad útil para agentes que escalan una tarea de un ajuste barato a uno caro a mitad de flujo.
No elimina la pasada de razonamiento. Una caché caliente significa que se procesa menos parte de tu prompt desde cero. No significa que el modelo ya haya pensado en tu bug. Presupuesta la espera de todos modos.
Cuándo pagar la espera y cuándo no
Usa un ajuste de razonamiento máximo cuando la tarea sea de esas que no quieres ejecutar dos veces: una migración, un refactor transversal, cualquier cosa en la que una respuesta equivocada cueste más de noventa segundos. OpenAI informa que Sol en su ajuste xhigh obtiene un 33,2 % en AutomationBench 1.0.6 a 0,27 $ por tarea, que es la forma del intercambio. La precisión ahora es barata en dinero y cara en tiempo de reloj.
Usa un ajuste de esfuerzo inferior cuando haya una persona sentada esperando la respuesta. Trabajo interactivo, una pregunta rápida sobre un archivo, un pequeño arreglo acotado: el problema del silencio casi desaparece con un esfuerzo bajo, porque el primer token aparece mientras todavía recuerdas lo que preguntaste.
Y la frontera honesta: si ejecutas un solo agente en una sola Task, no necesitas un tablero para esto. Sigue el log con un tail. El problema del estado empieza en el punto en que el número de ejecuciones supera el número de terminales que puedes vigilar de forma significativa, que para la mayoría de la gente son unos tres.
Lo que esto no arregla
Un estado te dice que una ejecución está Working. No te dice que la ejecución esté haciendo algo útil, y un agente con confianza equivocada muestra el mismo estado verde que uno bueno durante todo lo que dure la ejecución, que en Opus 5.5 puede ser de 18 horas o más. Distinguir «en ejecución» de «ejecutándose bien» sigue siendo un problema de revisión, y la revisión sigue siendo trabajo de una persona. La automatización se detiene donde hace falta el criterio del equipo.
Si ya ejecutas varios agentes a la vez, el cambio útil más pequeño para esta semana no es un modelo nuevo. Es conseguir que el estado de cada ejecución sea legible sin abrir un terminal, para que los próximos noventa segundos de silencio sean información en lugar de una pregunta.

