En résumé
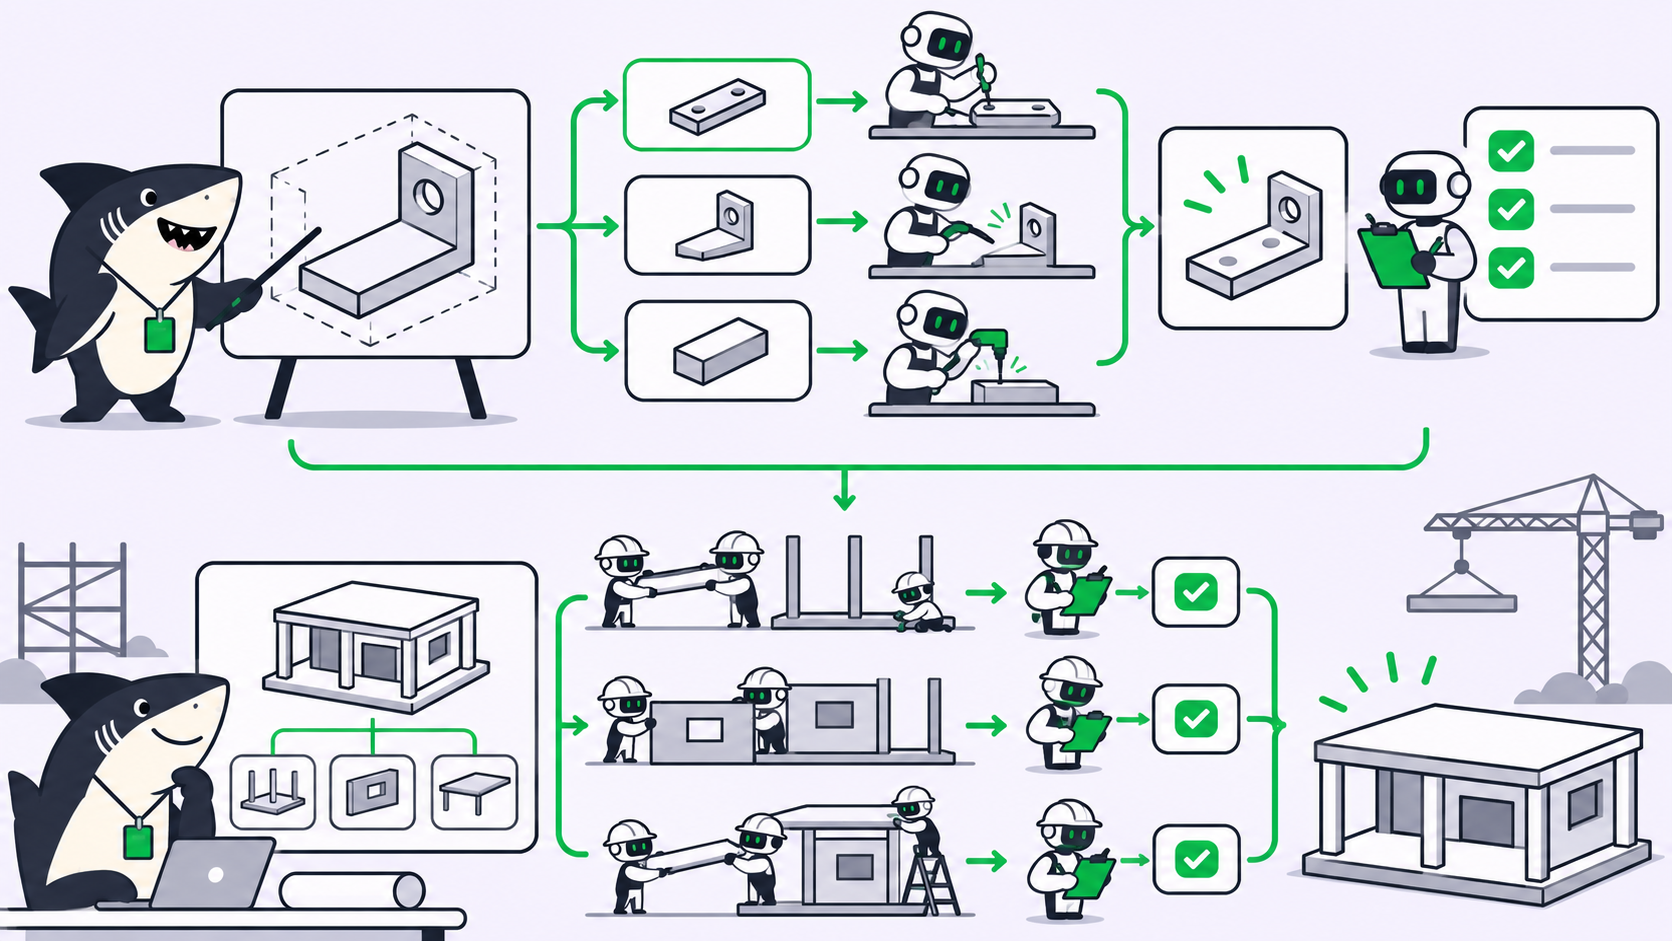
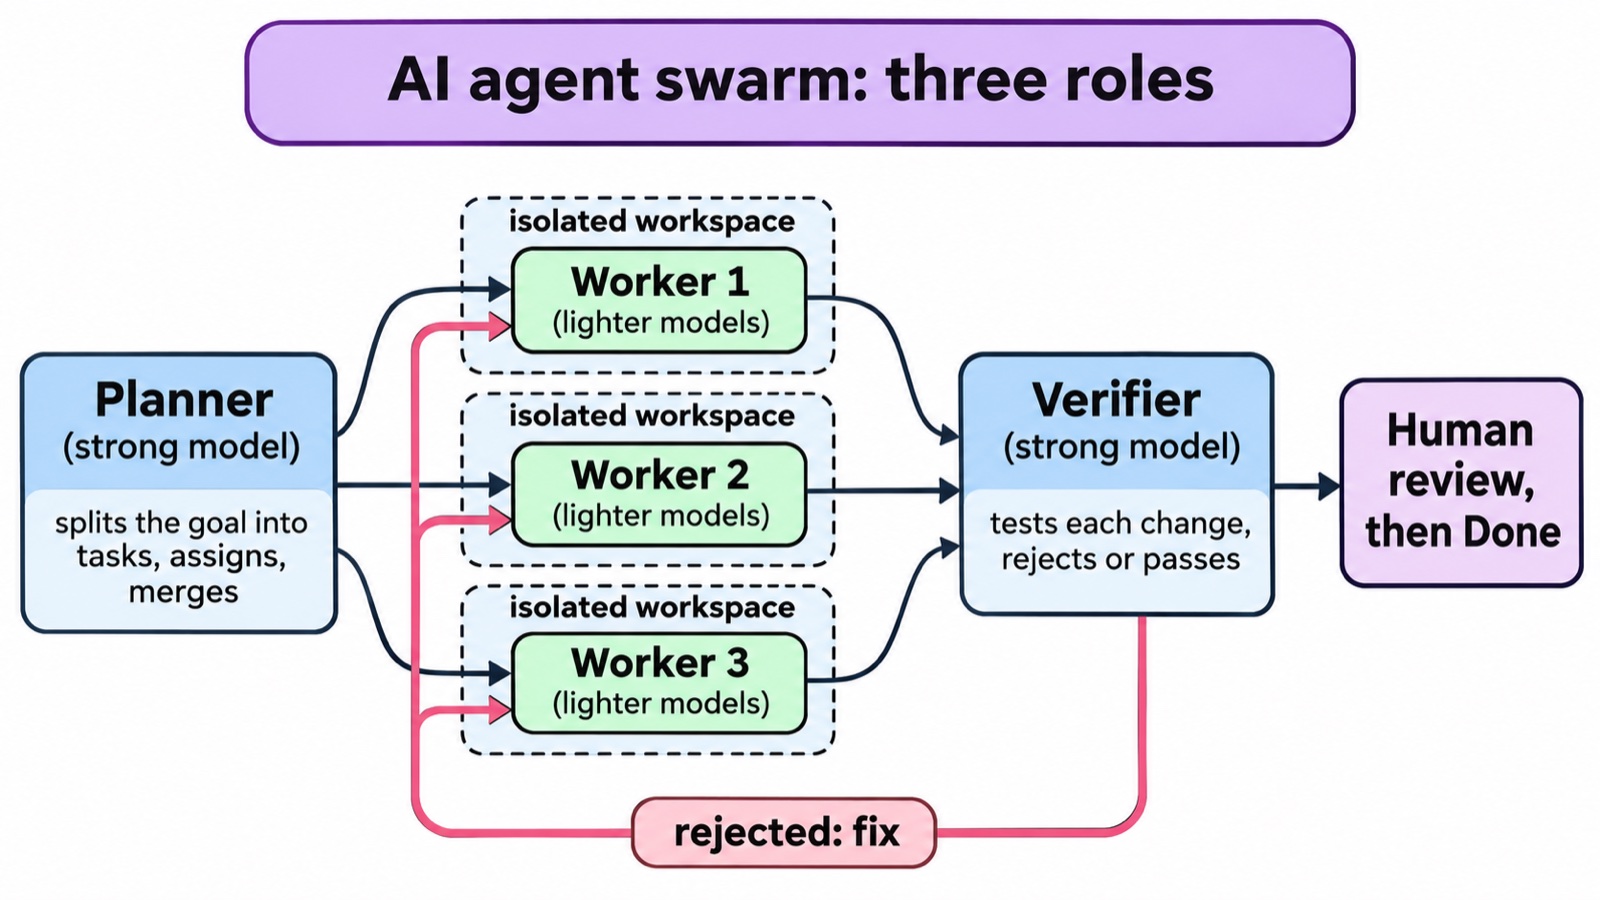
Les essaims d'agents IA répartissent un objectif unique entre trois rôles : un planificateur qui découpe le travail en tâches, des exécutants (workers) qui réalisent ces tâches en parallèle dans des espaces de travail isolés, et des vérificateurs qui testent chaque modification avant qu'elle ne soit prise en compte. Le planificateur et le vérificateur mobilisent votre modèle le plus performant ; les exécutants s'appuient sur des modèles plus rapides et plus économiques. Cette approche échoue dès lors que les exécutants partagent des fichiers, que les vérificateurs valident aveuglément ou que personne ne plafonne les dépenses.
Pourquoi les essaims d'agents IA reviennent sur le devant de la scène
Google a rendu Gemini 4 Carbon disponible pour tous et a présenté un aperçu de /swarm dans Google Antigravity, une fonctionnalité qui transforme un simple prompt en une équipe coordonnée d'agents. Selon les termes de Google, Carbon prend en charge « la conception architecturale, la coordination et l'audit », en s'associant à « des modèles plus rapides et plus légers au sein d'espaces de travail parallèles et isolés, ainsi qu'à des vérificateurs contradictoires qui testent chaque modification ».
Cette phrase résume un schéma que vous pouvez d'ores et déjà mettre en œuvre avec les modèles dont vous disposez. Ce guide détaille les trois rôles, explique pourquoi votre budget doit se concentrer sur la planification et la vérification, identifie les pièges courants et vous montre comment piloter un essaim sur un tableau partagé. Si vous utilisez déjà plusieurs agents de développement, Sharkly attribue à chacun une tâche (Task), un journal d'exécution et une étape de revue, soit l'essentiel de ce dont un essaim a besoin.
Qu'est-ce qu'un essaim d'agents IA ?
Un essaim d'agents IA est un groupe d'agents d'IA qui découpent un objectif unique en tâches indépendantes pour les traiter en parallèle. Un agent planifie et distribue le travail, plusieurs agents l'exécutent simultanément, et un ou plusieurs agents contrôlent chaque résultat avant toute fusion de code. Chaque rôle dispose d'un périmètre précis et d'un passage de relais bien défini.
Anthropic a décrit ce même schéma en 2024 sous le nom de pattern orchestrator-workers : un modèle central décompose une tâche, délègue les différentes parties et rassemble les résultats. Le vérificateur est un ajout plus récent, et c'est pourtant le rôle que la plupart des équipes négligent.
Un essaim ne se résume pas à « plusieurs agents effectuant le même travail ». Lancer cinq agents avec le même prompt sur le même dépôt relève de la situation de concurrence (race condition), pas du travail d'équipe. Ce sont les rôles qui définissent l'essaim. Pour avoir une vision d'ensemble de la coordination des agents, consultez notre article pour savoir ce qu'est l'orchestration d'agents IA.
Les trois rôles : planificateur, workers et vérificateurs
Chaque rôle répond à une question précise et nécessite un contexte différent.
| Rôle | Question à laquelle il répond | Modèle type | Lit | Écrit |
|---|---|---|---|---|
| Planificateur | Quelles sont les différentes parties et qui fait quoi ? | Le plus performant disponible | L'objectif, la cartographie du codebase | Liste de tâches, critères d'acceptation |
| Worker | Comment concevoir cette partie spécifique ? | Plus rapide, plus économique | Une tâche, ses fichiers associés | Un diff dans son propre espace de travail |
| Vérificateur | Cette modification respecte-t-elle les exigences de la tâche ? | Le plus performant disponible | La tâche, le diff, les résultats des tests | Validation ou rejet motivé |
Quel est le rôle du planificateur ?
Le planificateur transforme un objectif général en tâches sans chevauchement. Un bon plan spécifie les fichiers auxquels chaque tâche a le droit de toucher, le test qui valide son achèvement et l'ordre d'exécution en cas de dépendance. Si deux tâches doivent modifier le même fichier, le planificateur les fusionne en une seule ou les exécute de manière séquentielle.
Quel est le rôle des workers ?
Les workers réalisent chacun une tâche précise en parallèle, et rien d'autre. Chaque worker dispose de son propre espace de travail, généralement un worktree git : une copie locale distincte du même dépôt sur sa propre branche. Cette isolation permet à trois workers d'éditer du code simultanément sans écraser le travail des autres. Pour en savoir plus, consultez notre article sur les agents parallèles dans des worktrees isolés.
Quel est le rôle des vérificateurs ?
Les vérificateurs cherchent à prouver qu'une modification est incorrecte. Google emploie le terme « contradictoire » (adversarial), et il est particulièrement bien choisi : le vérificateur exécute les tests, examine le diff à la lumière de la tâche assignée et traque les raccourcis qu'un worker aurait pu emprunter. Un vérificateur qui se contente de demander « les tests passent-ils ? » passera à côté d'un worker qui a modifié les tests pour les faire réussir.
Pourquoi confier la planification et l'audit aux modèles haut de gamme
La planification et la vérification impliquent des lectures courtes mais à très fort impact. Le développement, en revanche, génère de longs volumes de code avec un enjeu plus faible par ligne produite. C'est cette asymétrie qui détermine l'attribution des modèles.
Un planificateur rédige quelques centaines de lignes de descriptions de tâches. Un vérificateur formule un verdict. Ni l'un ni l'autre ne génèrent un volume de sortie massif ; le tarif élevé par token a donc un impact financier global minime. En revanche, les workers produisent l'immense majorité des tokens : c'est sur eux que l'utilisation de modèles économiques génère les plus fortes économies.
L'impact des erreurs varie également d'échelle. Un mauvais plan égare l'ensemble des workers, et un vérificateur négligent laisse passer toutes les mauvaises modifications. À l'inverse, un worker défaillant ne produit qu'un mauvais diff, intercepté aussitôt par le vérificateur. Investissez votre capacité de discernement là où les erreurs font effet de levier.
Le positionnement de Google confirme d'ailleurs cette répartition. Selon l'entreprise, Gemini 4 Argon « reste le choix idéal pour la majorité des travaux d'ingénierie logicielle et de gestion des connaissances », tandis que Carbon consomme davantage de tokens « pour explorer en profondeur, raisonner rigoureusement et exécuter des boucles de vérification étendues ». Carbon coûte 2 $ par million de tokens en entrée et 10 $ par million en sortie jusqu'au 30 novembre 2026, puis 4 $ et 20 $. Pour connaître les spécificités de ces modèles, consultez Gemini 4 Carbon pour les agents de code et Gemini 4 Argon pour les agents de code. Ce même raisonnement s'applique à n'importe quelle combinaison de modèles ; voir notre article sur les Crews à modèles mixtes avec des workers économiques et un relecteur haut de gamme.
Les points de rupture des essaims d'agents IA
La plupart des échecs d'un essaim proviennent de trois lacunes : un état partagé, des contrôles superficiels et l'absence de garde-fous budgétaires.
Pourquoi les agents écrasent-ils le travail des autres ?
Deux workers modifient le même fichier simplement parce que le plan ne l'interdisait pas. Sans espaces de travail isolés, la dernière écriture l'emporte et le travail du premier worker disparaît. Avec l'isolation, les deux modifications subsistent jusqu'à la fusion, où elles entrent en conflit. La solution réside dans la planification : attribuez la responsabilité des fichiers par tâche et sérialisez les tâches qui partagent des fichiers communs.
Pourquoi les vérificateurs valident-ils à l'aveugle ?
Un vérificateur qui lit le résumé du worker au lieu d'analyser le diff évalue une simple affirmation, pas le travail accompli. Il lit que « tous les tests réussissent » et donne son accord. Fournissez au vérificateur le diff brut et les résultats d'exécution des tests, jamais le compte rendu rédigé par le worker. Exécutez-le également sur un modèle différent de celui des workers pour éviter qu'il ne partage leurs angles morts. Notre article sur les agents de revue de code par IA aborde ce qu'un agent relecteur est capable ou non de vérifier.
Comment les coûts d'un essaim peuvent-ils exploser ?
Chaque rejet déclenche un nouveau cycle de développement et une nouvelle revue : une tâche rejetée trois fois coûte ainsi quatre fois plus cher. Dix workers pris dans une boucle de rejet pendant la nuit peuvent engloutir le budget d'une semaine entière. Plafonnez le nombre de tentatives par tâche (deux est une valeur par défaut raisonnable), limitez le nombre de workers simultanés et réattribuez la tâche à un humain si la dernière tentative échoue.
Un quatrième problème sous-jacent subsiste : si le plan, les exécutions et les verdicts résident tous dans la même fenêtre de contexte, personne ne peut auditer le résultat. Une entité extérieure à l'essaim doit continuer à superviser l'ensemble.
Comment piloter un essaim d'agents IA sur un tableau partagé
Vous n'avez pas besoin d'un outil dédié pour faire tourner un essaim. Vous avez simplement besoin de tâches, d'espaces de travail isolés et d'une porte de validation (gate). Un tableau partagé réunit ces trois éléments tout en conservant un historique accessible aux équipes.
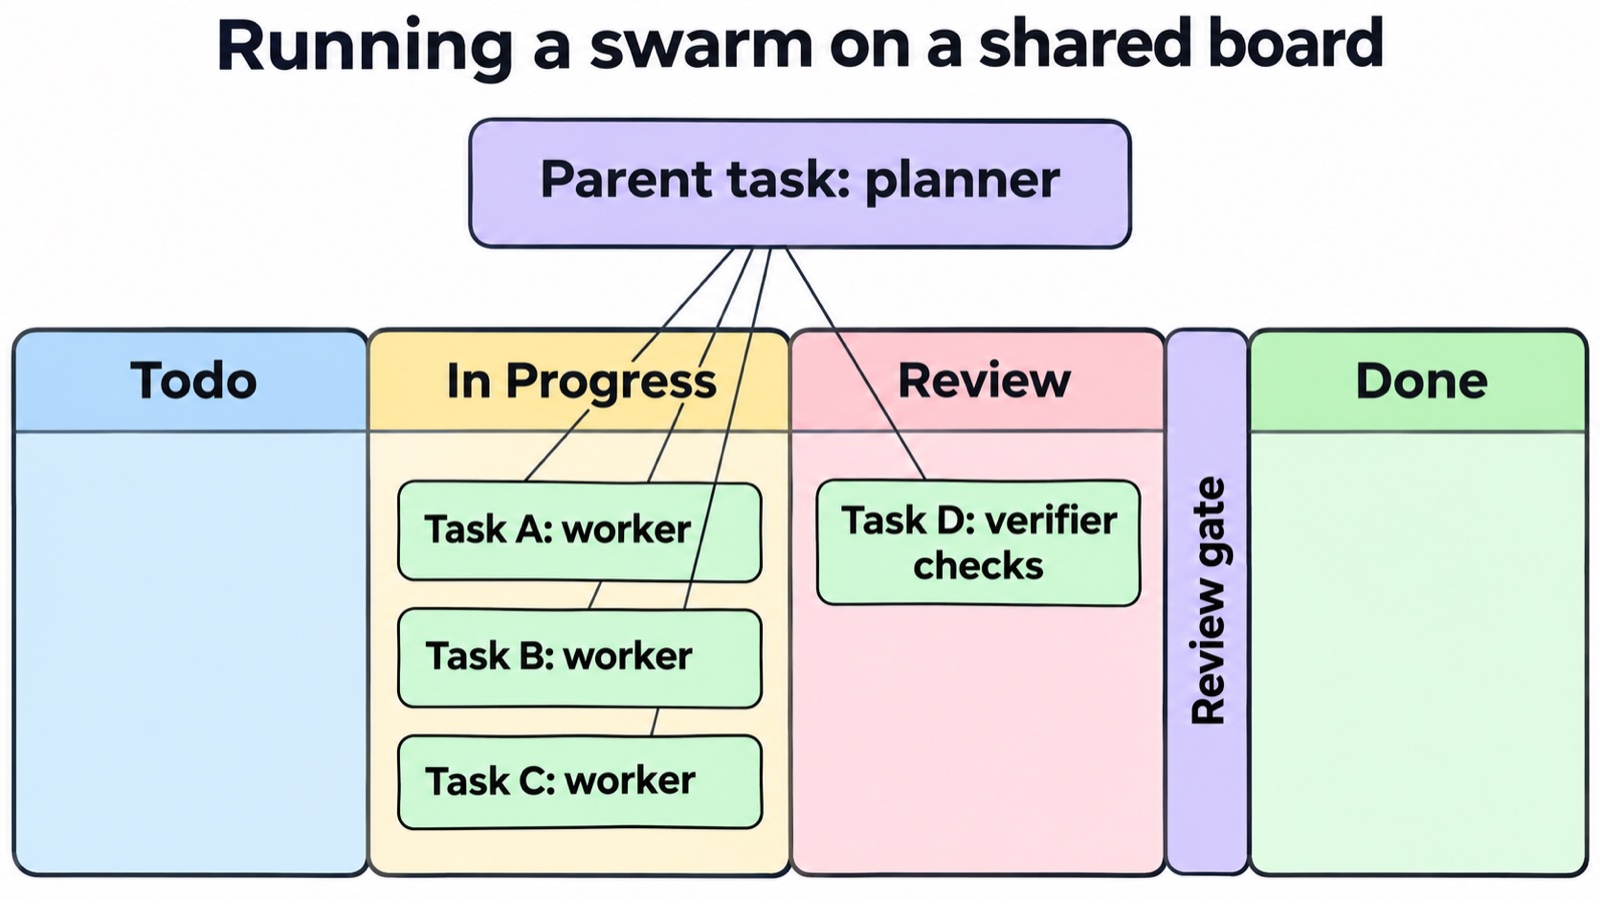
- Créez une tâche parente pour l'objectif global. Le planificateur la lit et structure le plan sous forme de sous-tâches, chacune assortie de sa liste de fichiers et de son test d'acceptation.
- Attribuez à chaque worker une tâche et une seule. Une tâche, un agent, une branche. Si deux sous-tâches partagent un fichier, fusionnez-les avant de lancer l'exécution.
- Exécutez chaque tâche dans son propre répertoire. Un worktree par exécution évite tout conflit entre éditions parallèles.
- Ajoutez un statut En revue avant l'état Terminé. Aucune tâche ne passe à l'état Terminé sur la simple parole du worker.
- Confiez la revue à un agent vérificateur basé sur un modèle plus puissant. Il examine le diff ainsi que le résultat des tests, puis valide la tâche ou la renvoie avec un motif de rejet explicite.
- Placez un être humain à l'étape finale. Le vérificateur fait le tri en amont ; l'humain valide définitivement le résultat.
Voici comment cela s'articule dans Sharkly. Une Crew est un groupe réutilisable composé de personnes et d'agents, coordonné par un agent leader. Attribuez la tâche parente (Task) à la Crew et le leader commence par intervenir : il prend connaissance de la tâche, sollicite les agents membres pour des étapes ciblées et synthétise leurs résultats. Cet ordonnancement garantit qu'aucun worker ne démarre tant que le plan n'est pas établi.
Les agents en mode répertoire de travail temporaire bénéficient d'un dossier isolé par tâche, et les exécutions adossées à un dépôt peuvent préparer un nouveau worktree, évitant ainsi tout partage de fichiers entre workers parallèles. Chaque agent tourne sur le Runtime configuré par vos soins, ce qui permet d'affecter au leader et au relecteur un modèle plus robuste qu'aux workers.
La porte de revue correspond à un statut dans votre workflow de tâches. Un agent peut laisser une tâche en attente de validation humaine, et cette passation apparaît dans le module Task Chats de la barre latérale principale, comme l'explique la documentation sur l'exécution des tâches par les agents. Les exécutions échouées ou bloquées sont quant à elles redirigées vers l'Inbox. Les agents recherchent, exécutent, testent et rendent compte. Les équipes humaines fixent le cap, accordent les autorisations et valident le résultat final. L'accès à Sharkly est gratuit pour démarrer : connectez un Computer, créez deux Agents et confiez une première mission simple à une Crew. Pour approfondir le rôle clé de l'humain, découvrez comment concevoir la revue pour des agents parallèles.
Dans quels cas vous pouvez vous passer d'un essaim d'agents IA
Renoncez à l'essaim lorsque le travail ne se prête pas à la découpe. La correction d'un bug isolé, le refactoring d'un fichier unique ou une longue chaîne de raisonnement séquentielle progressent bien plus vite avec un seul agent performant et un relecteur. En dessous de trois tâches indépendantes, le coût de coordination dépasse généralement les gains apportés par le parallélisme.
Privilégiez l'essaim lorsque l'objectif se décompose en blocs touchant des fichiers distincts : une migration multi-paquets, l'enrichissement de tests à travers plusieurs modules ou la répercussion d'un changement d'API sur une dizaine de services. Google cite d'ailleurs les « migrations multi-paquets » et les « analyses de causes racines transverses à plusieurs sous-systèmes » comme des cas d'usage où Carbon excelle en configuration multi-agents.
Conclusion
Un essaim d'agents IA repose sur trois étapes distinctes, et non sur un unique prompt géant : planifier, construire, vérifier. Mobilisez votre modèle le plus performant pour la planification et le verdict, utilisez des modèles économiques pour la réalisation, et assurez-vous que chaque résultat reste facilement consultable par un humain. Commencez simplement avec une tâche parente, trois workers et un vérificateur. Pour déployer ce schéma avec vos agents actuels, connectez un Computer à Sharkly et lancez votre première Crew.
FAQ
Quelle est la différence entre un essaim d'agents et l'orchestration multi-agents ?
L'orchestration est la discipline générale consistant à coordonner plusieurs agents. L'essaim est un modèle d'orchestration spécifique structuré autour de rôles fixes : un planificateur, des workers parallèles et des vérificateurs. Tout essaim relève de l'orchestration, mais toute orchestration n'est pas un essaim.
Combien d'agents un essaim d'agents IA doit-il comporter ?
Commencez avec un planificateur, trois workers et un vérificateur. N'augmentez le nombre de workers que si les tâches demeurent strictement indépendantes et que votre file d'attente de revue suit le rythme. Avoir plus de workers que de résultats vérifiables ne fait que déplacer le goulet d'étranglement vers le vérificateur.
Le planificateur et le vérificateur peuvent-ils être le même agent ?
Ils peuvent s'appuyer sur le même modèle, mais veillez à séparer leurs exécutions et leurs contextes. Un planificateur chargé d'évaluer le résultat de son propre plan aura naturellement tendance à le valider. Un vérificateur indépendant, doté d'un contexte vierge, analysera le diff sans être biaisé par les hypothèses de départ du planificateur.
Faut-il Google Antigravity pour exécuter un essaim d'agents ?
Non. La commande /swarm n'est qu'une fonctionnalité en préversion au sein d'Antigravity, mais ce modèle architectural nécessite seulement le découpage des tâches, des espaces de travail isolés et une étape de revue. Vous pouvez le mettre en place simplement avec des worktrees git et un tableau de suivi, quel que soit l'agent de code que vous utilisez déjà.
Qu'est-ce qui empêche les workers d'un essaim d'éditer le même fichier ?
Le plan attribue la responsabilité des fichiers afin que les tâches ne se chevauchent pas, tandis que les espaces de travail isolés maintiennent les modifications de chaque worker sur sa propre branche jusqu'à la fusion. Une règle CODEOWNERS permet d'ajouter un contrôle supplémentaire au moment de la revue.


