
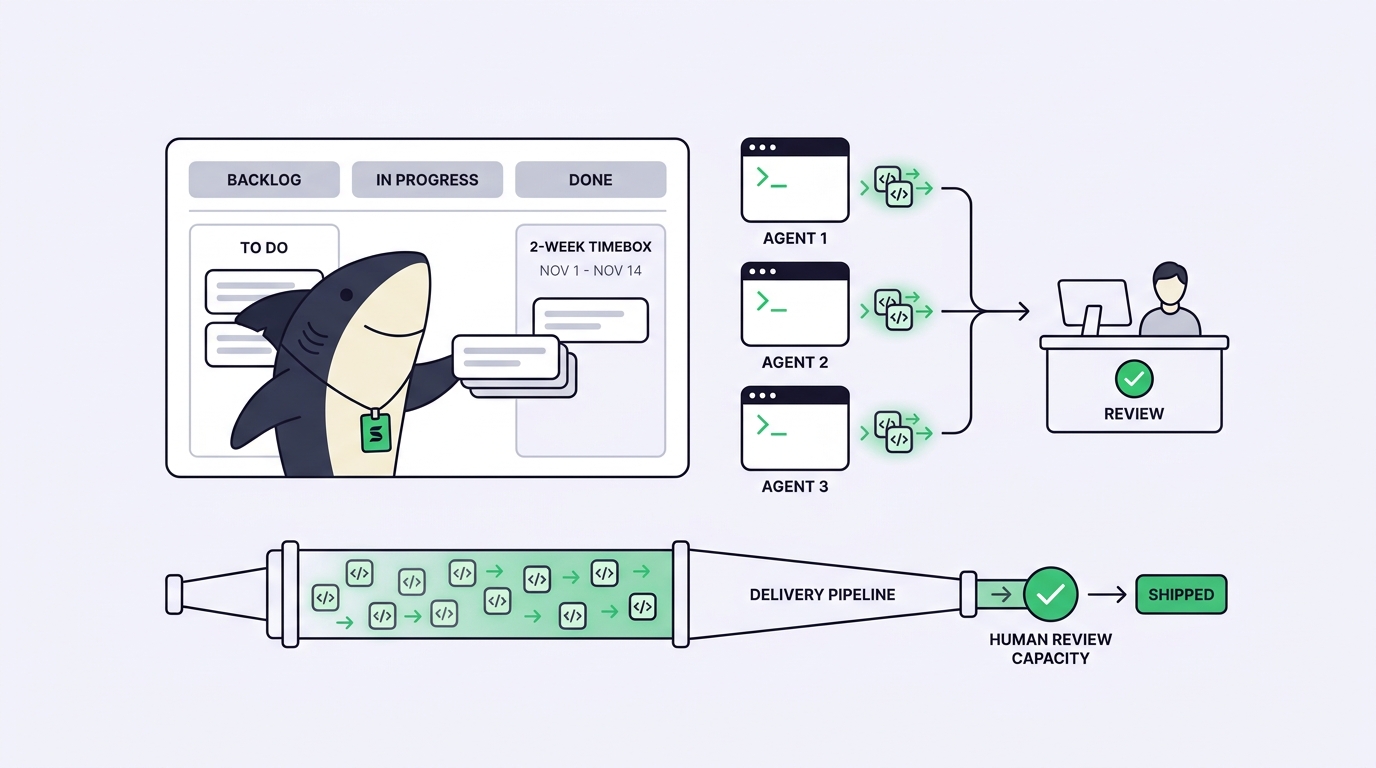
La planification de Sprint pour une équipe humains-agents fonctionne quand on planifie autour de la capacité de revue, et non de la vitesse d'exécution. Les agents peuvent prendre en charge et terminer plus de Tasks que vos relecteurs ne peuvent en accepter ; la vraie limite d'un cycle est donc le nombre de modifications terminées qu'une personne peut inspecter et fusionner, et non la quantité de code écrite. Ce guide déroule la méthode de planification étape par étape, nomme le mode de défaillance à chaque étape et se termine par une checklist à exécuter avant votre prochain Sprint.
La planification de Sprint classique part du principe que la ressource rare est le temps dont disposent les ingénieurs pour écrire du code. Ajoutez des agents de codage et cette hypothèse s'effondre. Claude Code, Codex et Gemini CLI peuvent chacun prendre une Task et renvoyer un diff fonctionnel pendant que vous êtes encore en train de lire le précédent. L'exécution cesse d'être le goulot d'étranglement. C'est l'acceptation qui le devient.
Ce basculement sabote discrètement un plan normal. Vous dimensionnez un cycle de deux semaines en jours-développeur, les agents liquident le backlog en trois jours, et une file de modifications terminées mais non relues s'accumule derrière une ou deux personnes capables d'accepter la fusion. Le Sprint a l'air rapide et se termine lentement.
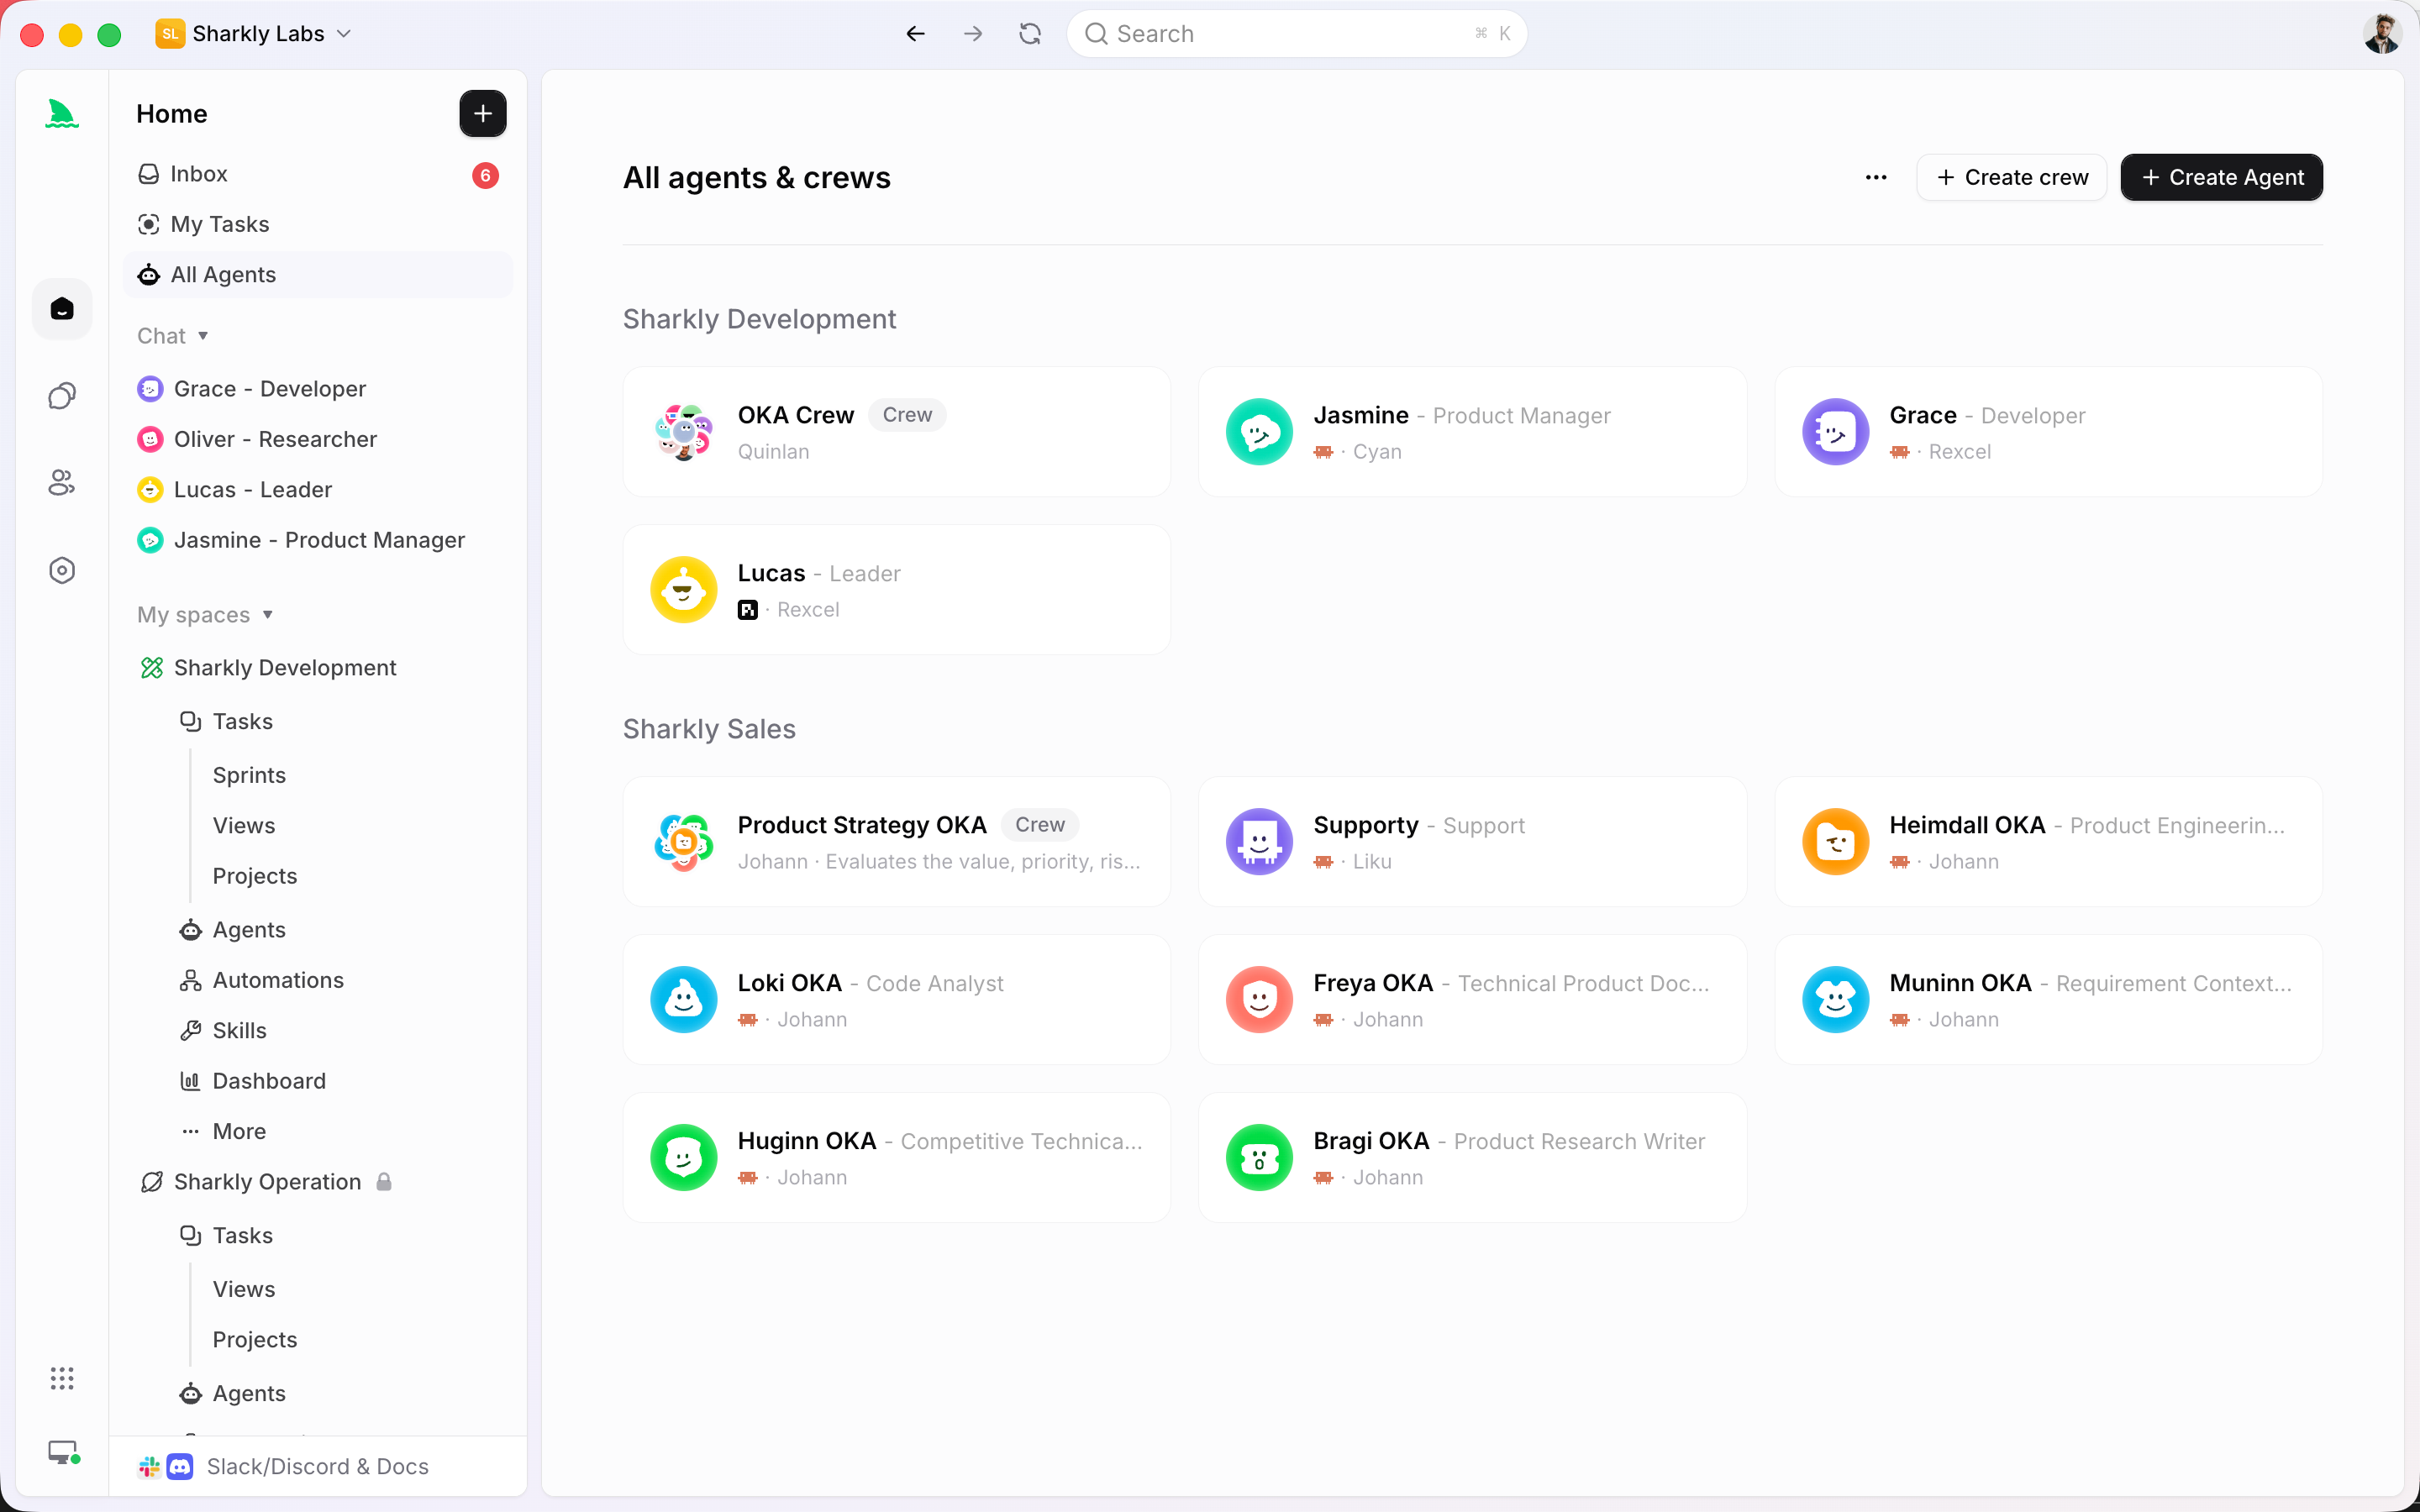
Sharkly est l'espace de travail dans lequel ce guide planifie. Vous avez déjà des agents de codage ; Sharkly en fait une équipe en regroupant chaque Task, sa progression, ses blocages, ses résultats et la revue humaine dans un seul espace partagé plutôt que de les disperser entre les terminaux. Un Sprint dans Sharkly est un ensemble de Tasks à durée limitée, rattaché à un seul Space. La méthode ci-dessous est la même, que vous l'appliquiez sur un tableau blanc ou dans le produit, mais les modes de défaillance sont plus faciles à repérer dès que le travail revient sur un tableau partagé.
Ce qui change quand les agents font l'exécution
La planification de Sprint pour une équipe humains-agents consiste à dimensionner un cycle en fonction du volume de travail d'agent terminé qu'une personne peut relire et accepter, et non en fonction de la quantité de code que l'équipe peut produire.
Les agents font la recherche, l'exécution, les tests et le compte rendu. Les humains donnent la direction, accordent l'autorité et acceptent le résultat. Cette répartition, c'est tout le problème de planification. Le débit de vos agents est élastique : vous pouvez en faire tourner trois ou dix. Votre débit de revue est en revanche figé par le nombre de personnes capables de lire un diff, d'exécuter la modification et de décider qu'elle part en production. Voir le calcul de la capacité de revue pour comprendre pourquoi un bond de 5x de la production des agents se traduit rarement par 5x plus de travail livré.
Le premier chiffre avec lequel vous planifiez n'est donc pas un nombre de points d'histoire. Ce sont les créneaux de revue : combien de Tasks terminées chaque relecteur peut accepter par jour, multiplié par le nombre de relecteurs, multiplié par le nombre de jours du cycle. Tout le reste doit tenir sous ce plafond.
Planifier le Sprint étape par étape
1. Fixez d'abord le plafond de revue. Estimez le nombre de Tasks terminées qu'un relecteur peut réellement accepter par jour ; une vraie revue d'une modification non triviale prend 30 à 60 minutes. Multipliez par le nombre de relecteurs et par le nombre de jours du Sprint. Mode de défaillance : sauter cette étape, planifier selon la capacité des agents, sur-engager, et terminer le cycle avec une file de revue plus longue que le Sprint lui-même.
2. Dimensionnez les Tasks pour la revue, pas pour l'exécution. Découpez le travail pour que chaque Task produise un diff qu'une personne peut garder en tête. Mode de défaillance : un agent renvoie allègrement une modification de 2 000 lignes réparties sur neuf fichiers, personne ne peut l'accepter dans un seul créneau, et elle pourrit au bas du tableau.
3. Rédigez les critères d'acceptation avant d'assigner. Chaque Task a besoin d'une définition de « terminé » testable : quoi construire, à quoi ressemble « correct », ce qu'il ne faut pas toucher. Mode de défaillance : un périmètre flou pousse l'agent à deviner, le relecteur renvoie la Task, et une seule Task consomme deux créneaux de revue.
4. Assignez à un seul Agent ou à une Crew, délibérément. Utilisez un seul Agent pour un travail petit et bien défini. Utilisez une Crew quand un Agent leader doit interpréter l'objectif, mobiliser d'autres membres et ramener leurs résultats dans une seule Task. Mode de défaillance : recourir à une Crew pour un travail trivial ajoute des pièces mobiles que vous devrez ensuite relire.
5. Plafonnez le travail en cours. Limitez le nombre de Tasks pouvant stationner dans la colonne « en revue », comme fonctionnent les limites de WIP dans kanban. Mode de défaillance : sans plafond, les agents inondent la colonne de revue plus vite que les humains ne la vident ; le goulot d'étranglement reste invisible jusqu'au dernier jour.
6. Laissez une marge de manœuvre. Réservez des créneaux de revue pour les reprises et pour les demandes de modification que vous renverrez. Mode de défaillance : planifier à 100 % et le premier tour de « merci de corriger » n'a nulle part où atterrir.
Où un tableur ou une configuration à base de tickets cesse de passer à l'échelle
Vous pouvez mener le premier Sprint dans un tableur. Un onglet de Tasks, une colonne responsable, une colonne statut. Ça tient tant qu'une seule personne fait tourner deux agents sur un seul dépôt.
Ça cesse de fonctionner dès que l'exécution et le suivi se séparent. L'exécution de l'agent, le diff, la sortie des tests et la discussion vivent dans un terminal ; le tableur, lui, affiche un « en cours » périmé. Quelqu'un met la ligne à jour à la main, ou personne ne le fait. Ajoutez un troisième agent sur un second dépôt et le tableau s'écarte de la réalité en une journée. Vous ne pouvez alors plus répondre à la seule question dont dépend la planification : qu'est-ce qui est terminé, et qu'est-ce qui m'attend ?
Un tableau de tâches conçu pour cela garde l'exécution et le compte rendu ensemble. Le travail, la progression, les blocages et les résultats reviennent dans la Task au lieu de disparaître dans des sessions privées. Dans Sharkly, un Agent prend une Task prête, s'exécute dans un worktree isolé pour que les modifications parallèles ne se heurtent pas, et son résumé de modification, ses résultats de vérification et ses limites connues reviennent dans la chronologie de la Task pour qu'une personne les accepte ou les renvoie. C'est la différence entre un statut que vous maintenez et un statut qui se maintient tout seul. Cela fournit aussi à votre prochaine session de planification de vraies données : quel travail les agents ont terminé au cycle précédent, et où le temps de revue est passé.
Limite honnête : si vous faites tourner un seul agent sur un seul dépôt et que vous relisez au fil de l'eau, vous n'avez pas besoin d'un tableau de tâches ni de Sharkly. Un seul terminal et une checklist suffisent. L'équation change dès que vous planifiez sur plusieurs agents, Tasks, dépôts ou personnes, ce qui est exactement le point où un tableur devient un second métier. Sharkly est conçu pour ce second cas ; téléchargez-le quand le tableur commence à vous mentir.
Une checklist à dérouler avant votre prochain Sprint
Déroulez-la avant de valider le plan :
- [ ] Le plafond de revue est calculé (relecteurs x acceptations-par-jour x jours) et traité comme la capacité réelle du Sprint.
- [ ] Chaque Task est assez petite pour être relue dans un seul créneau.
- [ ] Chaque Task a des critères d'acceptation testables et une limite claire de « ne pas toucher ».
- [ ] Chaque Task est assignée à un seul Agent ou à une Crew délibérément, pas par défaut.
- [ ] Un plafond de WIP existe sur la colonne « en revue ».
- [ ] Une marge est réservée pour les reprises et les demandes de modification.
- [ ] Un humain est responsable de la décision de fusion et de publication pour chaque Task.
- [ ] La progression, les blocages et les résultats reviennent sur un tableau partagé, pas dans des terminaux privés.
Cochez les huit et l'exécution par les agents reste dans un plan que l'équipe peut terminer. Ratez la première et les autres ne vous sauveront pas.
FAQ
La planification de Sprint est-elle encore utile quand les agents écrivent la majeure partie du code ? Oui, mais la contrainte se déplace. Un Sprint cesse d'être un contenant pour des heures d'ingénierie et devient un contenant pour la revue et l'acceptation. Planifiez le cycle autour du volume de travail terminé que les humains peuvent inspecter, et les agents le rempliront. Le Scrum Guide définit toujours la cérémonie ; seul le calcul de capacité change.
Comment estimer la capacité d'une équipe humains-agents ? Partez des relecteurs, pas des agents. Comptez les Tasks terminées qu'une personne peut honnêtement accepter par jour, puis multipliez par le nombre de relecteurs et par le nombre de jours du Sprint. Le nombre d'agents ne compte que jusqu'à ce qu'il dépasse ce plafond ; au-delà, plus d'agents ne font qu'allonger la file.
Les agents doivent-ils choisir leurs propres Tasks pendant le Sprint ? Laissez-les prendre les Tasks prêtes qui portent déjà leurs critères d'acceptation, pour que le travail parallèle avance sans répartiteur. Gardez les humains sur la direction, l'autorité et la fusion. Cela place l'humain dans la boucle là où le jugement est nécessaire, et l'automatise partout ailleurs.
En quoi est-ce différent de la gestion de projet classique ? Les cérémonies se ressemblent ; le goulot d'étranglement, non. La gestion de projet par agents IA planifie autour du débit de revue et de l'isolation des modifications plutôt que de la disponibilité des développeurs, parce que l'exécution n'est plus la ressource rare.
Ai-je besoin d'un nouvel outil, ou puis-je étendre Jira ? Vous pouvez conserver le système que votre équipe maîtrise déjà. La différence, c'est que les outils de tickets suivent un statut qu'un humain saisit, pas une exécution qu'une machine réalise. Voir les alternatives à Jira pour les équipes humains-agents pour savoir où cet écart commence à faire mal.


