Évaluez Claude Fable 5.2 sur des tâches représentatives de votre dépôt, avec des critères d'acceptation définis, des environnements identiques et une base de référence déjà éprouvée. Mesurez conjointement le nombre de modifications acceptées, la charge de revue de code, le temps écoulé et le coût global. Répétez les essais, conservez les échecs et décidez de son adoption par catégorie de tâches plutôt que sur la base d'un score unique de benchmark.
Anthropic a annoncé Fable 5.2 le 9 novembre 2026. Son communiqué met en avant des progrès en matière de programmation et de raisonnement. Il s'agit là d'affirmations de l'éditeur sur ses propres évaluations et cas d'usage. Elles ne préjugent en rien des performances du modèle face à vos dépendances, à vos conventions et à vos exigences de mise en production.
Votre évaluation doit répondre à une question plus ciblée : quelles tâches pouvez-vous lui confier sans surcharger vos revues de code ? Si plusieurs agents de programmation se partagent déjà ce travail, Sharkly vous permet d'organiser les tâches et leur contexte de relecture.
Ce guide propose un cadre expérimental. Il ne présente aucun résultat comparatif mesuré.
Construire un ensemble de tâches représentatif
L'évaluation sur un dépôt consiste à comparer méthodiquement des flux de programmation à des exigences directement issues de vos développements. L'unité de mesure du succès est la modification acceptée, tests et revue compris. Un patch plausible, une commande de test qui réussit ou un message d'achèvement rassurant ne suffisent pas à valider une acceptation.
Commencez avec douze tâches tirées de vos récentes interventions de maintenance. Cet effectif correspond à une taille de projet pilote suggérée, non à une garantie statistique. Intégrez des corrections de bugs, de petits ajouts, des refactorisations et des tâches d'investigation, dans des proportions fidèles à votre backlog.
Sélectionnez des tâches dont le commit initial est clairement identifié et attribuez-leur un relecteur qui maîtrise le comportement attendu. Évitez de retenir uniquement des anomalies aux solutions évidentes. Prévoyez au moins une tâche où la réponse adéquate exige de poser une question ou de signaler une dépendance manquante.
Pour les anomalies passées, retirez la solution du contexte fourni. Notez si le correctif était déjà public : le modèle a pu le rencontrer lors de son entraînement. Conservez un jeu distinct de tâches non publiées pour une phase ultérieure de confirmation.
Rédigez les critères d'acceptation avant tout lancement. Pour la correction de la pagination d'une API, précisez le comportement face à des résultats vides, aux limites de page, aux curseurs invalides et à la rétrocompatibilité avec les clients existants. Indiquez le périmètre autorisé des modifications ainsi que les vérifications requises pour l'acceptation.
| Catégorie | Exemple de tâche | Preuve d'acceptation |
|---|---|---|
| Correction de bug | Corriger la gestion des limites de curseur | Test de non-régression et passage de la suite de tests existante |
| Ajout mineur | Ajouter un filtrage optionnel des requêtes | Tests de contrat et valeurs par défaut documentées |
| Refactorisation | Extraire une logique de validation dupliquée | Comportement public inchangé et validation de la revue |
| Investigation | Diagnostiquer un dépassement de délai intermittent | Reproduction du problème et explication causale étayée |
Privilégiez une tâche simple pour obtenir une comparaison nette. Réservez une tâche plus complexe aux cas où la coordination fait elle-même partie de l'évaluation, et mesurez cette expérience séparément.
Figer les conditions avant d'exécuter les agents
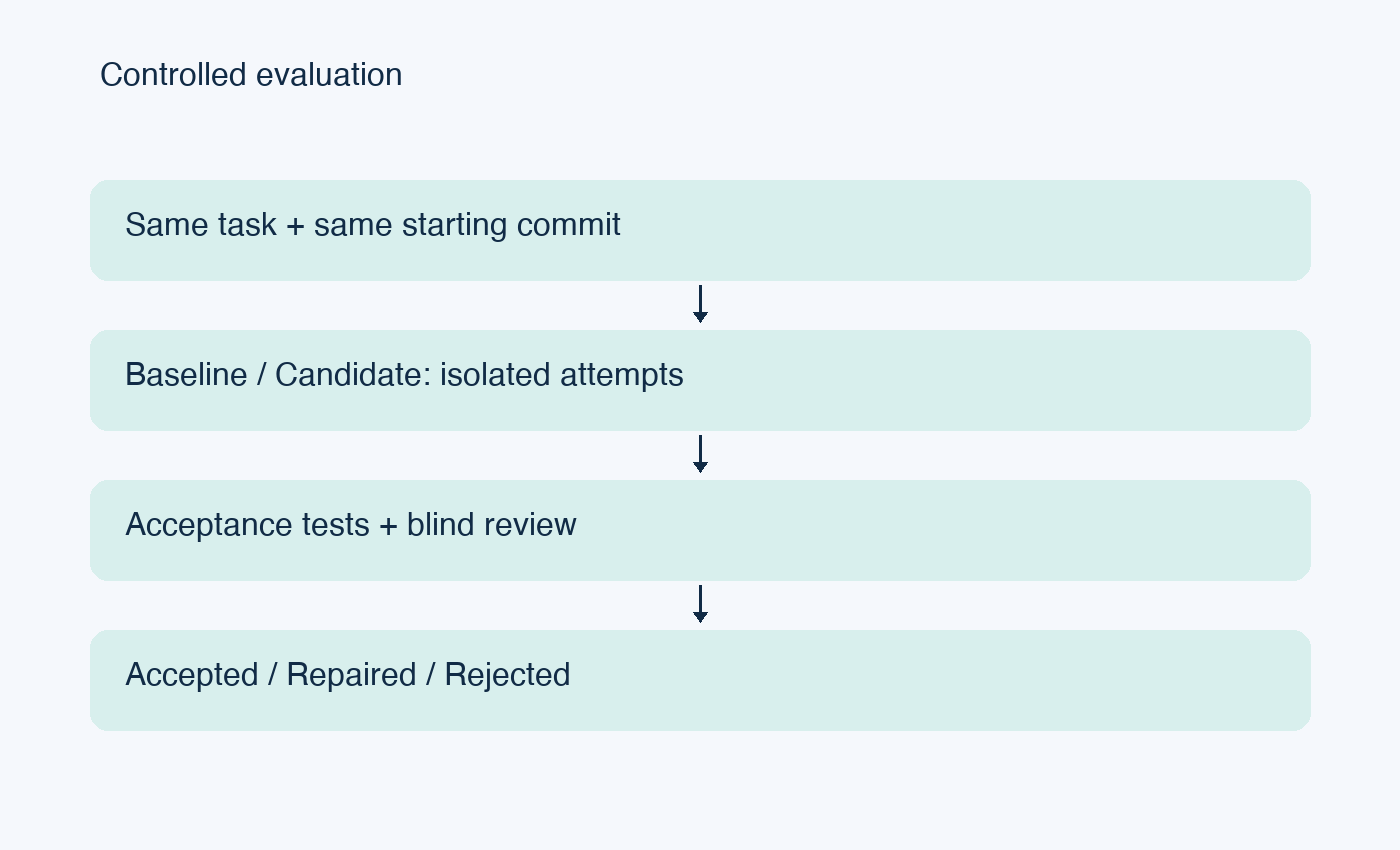
Consignez le commit du dépôt, le système d'exploitation, les fichiers de verrouillage des dépendances (lockfiles), les versions des outils, l'identifiant du modèle et sa configuration. Figez également le harnais de l'agent : il s'agit du logiciel qui fournit les outils, le contexte et gère l'exécution autour du modèle.
Comparez Fable 5.2 à votre flux de travail habituel. Une comparaison de modèles exige d'employer le même harnais lorsque cela est possible. Une comparaison de flux de travail peut recourir à des outils différents, à condition que la conclusion mentionne explicitement chacune des configurations complètes.
Maintenez des permissions, des accès réseau, un contexte de départ et des limites de temps strictement équivalents. Précisez si l'installation des dépendances est décomptée du temps d'exécution. Veillez à ce qu'aucune configuration n'hérite des fichiers modifiés, des caches contenant des éléments de solution ou de l'historique de conversation d'un autre essai.
Prévoyez un clone vierge ou un arbre de travail (worktree) isolé pour chaque tentative. La documentation sur git worktree détaille comment plusieurs arbres de travail peuvent partager un même dépôt. L'isolation des fichiers n'isole toutefois pas les bases de données, les ports ou les services externes ; allouez-leur également des ressources de test distinctes.
Définissez une règle d'intervention explicite. Vous pouvez par exemple autoriser une seule demande de précision, limitée aux informations accessibles à toutes les configurations. Enregistrez tout temps d'intervention : un relecteur qui corrigerait discrètement une implémentation fausserait les mesures du test.
Mener des essais comparatifs et conserver les échecs
Soumettez chaque configuration aux mêmes tâches. Alternez l'ordre d'exécution pour éviter qu'un ralentissement temporaire de service ne favorise systématiquement un candidat. Répétez les tentatives lorsque les ressources le permettent, selon un nombre prédéterminé avant de consulter les résultats.
Pour un projet pilote réaliste, vous pouvez prévoir trois tentatives par configuration et par tâche. Considérez ce chiffre comme un point de départ technique : un échantillon restreint ne permet pas de tirer des conclusions définitives sur des pannes rares ou une supériorité absolue.
Archivez l'invite (prompt), la configuration, les horodatages, la transcription, le patch, la sortie des outils et l'issue finale de chaque tentative. Considérez les dépassements de délai et les abandons comme des résultats à part entière. Les écarter donnerait l'illusion que les exécutions réussies sont plus économiques et plus rapides que le flux que vous déploieriez en réalité.
Séparez rigoureusement les jeux de données de test et les identifiants de l'environnement de production. Appliquez les procédures de test en vigueur dans votre dépôt. Pour les projets Python, la documentation de pytest détaille la gestion des fixtures et l'exécution des tests ; le framework ne saurait toutefois juger si vos critères d'acceptation couvrent l'intégralité du besoin.
Privilégier l'exactitude à la rapidité
Faites examiner le patch par un relecteur qui ignore, dans la mesure du possible, quel modèle l'a produit. Appuyez-vous sur une grille d'évaluation fixe portant sur le respect des spécifications, le risque de régression, la maintenabilité, la qualité des tests et l'absence de modifications superflues.
La réussite des tests est indispensable lorsque la tâche l'exige, mais un test peut très bien valider un comportement erroné. Vérifiez les assertions à la lumière du besoin initial. Soyez attentif aux contrôles désactivés, aux tolérances élargies, aux exceptions interceptées sans traitement et aux modifications qui contournent le cas défaillant.
Distinguez trois statuts : accepté tel quel, accepté après correction et rejeté. Enregistrez le temps passé à corriger ainsi que la nature de chaque intervention. Déterminez au préalable si les modifications corrigées entrent dans votre taux d'acceptation principal.
Pour les tâches d'investigation, évaluez la rigueur du raisonnement. Un rapport pertinent énonce des observations précises, distingue les hypothèses et fournit une étape de reproduction claire. N'accordez aucun crédit à un diagnostic affirmé avec assurance s'il manque de preuves.
Calculer le coût par modification acceptée
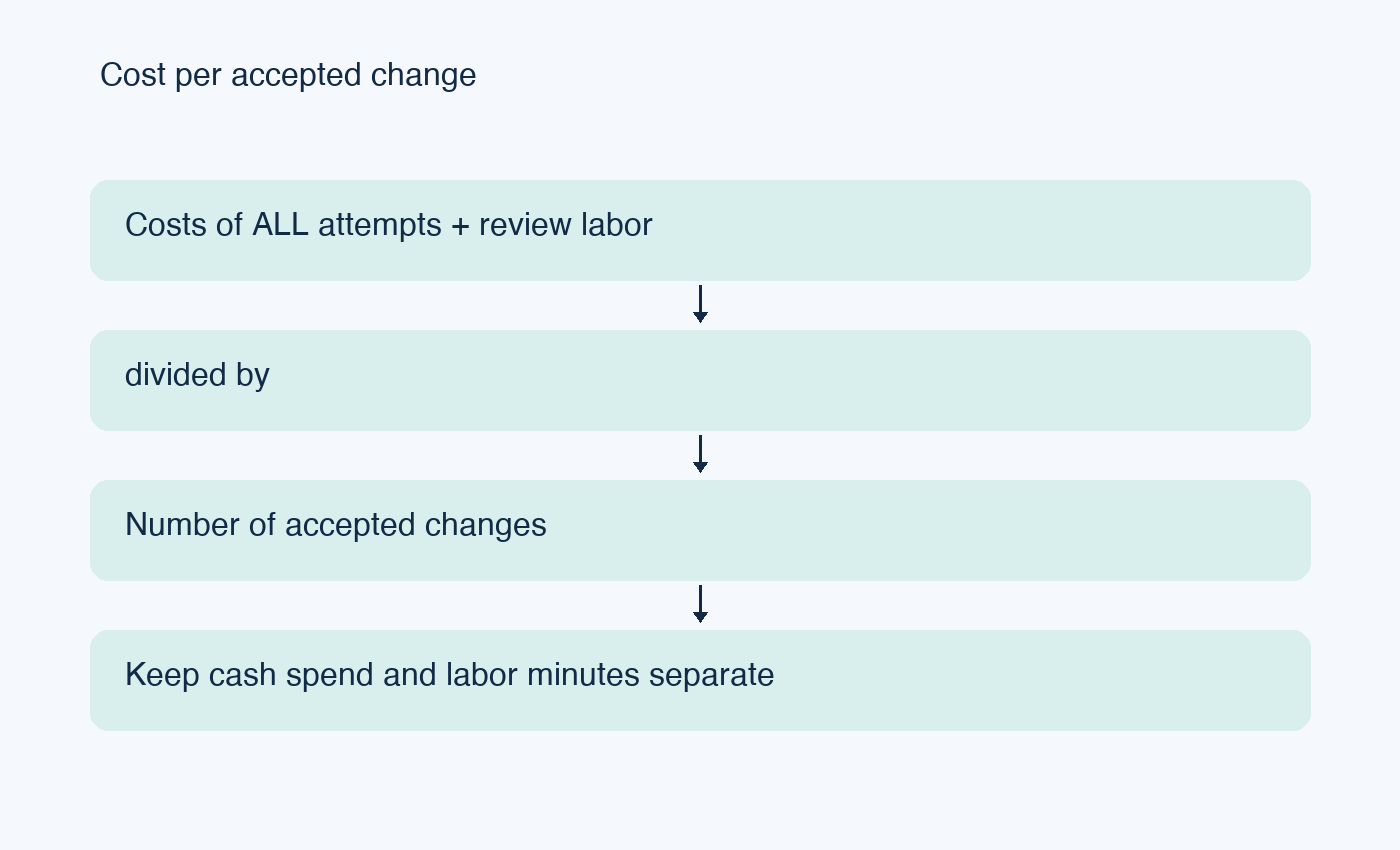
Le coût par modification acceptée s'obtient en divisant le coût total de l'évaluation par le nombre de modifications retenues selon votre règle établie. Intégrez les tentatives infructueuses au numérateur. Si aucune modification n'est acceptée, indiquez le coût global et zéro acceptation : ce ratio n'a pas de valeur finie.
Suivez conjointement ces différents indicateurs :
- Taux d'acceptation par catégorie de tâches.
- Temps réel écoulé entre le lancement de la tâche et la livraison prête pour revue.
- Temps humain consacré à la revue et aux corrections.
- Frais liés au modèle et aux outils pour l'ensemble des tentatives.
- Coûts d'infrastructure, dès lors qu'ils sont significatifs.
- Régressions détectées au cours de la période d'observation.
Relevez la consommation de jetons (tokens) ainsi que la date de la grille tarifaire utilisée en regard des montants facturés. La mise en cache des jetons, les relances et les outils d'exécution influent directement sur les coûts. Ne vous fiez pas uniquement à la longueur du code généré pour estimer la facture.
Si vous appliquez un taux horaire au temps de revue, explicitez-le comme une hypothèse interne. Présentez séparément les dépenses directes et le temps de travail afin que chacun puisse recalculer la comparaison. Une génération moins coûteuse peut très bien exiger une charge d'ingénierie plus importante.
Conserver les éléments d'évaluation au plus près du travail
Sharkly structure le travail autour des agents de programmation. Son workflow documenté articule les Tâches (Tasks), les Agents, les Environnements informatiques (Computers), le contexte d'exécution et la revue humaine. Reportez-vous à la documentation de Sharkly pour connaître la terminologie exacte et la mise en œuvre de la plateforme.
Dans le cadre de cette expérience, intégrez les critères d'acceptation directement dans chaque Tâche, puis rattachez le patch, les résultats des tests et l'issue finale au même enregistrement. Consignez les données de l'évaluation dans une feuille de calcul ou un fichier versionné si cela simplifie vos analyses. Ne présumez pas que la plateforme calculera automatiquement vos métriques expérimentales.
Limitez-vous à un Agent unique pour un essai ciblé. N'introduisez une équipe d'agents (Crew) que si l'évaluation porte expressément sur la coordination. Modifier la structure de l'équipe en cours de route ajouterait une variable supplémentaire.
Les agents exécutent les tâches et fournissent des éléments probants. Il revient aux humains de fixer les critères d'acceptation, d'examiner les changements et d'autoriser la mise en production. Cette séparation reste indispensable, même lorsque le code franchit tous les contrôles automatisés.
Décider de l'adoption par catégorie
Définissez votre règle d'adoption avant de dépouiller les résultats. Exigez d'abord un niveau de conformité satisfaisant, puis comparez les coûts et les délais d'exécution parmi les configurations qui atteignent ce seuil. Écartez du déploiement initial les catégories sensibles pour la sécurité ou celles dont la couverture de tests est insuffisante.
Présentez toujours les effectifs absolus à côté des pourcentages. Deux tâches acceptées sur trois n'ont pas la même portée statistique que deux cents sur trois cents. Décrivez les marges d'incertitude et les profils d'échec au lieu de proclamer un vainqueur indiscutable.
Réitérez l'évaluation dès lors que vous modifiez substantiellement vos invites, vos harnais, les versions du modèle ou l'architecture de votre dépôt. Archivez la configuration précédente pour disposer d'une base de référence reproductible lors de futures améliorations.
Commencez par une tâche de maintenance représentative dans Sharkly, associez-y des critères d'acceptation précis, puis comparez les résultats obtenus à votre flux de travail actuel. Élargissez ensuite la démarche une fois que vous saurez expliquer aussi bien les réussites que les échecs.
FAQ
Un benchmark public de code peut-il remplacer cette évaluation ?
Il peut vous orienter dans la sélection de candidats. Il ne saurait en revanche refléter les conventions de votre dépôt, vos dépendances, vos exigences de relecture ni vos contraintes d'exploitation.
Chaque tentative doit-elle utiliser des invites identiques ?
Fournissez des informations équivalentes sur la tâche et appliquez une politique d'incitation (prompting) définie à l'avance. Consignez les surcouches spécifiques aux outils afin de garder toute différence observable.
Les patchs corrigés doivent-ils être comptabilisés comme des succès ?
Fixez la règle dès le départ. Comptabilisez séparément les validations directes et celles obtenues après correction, et intégrez le temps de retouche dans la comparaison des flux de travail.
Comment évaluer les dépassements de délai ?
Traitez-les comme des échecs dès lors qu'ils excèdent le temps imparti. Incluez leurs coûts et le temps écoulé dans l'analyse des résultats.
Quand l'équipe doit-elle étendre le déploiement ?
Étendez le déploiement dès qu'une catégorie de tâches satisfait à votre règle d'acceptation sur plusieurs essais consécutifs et que les relecteurs maîtrisent ses modes d'échec récurrents.
Ressources complémentaires
Consultez la documentation de Git pour l'isolation des dépôts, le guide des fixtures de pytest pour la mise en place de tests contrôlés, ainsi que Sharkly pour structurer le travail des agents et la revue humaine.