
TL;DR : les limites de débit de GPT-6.2 sont identiques pour Astra et Sol via l’API : 5 000 RPM et 1 000 000 TPM sur le palier Build, 10 000 RPM et 4 000 000 TPM sur Launch, et 15 000 RPM et 40 000 000 TPM sur Grow. Les limites s’appliquent par organisation et par projet, donc tous les agents qui partagent une même clé partagent aussi ces limites. Pour une équipe d’agents, c’est le quota de jetons par minute qui s’épuise en premier, pas les requêtes.
OpenAI a lancé GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Astra est le modèle de pointe réservé aux tâches les plus difficiles ; Sol est le modèle économique du quotidien, conçu, selon les termes d’OpenAI, pour « alimenter des agents à grande échelle ».
Un agent isolé atteint rarement une limite. Six agents sur une seule clé API y arrivent avant midi. Ce guide présente les limites de débit de GPT-6.2, les plafonds des plans Codex, et comment dimensionner une équipe d’agents pour qu’elle se mette en file d’attente au lieu d’échouer. Si vous faites déjà tourner plusieurs agents de codage, Sharkly vous permet de définir combien d’entre eux s’exécutent simultanément.
Limites de débit de GPT-6.2 par palier d’utilisation
GPT-6.2 Astra et GPT-6.2 Sol partagent un même tableau standard de limites de débit, disponible sur la page du modèle Sol et la page du modèle Astra d’OpenAI. RPM désigne les requêtes par minute ; TPM désigne les jetons par minute. Le premier des deux que vous épuisez vous bloque.
| Palier | Accessible à partir de (achats cumulés de crédits) | Limite d’utilisation mensuelle | RPM | TPM |
|---|---|---|---|---|
| Build | 5 $ | 500 $ | 5 000 | 1 000 000 |
| Launch | 100 $ | 5 000 $ | 10 000 | 4 000 000 |
| Grow | 500 $ | 200 000 $ | 15 000 | 40 000 000 |
Les colonnes de qualification et de limite d’utilisation mensuelle proviennent du guide des limites de débit d’OpenAI. Votre palier évolue automatiquement dès que vos achats cumulés de crédits franchissent chaque seuil. La limite d’utilisation mensuelle est distincte des plafonds de dépenses que vous définissez vous-même.
Astra coûte quatre fois plus cher par jeton (8 $ en entrée, 40 $ en sortie par million, contre 2 $ et 10 $ pour Sol), mais sa limite de débit est identique. Ce que vous atteignez dépend du nombre de jetons que vos agents consomment.
Fonctionnement des plafonds d’utilisation de GPT-6.2 dans Codex
Si vos agents passent par Codex via un plan ChatGPT plutôt qu’une clé API, c’est un plafond différent qui s’applique. La page de tarification de Codex d’OpenAI donne les messages locaux par fenêtre de cinq heures sous forme de fourchettes, car la taille des tâches modifie le coût de chaque message.
| Modèle | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6 à 50 | 6 à 50 |
| GPT-6.2 Sol | 17 à 180 | 17 à 180 |
| GPT-6.1 Sol | 15 à 160 | 15 à 160 |
| GPT-6 Astra | 5 à 45 | 5 à 45 |
Quatre détails comptent pour une équipe d’agents :
- Les plans Pro n’ont actuellement aucune limite de cinq heures, mais des limites hebdomadaires peuvent toujours s’appliquer.
- Les messages locaux et les conversations cloud partagent un même quota. Une tâche cloud peut en consommer davantage qu’un message local.
- La vitesse coûte du quota. Le mode rapide consomme 2x l’utilisation incluse sur les modèles GPT-6.2 ; l’ultra-rapide en consomme 6x.
- Les longues sessions coûtent plus cher par message. OpenAI indique que les tâches conservant plus de contexte utilisent « nettement plus » de quota.
Un agent qui a lu la moitié d’un dépôt envoie un contexte volumineux à chaque tour, si bien que son compteur de messages chute vite. Nous avons décrit le même schéma pour les plans d’Anthropic dans Claude Code usage limits, et la réaction à la réduction des limites de Codex Pro suit la même logique.
Pourquoi c’est le TPM, et non le RPM, qui limite une équipe d’agents
Un agent de codage n’envoie pas des milliers de petites requêtes. Il en envoie quelques grosses. À chaque tour, il renvoie toute la conversation jusqu’ici : les instructions, les fichiers lus, les sorties d’outils et son propre raisonnement antérieur.
Prenons un agent illustratif : 80 000 jetons d’entrée par tour et 6 tours par minute. Cela fait 6 RPM et environ 480 000 TPM. Face au palier Build :
- RPM : 6 sur 5 000 utilisés. On en est loin.
- TPM : 480 000 sur 1 000 000 utilisés. Deux agents suffisent à saturer le quota.
Vos chiffres seront différents ; pas le ratio. Les agents sont gourmands en jetons et sobres en requêtes. Pour cet exemple d’agent, le plafond brut est de deux agents par projet sur Build et huit sur Launch. En gardant les 30 pour cent de marge issus des étapes de dimensionnement ci-dessous, cela tombe à un agent sur Build et cinq sur Launch. Sur Grow, la limite de débit cesse d’être votre goulot d’étranglement et c’est le plafond mensuel de 200 000 $ ou votre propre budget qui prend le relais.
Les limites sont partagées au niveau de l’organisation
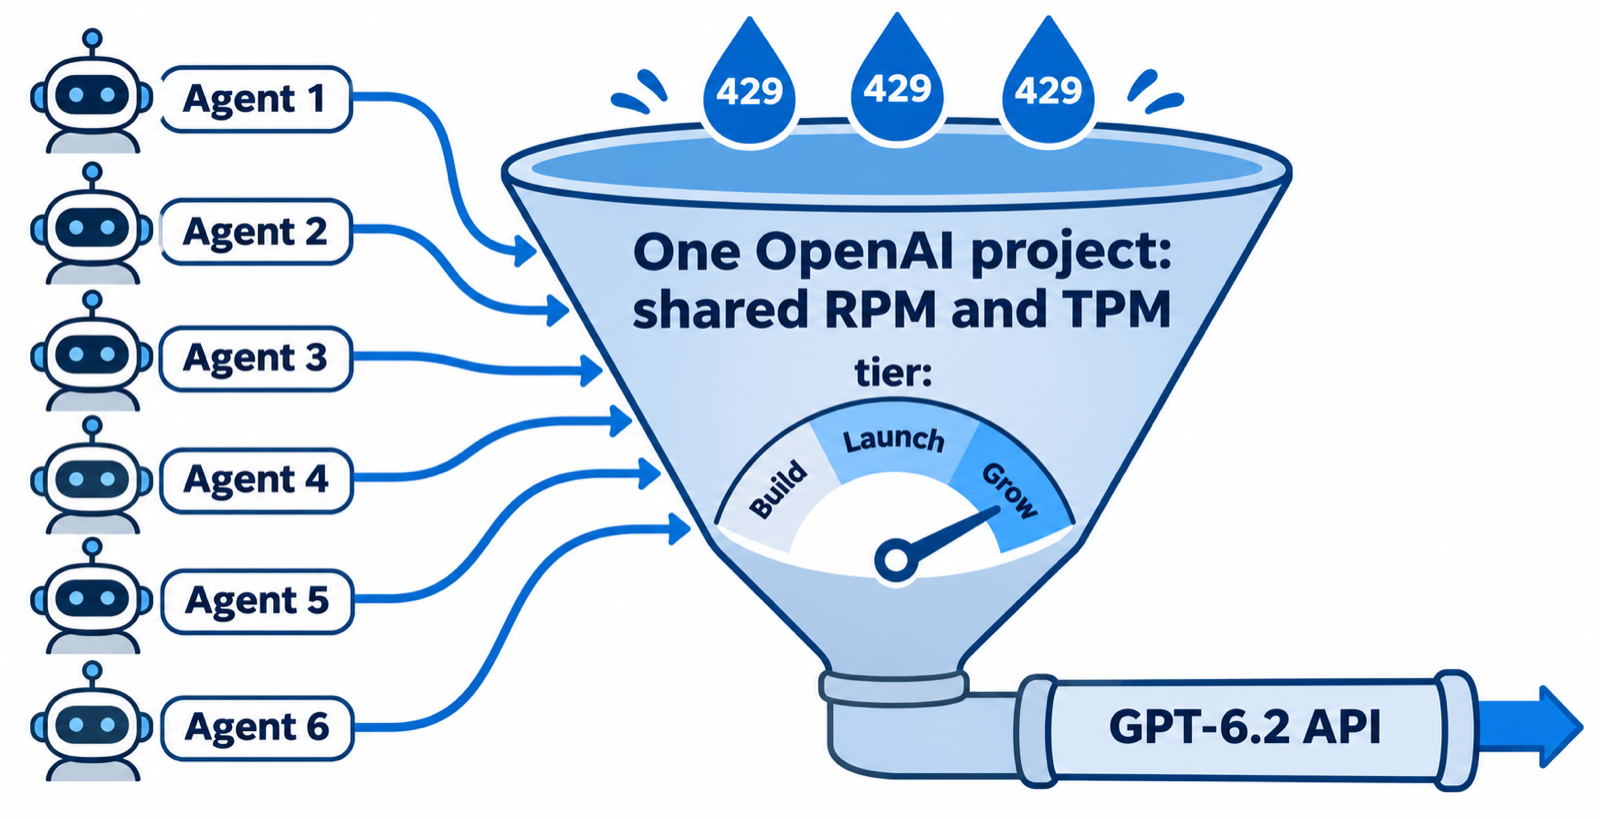
OpenAI définit les limites de débit au niveau de l’organisation et du projet, pas par utilisateur. Chaque agent qui utilise des clés issues d’un même projet puise dans le même réservoir. Certaines familles de modèles ont aussi une limite partagée, indiquée sur votre page des limites, si bien que le trafic vers un modèle peut être décompté d’un autre.
Comment dimensionner la concurrence des agents selon votre palier GPT-6.2
La solution consiste à plafonner le nombre d’agents exécutés simultanément, afin que le travail excédentaire patiente dans une file d’attente au lieu de se heurter à l’API. Voici la démarche qui fonctionne :
- Identifiez votre palier dans Settings, Organization, Limits sur la plateforme OpenAI.
- Mesurez une exécution réelle d’un agent. Notez les jetons d’entrée par tour et les tours par minute dans les statistiques d’utilisation de votre Runtime.
- Divisez votre TPM par le TPM d’un agent et gardez 30 pour cent de marge pour les pics.
- Définissez ce chiffre comme plafond de concurrence pour tous les agents s’appuyant sur le projet.
- Surveillez les erreurs 429 pendant une semaine, puis augmentez le plafond progressivement, étape par étape.
Dans Sharkly, chaque Agent dispose d’un réglage Max concurrency (assigned tasks), d’une Max run duration en minutes et d’un Queue timeout en heures. Quand le plafond est atteint, les nouvelles tâches attendent à l’état Queued jusqu’à ce qu’un créneau se libère. Les chats peuvent partager la même limite, donc une conversation ne peut pas s’y soustraire.

Un Computer possède lui aussi sa propre limite de concurrence de tâches. La documentation Sharkly précise qu’une concurrence plus élevée consomme davantage de CPU, de mémoire, de disque, de capacité fournisseur et de bande passante du dépôt ; n’augmentez donc la limite que lorsque la charge actuelle tourne correctement.
Répartir les agents sur plusieurs projets OpenAI
Les limites au niveau projet vous permettent d’isoler des groupes d’agents. Donnez un projet OpenAI à vos agents de revue et un autre à vos agents de refonte massive. Une refonte incontrôlée atteint alors sa propre limite de projet au lieu d’affamer la revue. La limite d’organisation plafonne toujours le total, ce mécanisme fixe donc des priorités ; il n’ajoute pas de capacité.
Pour un Runtime qui s’authentifie avec une clé API, définissez la clé comme variable d’environnement sur l’Agent. Sharkly injecte les variables d’environnement de l’Agent dans le processus au démarrage. Donnez à chaque groupe d’agents une clé issue de son propre projet OpenAI, afin que son trafic soit compté sur la bonne limite.
Surveiller les jetons par tâche
L’en-tête de l’Agent dans Sharkly affiche les tâches assignées, les exécutions totales et les jetons utilisés. Lisez les jetons par tâche, et pas seulement le total mensuel. Un type de tâche qui consomme trois fois plus de jetons que les autres est le premier candidat à Sol plutôt qu’à Astra, ou à une consigne de tâche plus resserrée.
Déplacer le travail de masse aux heures creuses
Les réglages du Runtime de chaque Agent incluent un interrupteur Working hours pour programmer le travail aux heures creuses. Orientez-le vers la génération de tests, les mises à jour de dépendances et les passes de documentation. Ces tâches tournent la nuit et laissent la capacité de jour au travail que les gens attendent.
Comment gérer une erreur 429 de GPT-6.2
Même avec un plafond, vous verrez parfois une erreur 429. Le guide d’OpenAI est précis sur la conduite à tenir :
- Suivez l’en-tête
Retry-Afterlorsqu’il est présent, et traitez-le comme un minimum. - Sans cet en-tête, utilisez un backoff exponentiel avec un jitter aléatoire.
- Lisez
x-ratelimit-remaining-tokensetx-ratelimit-reset-tokenspour savoir où vous en êtes. - N’imbriquez pas les tentatives : si votre code réessaie, désactivez les tentatives intégrées du SDK, sinon les deux se multiplient.
- Ne réessayez pas en cas d’erreur de quota ou de facturation. Elles exigent une intervention humaine.
Une erreur 503 avec server_is_overloaded signifie que le modèle est occupé, pas vous. Traitez-la avec le même backoff.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra ou Sol : quel modèle exploite le mieux vos limites
Les limites de débit étant identiques, le choix se joue sur la consommation de jetons et le prix. Utilisez Astra pour les changements d’architecture, les bugs difficiles et les longues exécutions autonomes. Utilisez Sol pour tout ce qui est courant. Dans Codex sur Plus, Sol offre environ trois fois plus de messages par fenêtre de cinq heures qu’Astra, ce qui est le signal le plus clair de l’écart de coût.
Une équipe mixte est la réponse habituelle : un agent Astra dirige, plusieurs agents Sol exécutent les morceaux, comme dans GPT-6 Astra as your Crew leader. Le travail courant relève d’un modèle moins cher, c’est la logique derrière GPT-6 Luna pour les 80 pour cent de tâches ingrates.
Autres moyens d’augmenter le débit de GPT-6.2
- Batch API. Elle s’exécute en dehors de vos limites de débit synchrones et coûte 50 pour cent des tarifs standard. Parfaite pour les évaluations et la classification en masse ; inadaptée à un agent interactif.
- Mode arrière-plan avec une fenêtre de
2hou8h. Il est décompté d’une limite de file Batch/Background distincte, et non de votre TPM en direct. - Mise en cache des prompts. L’entrée en cache coûte 0,40 $ par million sur Astra et 0,10 $ sur Sol, une économie substantielle pour les agents qui renvoient le même contexte.
Conclusion
Les limites de débit de GPT-6.2 sont généreuses par requête et strictes par jeton. Pour une équipe d’agents, la limite opérationnelle correspond au TPM de votre palier divisé par ce que consomme un agent, partagé entre tous les agents du projet. Mesurez une exécution, plafonnez la concurrence sous ce chiffre, isolez les groupes d’agents bruyants dans leurs propres projets, et laissez la file d’attente absorber le reste.
Vous pouvez mettre en place ce dispositif avec des scripts et un sémaphore, ou le définir par Agent dans Sharkly. Connectez un Computer, créez un Agent sur Codex avec GPT-6.2 Sol, fixez sa concurrence maximale à 2, et assignez-lui quelque chose d’ingrat. Pour en savoir plus sur l’exécution d’agents en parallèle, consultez How to run 10 AI coding agents at once.
FAQ
Quelles sont les limites de débit de GPT-6.2 ?
Via l’API, GPT-6.2 Astra et Sol partagent les mêmes limites : 5 000 RPM et 1 000 000 TPM sur Build, 10 000 RPM et 4 000 000 TPM sur Launch, et 15 000 RPM et 40 000 000 TPM sur Grow.
GPT-6.2 Astra a-t-il des limites de débit inférieures à celles de Sol ?
Non. OpenAI liste les mêmes RPM et TPM pour les deux modèles à chaque palier. Astra coûte plus cher par jeton, donc il atteint votre budget plus vite, pas votre limite de débit.
Comment passer à un palier d’utilisation OpenAI supérieur ?
Les paliers évoluent automatiquement selon les achats cumulés de crédits : 5 $ pour Build, 100 $ pour Launch, 500 $ pour Grow.
Les limites de débit s’appliquent-elles par clé API ou par organisation ?
Par organisation et par projet. Chaque clé d’un projet puise dans le même réservoir, donc dix agents sur dix clés dans un même projet partagent toujours une seule limite.
Combien de messages GPT-6.2 Astra ai-je droit dans Codex ?
Sur Plus et Standard Business, OpenAI estime 6 à 50 messages locaux par fenêtre de cinq heures pour GPT-6.2 Astra et 17 à 180 pour Sol. Les plans Pro n’ont actuellement aucune limite de cinq heures, mais des limites hebdomadaires peuvent s’appliquer.
Pourquoi mes agents rencontrent-ils des erreurs 429 alors que le RPM semble correct ?
Les agents envoient de grands contextes, donc ils épuisent les jetons par minute bien avant les requêtes par minute. Vérifiez x-ratelimit-remaining-tokens dans les en-têtes de réponse.
Sharkly ajoute-t-il ses propres limites de modèle ?
Non. Sharkly fait tourner les agents de codage que vous utilisez déjà, et le quota des modèles dépend des outils, des plans et des comptes API que votre équipe connecte. Sharkly contrôle le nombre de tâches que chaque Agent exécute simultanément.