
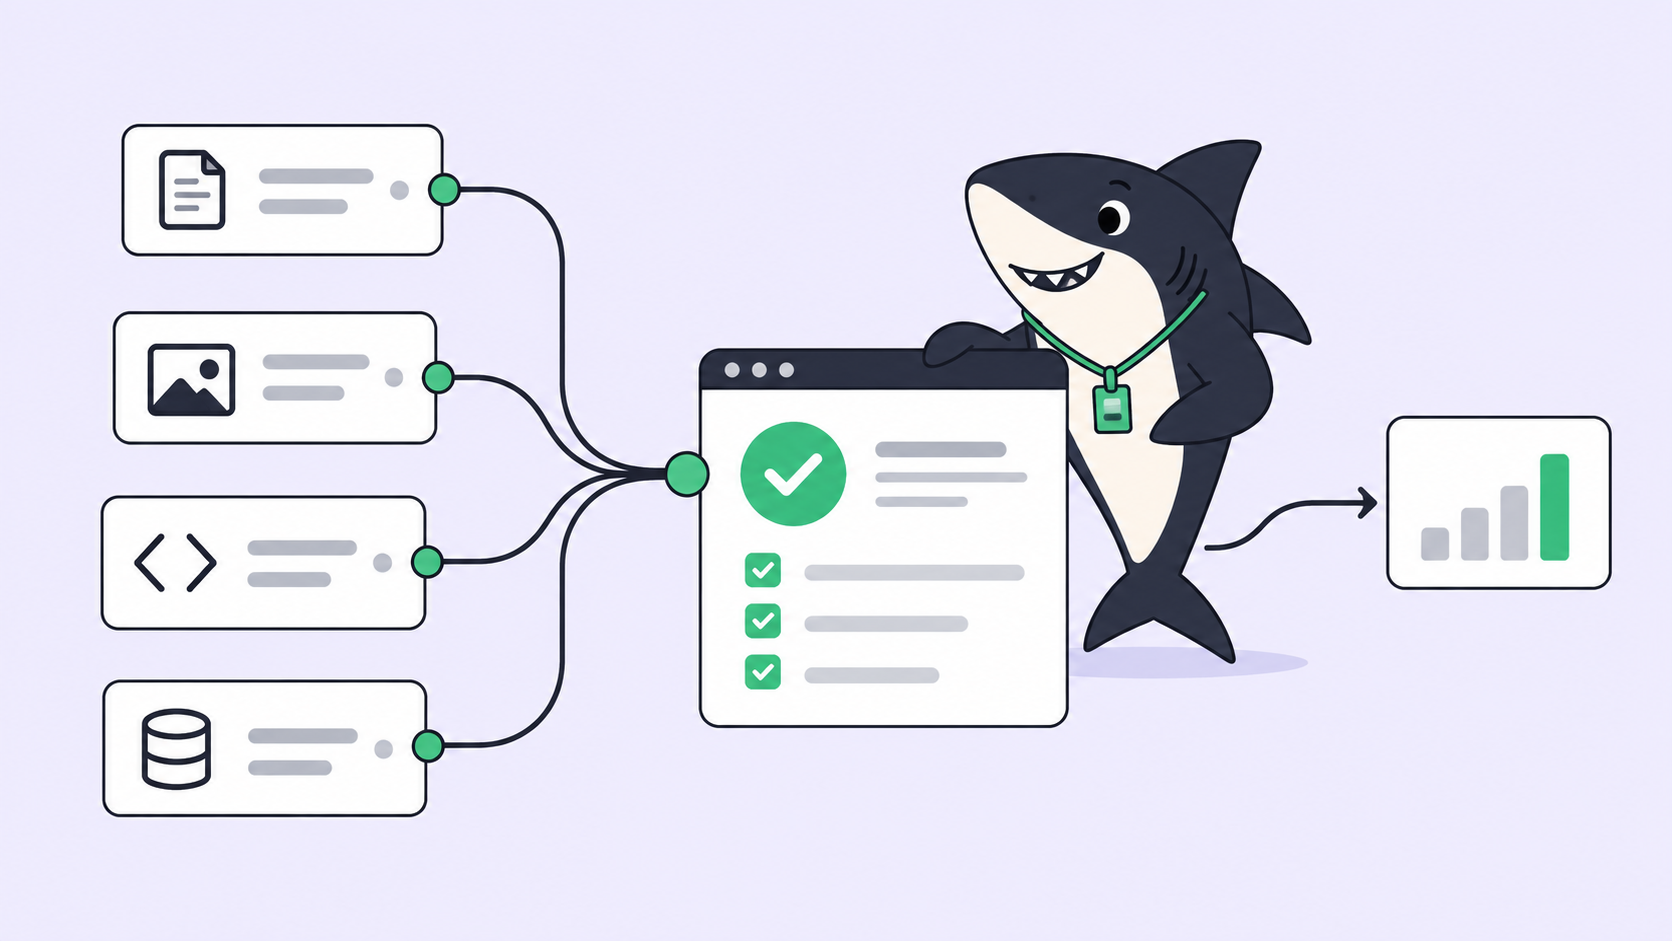
Le tableau tarifaire du 22/09/2026 suggère une architecture évidente. Placez GPT-6 Luna à 0,10 $ par million de tokens d'entrée sur le travail que personne n'aime faire, placez Claude Opus 5.5 à 4 $ sur l'Agent qui le vérifie, et vous conservez l'essentiel du débit pour une fraction de la facture. Beaucoup d'équipes mettent cela en place cette semaine, et la plupart construiront quelque chose qui ressemble à de la relecture sans en être.
L'échec ne vient ni de l'un ni de l'autre modèle. Il vient de ce qui franchit l'écart entre eux. Un relecteur qui lit le résumé que le travailleur fait de son propre travail lit une affirmation, et la seule chose qu'il peut renvoyer est un jugement sur une affirmation. Le diff passe, dit le travailleur. Ça me semble bon, dit le relecteur. Une personne approuve parce que deux modèles sont d'accord, ce qui est le type d'accord le moins informatif qui soit.
La question intéressante dans un Crew multi-modèles n'est donc pas de savoir quel modèle va où. C'est ce que le passage de relais doit transporter.
Qu'est-ce qu'un Crew multi-modèles
Un Crew multi-modèles est un groupe d'Agents où le Runtime est choisi par rôle plutôt que par équipe, et où au moins un rôle n'existe que pour vérifier la sortie des autres.
Un Agent relecteur n'est pas une approbation. C'est un deuxième avis qui a un coût, produit avant qu'une personne ne regarde, afin que la personne lise une liste plus courte. Les Agents font de la recherche, exécutent, testent et rendent compte. Les humains donnent la direction, accordent l'autorité et acceptent le résultat. Ajouter un modèle coûteux au milieu de cette phrase ne déplace pas la dernière proposition.
Les trois paliers, tels que les éditeurs les ont publiés
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| ID API | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Entrée / sortie par million | 4 $ / 20 $ | 2 $ / 10 $ | 0,10 $ / 0,50 $ |
| Entrée mise en cache | 0,20 $ en lecture, 5 $ en écriture | −90 % sur les lectures | −90 % sur les lectures |
| Contexte | 1M | 872k | 1M |
OpenAI décrit Sol et Luna comme 50 % moins chers que le tarif promotionnel de GPT-5.6, et « promotionnel » est un mot qui en dit long : la référence est déjà un tarif réduit. OpenAI affirme également que GPT-6 Astra « reste notre meilleur modèle sur tous les plans ».
Une mise en garde avant que quiconque n'y lise un classement. Le billet de lancement d'OpenAI compare Sol et Luna à Claude Opus 5, car Opus 5.5 n'existait pas lorsque le billet a été rédigé et est sorti quelques heures plus tard, avec un coût d'exploitation inférieur de 40 % à celui d'Opus 5 selon Anthropic elle-même. Personne n'a refait cette comparaison, et les deux éditeurs ne partagent pas le même banc d'essai. Choisissez les rôles en fonction du prix et du comportement observé dans votre propre dépôt.
Ce que chaque éditeur dit de son propre modèle suffit pour attribuer les rôles. Pour Luna, OpenAI annonce 66,6 % sur DeepSWE 1.1 à effort de raisonnement maximal, 93 % moins cher par tâche que Claude Opus 5 et 96 % moins cher que Fable 5, et, à effort plus élevé, un résultat de factualité équivalent à GPT-5.6 Sol pour environ un centième du coût. Voilà un modèle que vous pouvez affecter au volume. Pour Opus 5.5, Anthropic annonce 66,4 % sur Terminal-Bench 4.0, 54,4 % sur FrontierCode v1.1, 81,8 % sur OSWorld 2.0, 128 k de sortie maximale, et une capacité à rester sur une tâche 18 heures ou plus. Voilà un modèle que vous pouvez affecter au jugement.
La lecture, la moitié bon marché d'un modèle coûteux
Si cette architecture résiste au contact de la facture, c'est grâce à la mise en cache, et c'est cette asymétrie qui décide de la conception.
La lecture d'entrée mise en cache d'Opus 5.5 coûte 0,20 $ par million. C'est un vingtième de son propre tarif d'entrée non mise en cache, et le double du tarif non mis en cache de Luna. Sa sortie coûte 20 $ par million, soit quarante fois les 0,50 $ de Luna. Un relecteur qui lit énormément et écrit vingt lignes est donc quasiment gratuit, mais un relecteur qui raconte longuement ne l'est pas.
D'où une règle assortie de sa justification : le relecteur lit tout et ne dit presque rien. Donnez-lui le préfixe du dépôt, les conventions, le diff et le paquet décrit ci-dessous, puis plafonnez ce qu'il renvoie.
Le côté travailleur met aussi en cache. GPT-6 augmente les taux de succès de cache par défaut avec une remise de 90 % sur les lectures d'entrée mises en cache, ajoute des points de rupture explicites pour que vous choisissiez où se termine un préfixe mis en cache, et n'invalide plus le cache lorsque vous changez l'effort de raisonnement ou la disponibilité des outils. GitHub rapporte plus de 50 % de tokens de prompt en moins à traiter à neuf sur des milliards de requêtes. Pour une flotte de travailleurs Luna qui relisent le même dépôt toute la journée, cela représente l'essentiel de la facture.
Ce que le passage de relais doit transporter
Voici l'artefact, un modèle de passage de relais conçu pour un lecteur modèle. Un travailleur le renvoie à la Task lorsqu'il s'arrête, et le relecteur ne lit que cela plus le diff.
SH-312  Add retry with backoff to the webhook sender
Worker:   Agent "backend-worker" - Runtime Codex on gpt-6-luna
Attempts: 2 (attempt 1 failed on lint)
Diff:     4 files, +118 / -12   (worktree sh-312, commit a91f4c2)

Commands run, verbatim:
  $ pnpm lint            exit 0
  $ pnpm typecheck       exit 0
  $ pnpm test -- sender  exit 0   14 passed, 0 failed, 3 skipped
  $ pnpm build           exit 0

Not done:
  - The 3 skipped tests need a live webhook endpoint. Not run.
  - Did not touch the queue consumer, which has the same bug.

Assumptions made:
  - Max 5 retries, ceiling 30s. No spec said. Copied the values
    already used in payments/retry.ts.

Stopped because: acceptance criteria met.
Quatre propriétés rendent ce paquet digne de ses tokens.
Ce sont des artefacts, pas un récit. Les commandes et les codes de sortie peuvent être réexécutés. « J'ai vérifié le comportement » ne peut être contrôlé par personne.
Il indique ce qui n'a pas été fait. Les tests ignorés et le consommateur non touché sont les deux choses qu'un résumé aurait laissées de côté, et ce sont les deux choses dont un relecteur a le plus besoin. Demandez explicitement les absences, sinon un résumé bien propre ne les contiendra pas.
Il consigne les hypothèses. Toute Task délimitée contient une décision que la spécification n'a pas prise. Écrite, c'est un point de revue. Omise, c'est une surprise en production un mois plus tard.
Il nomme une raison d'arrêt. Terminé, bloqué, budget épuisé et échec après deux tentatives se ressemblent à l'identique dans un dépôt et signifient des choses différentes sur un tableau de suivi.
Ce que renvoie le relecteur
REVIEWER  Agent "review" - Runtime Claude Code on claude-opus-5-5
Reads:  repository prefix (cached), the packet, the full diff
Writes: at most 20 lines

VERDICT      changes requested
CHECKED      4 commands re-run, all exit 0. Backoff ceiling honoured.
UNVERIFIED   3 skipped tests. No evidence the retry path ever runs.
BLOCKING     Retry wraps the 4xx branch. A 422 will be retried 5 times.
FOR A PERSON Queue consumer has the same bug and is out of scope.
             Split SH-312, or widen it?
C'est la ligne UNVERIFIED qui justifie le prix du relecteur. Un travailleur bon marché ne vous dira pas lesquelles de ses affirmations ne reposent sur rien, en partie parce qu'il ne le sait pas. Un modèle coûteux qui lit un paquet structuré peut séparer ce qu'il a confirmé de ce qu'il a pris pour argent comptant, et cette séparation est le produit de l'étape de relecture. La ligne FOR A PERSON constitue l'autre moitié : le relecteur ne décide pas du périmètre, il renvoie la question à la Task.
La frontière qui garde cela honnête : un Agent relecteur peut réexécuter des commandes, lire le diff et signaler la différence entre preuve et assertion. Il ne peut pas vous dire si c'était la bonne fonctionnalité. Ce qu'un Agent de revue peut et ne peut pas vérifier est une liste figée, et elle raccourcit, elle n'allonge pas, quand le relecteur est coûteux.
Deux modes de défaillance à surveiller
La latence arrive en premier, et elle est contre-intuitive. Artificial Analysis, un tiers plutôt que l'un des deux éditeurs, a mesuré les variantes de raisonnement « max » à 124,23 secondes jusqu'au premier token pour Luna et 102,15 secondes pour Sol. [VERIFY] Vérifiez ces chiffres par rapport à la fiche actuelle avant de vous y fier. La forme importe plus que les chiffres : à effort de raisonnement élevé, les modèles bon marché ne sont pas ceux qui démarrent le plus vite, si bien qu'un Crew multi-modèles a des travailleurs qui semblent bloqués et un relecteur qui les attend. C'est un problème de statut, pas un problème de modèle.
Le volume de relecture vient en second. Dix travailleurs Luna produisent dix paquets. Si le relecteur en approuve neuf et en escalade un, vous avez converti dix exécutions d'agents en une seule décision humaine, ce qui est précisément le but. S'il en escalade six, vous avez payé la relecture et vous devez encore six décisions, alors que la file de relecture était déjà le goulot d'étranglement. Suivez le taux d'escalade par Agent travailleur pendant un Sprint. Il vous dit si le paquet est trop mince ou les Tasks trop grosses, bien avant que la facture ne le fasse.
Quand ne pas faire cela
Utilisez un seul modèle pour tout lorsqu'une personne fait tourner un ou deux Agents sur un seul dépôt. Le paquet est une surcharge, le relecteur est une seconde facture, et c'est vous le relecteur de toute façon.
Utilisez un Crew multi-modèles lorsque plusieurs Agents tournent en parallèle, lorsque plus d'une personne peut lancer une exécution, ou lorsque le travail terminé a dépassé le temps dont quiconque dispose pour le lire.
Et ne mettez pas le modèle coûteux en relecture quand le travail lui-même est la partie difficile. Une migration qui doit tenir le contexte pendant des heures a sa place directement sur Opus 5.5, avec un Agent bon marché qui rédige le paquet ensuite. Choisir par rôle, c'est choisir par Task, et non une fois pour toute l'équipe : c'est pourquoi associer les modèles aux rôles d'agent est une règle que l'on écrit noir sur blanc plutôt qu'une habitude que six personnes gardent pour elles.
Le chiffre qui n'a pas bougé
Le coût par tâche terminée a chuté fortement des deux côtés de ce lancement. OpenAI indique que son chercheur médian dépense plus de 600 $ par jour en agents de codage, le 90e percentile dépassant 7 000 $. Les équipes sous cette ligne peuvent désormais se permettre plusieurs fois plus de travail d'agents que la semaine dernière.
Les heures de relecture, elles, n'ont pas bougé d'un iota. Un Crew multi-modèles justifie son existence en transformant davantage de production bon marché en moins de décisions humaines, et cela n'arrive que si le passage de relais transporte des preuves plutôt qu'un résumé. Gardez l'objectif, le diff, les commandes, les blocages, les affirmations non vérifiées, et la relecture humaine qui revient à la Task de la demande à la livraison : la répartition des modèles devient alors un réglage que vous pouvez modifier le trimestre suivant sans changer la façon de travailler de quiconque.
Sharkly ne fait pas tourner le modèle et ne le choisit pas à votre place. C'est la couche partagée de Task, de Computer, de contexte et de relecture autour des outils qui s'en chargent, l'endroit où un passage de relais doit vivre si un relecteur et une personne doivent tous deux le lire. Si vous faites déjà tourner plusieurs agents de codage : connectez un Computer, créez un Agent travailleur et un Agent relecteur, et faites renvoyer ce paquet par le travailleur sur une tâche ennuyeuse.


