
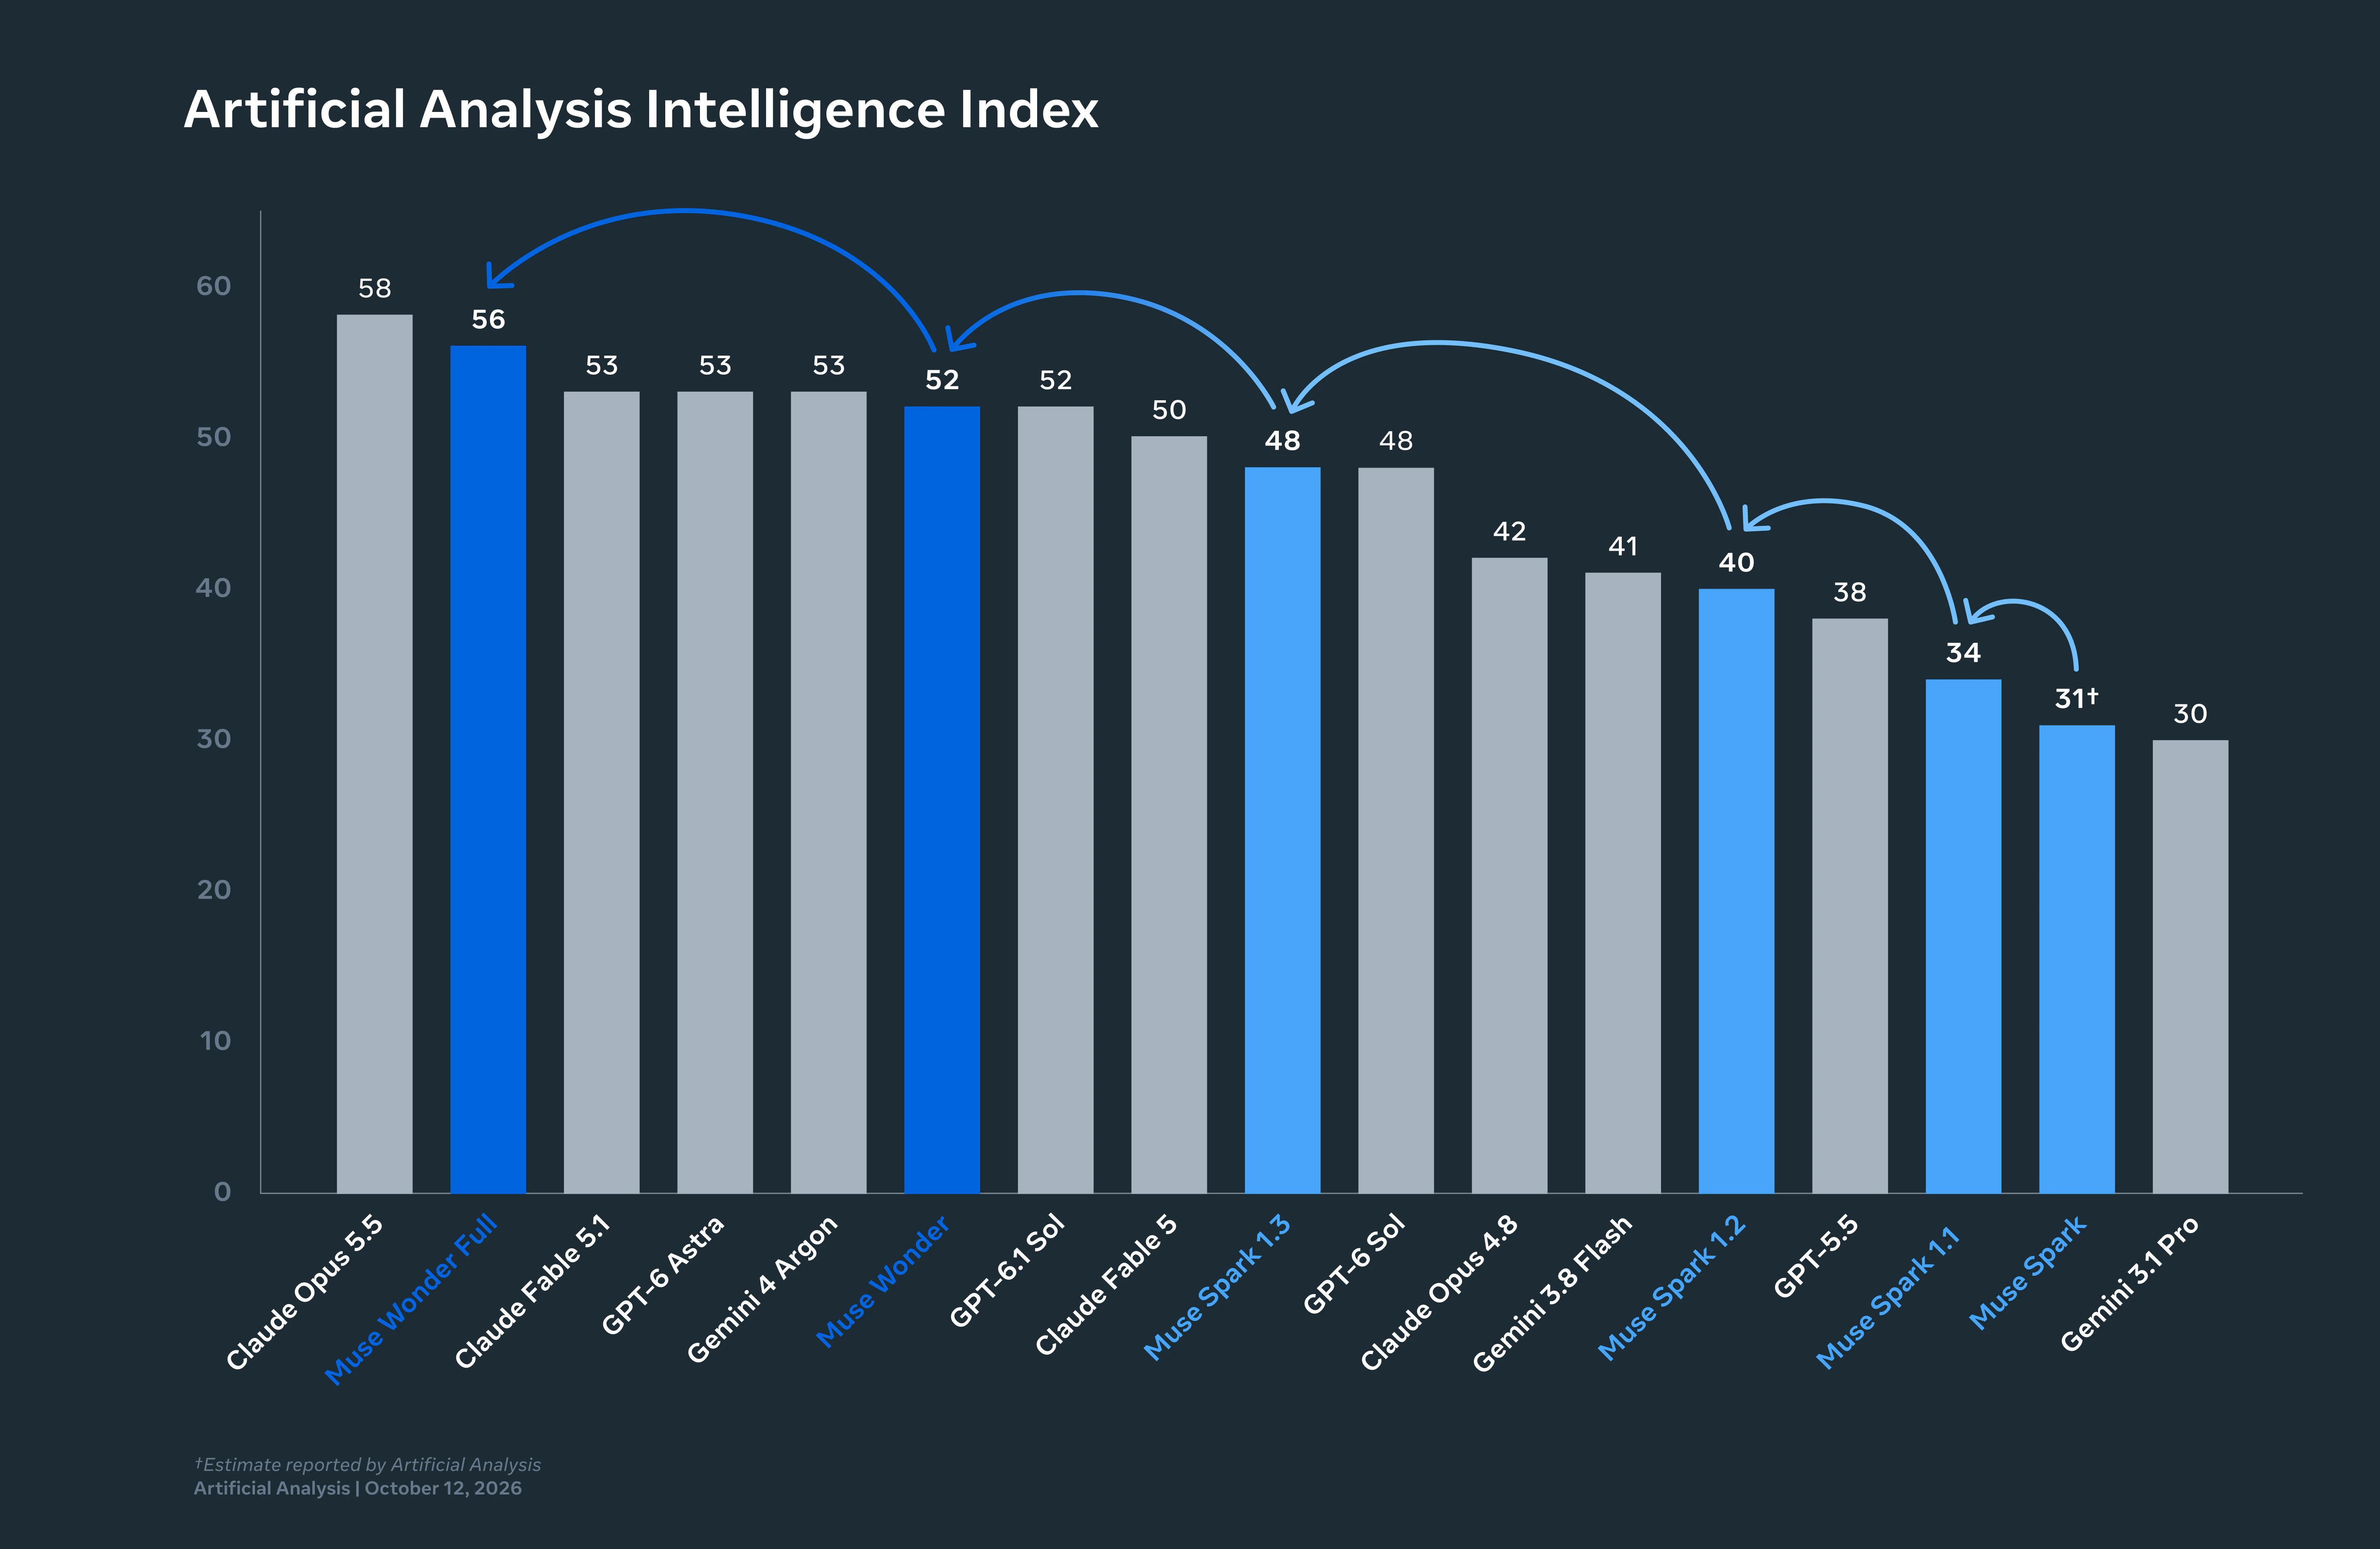
Muse Wonder et Claude Opus 5.5 affichent le même tarif : 4 $ par million de tokens en entrée et 20 $ par million de tokens en sortie. Pour une Crew, le choix entre les deux n’est donc pas une question de budget, mais une règle de routage. La fiche modèle de Meta place Wonder en tête sur le benchmark évaluant les tâches de code de longue durée (SWE-Marathon, 53,1 contre 46,3), tandis qu’Opus mène sur le travail dans le terminal (59,6 contre 52,0), l’intelligence générale (58 contre 52 sur l’indice indépendant) et les connaissances factuelles (46 contre 25). Ces quatre chiffres caractérisent deux Agents bien distincts ; un board qui orchestre leurs tâches en fonction de ces forces tire bien meilleur parti de chacun qu’un board s’en remettant à un choix par défaut.
Cet article traduit ces chiffres en critères d’attribution : quelles Tâches confier à un Agent Muse Wonder, lesquelles réserver à Opus 5.5, quel impact chacun produit sur la file de relecture, et comment vérifier au bout d’une semaine si la règle porte ses fruits. La configuration du couloir Meta est détaillée dans le guide comment exécuter des agents Muse Wonder dans Sharkly.
Les chiffres qui comptent pour le routage
| Métrique | Muse Wonder | Claude Opus 5.5 | Source |
|---|---|---|---|
| SWE-Marathon (sessions de code longues) | 53.1 | 46.3 | Fiche modèle Meta |
| DeepSWE 1.1 | 78.8 | 74.2 | Fiche modèle Meta |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Fiche modèle Meta |
| AA-Omniscience (connaissances) | 25 | 46 | Artificial Analysis |
| Taux d’hallucination | 27% | plus bas, selon le classement AA | Artificial Analysis |
| Indice d’intelligence | 52 | 58 | Artificial Analysis |
| Indice Coding Agents | 63 | 66 (Claude Code) | Artificial Analysis |
| Coût par tâche de référence | $4.52 | $5.98 | Artificial Analysis |
| Entrées | Texte, image, vidéo, audio | Texte, image, PDF | Documentation fournisseur |
Voyez ce tableau comme deux profils distincts. Wonder : persévérant, plus économique par tâche grâce à des réponses concises, mais limité sur la restitution de connaissances, tout en acceptant la vidéo et l’audio. Opus : globalement plus intelligent, bien plus à l’aise dans un shell, disposant d’une culture technique plus large, mais plus coûteux par tâche. Aucun profil n’est intrinsèquement supérieur à l’autre ; ils répondent simplement à des Tâches différentes.
Les Tâches taillées pour l’Agent Muse Wonder
Leur point commun : des sessions longues semées d’embûches. Meta a entraîné ce modèle selon une approche qualifiée d’« Active Focus », qui consiste à explorer des alternatives et à surmonter méthodiquement les blocages — ce qu’évalue précisément le benchmark SWE-Marathon.
- Les refactorisations multifichiers avec une suite de tests à maintenir au vert. Des opérations en de nombreuses étapes, toutes vérifiables, où les échecs nécessitent d’essayer une deuxième puis une troisième approche.
- Les migrations de dépendances et de frameworks. L’archétype de la tâche au long cours : mettre à niveau, casser, corriger, recommencer — où l’agent doit impérativement persister au-delà de la dixième tentative.
- Les boucles de correction et de vérification face à des suites de tests instables (flaky). Des exécutions où il faut distinguer un bug introduit par l’agent d’une instabilité propre à la suite de tests.
- Les tâches nécessitant des entrées vidéo ou audio. Un enregistrement d’écran illustrant un bug, ou l’enregistrement d’une réunion précisant les spécifications. Opus 5.5 ne prend pas en charge ces formats.
Formulez vos critères d’acceptation de façon à ce que l’agent puisse les vérifier de manière autonome. Wonder donne le meilleur de lui-même lorsque la Tâche indique « tous les tests de packages/api passent et le journal des modifications comporte une entrée », mais perd ses moyens lorsqu’on lui laisse déterminer seul ce qui constitue un travail terminé.
Les Tâches à réserver à Opus 5.5
- Le travail axé sur le terminal. Scripts d’infrastructure, pipelines de déploiement, ou toute tâche où l’agent opère directement dans un shell. Sept points et demi d’écart sur Terminal-Bench représentent une différence bien réelle.
- Tout ce qui repose sur des connaissances encyclopédiques. Un score Omniscience de 25 contre 46 signifie que Wonder a deux fois plus de risques d’ignorer une information clé. Pour les API de bibliothèques peu courantes, les codes d’erreur obscurs ou les règles métier pointues, Opus répond de mémoire là où Wonder doit chercher ou deviner.
- Le rôle de relecteur. L’Agent chargé d’examiner le diff produit par un autre Agent pour valider sa pertinence doit être le plus affûté de votre dispositif. Sur l’indice global, c’est Opus qui s’impose, et le modèle architectural mixed-model Crew attribue déjà ce rôle au modèle premium.
- Les Tâches courtes et précises. Sur DeepSWE, les deux modèles sont au coude-à-coude, mais Opus domine sur l’intelligence générale. Si l’exécution ne dure que dix minutes, l’atout de persévérance de Wonder n’a pas le temps d’opérer.
L’impact de chaque modèle sur la file de relecture
Aiguiller les tâches modifie la nature même des éléments soumis aux relecteurs — et c’est là que réside le véritable coût.
Sur une tâche de longue haleine, une exécution menée par Wonder suit un parcours plus étendu : davantage d’essais, de retours en arrière et de commits. C’est le modèle qui joue pleinement son rôle, mais cela signifie aussi que le diff ne reflète pas toute l’histoire. Le relecteur a besoin du journal d’exécution ; c’est pourquoi les instructions fournies à l’Agent doivent lui demander de consigner l’historique continu de ses tentatives. Le principe selon lequel la relecture humaine constitue le véritable goulot d’étranglement prend ici tout son sens : un modèle persistant génère plus de matière à relire par Tâche, et non l’inverse.
Le déficit de connaissances de Wonder se manifeste par des affirmations erronées formulées avec aplomb : un flag inexistant, une méthode renommée deux versions plus tôt. Son taux d’hallucination reste faible pour sa catégorie — 27 % selon la mesure d’Artificial Analysis —, mais 27 % n’est pas négligeable. Donnez pour instruction à l’Agent de vérifier dans le dépôt toute information sujette à caution et de signaler ce qu’il n’a pas pu confirmer, puis demandez au relecteur d’effectuer un contrôle ciblé sur ces lignes précises.
Pour une Tâche identique, une exécution confiée à Opus produit généralement un cheminement plus direct, plus tranché, assorti d’une facture plus élevée par tâche. La relecture est en revanche plus rapide par cycle. Toutefois, face à une Tâche longue truffée de blocages, Opus a davantage tendance à s’arrêter en cours de route. Cela introduit un autre type d’élément dans la file d’attente : une Tâche restituée à moitié terminée et dont le périmètre doit être redéfini.
Trois cas concrets de routage
Des exemples concrets facilitent la mise en pratique de cette règle au moment d’attribuer le travail.
« Mettre à niveau l’ORM de la v5 vers la v7 sur l’ensemble des services ; tous les tests d’intégration doivent passer. » Wonder. Des dizaines d’étapes, une suite de tests qui échouera différemment à chaque palier, et une ligne d’arrivée clairement tracée. L’opiniâtreté du modèle devient ici un atout majeur, d’autant que l’exécution peut valider d’elle-même les critères d’acceptation.
« Rédiger le code Terraform pour le nouvel environnement de préproduction et l’appliquer. » Opus. Une forte composante shell, des connaissances pointues en infrastructure et une action lourde de conséquences. Terminal-Bench penche clairement pour Opus ; quant au rayon d’impact potentiel, il impose que l’Agent suspende son action pour demander confirmation avant tout apply, quel que soit le modèle sélectionné.
« Expliquer pourquoi le webhook de paiement se déclenche deux fois et proposer un correctif. » Opus pour l’explication, car cela requiert de comprendre la sémantique de relance du prestataire — un pur exercice de restitution de connaissances. Si la solution proposée débouche sur une modification multifichiers assortie de tests, cette Tâche consécutive pourra alors être confiée à Wonder.
La logique générale : Wonder pour les Tâches définies par un objectif final mesurable, Opus pour celles définies par l’étendue des connaissances requises. Lorsqu’une Tâche combine les deux aspects, découpez-la. Sharkly est précisément pensé pour ce découpage : une Tâche par Agent et par couloir, le passage de relais étant consigné sur le board plutôt que conservé dans la tête de quelqu’un.
Exploiter les deux modèles et analyser les résultats
Appliquez cette règle sur votre board pendant une semaine et laissez les Tâches trancher.
- Créez l’Agent Muse Wonder et conservez l’Agent Opus 5.5. Dans les instructions de chaque Agent, demandez d’indiquer l’identifiant du modèle en tête de rapport, car Sharkly ne l’affiche pas nativement.
- Attribuez les tâches selon la règle définie ci-dessus, et non par préférence personnelle. Les tâches longues et complexes à Wonder, le travail en terminal et les tâches axées sur les connaissances à Opus, la relecture à Opus.
- Au terme de la semaine, extrayez les Tâches traitées par chaque Agent et évaluez trois critères : combien sont revenues avec une question au lieu d’un résultat, combien ont nécessité une seconde exécution, et combien de commentaires de relecture chacune a suscités.
Si les Tâches longues de Wonder se clôturent avec moins de réexécutions et que les Tâches de terminal d’Opus nécessitent moins de corrections, votre règle est pertinente. En revanche, si les Tâches de Wonder entraînent plus de remarques de relecture qu’elles n’évitent de réexécutions, réduisez le champ de ce que vous lui confiez. Les valeurs du tableau ne sont que des moyennes observées sur des benchmarks ; ce sont vos propres Tâches qui constituent le véritable banc d’essai.
Rien de tout cela n’apparaît sur votre facture Sharkly. La consommation des modèles s’impute directement sur les clés Meta et Anthropic paramétrées sur le Computer et, les tarifs publics étant identiques, l’unique variation de coût provient de ce que renvoie le bloc usage à chaque exécution.
Les modèles ont évolué ce mois-ci. Mais le contexte, la progression, les blocages, les résultats et la relecture humaine restent visibles de la demande initiale jusqu’au déploiement. Vous pouvez mettre en place cette organisation manuellement à l’aide de worktrees, ou laisser Sharkly orchestrer l’ensemble du flux de travail.


