

En résumé
Pour router les tâches entre agents IA avec l’API Gemini Decisions, envoyez le titre et la description de la tâche à gemini-decision-1 avec trois questions : un choice pour désigner l’agent qui s’en charge, un score pour évaluer sa difficulté, et un noul pour déterminer si une décision humaine préalable est requise. Assignez automatiquement dès que l’indice de confiance dépasse votre seuil. Dans tous les autres cas, passez le relais à un humain.
Introduction
Toutes les équipes qui font tourner plusieurs agents de code se heurtent à la même corvée : quelqu’un doit lire chaque nouvelle tâche pour décider à qui la confier. L’agent backend ou l’agent frontend ? Le modèle économique ou le modèle de pointe ? La tâche est-elle prête à démarrer, ou une décision reste-t-elle à trancher ?
Le 11 novembre 2026, Google a lancé un outil conçu sur mesure pour cette tâche. L’API Gemini Decisions répond à des questions fermées sous forme de probabilités calibrées plutôt que de texte généré. Google l’utilise au sein de Gemini Notebook pour aiguiller chaque requête vers le niveau de modèle et de réflexion adapté, affirmant avoir ainsi réduit la latence sur les requêtes courantes jusqu’à 40 %.
Cet article montre comment concevoir un routeur similaire pour un tableau d’agents : un seul appel par tâche, trois questions, un seuil, et un passage de relais fluide vers un opérateur humain en cas d’incertitude. Si vous cherchez un tableau d’agents pour le tester, Sharkly propose une version gratuite pour démarrer. Concernant la stratégie de routage elle-même (quelles tâches justifient le recours au modèle le plus puissant), commencez par lire router les tâches des agents selon leur difficulté. Cet article se concentre quant à lui sur l’appel qui met en œuvre cette politique.
Comment fonctionne l’API Gemini Decisions
L’API Gemini Decisions est un point de terminaison qui évalue des questions typées à partir d’une entrée commune, puis renvoie une probabilité ainsi qu’un score de confiance pour chacune d’elles. Comme elle ne produit aucun texte, les tokens de sortie sont toujours à zéro. Votre code peut ainsi directement créer des embranchements logiques à partir de ces valeurs numériques, sans aucune étape de parsing.
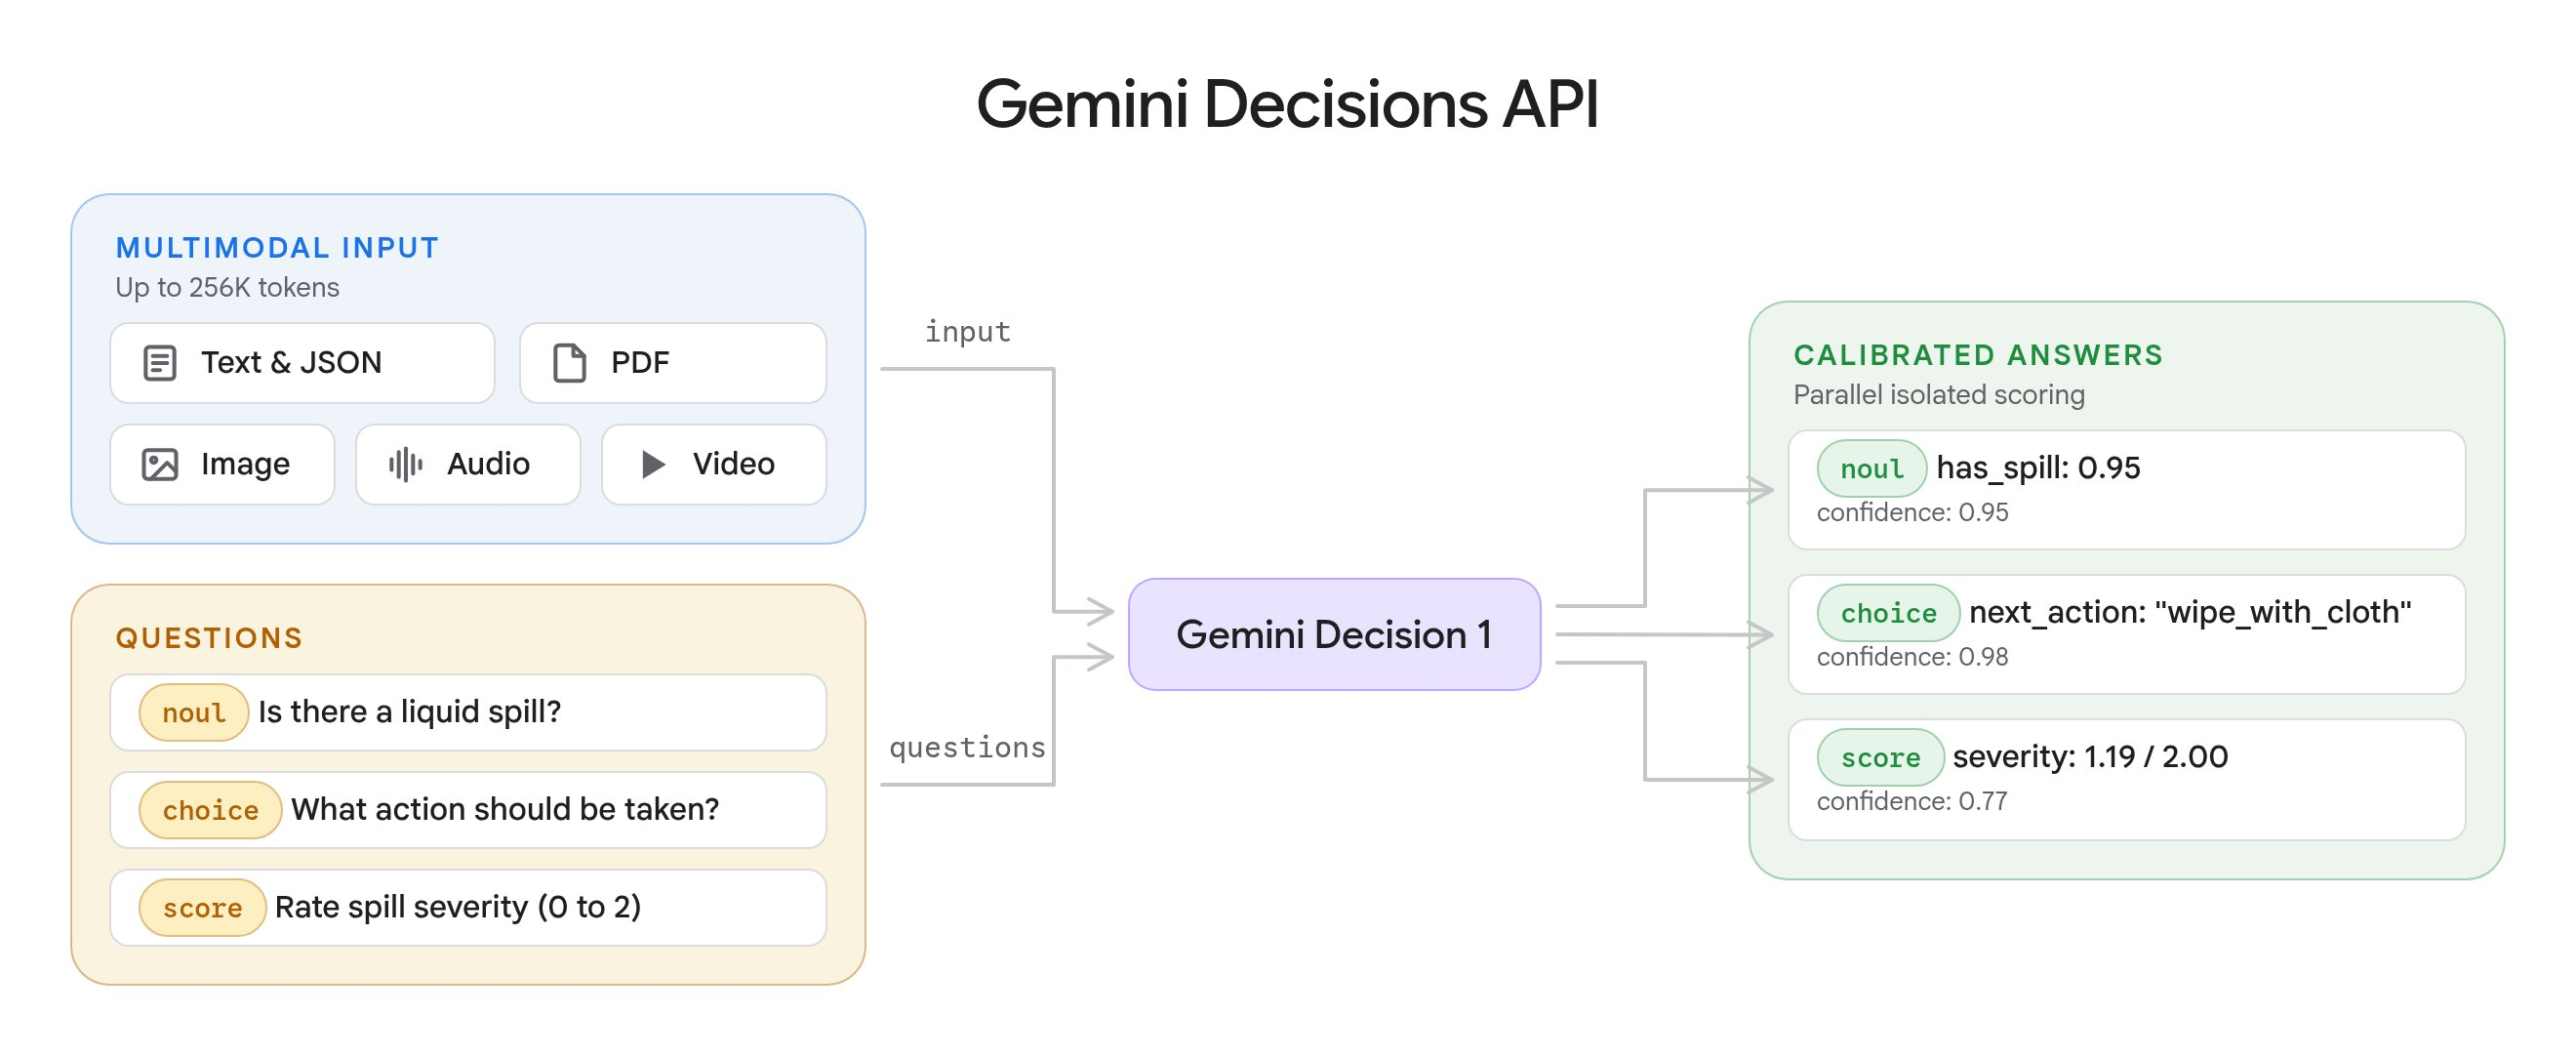
Le routage s’articule autour de trois types de questions :
| Type | Ce à quoi elle répond | Ce qui est renvoyé |
|---|---|---|
choice |
Choisir une option parmi 2 à 255 possibilités | choice, probabilities, confidence |
score |
Évaluer selon une échelle ordonnée | score, probabilities, legend, confidence |
noul |
Oui ou non | noul (0.01 to 0.99), confidence |
Une seule requête peut traiter jusqu’à 1 000 questions pour une même entrée. D’après la documentation de l’API Decisions, les questions sont évaluées en une seule passe avant et restent indépendantes les unes des autres : ajouter une question ne modifie en rien les autres réponses. Google indique une latence de bout en bout de 150 à 250 ms, pratiquement constante de 1 à 100 questions.
Si vous avez lu notre article sur Jev et les modèles de décision pour orchestrer des agents de code, l’approche vous paraîtra familière. La différence réside ici dans la mise en pratique : un modèle hébergé par Google, trois questions explicites et l’intégration directe à un tableau de bord.
L’appel de routage : trois questions par tâche
Voici le routeur. Il nécessite google-genai en version 3.2 ou supérieure et une clé GEMINI_API_KEY issue de Google AI Studio.
import json
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

AGENTS = {
    "backend": "Server code, APIs, database migrations, and backend tests.",
    "frontend": "UI components, styling, client state, and frontend tests.",
    "docs": "README files, docs pages, and changelogs. No code changes.",
    "other": "Work that fits none of the options above.",
}

DIFFICULTY = [
    "Trivial: one file, obvious change, no design decision.",
    "Routine: a few files, follows a pattern already in the repo.",
    "Involved: several modules or a new pattern, needs new tests.",
    "Hard: cross-cutting, touches auth or data migrations, or the spec is thin.",
]

def ask(task):
    state = json.dumps({
        "title": task["title"],
        "description": task["description"][:8000],
    })
    result = client.decisions.create(
        model="gemini-decision-1",
        input=state,
        questions={
            "agent": {
                "type": "choice",
                "instructions": "Which agent should take the task in `title` and `description`?",
                "criteria": AGENTS,
            },
            "difficulty": {
                "type": "score",
                "instructions": "How hard is this task for a coding agent working alone?",
                "criteria": DIFFICULTY,
            },
            "needs_human": {
                "type": "noul",
                "instructions": "Does a person need to make a decision before any agent starts?",
                "criteria": {
                    "true_description": "The spec is ambiguous, contradicts itself, or asks for a product, security, or pricing call.",
                    "false_description": "The spec is clear enough to implement as written.",
                },
            },
        },
    )
    return result.answers
Quatre détails dans ce code proviennent directement de la documentation et peuvent facilement passer inaperçus.
Le modèle ne voit jamais vos clés. Il lit uniquement instructions et criteria ; veillez donc à formuler la question complète dans instructions et à détailler chaque option.
Les clés d’options sont triées par ordre alphabétique. L’API classe les clés de choix selon l’ordre des octets UTF-8 avant de calculer les scores. C’est pour cette raison que l’option fourre-tout s’appelle other et non none_of_the_above, qui se retrouverait triée avant les options réelles.
Les niveaux de score doivent être linéaires. La valeur de score renvoyée est une moyenne pondérée par les probabilités des indices de niveau, soit de 0 à 3 ici. Veillez à ce que les niveaux successifs soient nettement distincts.
Transmettez uniquement ce dont les questions ont besoin. D’après la documentation, inclure des informations superflues dégrade la précision. Le titre et la description s’avèrent généralement bien plus pertinents que l’intégralité du fil de commentaires.
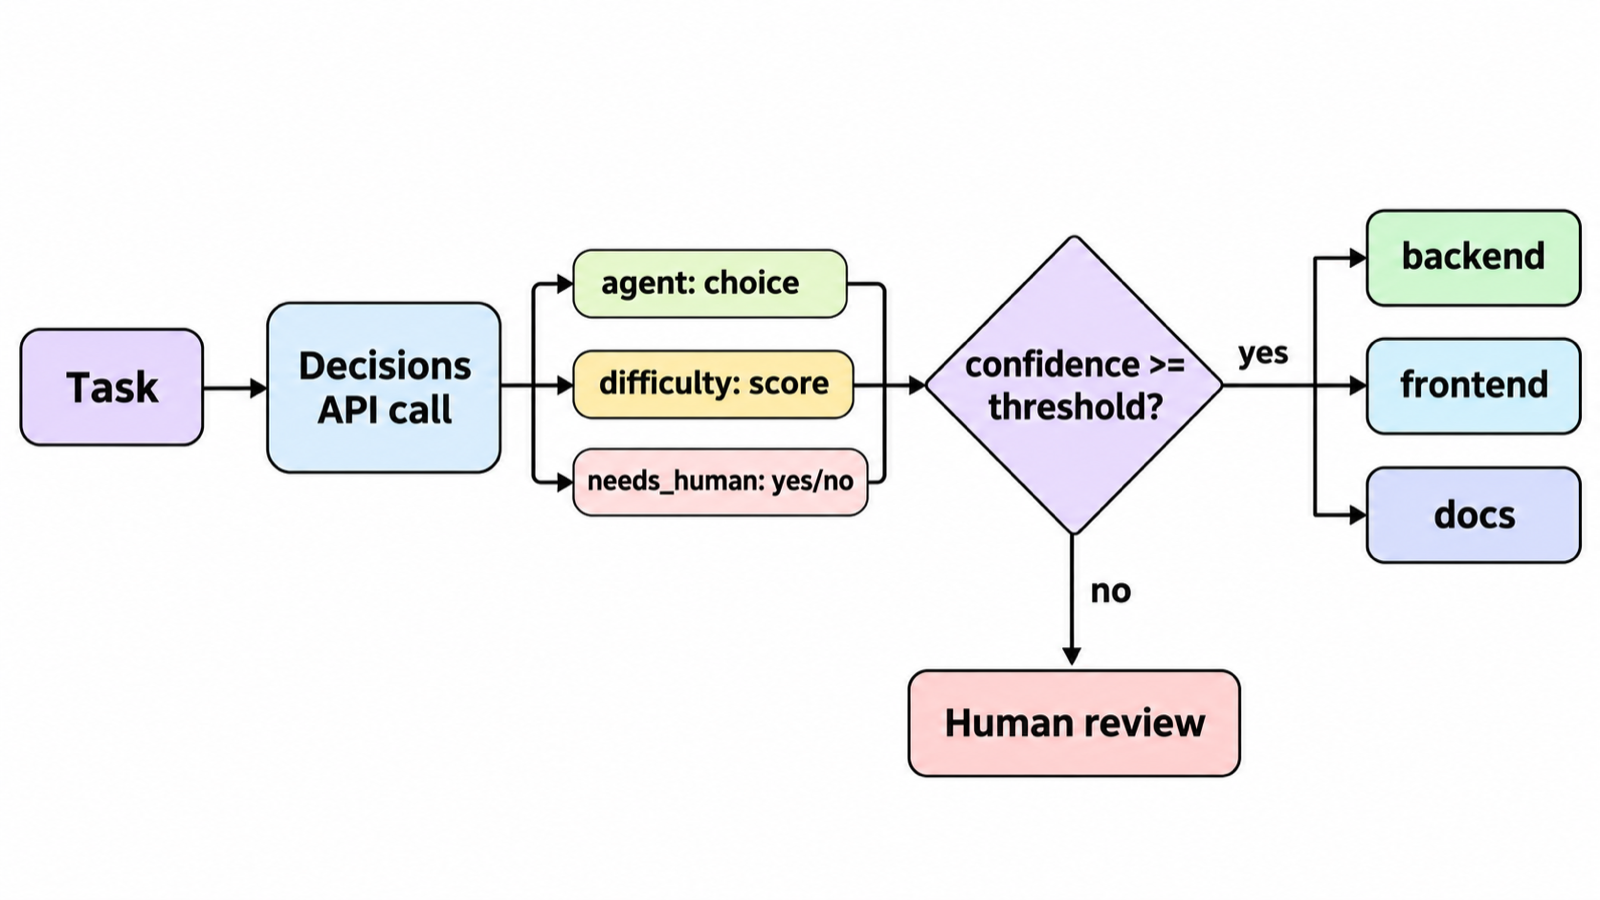
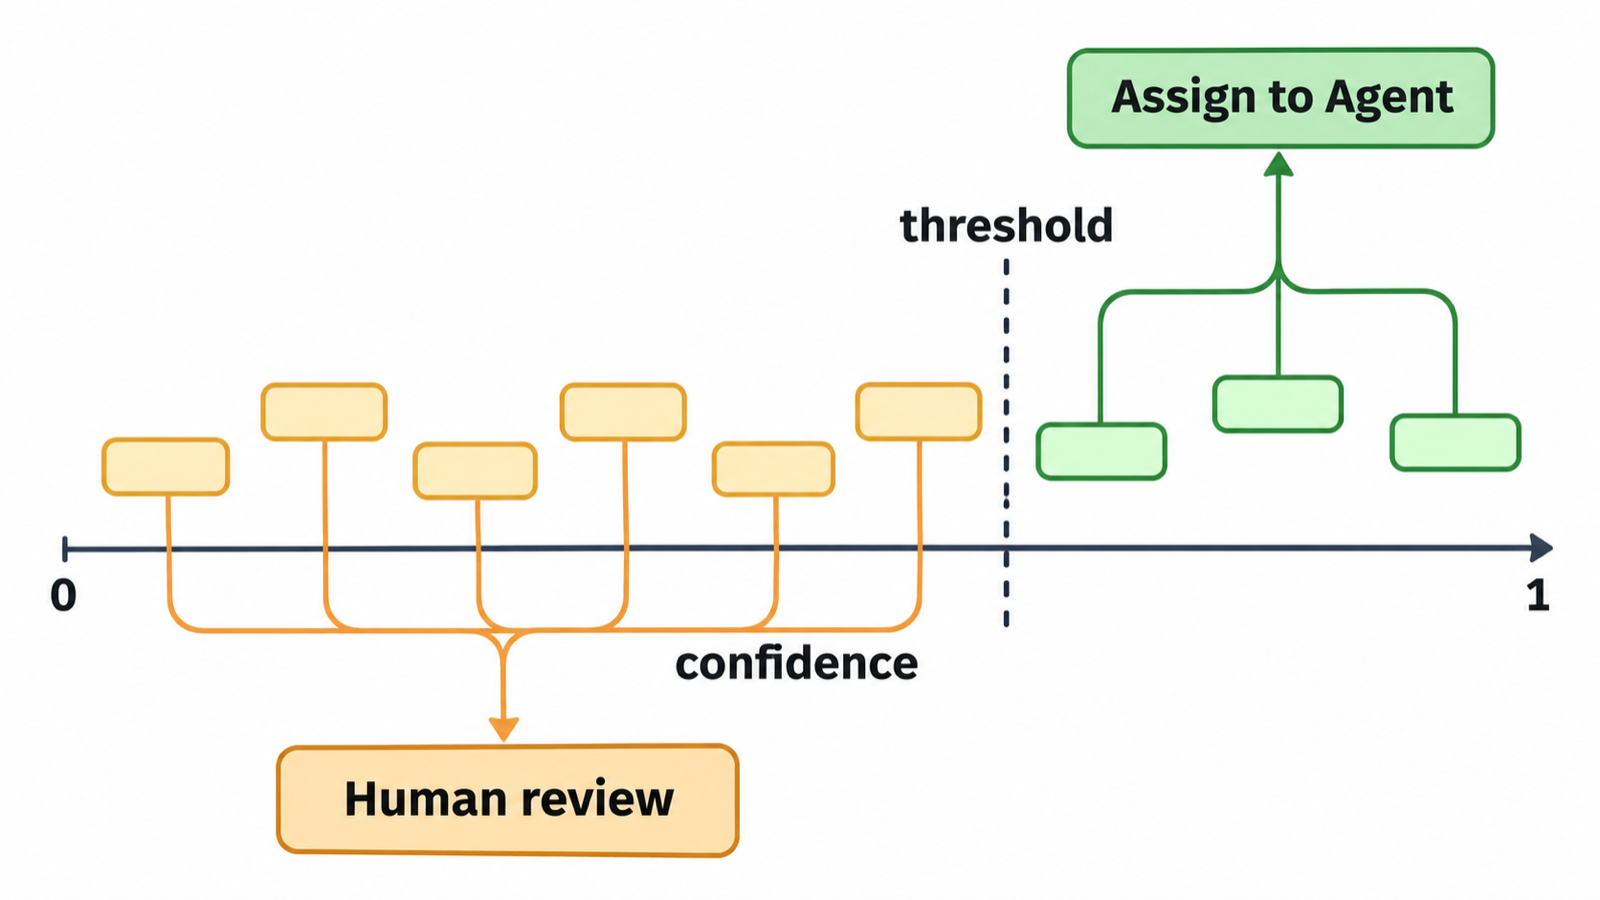
Définir le seuil de confiance à partir de vos propres tâches
La valeur de la réponse indique l’action à mener. Le score de confiance, lui, détermine s’il faut l’exécuter sans intervention humaine. Pour une réponse de type choice, la confiance correspond à la probabilité de la meilleure option. Pour un noul, elle vaut max(noul, 1 - noul).
Voici la couche de décision :
AUTO = 0.75      # assign without a person above this
HARD = 2.4       # difficulty score that earns the strong-model Agent

def decide(a):
    if a["needs_human"].noul >= 0.5:
        return ("human", "needs a decision first")
    if a["agent"].choice == "other" or a["agent"].confidence < AUTO:
        return ("human", f"router unsure ({a['agent'].confidence:.2f})")
    tier = "strong" if a["difficulty"].score >= HARD else "default"
    return (f"{a['agent'].choice}-{tier}", "auto")
Ne reprenez pas la valeur 0,75 à l’aveugle. Google conseille d’ajuster les seuils à l’aide d’exemples étiquetés issus de votre propre activité. Récupérez vos 50 à 100 dernières tâches clôturées, notez quel agent a traité chacune d’elles et soumettez-les à ask(). Choisissez le seuil le plus bas pour lequel les tâches routées automatiquement correspondent aux décisions prises par votre équipe. Un mauvais routage automatique coûte une exécution infructueuse et une réaffectation ; une mise en attente humaine inutile ne coûte que quelques minutes. Pesez ces deux risques l’un par rapport à l’autre plutôt que de viser un chiffre rond arbitraire.
Deux pièges à éviter : la probabilité d’un noul ne dépasse jamais 0,99, si bien qu’un test comme > 0.99 ne se déclenchera jamais. De plus, un score de 1,5 peut signifier « hésitation entre les niveaux 1 et 2 » tout comme « incertitude répartie sur les quatre niveaux ». Dès que la précision compte, pensez à examiner également probabilities.
Intégrer le routeur à un tableau Sharkly
Le routeur n’étant constitué que de Python standard, il s’exécute n’importe où. Sur un tableau Sharkly, le déclencheur le plus propre intervient dès qu’une tâche passe à l’état « prête à être traitée ».
1. Créez un agent par filière et par palier. Par exemple backend-default, backend-strong, frontend-default. D’après la documentation sur les agents Sharkly, chaque agent utilise par défaut le modèle de son environnement d’exécution (Runtime), et la ligne Model vous permet de sélectionner un autre modèle dans le catalogue de cet environnement. C’est précisément là que l’évaluation de la difficulté détermine le choix du modèle.
2. Appliquez la décision avec la CLI sharkly.
import subprocess

def apply(task_id, target, reason, a):
    note = (f"Router: agent={a['agent'].choice} ({a['agent'].confidence:.2f}), "
            f"difficulty={a['difficulty'].score:.1f}, "
            f"needs_human={a['needs_human'].noul:.2f}")
    if target == "human":
        subprocess.run(["sharkly", "task", "comment", task_id,
                        "--body", f"{note}. Held for a person: {reason}."], check=True)
        return
    subprocess.run(["sharkly", "task", "edit", task_id,
                    "--delegate-agent", target], check=True)
    subprocess.run(["sharkly", "task", "comment", task_id, "--body", note], check=True)
Assigner un agent déclenche son exécution dès que la tâche est au statut « prêt ». Consigner les probabilités dans un commentaire est bien plus important qu’il n’y paraît : c’est ce qui vous permettra d’auditer le comportement du routeur dans un mois.
3. Déclenchez le routage lors d’un changement de statut. Une automatisation Sharkly (Automation) regroupe des instructions, un agent assigné et des déclencheurs. Donnez à un petit agent routeur l’instruction « exécuter route.py sur la tâche à l’origine du déclenchement », puis ajoutez un déclencheur de changement de statut configuré sur l’état que votre équipe utilise pour indiquer qu’une tâche est prête. Les exécutions lancées par un tel déclencheur restent rattachées à la tâche en question : l’historique de routage est ainsi conservé avec le travail. Depuis la CLI :
sharkly automation trigger create <automation-id> --kind task_event --to-status "Ready"
Combien coûte un appel de routage
D’après l’article d’annonce de Google, Gemini Decision 1 est facturé 0,10 $ par million de tokens d’entrée et 0 $ pour les tokens de sortie. L’entrée partagée n’est facturée qu’une seule fois par requête, quel que soit le nombre de questions posées.
| Élément | Tokens (estimation) |
|---|---|
| Titre et description de la tâche | 2 000 |
| Trois questions avec critères | 300 |
| Total par appel de routage | 2 300 |
| 1 000 tâches routées | 2,3 M, environ 0,23 $ |
Le routeur coûte moins cher qu’une seule exécution d’agent sur une tâche. Google propose également un niveau d’accès gratuit dans AI Studio pour le prototypage.
Les limites à connaître avant de se lancer
L’API est proposée en version v1beta sur la Gemini Developer API, l’intégration de Gemini dans Google Cloud étant annoncée comme « prochainement disponible ». La documentation précise qu’elle ne prend en charge ni la mise en cache de contexte, ni l’API Batch, ni les modes d’inférence Flex et Priority ; une entrée répétée est donc intégralement décomptée à chaque fois. Les quotas d’utilisation par palier sont détaillés sur la page des limites de débit de Google ; vérifiez les vôtres avant de faire transiter l’ensemble de vos tâches par une unique clé d’API.
Traitez les descriptions de tâches comme des entrées non sécurisées. La documentation avertit qu’un texte saisi par un utilisateur peut tenter d’influencer sa propre classification. Si des personnes externes à votre équipe peuvent créer des tâches, conservez systématiquement une validation humaine pour tout ce qui touche à l’authentification, aux paiements ou aux données de production, quel que soit l’avis du routeur.
Les performances revendiquées par Google (la plus faible erreur d’étalonnage de toute sa gamme, un coût près de 5 fois inférieur à celui de Gemini 3.5 Flash-Lite via l’API Interactions) ne restent que des chiffres fournis par Google. Vos propres tâches étiquetées constituent le seul banc d’essai qui compte réellement.
Quand l’appel de routage n’est pas le bon outil
Utilisez un appel à l’API Decisions lorsque les tâches arrivent plus vite qu’un être humain ne peut les trier et que les options sont prédéfinies : un ensemble d’agents, une échelle de paliers, un filtre binaire oui/non. En revanche, préférez une simple règle déterministe lorsqu’une étiquette tranche déjà la question. Si chaque tâche étiquetée docs est confiée à l’agent de documentation, une instruction if coûte moins cher et ne commet jamais d’erreur.
Tournez-vous plutôt vers un modèle génératif lorsque vous souhaitez que le routeur explique son raisonnement en langage naturel, reformule le cahier des charges ou découpe la tâche en sous-tâches. L’API Decisions renvoie des chiffres, pas du texte. Pour répartir le travail entre plusieurs rôles, un Crew au sein duquel un superviseur décompose l’objectif global sera bien plus approprié ; consultez notre article sur le routage de modèles pour les Crews d’agents.
Conclusion
Le routage relève d’une prise de décision au sein d’un ensemble fini de choix, et l’API Gemini Decisions a précisément été conçue dans cette optique : un appel unique, des réponses typées, un score de confiance quantifiable par seuil et un coût qui ne représente que des fractions de centime. Le reste du travail vous appartient : rédigez des descriptions d’options claires, étalonnez votre seuil à partir de vos tâches passées et redirigez les cas incertains vers un humain.
Commencez par un seul périmètre. Aiguillez les nouvelles tâches backend pendant une semaine, comparez les choix du routeur avec ce que votre équipe aurait décidé, puis élargissez son champ d’action. Pour tester le routeur sur un véritable tableau regroupant agents, automatisations et validation humaine au même endroit, démarrez avec Sharkly.
FAQ
Qu’est-ce que l’API Gemini Decisions ?
Il s’agit d’un point de terminaison de l’API Gemini, lancé le 11 novembre 2026, qui répond à des questions de type oui/non, choix multiple ou score à partir de texte, d’images, de fichiers audio, de vidéos ou de documents PDF. Il renvoie des probabilités étalonnées et un score de confiance plutôt que du texte généré, en s’appuyant sur le modèle gemini-decision-1.
Combien coûte Gemini Decision 1 ?
Google affiche un tarif de 0,10 $ par million de tokens d’entrée et 0 $ pour les tokens de sortie, l’entrée commune n’étant facturée qu’une seule fois par requête. Un niveau gratuit est accessible sur Google AI Studio pour le prototypage.
Combien de questions une seule requête peut-elle comporter ?
Entre 1 et 1 000 questions, dans la limite d’une fenêtre de contexte de 262 144 tokens englobant l’entrée et l’ensemble des questions. Les questions de type choix acceptent de 2 à 255 options.
Quel seuil de confiance devrais-je utiliser pour le routage ?
Il n’existe pas de valeur universelle. Google recommande de définir les seuils à partir d’exemples étiquetés issus de votre propre activité. Rejouez 50 à 100 tâches clôturées et choisissez le seuil à partir duquel les choix automatiques coïncident avec ceux de votre équipe.
L’API Decisions peut-elle choisir le modèle utilisé par un agent ?
Indirectement. Posez une question de type score pour évaluer la difficulté, puis associez les scores élevés à un agent configuré avec un modèle plus puissant. Dans Sharkly, chaque agent peut être associé à un modèle issu du catalogue de son environnement d’exécution.
L’API Gemini Decisions est-elle disponible sur Vertex AI ?
Pas encore. L’article de lancement de Google indique que la prise en charge de Gemini dans Google Cloud est prévue prochainement. À l’heure actuelle, elle fonctionne sur la Gemini Developer API en version v1beta.

