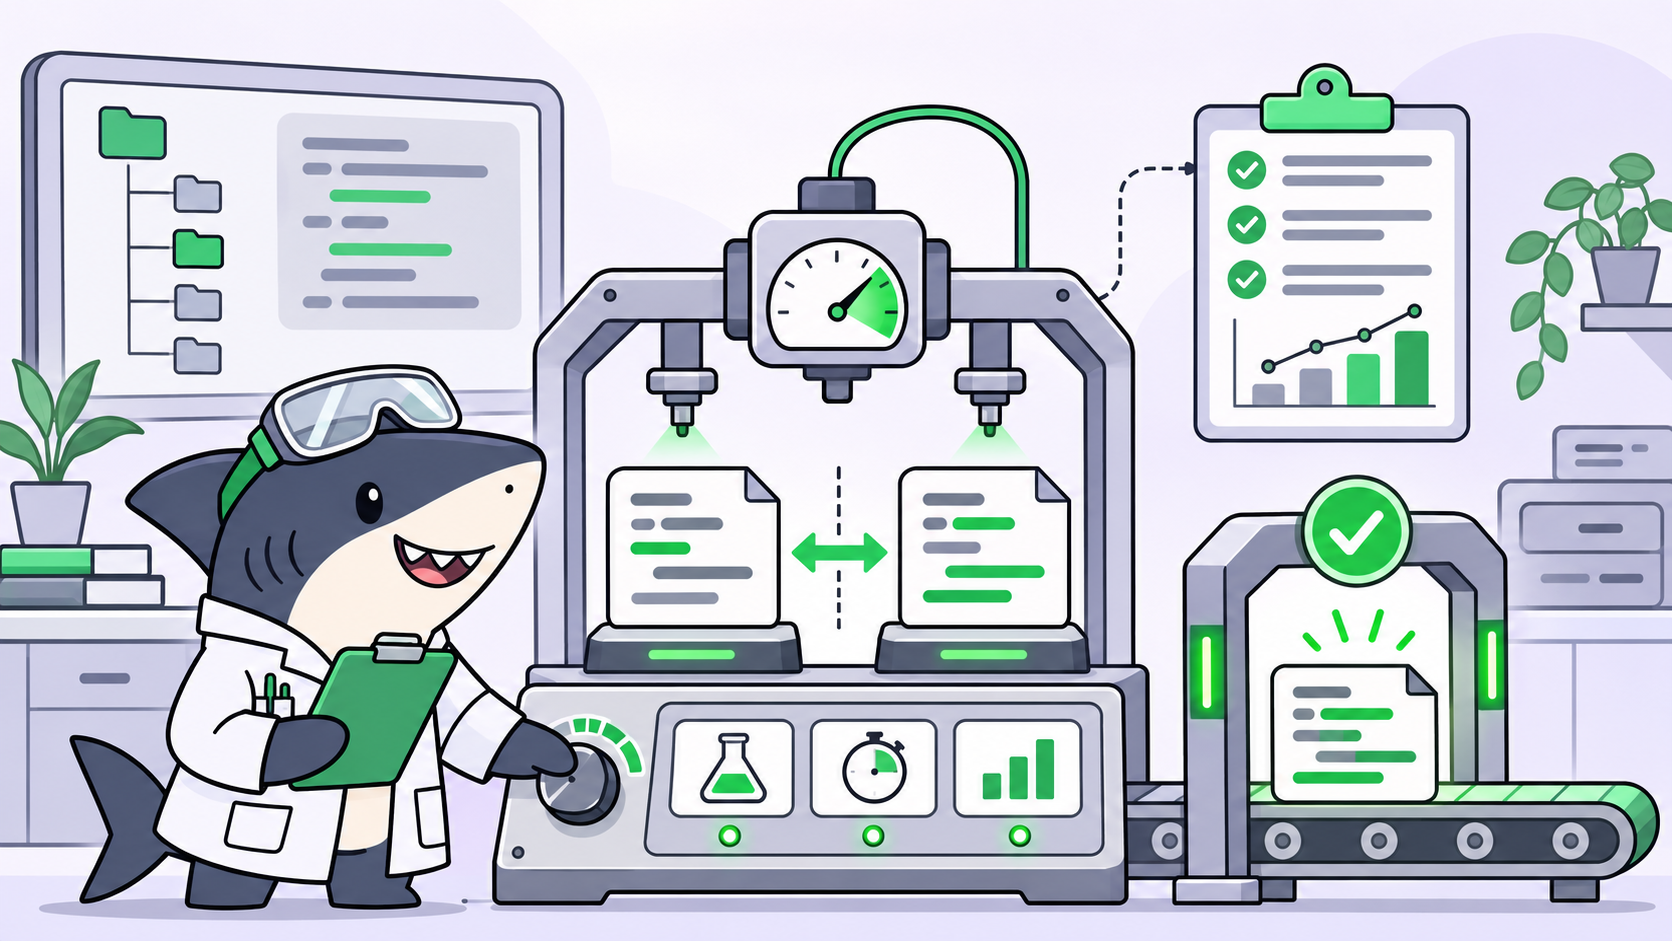
Evaluasi Claude Fable 5.2 pada tugas repositori yang representatif dengan kriteria penerimaan yang pasti, lingkungan yang identik, serta tolok ukur acuan (baseline) yang sudah Anda gunakan. Ukur perubahan yang diterima, beban peninjauan, waktu yang dihabiskan, dan total biaya secara bersamaan. Ulangi pengujian, catat setiap kegagalan, dan tentukan adopsi berdasarkan kategori tugas, bukan sekadar skor benchmark tunggal.
Anthropic mengumumkan Fable 5.2 pada 9 November 2026. Dalam pengumumannya, dilaporkan adanya peningkatan dalam kemampuan coding dan penalaran (reasoning). Klaim tersebut datang dari vendor berdasarkan evaluasi dan pengalaman mereka sendiri, serta belum membuktikan bagaimana kinerja model ini saat berhadapan langsung dengan dependensi, konvensi, dan standar rilis repositori Anda.
Evaluasi Anda sebaiknya menjawab pertanyaan yang lebih spesifik: pekerjaan mana saja yang dapat didelegasikan dengan beban peninjauan (review) yang masih wajar? Jika sejumlah coding agent sudah berbagi pekerjaan tersebut, Sharkly menyediakan sarana untuk mengorganisasi tugas-tugas ini beserta konteks peninjauannya.
Panduan ini memaparkan rancangan eksperimen dan tidak memuat hasil perbandingan terukur.
Susun kumpulan tugas yang representatif
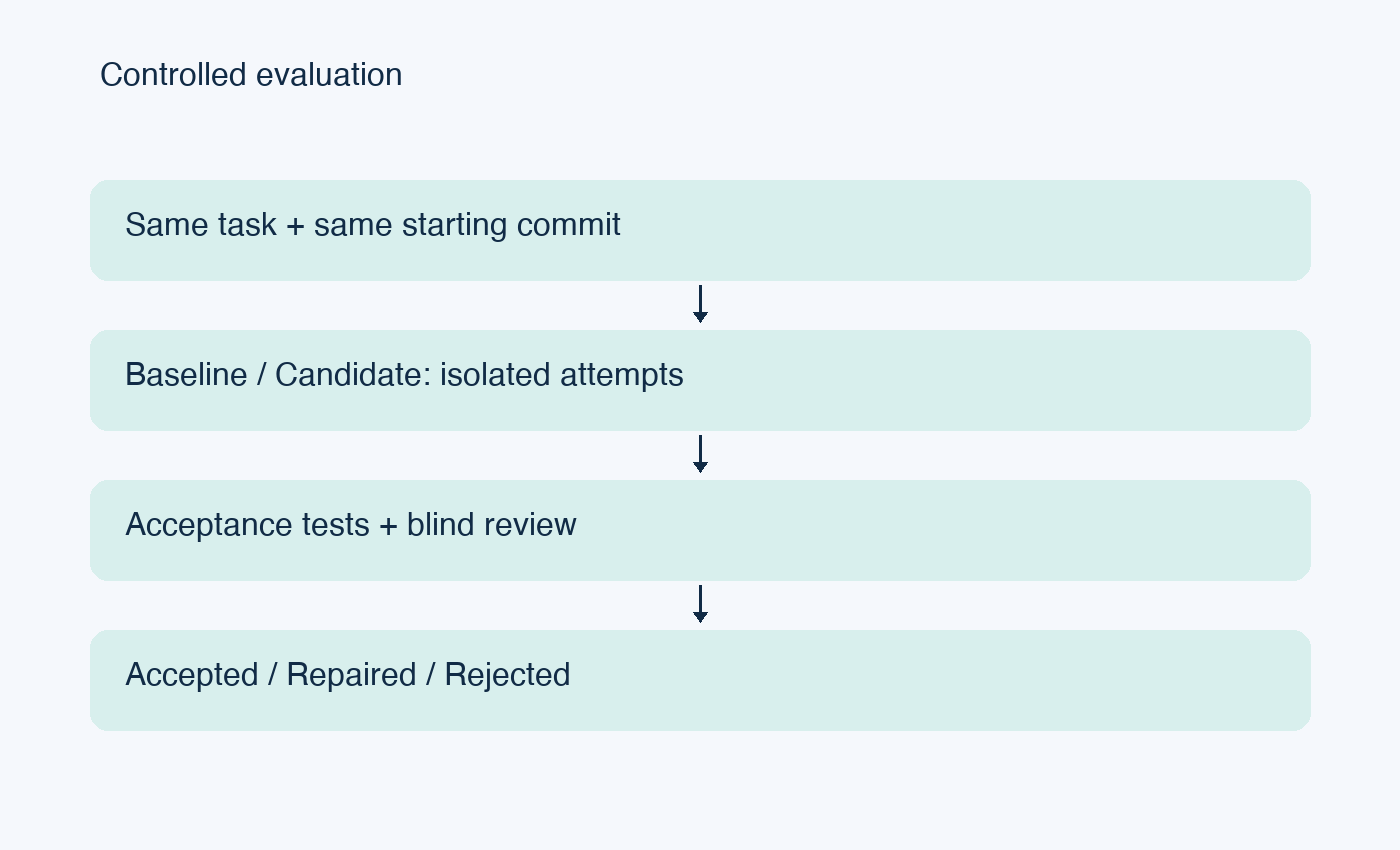
Evaluasi repositori merupakan perbandingan terkontrol antara alur kerja coding terhadap kebutuhan nyata dari proses pengembangan Anda sendiri. Tolok ukur keberhasilannya adalah perubahan kode yang berhasil diterima (accepted change), lengkap dengan pengujian dan peninjauannya. Patch yang tampak meyakinkan, perintah pengujian yang lolos, atau pesan selesai yang meyakinkan semata belum cukup membuktikan bahwa hasil tersebut layak diterima.
Mulailah dengan dua belas tugas yang diambil dari pekerjaan pemeliharaan (maintenance) terbaru. Jumlah ini merupakan saran ukuran uji coba awal (pilot), bukan jaminan statistik. Sertakan perbaikan bug (bug fix), penambahan fitur kecil, refaktor, serta tugas investigasi dengan proporsi yang menyerupai backlog harian Anda.
Pilihlah pekerjaan dengan commit awal yang jelas dan peninjau yang memahami perilaku sistem yang diharapkan. Hindari memilih isu-isu yang jawabannya terlalu kentara. Masukkan setidaknya satu tugas di mana respons yang benar menuntut model untuk mengajukan pertanyaan atau menjelaskan dependensi yang hilang.
Untuk isu-isu historis, hapus solusinya dari konteks yang diberikan. Catat apakah perbaikan tersebut sudah pernah dipublikasikan secara terbuka, karena ada kemungkinan model telah mempelajarinya sebelumnya. Siapkan kumpulan tugas terpisah yang belum pernah dipublikasikan untuk putaran konfirmasi selanjutnya.
Tulis kriteria penerimaan sebelum pengujian dijalankan. Misalnya untuk perbaikan paginasi API, tentukan skenario hasil kosong, batas halaman, kursor yang tidak valid, serta kompatibilitas dengan klien yang ada. Cantumkan juga batasan cakupan perubahan yang diperbolehkan dan pemeriksaan apa saja yang wajib dipenuhi agar dapat diterima.
| Kategori | Contoh tugas | Bukti penerimaan |
|---|---|---|
| Bug fix | Memperbaiki penanganan batas kursor | Uji regresi dan seluruh rangkaian tes yang ada lolos |
| Penambahan kecil | Menambahkan pemfilteran request opsional | Uji kontrak dan nilai default yang terdokumentasi |
| Refaktor | Mengekstrak validasi yang duplikat | Perilaku publik tidak berubah dan lolos peninjauan |
| Investigasi | Mendiagnosis timeout intermiten | Reproduksi masalah dan penjelasan kausal yang didukung bukti |
Gunakan tugas berukuran kecil saat Anda membutuhkan perbandingan yang bersih dan terisolasi. Gunakan tugas yang lebih besar jika koordinasi antarkomponen menjadi bagian dari penilaian, dan evaluasi eksperimen tersebut secara terpisah.
Bekukan kondisi lingkungan sebelum menjalankan agent
Catat commit repositori, sistem operasi, lockfile dependensi, versi alat bantu (tool), pengenal model, dan konfigurasinya. Kunci juga versi harness agent: harness adalah perangkat lunak yang menyediakan alat, konteks, dan alur eksekusi di sekitar model.
Bandingkan Fable 5.2 dengan alur kerja Anda saat ini. Perbandingan performa model membutuhkan harness yang sama jika memungkinkan. Sementara itu, perbandingan alur kerja boleh menggunakan alat yang berbeda, tetapi kesimpulannya harus merinci konfigurasi lengkap tersebut.
Pastikan hak akses, koneksi jaringan, konteks awal, dan batas waktu dibuat setara. Tetapkan apakah proses instalasi dependensi dihitung ke dalam total waktu atau tidak. Jangan sampai satu konfigurasi mewarisi file yang sudah diedit, cache yang memuat jawaban, atau riwayat percakapan dari proses uji coba lainnya.
Gunakan checkout bersih atau worktree yang terisolasi untuk setiap percobaan. Dokumentasi worktree Git menjelaskan cara beberapa working tree berbagi satu repositori. Isolasi file tidak otomatis mengisolasi database, port, atau layanan eksternal; sediakan pula resource pengujian yang terpisah untuk hal-hal tersebut.
Tetapkan aturan intervensi yang tegas. Misalnya, izinkan satu kali respons klarifikasi yang hanya berisi informasi yang tersedia untuk semua konfigurasi. Catat seluruh waktu yang dipakai untuk intervensi. Peninjau yang diam-diam memperbaiki implementasi akan mengubah validitas hasil uji coba tersebut.
Jalankan pengujian berpasangan dan catat setiap kegagalan
Jalankan setiap konfigurasi pada tugas yang sama. Selang-seling urutan eksekusi agar perlambatan layanan yang bersifat sementara tidak menguntungkan salah satu kandidat secara konsisten. Ulangi percobaan jika sumber daya memungkinkan, dengan jumlah pengulangan tetap yang telah ditentukan sebelum melihat hasilnya.
Uji coba awal yang praktis dapat menggunakan tiga kali percobaan per konfigurasi untuk setiap tugas. Jadikan angka ini sebagai titik awal teknis. Sampel kecil tentu belum dapat mendukung klaim presisi terkait kegagalan langka atau keunggulan mutlak.
Simpan prompt, konfigurasi, stempel waktu (timestamp), transkrip, patch, output alat bantu, serta disposisi akhir dari setiap percobaan. Catat kejadian timeout dan proses yang terhenti sebagai bagian dari hasil pengujian. Mengabaikan kegagalan-kegagalan tersebut hanya akan membuat proses yang berhasil tampak lebih murah dan lebih cepat daripada alur kerja nyata yang nantinya Anda terapkan.
Pisahkan fixture pengujian dan kredensial dari lingkungan produksi. Ikuti proses pengujian yang sudah berjalan di repositori Anda. Untuk repositori Python, dokumentasi pytest menjelaskan tentang fixture dan eksekusi pengujian; framework tersebut tidak menentukan apakah kriteria penerimaan Anda sudah mencakup seluruh kebutuhan atau belum.
Tinjau ketepatan sebelum kecepatan
Jika memungkinkan, minta peninjau memeriksa patch tanpa mengetahui model mana yang menghasilkannya (blind review). Gunakan rubrik penilaian tetap yang mencakup pemenuhan kebutuhan, risiko regresi, keterpeliharaan (maintainability), kualitas pengujian, dan perubahan di luar cakupan yang tidak diperlukan.
Lolos pengujian memang wajib jika tugas tersebut mensyaratkannya, tetapi tes otomatis pun bisa saja memvalidasi perilaku yang keliru. Periksa assertion terhadap kebutuhan awal. Waspadai pengujian yang dinonaktifkan, toleransi yang dilonggarkan, error yang disembunyikan (swallowed errors), serta perubahan kode yang hanya memotong jalur kegagalan.
Bedakan tiga kategori disposisi: diterima tanpa perubahan, diterima setelah perbaikan, dan ditolak. Catat durasi perbaikan dalam menit beserta bentuk perbaikannya. Tentukan sejak awal apakah perubahan yang diperbaiki akan dihitung ke dalam tingkat penerimaan utama Anda.
Untuk tugas investigasi, nilailah alur bukti yang disajikan. Laporan yang baik mengidentifikasi hasil observasi, membedakan hipotesis, dan memberikan langkah berikutnya yang dapat direproduksi. Jangan memberi nilai tinggi pada diagnosis yang terdengar meyakinkan namun tanpa bukti yang kuat.
Hitung biaya per perubahan yang diterima
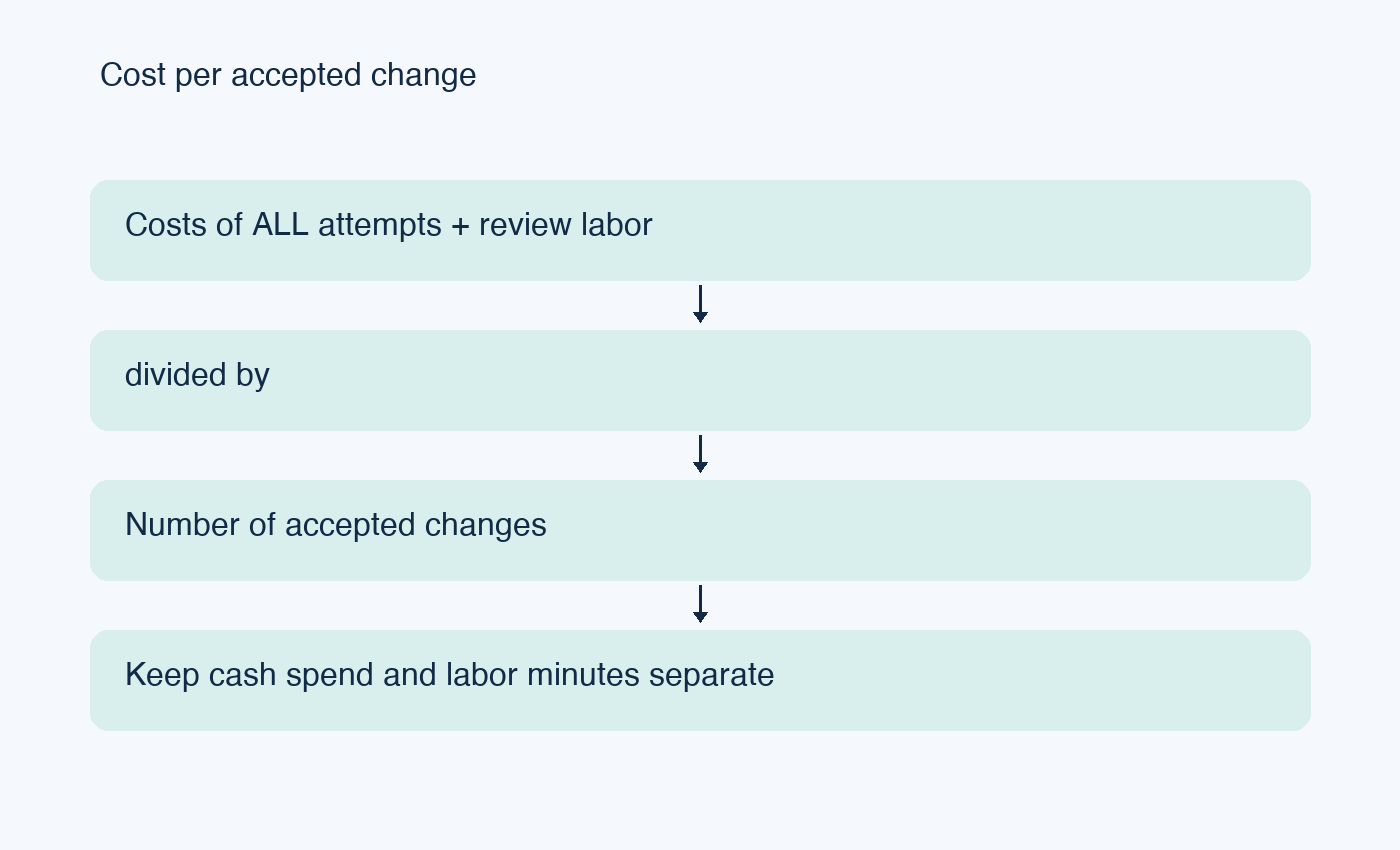
Biaya per perubahan yang diterima dihitung dengan membagi total biaya evaluasi dengan jumlah perubahan yang berhasil diterima berdasarkan aturan yang telah Anda tetapkan. Masukkan biaya dari percobaan yang gagal ke dalam pembilang (total biaya). Jika tidak ada perubahan yang diterima, laporkan biayanya dengan nol penerimaan; rasio tersebut tidak memiliki nilai terhingga.
Pantau metrik-metrik berikut secara bersamaan:
- Tingkat penerimaan berdasarkan kategori tugas.
- Waktu riil (wall-clock time) dari tugas dimulai hingga output siap ditinjau.
- Waktu (dalam menit) untuk peninjauan dan perbaikan manual oleh manusia.
- Biaya model dan alat bantu untuk seluruh percobaan.
- Biaya infrastruktur jika signifikan.
- Regresi yang ditemukan selama periode observasi.
Catat penggunaan token dan rujukan harga bertanggal bersamaan dengan jumlah tagihan. Token dalam cache, percobaan ulang (retries), dan alat eksekusi dapat memengaruhi biaya. Jangan memperkirakan tagihan hanya dari panjang output semata.
Jika Anda menetapkan nilai moneter untuk waktu peninjau, cantumkan hal tersebut sebagai asumsi internal. Tampilkan pengeluaran uang tunai dan durasi kerja manual secara terpisah agar pembaca dapat menghitung ulang perbandingannya. Generasi kode yang lebih murah bisa jadi tetap menuntut perhatian teknis yang lebih besar.
Simpan bukti evaluasi bersama alur kerja
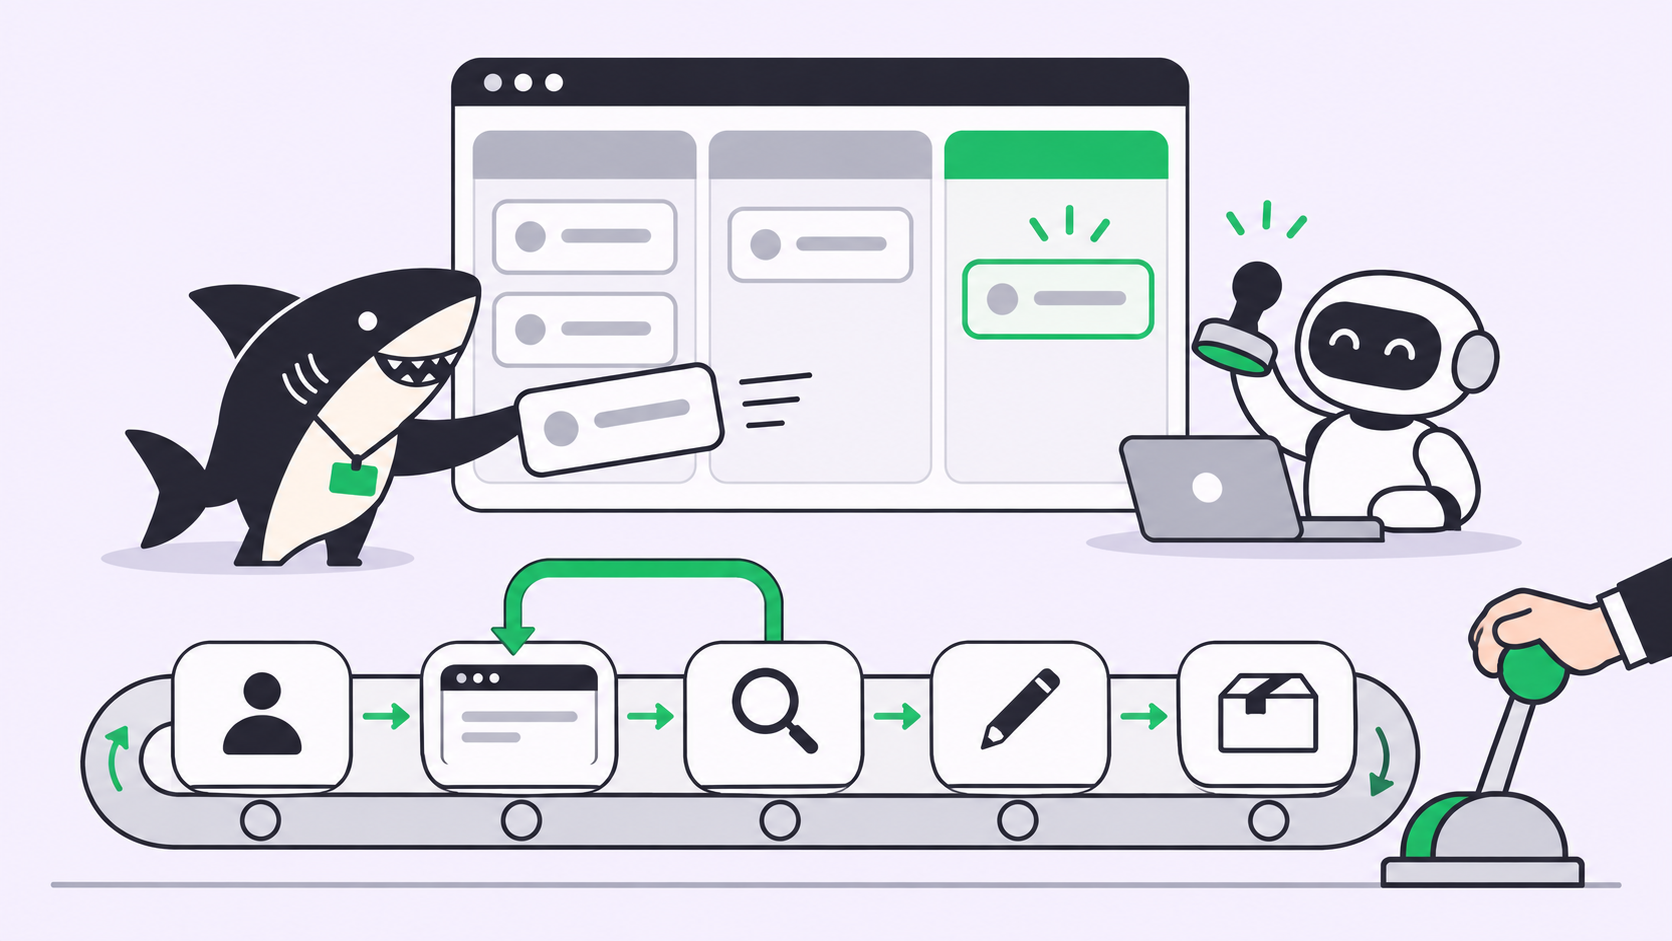
Sharkly mengelola alur kerja coding agent. Alur kerjanya yang terdokumentasi menghubungkan Task, Agent, Computer, konteks eksekusi, serta peninjauan manusia. Lihat dokumentasi Sharkly untuk memahami istilah produk dan penyiapannya saat ini.
Untuk eksperimen ini, cantumkan kriteria penerimaan di setiap Task dan simpan patch, bukti pengujian, serta hasilnya pada catatan kerja yang sama. Catat rekap evaluasi dalam spreadsheet atau file data berversi jika itu dirasa paling mudah dianalisis. Jangan berasumsi bahwa platform akan menghitung metrik eksperimen Anda secara otomatis.
Gunakan satu Agent untuk uji coba yang berbatas jelas. Gunakan Crew hanya jika koordinasi antarentitas memang menjadi bagian dari evaluasi. Mengubah struktur tim di tengah proses akan menambah variabel baru.
Agent bertugas mengeksekusi dan menyajikan bukti. Manusia bertugas menentukan kriteria penerimaan, memeriksa perubahan kode, dan mengesahkan rilis. Pembagian peran ini tetap sangat penting, bahkan ketika kodenya telah lolos semua pemeriksaan otomatis.
Tentukan adopsi berdasarkan kategori
Tentukan aturan adopsi sebelum melihat hasil evaluasi. Utamakan tingkat kebenaran yang dapat diterima terlebih dahulu, baru kemudian bandingkan biaya dan waktu yang dihabiskan di antara konfigurasi yang memenuhi standar tersebut. Jangan sertakan kategori yang sensitif terhadap keamanan atau yang cakupan pengujiannya rendah dalam peluncuran awal.
Laporkan jumlah absolut bersama persentase. Hasil dua tugas yang diterima dari tiga percobaan memberikan gambaran yang sangat berbeda dibandingkan dua ratus dari tiga ratus tugas. Jelaskan tingkat ketidakpastian dan pola kegagalan daripada langsung mendeklarasikan pemenang mutlak.
Ulangi evaluasi setiap kali ada perubahan signifikan pada prompt, harness, versi model, atau struktur repositori. Pertahankan konfigurasi lama agar peningkatan performa di masa mendatang memiliki baseline yang dapat direproduksi.
Mulailah dengan satu tugas pemeliharaan yang representatif di Sharkly, sertakan kriteria penerimaan yang jelas, lalu bandingkan bukti yang dihasilkan dengan alur kerja Anda saat ini. Perluas cakupan setelah Anda mampu menjelaskan faktor keberhasilan maupun kegagalannya.
FAQ
Bisakah benchmark coding publik menggantikan evaluasi ini?
Benchmark publik dapat membantu Anda menyaring kandidat model, tetapi tidak mencakup konvensi, dependensi, ekspektasi peninjauan, ataupun batasan operasional pada repositori Anda.
Apakah setiap percobaan harus menggunakan prompt yang identik?
Gunakan informasi tugas yang setara dan kebijakan perancangan prompt (prompting policy) yang telah ditetapkan sebelumnya. Catat wrapper khusus alat agar perbedaan teknisnya tetap dapat dianalisis.
Apakah patch yang diperbaiki dihitung sebagai keberhasilan?
Tentukan aturannya sejak awal. Laporkan penerimaan hasil perbaikan dan penerimaan tanpa perubahan secara terpisah, serta sertakan durasi perbaikan ke dalam perbandingan alur kerja.
Bagaimana batas waktu yang terlampaui (timeout) harus dinilai?
Tetap catat kejadian tersebut sebagai kegagalan dalam batas waktu yang telah ditentukan. Masukkan biaya yang telah terpakai dan waktu yang dihabiskan ke dalam laporan hasil.
Kapan tim sebaiknya memperluas penerapan?
Perluas penerapan ketika suatu kategori tugas secara konsisten memenuhi aturan penerimaan Anda melalui uji coba berulang dan tim peninjau telah memahami pola kegagalan yang sering terjadi.
Sumber daya tambahan
Baca dokumentasi Git untuk isolasi repositori, panduan fixture pytest untuk penyiapan pengujian terkontrol, dan Sharkly untuk mengorganisasi pekerjaan agent serta peninjauan manusia.