
TL;DR: Rate limit GPT-6.2 sama untuk Astra dan Sol di API: 5.000 RPM dan 1.000.000 TPM di tier Build, 10.000 RPM dan 4.000.000 TPM di Launch, serta 15.000 RPM dan 40.000.000 TPM di Grow. Limit berlaku per organisasi dan per proyek, jadi semua agen pada satu key berbagi kuota yang sama. Untuk tim agen, token per menit yang habis lebih dulu, bukan request.
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 17 November 2026. Astra adalah model frontier untuk pekerjaan tersulit; Sol adalah model sehari-hari yang lebih murah, dibuat untuk "menjalankan agen dalam skala besar", dengan kata-kata OpenAI sendiri.
Satu agen jarang kena limit. Enam agen pada satu API key bisa kena sebelum makan siang. Panduan ini membahas rate limit GPT-6.2, batas paket Codex, dan cara mengukur ukuran tim agen agar tugas mereka mengantre, bukan gagal. Jika Anda sudah menjalankan beberapa coding agent, Sharkly adalah tempat Anda mengatur berapa banyak agen yang berjalan bersamaan.
Rate limit GPT-6.2 berdasarkan tier penggunaan
GPT-6.2 Astra dan GPT-6.2 Sol berbagi satu tabel rate limit standar di halaman model Sol dan halaman model Astra OpenAI. RPM berarti request per menit; TPM berarti token per menit. Mana pun yang habis lebih dulu, itu yang menghentikan Anda.
| Tier | Kualifikasi (total pembelian kredit) | Batas penggunaan bulanan | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5.000 | 1.000.000 |
| Launch | $100 | $5.000 | 10.000 | 4.000.000 |
| Grow | $500 | $200.000 | 15.000 | 40.000.000 |
Kolom kualifikasi dan batas penggunaan bulanan berasal dari panduan rate limit OpenAI. Tier Anda naik secara otomatis saat total pembelian kredit melewati setiap ambang batas. Batas penggunaan bulanan adalah batas terpisah dari batas belanja yang Anda tetapkan sendiri.
Astra harganya empat kali lebih mahal per token ($8 input, $40 output per juta dibanding $2 dan $10 untuk Sol), tetapi rate limit-nya sama. Yang Anda kenakan tergantung pada berapa banyak token yang dikirim agen Anda.
Cara kerja batas penggunaan GPT-6.2 di Codex
Jika agen Anda berjalan melalui Codex pada paket ChatGPT alih-alih API key, batas yang berlaku berbeda. halaman harga Codex OpenAI memberikan jumlah pesan lokal per jendela lima jam dalam bentuk rentang, karena ukuran tugas mengubah biaya setiap pesan.
| Model | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6 hingga 50 | 6 hingga 50 |
| GPT-6.2 Sol | 17 hingga 180 | 17 hingga 180 |
| GPT-6.1 Sol | 15 hingga 160 | 15 hingga 160 |
| GPT-6 Astra | 5 hingga 45 | 5 hingga 45 |
Empat detail penting untuk tim agen:
- Paket Pro saat ini tidak memiliki limit lima jam, tetapi limit mingguan mungkin tetap berlaku.
- Pesan lokal dan chat cloud berbagi satu jatah. Tugas cloud bisa menghabiskan lebih banyak jatah daripada pesan lokal.
- Kecepatan ber biaya jatah. Mode fast menggunakan 2x jatah penggunaan pada model GPT-6.2; Ultrafast menggunakan 6x.
- Sesi panjang lebih mahal per pesan. OpenAI menyatakan tugas yang menahan konteks lebih banyak menggunakan jatah "jauh lebih banyak".
Agen yang telah membaca setengah repositori mengirim konteks besar di setiap giliran, sehingga jumlah pesannya turun cepat. Kami membahas pola yang sama untuk paket Anthropic di batas penggunaan Claude Code, dan respons terhadap pemotongan limit Codex Pro mengikuti logika yang sama.
Mengapa TPM, bukan RPM, yang membatasi tim agen
Coding agent tidak mengirim ribuan request kecil. Ia mengirim beberapa request besar. Setiap giliran mengirim ulang percakapan sejauh ini: instruksi, file yang telah dibaca, output tool, dan penalarannya sendiri sebelumnya.
Ambil satu agen ilustratif: 80.000 token input per giliran dan 6 giliran per menit. Itu berarti 6 RPM dan sekitar 480.000 TPM. Dibandingkan tier Build:
- RPM: 6 dari 5.000 digunakan. Jauh dari batas.
- TPM: 480.000 dari 1.000.000 digunakan. Dua agen saja sudah penuh.
Angka Anda akan berbeda; rasionya tidak. Agen boros token dan hemat request. Untuk agen contoh ini, batas mentahnya adalah dua agen per proyek di Build dan delapan di Launch. Dengan ruang kosong 30 persen dari langkah pengukuran di bawah, jumlahnya turun menjadi satu agen di Build dan lima di Launch. Di Grow, rate limit tidak lagi menjadi bottleneck Anda; batas bulanan $200.000 atau anggaran Anda sendiri yang mengambil alih.
Limit dibagi di seluruh organisasi
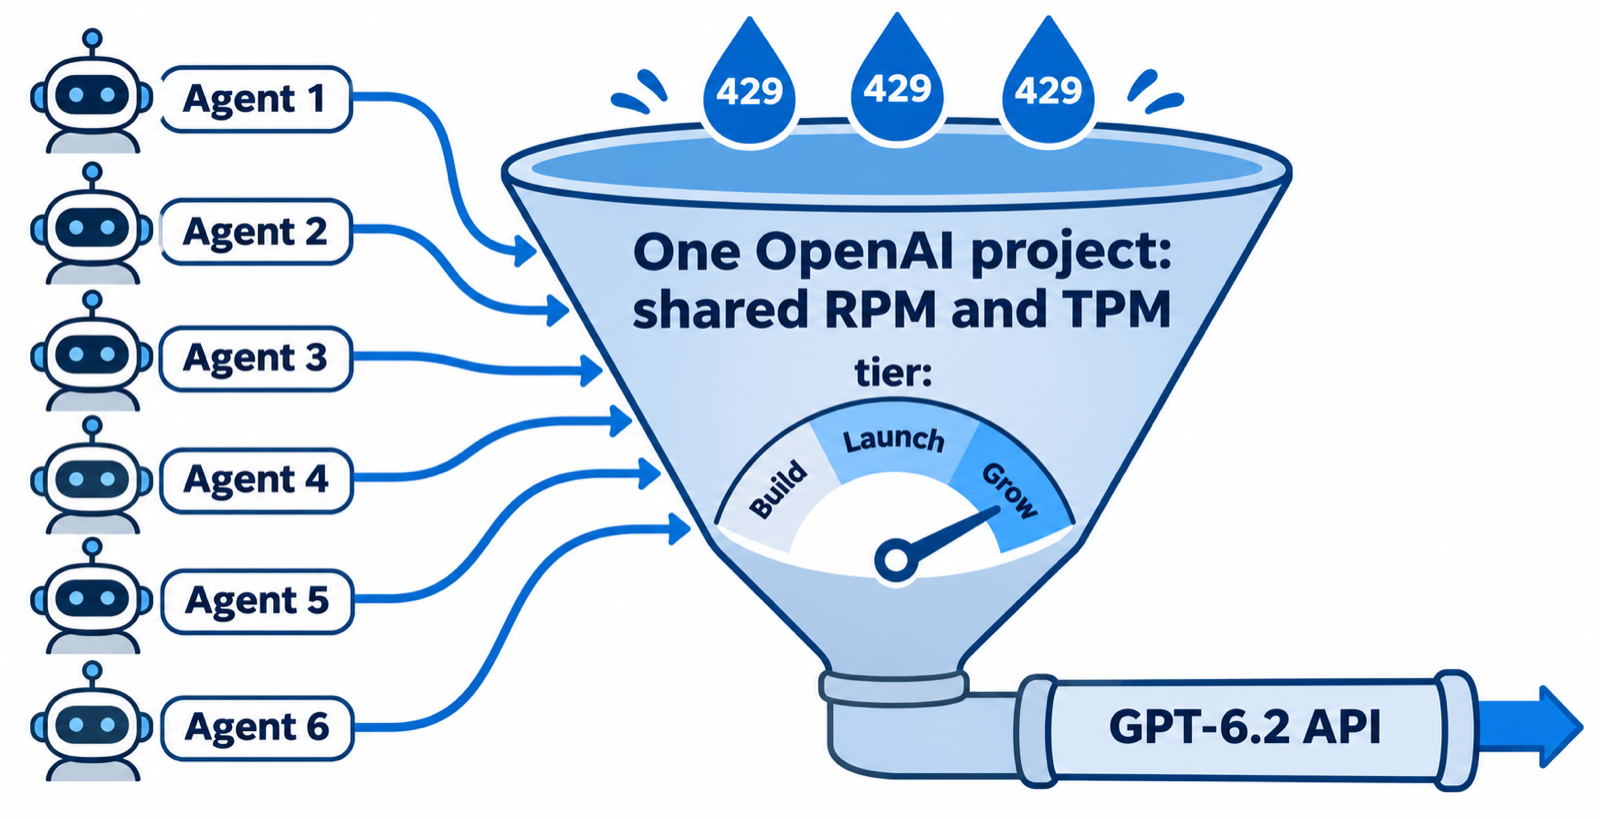
OpenAI mendefinisikan rate limit di level organisasi dan level proyek, bukan per pengguna. Setiap agen yang menggunakan key dari satu proyek mengambil dari kumpulan yang sama. Beberapa keluarga model juga memiliki limit bersama yang tercantum di halaman limits Anda, sehingga trafik ke satu model dapat dihitung terhadap model lain.
Cara mengukur concurrency agen sesuai tier GPT-6.2 Anda
Solusinya adalah membatasi berapa banyak agen yang berjalan bersamaan, sehingga pekerjaan ekstra mengantre alih-alih bertabrakan di API. Berikut urutan yang berhasil:
- Temukan tier Anda di Settings, Organization, Limits pada platform OpenAI.
- Ukur satu run agen nyata. Catat token input per giliran dan giliran per menit dari output penggunaan Runtime Anda.
- Bagi TPM Anda dengan TPM satu agen dan sisakan ruang kosong 30 persen untuk lonjakan.
- Tetapkan angka itu sebagai batas concurrence untuk setiap agen yang menggunakan proyek tersebut.
- Pantau error 429 selama seminggu, lalu naikkan batas satu langkah demi langkah.
Di Sharkly, setiap Agent memiliki pengaturan Max concurrency (assigned tasks), Max run duration dalam menit, dan Queue timeout dalam jam. Saat batas penuh, tugas baru menunggu dalam status Queued sampai ada slot kosong. Chat dapat berbagi limit yang sama, sehingga percakapan tidak bisa menyelinap melewatinya.

Sebuah Computer juga memiliki batas concurrence tugas sendiri. Dokumentasi Sharkly mencatat bahwa concurrence lebih tinggi menggunakan lebih banyak CPU, memori, disk, kapasitas penyedia, dan bandwidth repositori, jadi naikkan hanya setelah beban saat ini berjalan lancar.
Pisahkan agen ke beberapa proyek OpenAI
Limit level proyek memungkinkan Anda memagari kelompok agen. Beri agen review Anda satu proyek OpenAI dan agen refactor massal Anda proyek lain. Refactor yang membabi buta kemudian menghantam limit proyeknya sendiri alih-alih memperlambat agen review. Limit organisasi tetap membatasi totalnya, jadi ini menetapkan prioritas; bukan menambah kapasitas.
Untuk Runtime yang mengautentikasi dengan API key, tetapkan key tersebut sebagai variabel lingkungan pada Agent. Sharkly menyuntikkan variabel lingkungan Agent ke proses agen saat dimulai. Beri setiap kelompok agen key dari proyek OpenAI masing-masing, sehingga trafiknya masuk ke limit yang tepat.
Pantau token per tugas
Header Agent di Sharkly menampilkan tugas yang ditugaskan, total run, dan token yang digunakan. Baca token per tugas, bukan hanya total bulanan. Jenis tugas yang membakar tiga kali lipat token dibanding yang lain adalah kandidat pertama Anda untuk Sol alih-alih Astra, atau untuk deskripsi tugas yang lebih ketat.
Pindahkan pekerjaan massal ke luar jam sibuk
Pengaturan Runtime setiap Agent mencakup sakelar Working hours untuk menjadwalkan pekerjaan di luar jam sibuk. Arahkan ke pembuatan test, peningkatan dependensi, dan penyusunan dokumentasi. Tugas-tugas itu berjalan semalaman dan menyisakan kapasitas siang hari untuk pekerjaan yang ditunggu orang.
Cara menangani error 429 pada GPT-6.2
Bahkan dengan batas, Anda akan sesekali melihat 429. Panduan OpenAI cukup spesifik tentang apa yang harus dilakukan:
- Ikuti header
Retry-Aftersaat ada, dan perlakukan sebagai nilai minimum. - Tanpa itu, gunakan exponential backoff dengan random jitter.
- Baca
x-ratelimit-remaining-tokensdanx-ratelimit-reset-tokensuntuk melihat seberapa dekat Anda dengan batas. - Jangan menumpuk retry: jika kode Anda melakukan retry, matikan retry bawaan SDK, atau keduanya akan saling melipatgandakan.
- Jangan retry error kuota atau tagihan. Itu membutuhkan manusia.
503 dengan server_is_overloaded berarti model yang sedang sibuk, bukan Anda. Tangani dengan backoff yang sama.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra atau Sol: model mana yang membuat limit Anda lebih tahan lama
Rate limit-nya identik, jadi pilihan bergantung pada penggunaan token dan harga. Gunakan Astra untuk perubahan arsitektur, bug sulit, dan run otonom yang panjang. Gunakan Sol untuk semua hal rutin. Di Codex pada Plus, Sol mendapat kira-kira tiga kali lebih banyak pesan per jendela lima jam dibanding Astra, sinyal paling jelas dari selisih biaya.
Tim campuran adalah jawaban yang biasa: satu agen Astra memimpin, beberapa agen Sol mengerjakan bagian-bagiannya, seperti pada GPT-6 Astra sebagai pemimpin Crew Anda. Pekerjaan rutin sebaiknya dijalankan di model yang lebih murah, logika di balik GPT-6 Luna untuk 80 persen pekerjaan membosankan.
Cara lain untuk mendapatkan throughput GPT-6.2 lebih besar
- Batch API. Berjalan di luar rate limit sinkron Anda dan ber biaya 50 persen dari tarif standar. Bagus untuk eval dan klasifikasi massal; tidak cocok untuk agen interaktif.
- Mode background dengan jendela
2hatau8h. Ini dihitung terhadap limit antrean Batch/Background terpisah, bukan TPM langsung Anda. - Prompt caching. Input yang di-cache ber biaya $0,40 per juta pada Astra dan $0,10 pada Sol, penghematan besar untuk agen yang mengirim ulang konteks yang sama.
Kesimpulan
Rate limit GPT-6.2 besar untuk per request dan ketat untuk per token. Untuk tim agen, batas kerja adalah TPM tier Anda dibagi dengan yang dibakar satu agen, dibagi oleh setiap agen di proyek tersebut. Ukur satu run, batas concurrence di bawah angka itu, pisahkan kelompok agen yang berisik ke proyek mereka sendiri, dan biarkan antrean menyerap sisanya.
Anda bisa membangun ini dengan skrip dan semaphore, atau mengaturnya per Agent di Sharkly. Hubungkan satu Computer, buat satu Agent di Codex dengan GPT-6.2 Sol, tetapkan max concurrency-nya ke 2, dan tugaskan sesuatu yang membosankan. Lebih lanjut tentang menjalankan agen berdampingan di How to run 10 AI coding agents at once.
FAQ
Berapa rate limit GPT-6.2?
Di API, GPT-6.2 Astra dan Sol berbagi limit yang sama: 5.000 RPM dan 1.000.000 TPM di Build, 10.000 RPM dan 4.000.000 TPM di Launch, serta 15.000 RPM dan 40.000.000 TPM di Grow.
Apakah GPT-6.2 Astra memiliki rate limit lebih rendah daripada Sol?
Tidak. OpenAI mencantumkan RPM dan TPM yang sama untuk kedua model di setiap tier. Astra lebih mahal per token, jadi ia menghabiskan anggaran Anda lebih cepat, bukan rate limit Anda.
Bagaimana cara naik ke tier penggunaan OpenAI yang lebih tinggi?
Tier naik otomatis berdasarkan total pembelian kredit: $5 untuk Build, $100 untuk Launch, $500 untuk Grow.
Apakah rate limit berlaku per API key atau per organisasi?
Per organisasi dan per proyek. Setiap key dalam satu proyek mengambil dari kumpulan yang sama, jadi sepuluh agen dengan sepuluh key di satu proyek tetap berbagi satu limit.
Berapa jumlah pesan GPT-6.2 Astra yang saya dapatkan di Codex?
Di Plus dan Standard Business, OpenAI memperkirakan 6 hingga 50 pesan lokal per jendela lima jam untuk GPT-6.2 Astra dan 17 hingga 180 untuk Sol. Paket Pro saat ini tidak memiliki limit lima jam, meskipun limit mingguan mungkin berlaku.
Mengapa agen saya kena error 429 padahal RPM tampak aman?
Agen mengirim konteks besar, sehingga mereka menghabiskan token per menit jauh sebelum request per menit. Periksa x-ratelimit-remaining-tokens di header respons.
Apakah Sharkly menambahkan limit modelnya sendiri?
Tidak. Sharkly menjalankan coding agent yang sudah Anda gunakan, dan kuota model bergantung pada tools, paket, dan akun API yang dihubungkan tim Anda. Sharkly mengontrol berapa banyak tugas yang dijalankan setiap Agent sekaligus.