

Jev adalah model baru dari TypeSafe AI, dan ia tidak menulis kode atau prosa. Anda memberinya sepotong status program, mendeklarasikan pertanyaan yang perlu dijawab, dan ia mengembalikan jawaban bertipe dengan probabilitas yang terkalibrasi. TypeSafe menyebutnya System One Model. Model ini hadir di Vercel AI Gateway pada 16 September 2026, itulah sebabnya ia tiba-tiba muncul di mana-mana.
Bagi tim yang menjalankan beberapa coding agent, bagian yang menarik bukanlah modelnya. Yang menarik adalah posisi model pengambilan keputusan dalam stack. Agent Anda menghasilkan pekerjaan. Masalah sulitnya, seperti yang kami bahas di mengapa tinjauan manusia menjadi hambatan, adalah memutuskan apa yang harus dilakukan dengan keluaran dari lima proses sekaligus: mana yang butuh manusia, mana yang bisa di-merge, mana yang macet. Jev dirancang tepat untuk pertanyaan semacam itu. Tulisan ini menjelaskan apa itu Jev, apa yang bukan Jev, dan di mana posisinya di atas agent Anda.
Apa itu Jev
System One Model adalah model yang mengembalikan keputusan, bukan teks. Postingan peluncuran TypeSafe merumuskannya sebagai "unstructured state in, typed probabilistic decisions out." Ada tiga properti yang penting.
Bentuk keluaran dideklarasikan sebelum pemanggilan. Anda mendefinisikan tipe setiap pertanyaan di awal, dan model hanya bisa menjawab di dalam tipe tersebut. Tidak ada teks yang perlu di-parse dan tidak ada ketidaksesuaian skema yang perlu ditangkap.
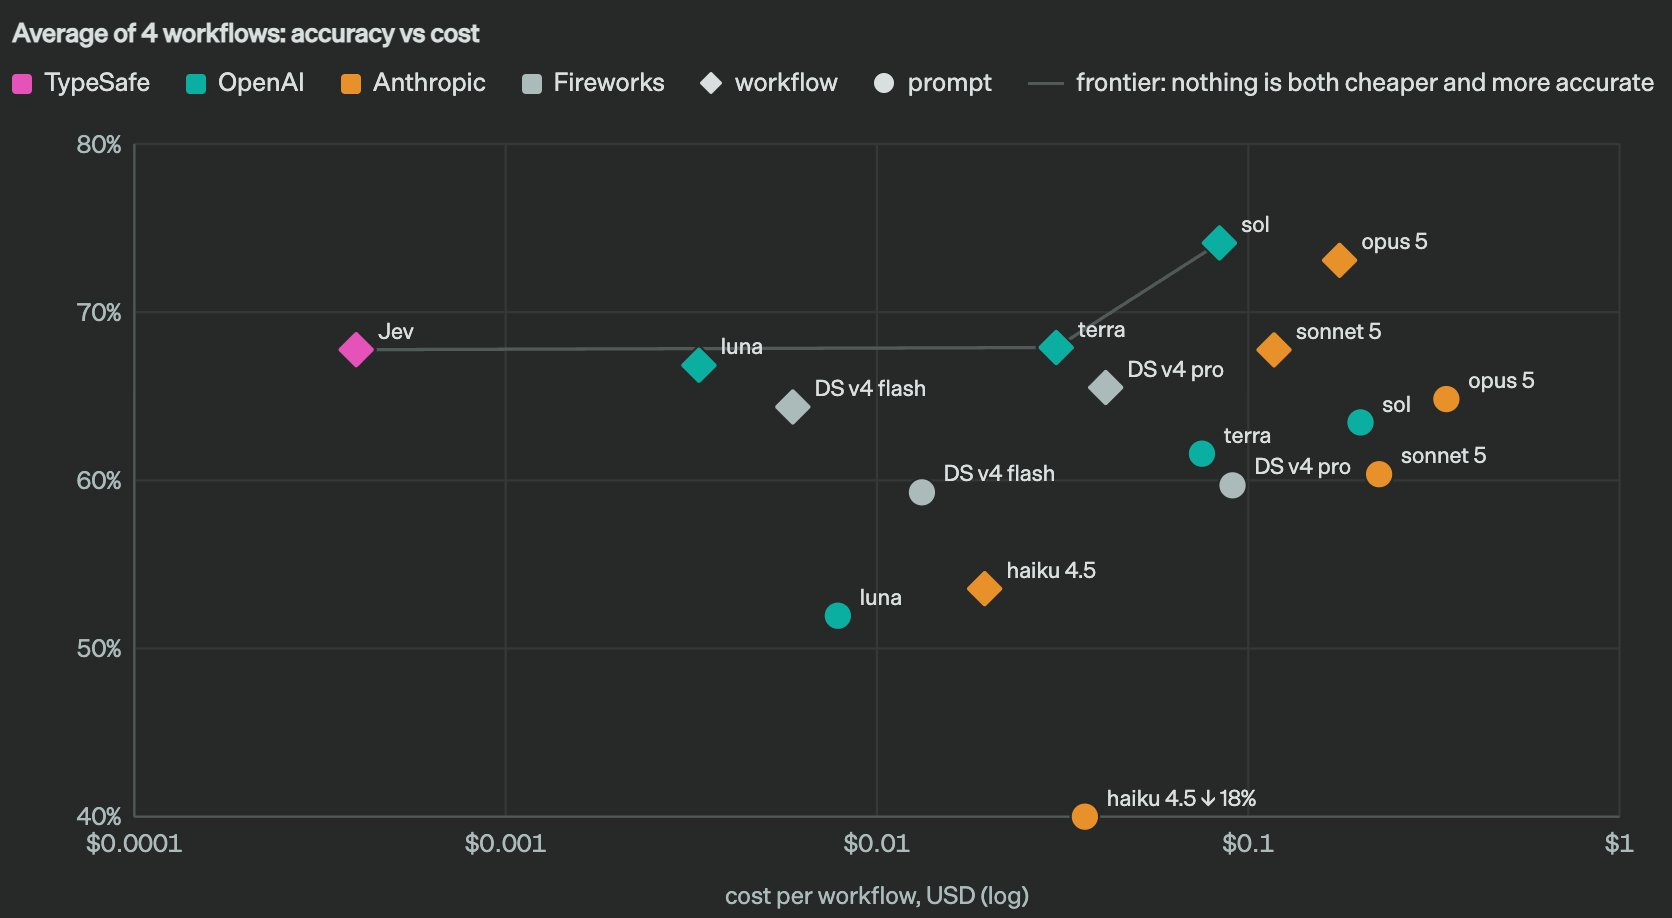
Setiap jawaban membawa probabilitas. Pertanyaan ya/tidak mengembalikan 0.97, bukan true. Pilihan mengembalikan distribusi penuh di seluruh opsi. TypeSafe melatihnya dengan metode yang mereka sebut Reinforcement Learning for Calibrated Decisions, dan klaimnya adalah semakin tinggi keyakinan, semakin tinggi akurasinya, sehingga Anda bisa menetapkan ambang batas: otomatiskan di atasnya, kirim sisanya ke manusia.
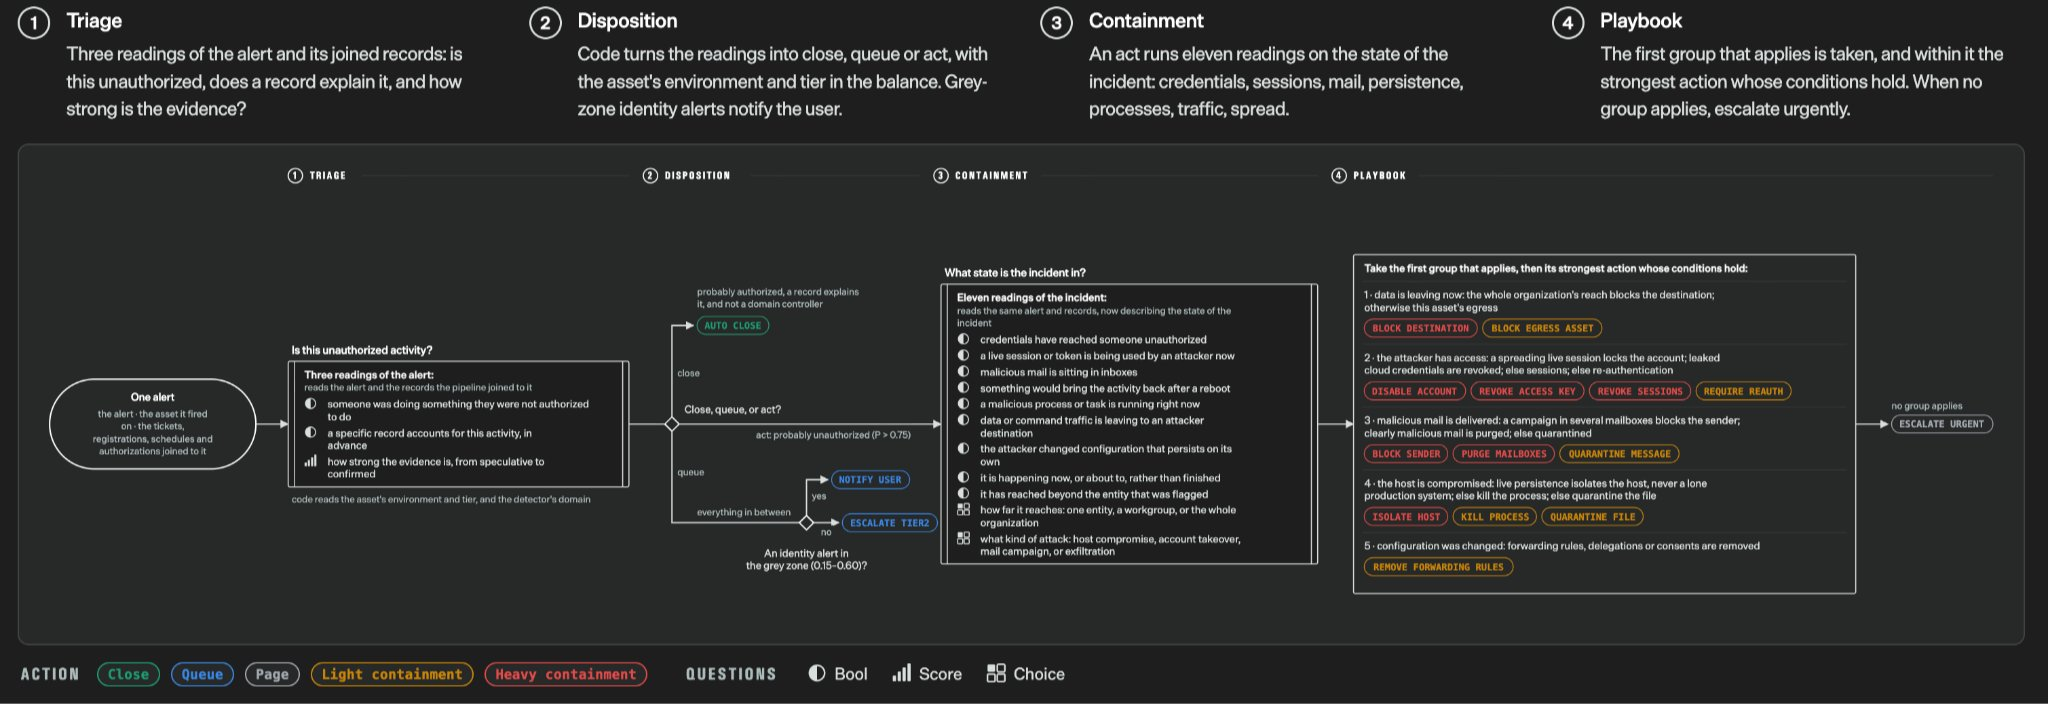
Semua pertanyaan dijawab secara paralel, dalam satu permintaan. Itulah sebabnya TypeSafe menyebut waktu end-to-end 70ms hingga 500ms. Itu angka dari vendor, bukan benchmark independen, tetapi arsitekturnya menjelaskannya: tidak ada yang dihasilkan token demi token.
Tiga jenis pertanyaan
API Jev mengekspos tiga primitif. Masing-masing adalah objek JSON di bawah kunci yang Anda pilih, semuanya dievaluasi terhadap state yang sama.
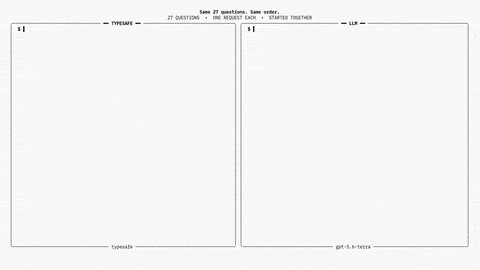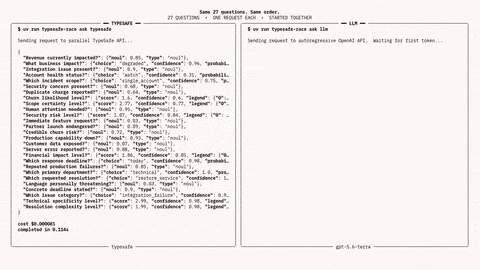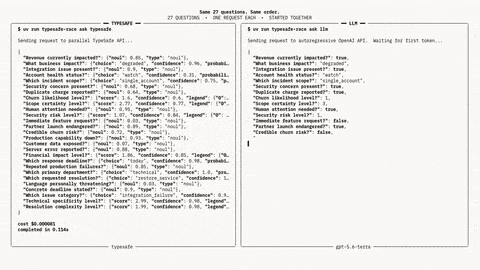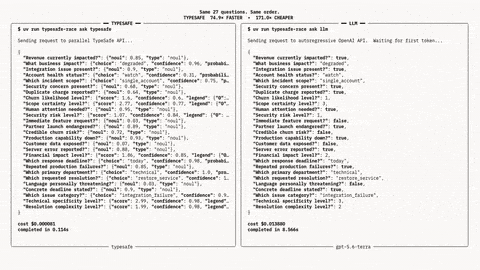
Noul adalah probabilitas ya/tidak. {"type": "noul", "instructions": "Does this run need a human before merge?"} mengembalikan {"noul": 0.91}. Anda menetapkan ambang batasnya di dalam kode.
Choice memilih satu opsi dari sekumpulan opsi bernama yang berisi hingga 255 pilihan. Anda memberikan criteria yang memetakan nama opsi ke deskripsinya, dan jawabannya membawa pilihan, distribusi penuh, serta angka keyakinan.
Score menempatkan state pada rubrik terurut dari 2 hingga 10 level. Jawabannya adalah posisi berbobot probabilitas, sehingga sebuah bug bisa mendapat skor 1.3 di antara "ada solusi sementara" dan "menghambat".
Melalui Vercel AI SDK, tipe ya/tidak disebut boolean dan field-nya adalah probability; sedangkan pada endpoint TypeSafe sendiri, namanya noul. Ide yang sama, kunci yang berbeda.
Di mana model pengambilan keputusan berada di atas agent Anda
Berikut adalah model mental yang kami gunakan. Model menghasilkan token. Coding agent (Claude Code, Codex, Gemini CLI, OpenCode) mengubah token menjadi perubahan pada sebuah Computer. Lapisan manajemen memutuskan siapa mengerjakan apa dan apa yang terjadi pada hasilnya. Jev termasuk dalam lapisan atas itu, bukan lapisan tengah. Ia bukan agent dan tidak bisa mengedit file. Ia adalah jawaban cepat dan bertipe untuk sebuah pertanyaan manajemen.
Ada tiga pertanyaan yang muncul di setiap board yang menjalankan agent secara paralel, dan masing-masing dipetakan ke primitif Jev.
Assignee mana yang sebaiknya mengambil Task ini? Sebuah Choice atas Agent Anda, dengan criteria yang mendeskripsikan keunggulan masing-masing. State-nya adalah judul Task, deskripsi, dan repositori yang tertaut. Ini adalah langkah triase yang kami jelaskan di manajemen dan triase backlog AI, yang dilakukan sebagai satu panggilan 100ms alih-alih seseorang membaca empat puluh tiket.
Apakah proses ini butuh manusia sebelum di-merge? Sebuah Noul atas ringkasan diff proses tersebut, hasil tes, dan path yang tersentuh. Di atas 0.85, tahan untuk ditinjau; di bawah 0.15, biarkan approval gate meloloskannya; di antaranya, tandai. Intinya bukan menghilangkan reviewer. Intinya adalah memastikan sore hari reviewer tercurah pada proses yang memang membutuhkannya.
Seberapa berisiko perubahan ini? Sebuah Score dari "kosmetik" hingga "menyentuh autentikasi atau pembayaran", yang diterapkan pada state yang sama. Angka itu mengurutkan antrean tinjauan, yang merupakan sebagian besar tujuan dari melacak pekerjaan yang diselesaikan oleh coding agent.
Komunitas sudah lebih dulu sampai ke sini. Dalam sepekan setelah peluncuran, para developer merilis alur kerja tinjauan kode bertahap yang dibangun di atas Jev, sebuah plugin Claude Code yang menggantikan ringkasan compaction dengan keputusan Jev tentang panggilan tool mana yang harus dipertahankan, dan sebuah "mandor pabrik perangkat lunak" yang mengarahkan pekerjaan dengannya. Semuanya adalah lapisan keputusan di atas agent, dan itulah pola yang penting.
Aturan keputusan yang jujur
Gunakan Jev ketika pertanyaannya memiliki sekumpulan jawaban tetap dan Anda membutuhkan probabilitas bersamanya: routing, tingkat keparahan, "butuh tinjauan," "macet," "apakah deskripsi PR ini jujur." Itulah pertanyaan yang diajukan sebuah board ratusan kali sehari.
Jangan gunakan Jev ketika pertanyaannya membutuhkan penilaian yang tidak ada dalam state. "Apakah ini arsitektur yang tepat" bukanlah sebuah Choice. "Apakah pelanggan akan menerima ini" bukanlah sebuah Score. Probabilitas atas pertanyaan-pertanyaan itu hanyalah angka yang tampak seperti keputusan. Pertahankan manusia, atau model bahasa yang bisa menjelaskan alasannya, di sisi garis itu.
Dan jangan biarkan probabilitas menggantikan gerbang tinjauan. Nilai 0.96 pada "aman untuk di-merge" adalah sinyal kuat untuk menempatkan proses tersebut di urutan teratas antrean manusia, bukan alasan untuk melewati manusia. Batas yang ditarik Sharkly adalah bahwa otomatisasi berhenti di titik yang memerlukan penilaian tim, dan model pengambilan keputusan tidak menggeser garis itu. Ia hanya membuat antrean di sisi manusia menjadi lebih pendek dan lebih tertata.
Cara Memanggilnya
Langsung: POST https://api.typesafe.ai/v1/systemone dengan kunci Bearer dari console.typesafe.ai, model jev-latest (saat ini jev-1.13.0). Melalui Vercel AI Gateway: model typesafe-ai/jev melalui experimental_evaluate di AI SDK 7, dan perhatikan bahwa dokumentasi Gateway menyatakan evaluasi hanya tersedia melalui AI SDK, bukan melalui endpoint yang kompatibel dengan OpenAI.
Panggilan triase yang menjawab ketiga pertanyaan sekaligus:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
Harga menurut halaman model TypeSafe: $0.042 per juta token input, output tidak dikenai biaya, 64k token per permintaan dengan 32k untuk state, hanya teks. Dengan harga tersebut, panggilan triase di atas hanya memakan biaya sepersekian sen, itulah yang membuat menjalankannya pada setiap Task dan setiap proses menjadi masuk akal.
Kaitannya dengan Sharkly
Sharkly tidak memanggil Jev untuk Anda, dan Sharkly bukan model pengambilan keputusan. Sharkly adalah lapisan task, Computer, konteks, dan tinjauan bersama di sekitar agent yang sudah Anda jalankan. Yang diberikan model seperti Jev kepada Anda adalah cara murah dan bertipe untuk membuat keputusan routing dan tinjauan yang dimunculkan lapisan tersebut: Assignee mana, antrean mana, seberapa mendesak. Sambungkan ke sebuah Automation yang membuat Task dan memilih Agent, atau jalankan pada keluaran proses yang telah selesai sebelum hasilnya sampai ke reviewer. Apa pun caranya, keputusan itu berakhir di tempat yang bisa dilihat manusia, dan itulah bagian yang harus tetap berlaku apa pun kata probabilitasnya.
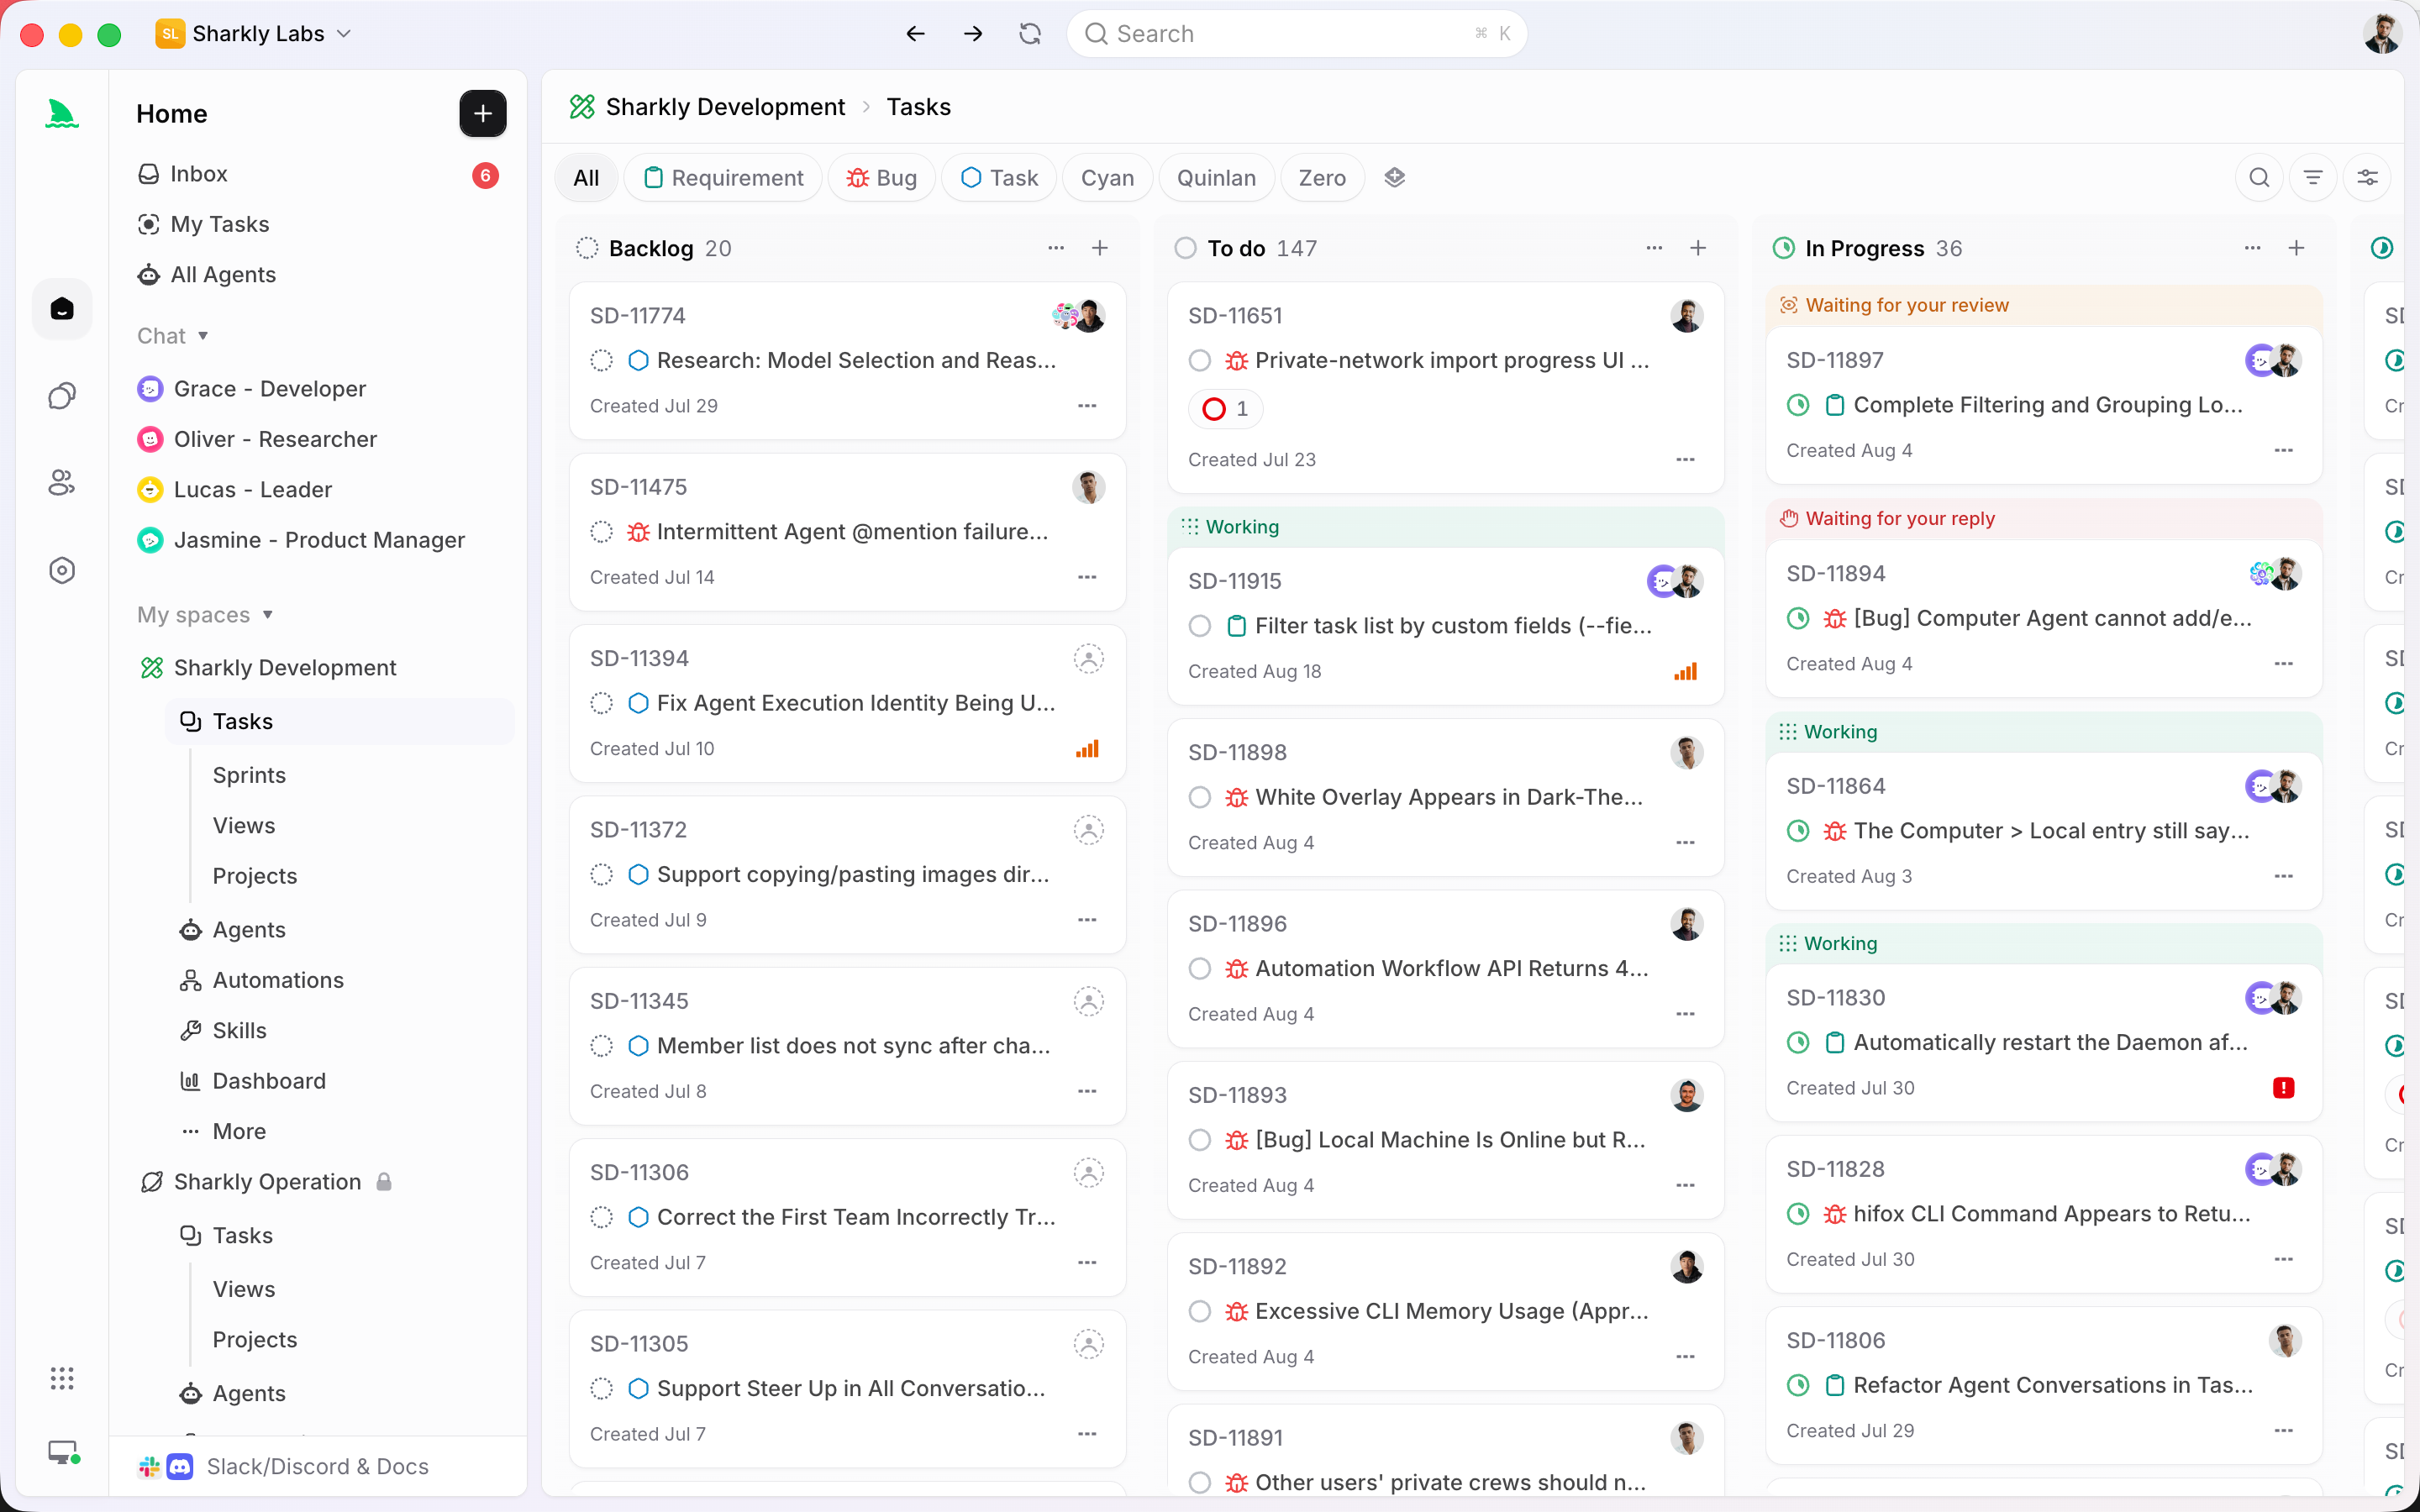
Jika Anda menjalankan lebih dari satu agent dan antrean tinjauan adalah hal yang menyakitkan, memulai dengan Sharkly membahas board, Computer, dan alur tinjauan yang menjadi tempat model pengambilan keputusan tersambung.
FAQ
Apakah Jev sebuah coding agent?
Tidak. Ia tidak bisa menghasilkan kode atau mengedit file. Ia menjawab pertanyaan yang dideklarasikan tentang state yang Anda berikan, dengan sebuah probabilitas. Agent menghasilkan pekerjaan; Jev membantu memutuskan apa yang harus dilakukan dengannya.
Bisakah ia menggantikan tinjauan kode?
Tidak, dan seharusnya tidak. Ia bisa mengurutkan antrean tinjauan dan mengeluarkan kasus-kasus yang jelas darinya. Keputusan untuk merge tetap ada pada manusia, dan itulah batas yang menjadi tumpuan seluruh alur kerja ini.
Apa arti terkalibrasi?
Jika Jev mengatakan 0.9, ia seharusnya benar sekitar 90% dari waktu untuk jenis pertanyaan tersebut. Ujilah pada proses Anda sendiri sebelum mempercayai sebuah ambang batas: beberapa lusin diff berlabel sudah cukup untuk melihat apakah angka itu berarti seperti yang dikatakannya.
Apakah saya perlu Vercel untuk menggunakannya?
Tidak. API langsungnya berfungsi dengan kunci Bearer. Gateway hanyalah kemudahan jika Anda sudah menggunakan AI SDK.


