
Sebagian besar tim yang menjalankan beberapa coding agent pada suatu titik menetapkan plafon pengeluaran model bulanan, biasanya setelah seminggu yang buruk. Pilih satu angka, batasi konkurensi sampai tagihannya tetap di bawah angka itu, lalu tinjau ulang kuartal berikutnya. Pada 2026-09-22, angka itu diam-diam berhenti bermakna seperti sebelumnya.
OpenAI merilis GPT-6 Sol dengan harga $2 per juta token input dan $10 per juta token output, dengan id API gpt-6-sol, dan mempublikasikan sesuatu yang lebih berguna daripada tarif token: biaya per tugas. Pada AutomationBench 1.0.6, Sol dengan reasoning effort extra-high mencetak 33,2% dengan biaya $0,27 per tugas. Claude Opus 5 pada effort max mencetak 26,9% dengan biaya per tugas 11,1 kali lipat Sol pada harness yang sama.
Jadi hitung dulu apa yang bisa dibeli plafon Anda sekarang, sebelum menaikkannya. Jawabannya bagi sebagian besar tim: plafon itu sudah membeli lebih banyak run selesai daripada yang bisa dibaca siapa pun. Artinya, plafon tersebut tidak pernah benar-benar melindungi anggaran. Tanpa sengaja, ia melindungi para reviewer Anda, dan fungsi itu akan segera berakhir.
TL;DR
Biaya per perubahan yang diterima adalah berapa banyak yang tim Anda keluarkan untuk inferensi model pada setiap diff yang benar-benar dibaca dan diterima seseorang, dan inilah satu-satunya angka biaya agent yang benar-benar terhubung ke pekerjaan yang terkirim. Dengan tarif yang dipublikasikan, seluruh throughput bulanan yang bisa ditinjau oleh tim dengan empat reviewer hanya menghabiskan sekitar $136 GPT-6 Sol. Kendala pengikatnya berpindah dari tagihan ke tahap penerimaan, dan tidak ada rilis model yang menyentuh hal itu. Agent meneliti, mengeksekusi, menguji, dan melapor. Manusia menentukan arah, memberikan wewenang, dan menerima hasilnya.
Angka yang benar-benar dipublikasikan OpenAI
OpenAI melaporkan skor bersamaan dengan biaya per tugas—sebuah kejujuran yang tidak biasa dan jauh lebih berguna daripada sekadar daftar harga.
| Model, pada level effort yang digunakan OpenAI | AutomationBench 1.0.6 | Biaya per tugas |
|---|---|---|
| GPT-6 Sol, extra-high | 33,2% | $0,27 |
| GPT-6 Astra, low | 30,3% | 3,9x Sol |
| Claude Opus 5, max | 26,9% | 11,1x Sol |
| Fable 5.1 dengan fallback Opus 5, max | 31,4% | lebih dari 8,9x Sol |
Ringkasan OpenAI sendiri untuk baris pertama dan ketiga: Sol pada extra-high mengalahkan Opus 5 pada max dengan biaya per tugas sekitar 9% dari biaya Opus 5. Pola yang sama muncul di bagian lain postingan mereka. Pada Agents’ Last Exam V1, Sol pada max mencetak 56,4%, di atas hasil terbaik Opus 5, dengan biaya per tugas 60% lebih rendah. Pada DeepSWE 1.1, Sol pada max mencetak 68,8%, hanya terpaut 1,1 poin persentase dari Fable 5 pada extra-high (69,9%), dan sekitar 80% lebih murah per tugas.
Ada dua catatan yang seharusnya menyertai angka-angka itu dan jarang ikut disebutkan. Sorotan utama OpenAI adalah bahwa Sol dan Luna masing-masing 50% lebih murah daripada harga promosi GPT-5.6, dan “promosi” itu kata OpenAI sendiri: perbandingannya dilakukan terhadap tarif yang sudah didiskon. Selain itu, OpenAI membandingkan dengan Claude Opus 5, karena Claude Opus 5.5 dirilis beberapa jam kemudian dengan harga $4 dan $20 per juta token, dibandingkan Opus 5 yang $5 dan $25. Kolom Opus 5 adalah perbandingan terakhir yang dipublikasikan, bukan yang berlaku saat ini.
Menghitung berapa run yang bisa dibeli anggaran Anda
Kalikan $0,27 dengan 11,1, maka Opus 5 pada max berada di sekitar $3,00 per tugas pada harness tersebut. Perhitungan ini kami sendiri yang buat, berdasarkan dua angka dari OpenAI. Bagi plafon bulanan dengan masing-masing angka, dan Anda akan mendapatkan tabel yang mengubah cara membaca plafon itu.
| Anggaran model bulanan | Tugas pada Sol, extra-high | Tugas pada Astra, low | Tugas pada Opus 5, max |
|---|---|---|---|
| $250 | sekitar 925 | sekitar 240 | sekitar 83 |
| $1.000 | sekitar 3.700 | sekitar 950 | sekitar 330 |
| $5.000 | sekitar 18.500 | sekitar 4.750 | sekitar 1.660 |
Biaya per tugas dalam benchmark bukanlah biaya per tugas Anda. Tugas AutomationBench dibentuk untuk keperluan benchmark: terbatas, singkat, dan sama sekali tidak seperti tiket nyata di repositori dengan riwayat bertahun-tahun. Tugas Anda sendiri bisa menghabiskan sepuluh atau seratus kali lipat token. Yang bisa dibawa dari benchmark ke repositori Anda adalah rasio antar model, bukan angka dolar absolutnya. Anggap tabel itu sebagai gambaran bentuk perubahannya, lalu ukur sendiri biaya per run lintas agent Anda dan sesuaikan skalanya.
Ada koreksi kedua, dan arahnya berlawanan. Biaya per tugas dihitung per percobaan, bukan per keberhasilan. Dengan angka benchmark itu sendiri sebesar 33,2%, kira-kira dua dari tiga percobaan tidak berhasil, sehingga Sol memakan sekitar $0,81 per keberhasilan benchmark dan Opus 5 pada max sekitar $11,15. Sekali lagi ini hitungan kami, dan masih kasar, karena tingkat kelulusan benchmark bukanlah tingkat penerimaan tim Anda. Arahnya yang penting: biaya mencoba sesuatu dua kali kini cukup kecil sehingga strategi retry menjadi pilihan desain, bukan keputusan anggaran.
Di mana batasnya berada sekarang
Sekarang mari hitung sisi review dengan cara yang sama. Seorang reviewer yang benar-benar membaca diff, memahami apa yang dipilih Agent, dan bertanggung jawab atas hasilnya akan melewati sejumlah perubahan tertentu dalam satu hari kerja. Sebut saja enam, dan sesuaikan dengan tim Anda.
| Reviewer | Perubahan yang diterima per bulan | Biaya Sol pada $0,27 | Biaya Opus 5 max pada $3,00 |
|---|---|---|---|
| 1 | sekitar 126 | $34 | $378 |
| 2 | sekitar 252 | $68 | $756 |
| 4 | sekitar 504 | $136 | $1.512 |
| 8 | sekitar 1.008 | $272 | $3.024 |
Enam perubahan yang diterima per reviewer per hari selama 21 hari kerja—asumsi dan hitungan kami sendiri. Masukkan angka Anda sendiri, dan kesimpulannya tetap bertahan: semua yang benar-benar bisa diterima tim engineering normal dalam sebulan hanya memakan biaya inferensi beberapa ratus dolar, bahkan pada pilihan termahal. Plafon $1.000 untuk tim berisi empat orang bukanlah sebuah kendala. Angka itu sekitar tujuh kali lebih banyak output agent daripada yang bisa diserap tim tersebut.
Itulah inti dari pemangkasan harga bagi tim yang meninjau pekerjaannya. Pemangkasan itu tidak menaikkan output Anda. Ia menghapus alasan terakhir untuk memiliki antrean yang pendek, dan menyingkap hambatan yang selama ini selalu ada: langkah review oleh manusia.
Pengeluaran internal OpenAI adalah kontra-contoh yang berguna, bukan sebuah kontradiksi. Peneliti mediannya menjalankan lebih dari $600 per hari inferensi coding agent dengan harga API, dan persentil ke-90 menjalankan $7.000 per hari. Itu angka nyata dan jauh melampaui tabel di atas, karena pekerjaan tersebut bentuknya berbeda: fan-out yang sangat besar, penilaian otomatis, dan tidak ada tahap di mana orang tertentu menerima setiap hasil ke branch produksi. Jika proses Anda memiliki tahap itu, tagihan model Anda akan tetap kecil, tetapi antrean Anda tidak.
Apa yang sebaiknya dibeli dengan sisa anggaran
Begitu anggaran tidak lagi menjadi kendala, pertanyaannya bukan lagi berapa banyak run yang harus dibeli, melainkan untuk apa selisihnya dibelanjakan. Dua jawaban berikut justru mengurangi pekerjaan yang tiba di reviewer, bukan menambahnya.
Belilah effort, bukan volume. Reasoning effort adalah tombol pengatur biaya, dan tabel OpenAI sendiri memakai level berbeda untuk benchmark yang berbeda. Angka $0,27 adalah baris extra-high, jadi premi untuk run yang lebih teliti sudah termasuk di dalam angka yang hanya 9% dari alternatifnya. Membayar premi itu pada jumlah tugas yang sama hampir tidak memakan biaya dan menghasilkan diff yang lebih cepat diperiksa.
Belilah cache, bukan token. GPT-6 memberi diskon 90% untuk pembacaan input dari cache, menjaga hit rate lebih tinggi secara default, dan tidak lagi membatalkan cache saat Anda mengubah reasoning effort atau ketersediaan tool. Breakpoint eksplisit memungkinkan Anda menentukan di mana prefix yang di-cache berakhir. OpenAI menyebut GitHub mengalami penurunan lebih dari 50% token prompt yang perlu diproses ulang di miliaran request. Bagi sebuah Crew, ini adalah perbedaan antara Agent pertama dan Agent kesepuluh pada satu repositori: mereka mengirim ulang prefix yang hampir sama berisi tata letak, aturan internal, dan konvensi, dan prefix itulah yang memang menjadi sasaran cache. Biaya token konteks repositori adalah tempat tagihan sebuah fleet sebenarnya berada.
Pasangan keputusan yang jujur: naikkan jumlah run bersamaan ketika run tambahan itu menuju satu hasil yang diterima seseorang, misalnya tiga percobaan untuk satu migrasi di mana test suite memilih pemenangnya. Jangan naikkan ketika setiap run menghasilkan diff sendiri, ringkasan sendiri, dan keputusan penerimaan sendiri, seberapa murah pun run itu sekarang. Pada kasus kedua, tagihan adalah satu-satunya hal yang benar-benar berhasil diskalakan.
Buat batas baru itu bisa dihitung
Anggaran adalah proksi yang buruk untuk kapasitas, tapi ia punya satu kelebihan: ia adalah angka yang diawasi seseorang. Gantilah dengan angka yang sekarang menjadi kendala, yaitu run yang sudah selesai dan menunggu seseorang.
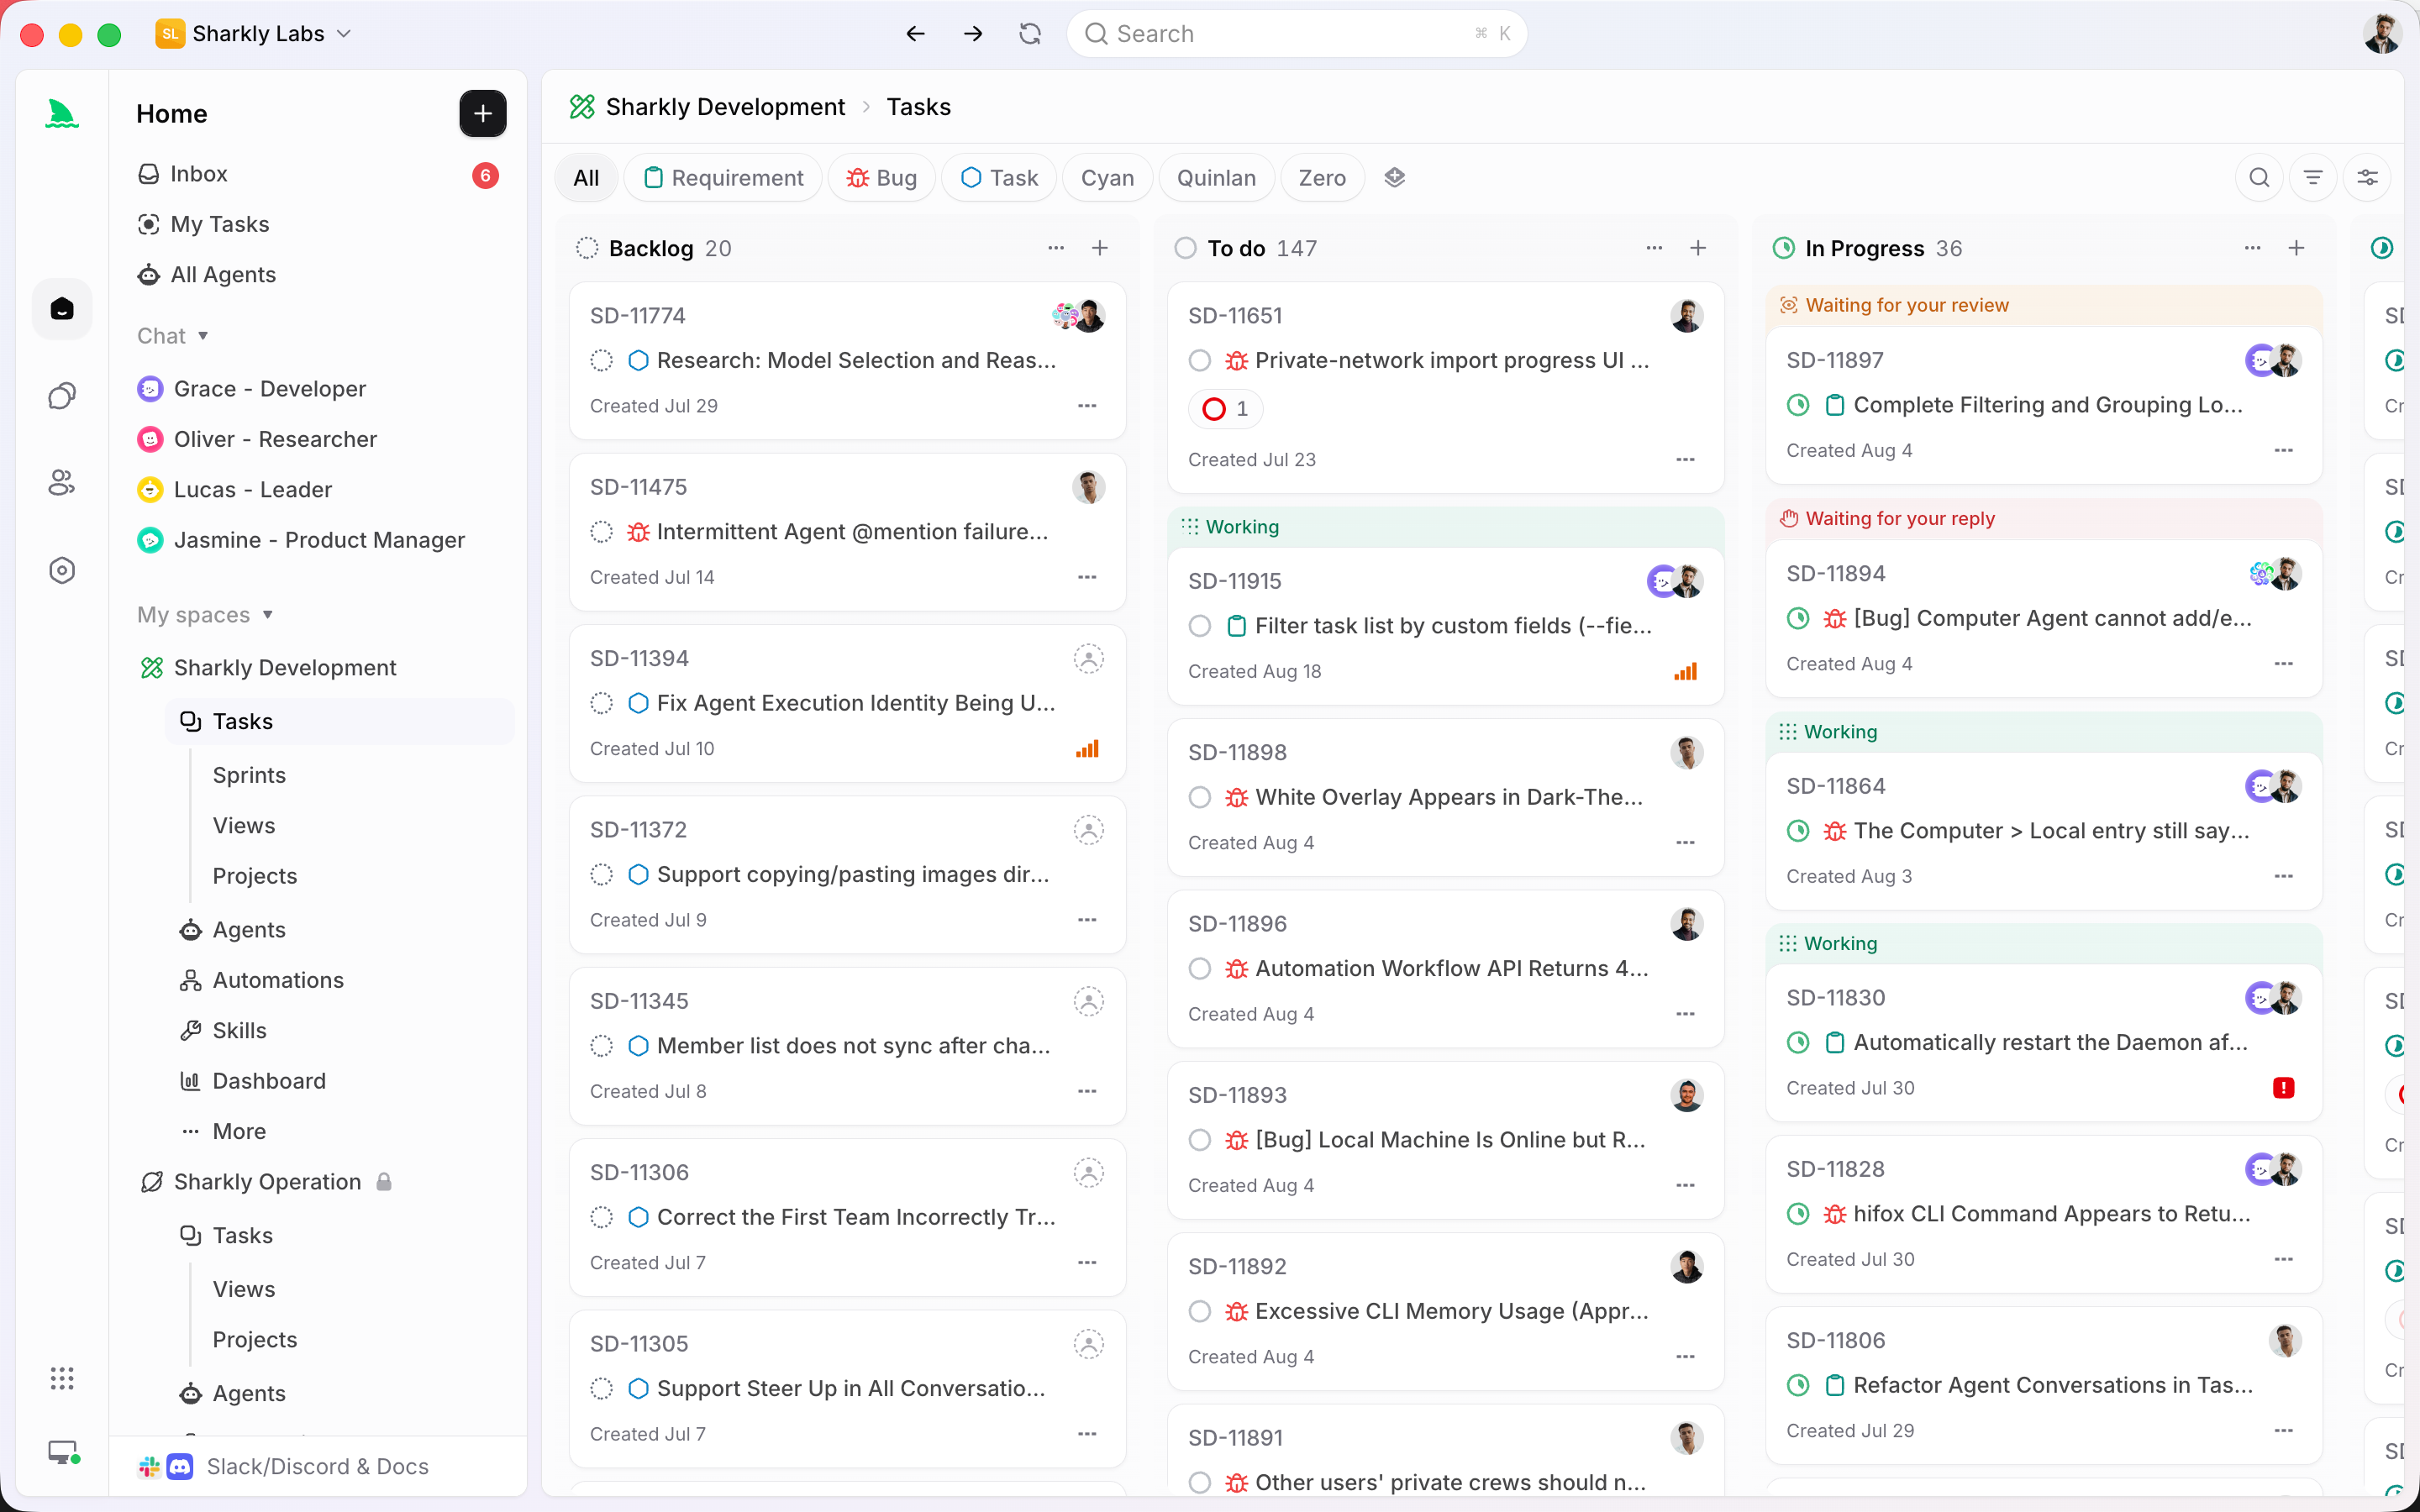
Hal itu hanya bisa diukur jika run berhenti hidup di terminal pribadi. Sharkly bukan pengganti Codex, Claude Code, atau tool lain yang menjalankan model-model ini. Ia adalah lapisan di sekitarnya, tempat konteks, progres, penghambat, hasil, dan review manusia tetap terlihat dari request sampai rilis. Eksekusi dan penghambat kembali ke Task, sehingga “menunggu manusia” menjadi status yang bisa Anda hitung di board, bukan perasaan yang muncul Jumat sore. Hitungan kapasitas review hanya berfungsi jika Anda bisa melihat antreannya.
Jika Anda sudah menjalankan beberapa coding agent, langkah minggu ini bukanlah menaikkan plafon. Langkahnya adalah mencari tahu berapa banyak run selesai yang diterima tim Anda dalam seminggu normal, menetapkan konkurensi berdasarkan angka itu, dan membelanjakan sisa anggaran untuk run yang lebih mudah diterima.


