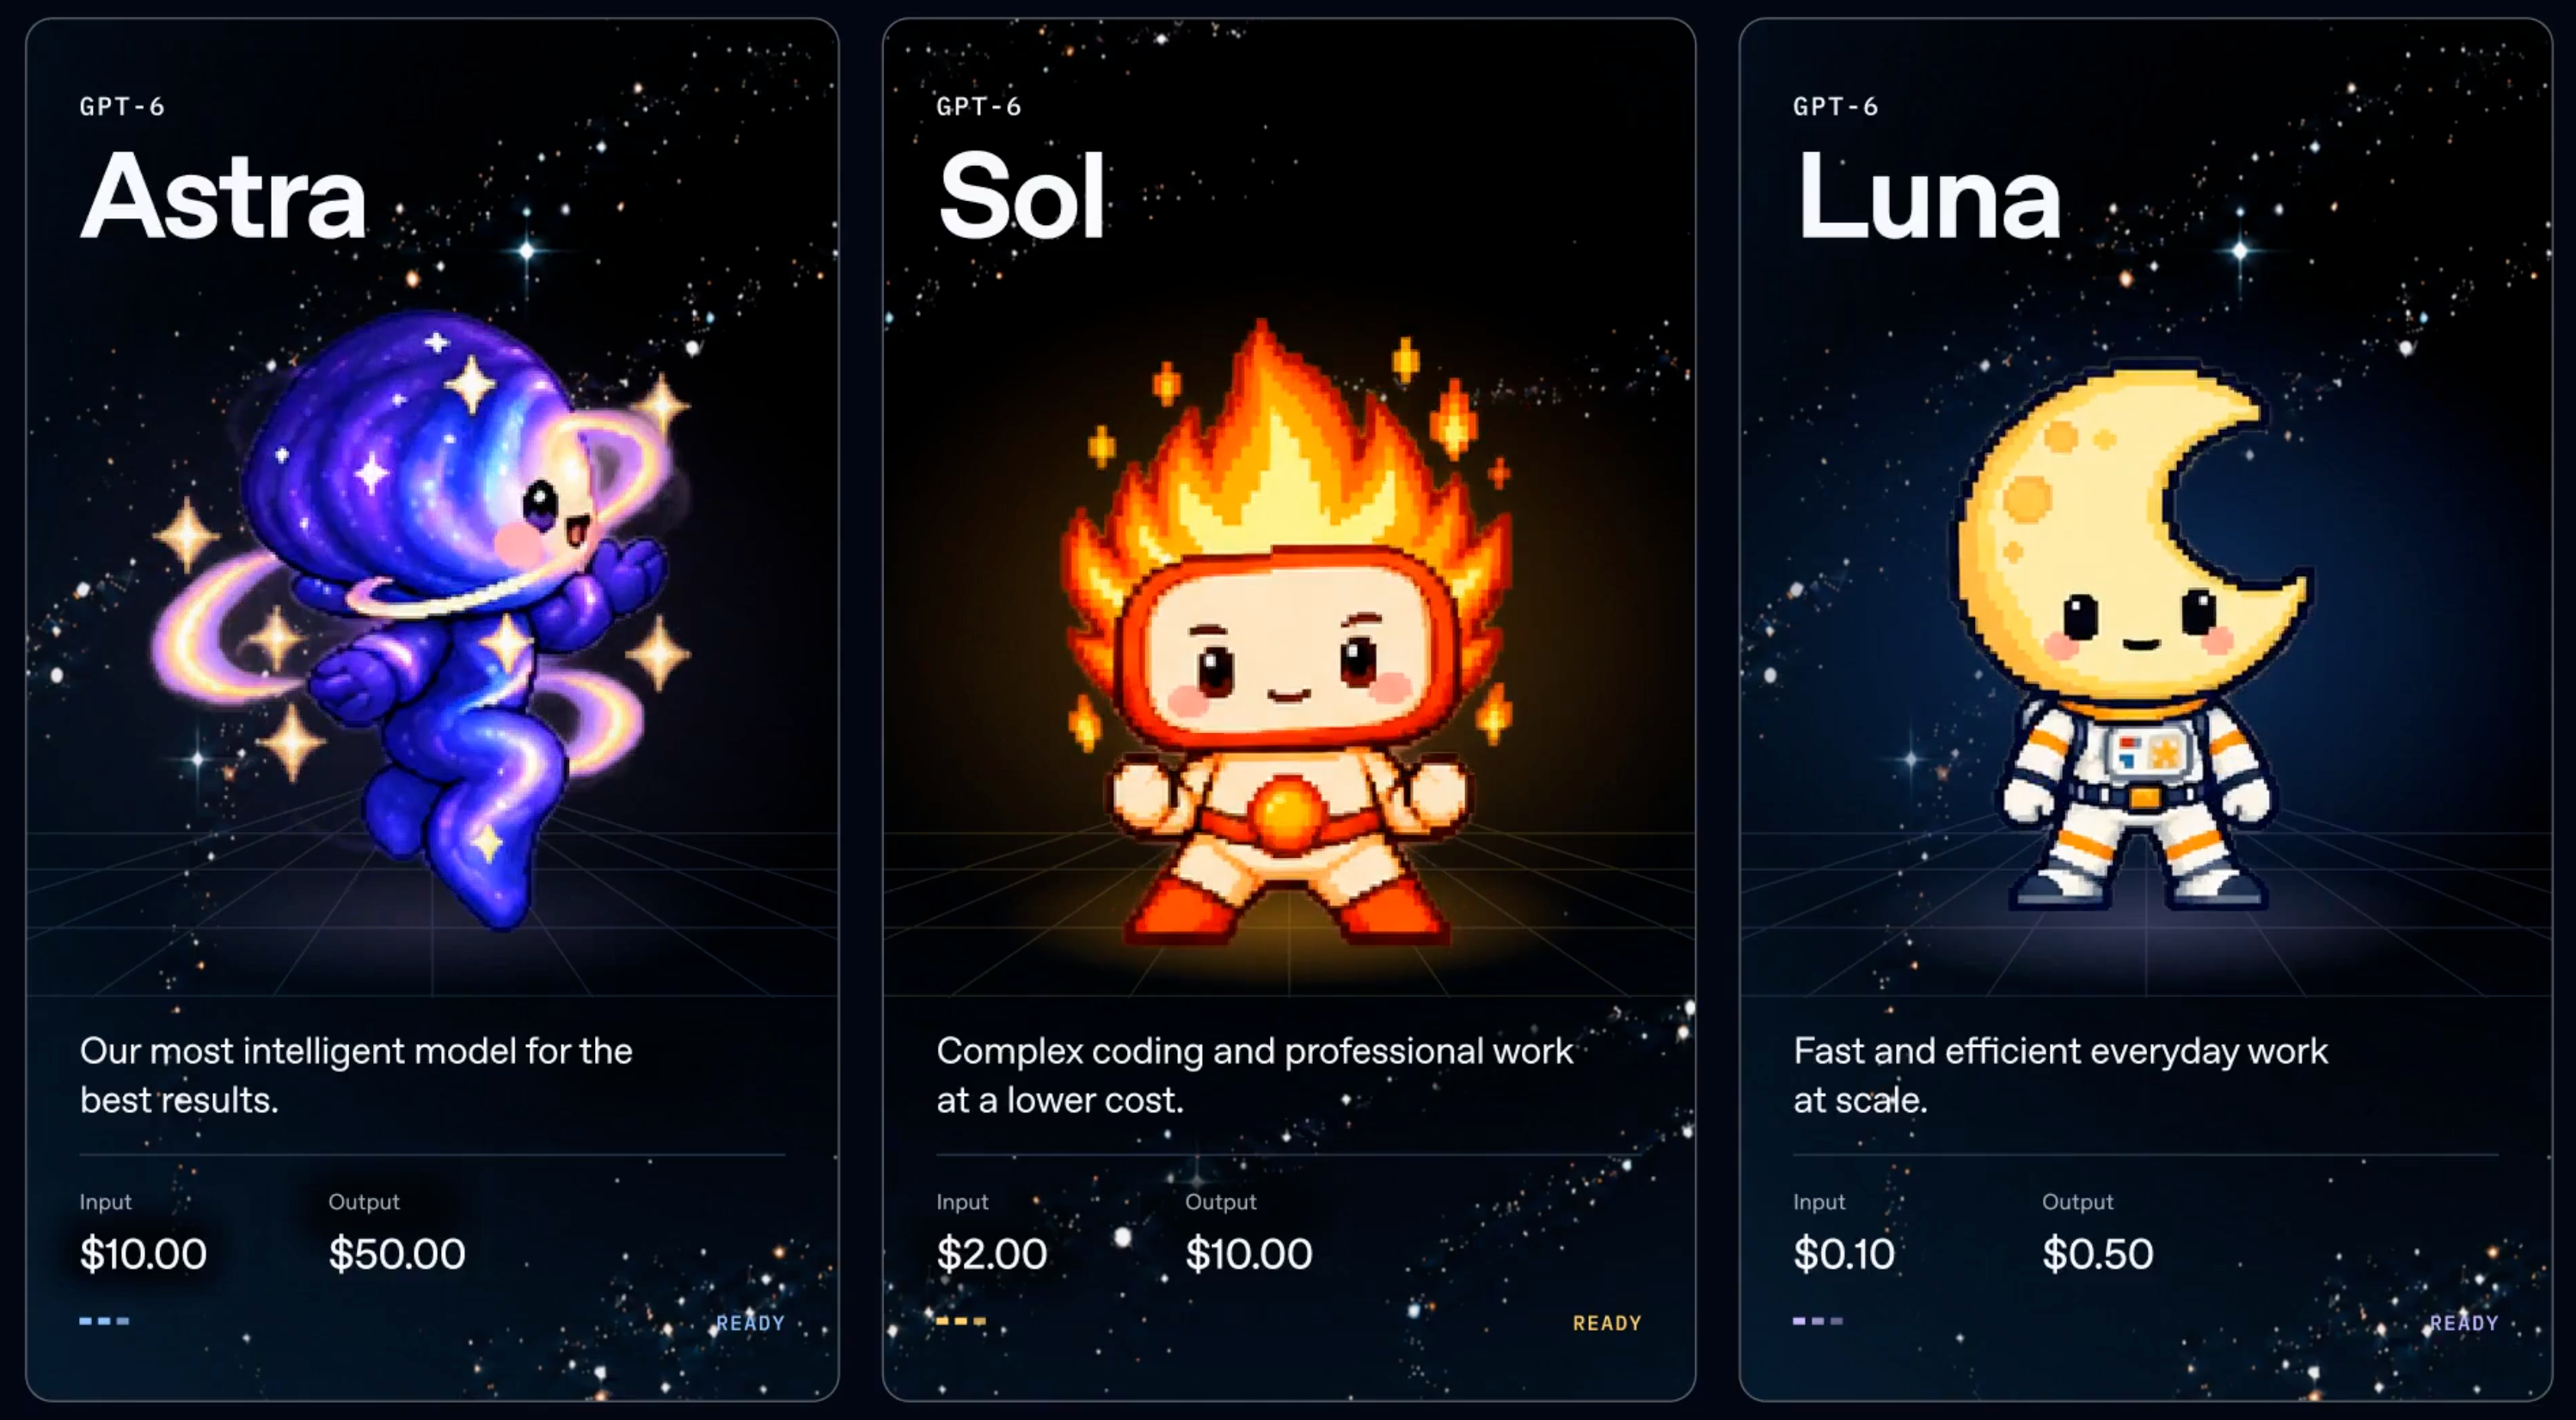
Tagihan adalah angka yang paling mudah diubah dan paling membosankan untuk dibaca. Alihkan pekerjaan rutin Crew Anda ke GPT-6 Luna seharga $0,10 dan $0,50 per satu juta token, maka pos biaya model akan anjlok dalam sehari. Dua minggu kemudian tagihan tetap rendah, papan tugas memuat lebih banyak eksekusi selesai daripada sebelumnya, tetapi empat perubahan dari hari Selasa lalu masih menunggu seseorang untuk menyetujuinya.
Tidak ada yang keliru. Anda hanya memindahkan biaya dari pos yang Anda pantau ke pos yang tidak pernah dihitung harganya oleh siapa pun.
Biaya per perubahan yang diterima (cost per accepted change) adalah total uang dan waktu manusia yang dihabiskan untuk setiap percobaan hingga menghasilkan satu perubahan yang disetujui seseorang. Angka ini memperhitungkan eksekusi yang gagal, output yang tidak pernah di-merge oleh siapa pun, serta menit-menit yang dihabiskan seseorang untuk mempertimbangkan keduanya. Tidak ada vendor yang mempublikasikannya, tidak ada tolok ukur (benchmark) yang mengukurnya, dan inilah satu-satunya angka yang benar-benar bergerak seiring dengan apa yang dirilis tim Anda.
TL;DR
Model yang lebih murah memang menurunkan biaya per percobaan, tetapi meningkatkan tiga hal yang harus dibayar dengan perhatian reviewer: jumlah percobaan per perubahan yang dirilis, output per percobaan, dan keputusan per perubahan yang dirilis. Perhatian manusia tidak menjadi lebih murah pada 22-09-2026. Tingkat (tier) murah benar-benar lebih hemat selama mesin yang menentukan apakah suatu percobaan lolos, tetapi diam-diam menjadi sangat mahal ketika manusia yang harus menentukannya. Agent bertugas meriset, mengeksekusi, menguji, dan melapor. Manusia bertugas menentukan arah, memberi otorisasi, dan menerima hasilnya. Solusinya adalah perubahan akuntansi sebelum menjadi perubahan routing: ukur jumlah percobaan dan menit kerja manusia per perubahan yang diterima, untuk setiap Runtime, dan jadikan pekerjaan yang menunggu review manusia sebagai status yang dapat dihitung, bukan sekadar firasat yang Anda rasakan di hari Jumat.
Tiga metrik, dan hanya satu yang benar-benar milik Anda
| Metrik | Siapa yang menggunakannya | Apa yang ditunjukkannya | Apa yang diabaikannya |
|---|---|---|---|
| Per satu juta token | Halaman harga vendor | Biaya input dan output | Berapa banyak token yang dibutuhkan tugas Anda |
| Per tugas yang selesai | Tabel benchmark | Biaya satu kali percobaan yang dinilai | Percobaan yang gagal, basis kode Anda, proses review |
| Per perubahan yang diterima | Tim Anda | Berapa biaya satu perubahan yang dirilis dari awal hingga akhir | Tidak ada, dan itulah mengapa tidak ada yang mempublikasikannya |
Kedua lab merilis model pada 22-09-2026, dan keduanya mempublikasikan angka di kolom tengah. Jangan membaca tabel-tabel tersebut seolah-olah itu adalah kolom kanan.
Berapa biaya tier murah dan berapa skornya
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API id | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Input / output per 1M | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| Cached input | Diskon 90% untuk read | Diskon 90% untuk read | $0.20 read, $5 write |
| Context | 1M | 872k | 1M |
| DeepSWE 1.1 pada penalaran maksimal | 66.6% | 68.8% | Tidak ada dalam materi peluncuran |
| Indeks Artificial Analysis | 37 | 48 | 58, peringkat 1 dari 212 |
Anthropic melaporkan 40,0% pada AutomationBench untuk Opus 5.5. OpenAI melaporkan 33,2% untuk Sol pada penalaran ekstra tinggi di AutomationBench 1.0.6, dengan biaya $0,27 per tugas. Dua lab, dua harness pengujian, satu publikasi biaya per tugas. Pasangan ini bukanlah perbandingan langsung (head-to-head), dan ketidakmungkinan untuk membandingkannya secara langsung justru merupakan poin utamanya: tidak ada tabel vendor yang membawa Anda ke biaya per perubahan yang diterima.
Faktor tersembunyi pertama: jumlah percobaan per perubahan yang diterima
OpenAI mencatat Luna pada penalaran maksimal di angka 66,6% pada DeepSWE 1.1 dan Sol pada tingkat maksimal di 68,8%. Berdasarkan hitungan kami sendiri, itu berarti sekitar satu dari tiga percobaan Luna tidak memberikan hasil yang lolos. Repositori Anda bukanlah DeepSWE dan tingkat keberhasilan Anda akan berbeda, tetapi polanya tetap sama: tier murah dengan skor beberapa poin lebih rendah tidak sekadar beberapa poin lebih buruk per eksekusi, melainkan beberapa poin lebih berpeluang memberi Anda hasil yang memerlukan putaran pengerjaan ulang.
Dari segi biaya uang, putaran ulang itu tetap sangat murah. OpenAI melaporkan bahwa Luna pada penalaran maksimal 93% lebih murah per tugas dibandingkan Claude Opus 5 pada benchmark yang sama. Gandakan jumlah percobaannya dan—sekali lagi menurut hitungan kami—biayanya masih sekitar 86% lebih murah. Pos biaya model tidak pernah menjadi masalahnya.
Namun percobaan yang gagal tidaklah gratis di aspek lain. Percobaan itu menghasilkan sebuah branch, ringkasan perubahan, dan sebuah keputusan yang harus diambil oleh manusia. Eksekusi yang gagal bukanlah angka nol. Itu adalah item review yang tidak menghasilkan perubahan apa pun pada akhirnya.
Faktor tersembunyi kedua: tier murah menjadi bagus karena berpikir lebih lama
Perhatikan dari mana angka bagus Luna berasal. Skor 66,6% itu dicapai pada penalaran maksimal, dan catatan faktualitas OpenAI menyatakan bahwa Luna dengan tingkat upaya lebih tinggi dapat menandingi GPT-5.6 Sol dengan biaya sekitar seperseratusnya. Tier murah mencapai kualitas yang dapat diterima dengan mencurahkan lebih banyak upaya (effort), dan upaya tersebut berwujud sebagai token output serta waktu tunggu nyata (wall-clock time).
Artificial Analysis, pihak ketiga independen di luar kedua vendor tersebut, mengukur bahwa varian penalaran maksimal menghasilkan 153,9 token output per detik untuk Luna dengan 124,23 detik hingga token pertama (time to first token), serta 115,2 token per detik untuk Sol dengan 102,15 detik. Anggap angka-angka tersebut sebagai indikasi: data ini berasal dari pihak ketiga, mencakup varian penalaran maksimal secara spesifik, dan dapat berubah seiring pengukuran ulang oleh lab terkait.
Dua konsekuensinya jatuh ke tim Anda, bukan ke tagihan Anda. Eksekusi yang hening selama dua menit tampak persis seperti eksekusi yang macet (hung), sehingga seseorang harus meluangkan waktu untuk memeriksanya. Selain itu, jejak (trace) yang lebih panjang dengan diff yang lebih panjang berarti lebih banyak hal yang harus dibaca, di setiap percobaan, sebelum seseorang dapat menyetujuinya. Kemampuan membaca adalah sumber daya yang terbatas, dan Anda baru saja membeli lebih banyak hal yang menguras sumber daya tersebut.
Faktor tersembunyi ketiga: keputusan, bukan sekadar diff
Hitunglah berapa banyak keputusan manusia antara sebuah Task diberikan hingga suatu perubahan disetujui. Pada Runtime yang kuat, jalurnya biasanya cuma satu: baca, lalu setujui. Pada Runtime murah yang mengerjakan tugas yang sulit diverifikasi secara otomatis, jalurnya bercabang, dan setiap cabang membutuhkan campur tangan manusia:
- Eksekusi gagal. Coba lagi di Runtime yang sama, atau eskalasikan ke Runtime yang lebih kuat?
- Eksekusi lolos pengujian tetapi menggunakan pendekatan yang tidak akan Anda pilih. Setujui, atau kembalikan untuk direvisi?
- Eksekusi menghasilkan tiga hasil parsial. Mana yang merupakan perubahannya?
- Eksekusi berhenti untuk menanyakan sesuatu. Siapa yang menjawab, dan di mana jawaban tersebut dicatat?
Tidak ada satu pun dari hal tersebut yang tercantum dalam tagihan token. Semuanya justru menumpuk di kalender siapa pun yang bertanggung jawab atas review manusia.
Rumusnya, dengan angka-angka Anda sendiri
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
Masukkan angka-angka Anda sendiri, bukan angka kami. Pada tarif $0,10 dan $0,50 per satu juta token, biaya model di dalam tanda kurung tersebut praktis mendekati nol, sehingga rumus ini sepenuhnya didominasi oleh menit kerja reviewer dikalikan jumlah percobaan. Beralih ke Runtime yang lebih murah menyusutkan pos biaya yang memang sudah kecil dan melipatgandakan pos biaya yang besar. Terkadang itu masih merupakan kompromi yang menguntungkan. Namun, hal itu tidak akan pernah bisa Anda nilai hanya dari halaman daftar harga.
Kapan tier murah benar-benar lebih hemat
Gunakan Runtime murah ketika mesin yang menentukan apakah suatu percobaan lolos. Typecheck, unit test, build, lint rule, schema check: hasilnya sudah keluar sebelum manusia mencurahkan perhatian, dan percobaan ekstra diserap oleh harness pengujian alih-alih menyita hari Jumat Anda. Itulah porsi terbesar dari beban kerja dalam sebuah Crew yang aktif, dan alasan kuat yang masuk akal untuk mendelegasikan 80% pekerjaan yang membosankan ke Luna.
Jangan gunakan Runtime murah ketika persetujuan membutuhkan penilaian manusia (judgement). Keputusan arsitektur, migrasi data, apa pun yang relevan dengan keamanan, atau hal apa pun di mana pertanyaan “apakah ini benar?” tidak dapat dijawab oleh sebuah perintah terminal. Di ranah tersebut, selisih skor benchmark langsung berubah menjadi menit kerja reviewer, dan hal paling murah yang bisa Anda beli adalah percobaan yang hanya perlu Anda baca satu kali.
Tuliskan aturan eskalasi secara jelas alih-alih menyerahkannya pada preferensi semata, karena preferensi selalu kalah melawan harga yang lebih murah. Routing model adalah aturan tentang kemampuan verifikasi terlebih dahulu, baru kemudian biaya.
Mengapa tidak ada vendor yang akan memberi tahu Anda hal ini
Kedua lab melakukan benchmark satu sama lain pada hari yang sama, dan baseline perbandingan OpenAI adalah Claude Opus 5, yang beberapa jam kemudian langsung digantikan oleh Anthropic dengan Opus 5.5. Tier murah dari setiap vendor adalah pintu masuk utama (top of funnel) mereka. Tidak ada yang akan mempublikasikan kalimat “model hemat kami akan menuntut putaran review tambahan dari tim Anda”, dan mereka juga tidak salah jika tidak mencantumkannya: angka tersebut sangat bergantung pada basis kode dan tim Anda sendiri.
Sharkly tidak menjual token model. Penggunaan model tetap berjalan melalui langganan atau API key yang dikonfigurasi di tools yang sudah digunakan tim Anda, sehingga kami tidak memiliki kepentingan apa pun terhadap Runtime mana yang Anda pilih. Hanya dari posisi independen inilah argumen ini dapat disampaikan secara jujur, dan ini pula alasan alur kerja Anda harus tetap bertahan tanpa perlu dibangun ulang saat model murah berikutnya dirilis.
Apa yang sebaiknya dipasang di dashboard sebagai gantinya
Menit kerja manusia per perubahan yang diterima, per Runtime. Jika angka tersebut naik setelah Anda beralih model, maka model yang lebih murah itu sebenarnya lebih mahal, dan sekarang Anda memiliki buktinya. Dolar per eksekusi menjawab pertanyaan yang sudah tidak lagi relevan sejak 22-09-2026.
Jumlah percobaan per perubahan yang diterima, per Runtime. Faktor ini menentukan segalanya dan tidak ada vendor yang bisa memberikannya kepada Anda. Anda mendapatkannya dengan mencatat Runtime mana yang menghasilkan setiap percobaan, tepat pada Task yang bersangkutan.
Status menunggu manusia sebagai status yang nyata. Eksekusi, kendala (blocker), hasil, dan diskusi lanjutan dikembalikan ke timeline Task, sehingga antrean yang membutuhkan manusia dapat dihitung secara pasti, bukan sekadar cerita angin lalu. Wajibkan setiap eksekusi untuk menyertakan buktinya:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
Anda tidak membutuhkan semua ini dalam skala kecil. Jika satu orang menjalankan dua Agent dan membaca semuanya di sore hari yang sama, teruskan saja: status dan antrean hanya menjadi beban tambahan untuk masalah yang belum Anda miliki. Pengukuran semacam ini baru mulai penting ketika tidak ada lagi yang bisa mengingat di luar kepala berapa banyak eksekusi selesai yang sedang menunggu untuk ditinjau.
Bagian yang tidak menjadi lebih murah
Dua lab memangkas biaya percobaan dalam satu hari yang sama. Namun tidak satu pun yang merilis alat yang bisa membaca diff untuk Anda, dan tanggung jawab atas perubahan tetap bermuara pada manusia. Model yang lebih murah bukan berarti alur kerja yang lebih murah. Itu hanyalah percobaan yang lebih murah, dan setiap percobaan bermuara pada suatu proses yang tahap termahalnya adalah manusia.
Jika Anda sudah menjalankan beberapa agent coding, Sharkly memberi Anda satu tempat terpusat untuk melihat Runtime mana yang menghasilkan percobaan tertentu, bukti apa yang dilampirkannya, dan seberapa banyak pekerjaan yang saat ini sedang menunggu tinjauan manusia.