네, 하루 전 공개된 DeepSeek V4.1 Flash와 동일한 조건으로 무료 지원됩니다. 2026년 10월 16일, OpenCode는 "OpenCode에서 GLM 5.3 Flash를 무료로 제공한다"고 발표했습니다. 해당 모델명은 opencode/glm-5.3-flash-free이며, OpenCode Zen 공식 문서에서는 이를 "한시적 무료"로 명시하고 있습니다. 무료 티어는 오직 OpenCode의 요청에만 응답합니다. 다른 환경에서 동일한 엔드포인트를 호출하면 "OpenCode’s free tier can only be used from within OpenCode"라는 메시지와 함께 HTTP 403 에러가 반환됩니다.
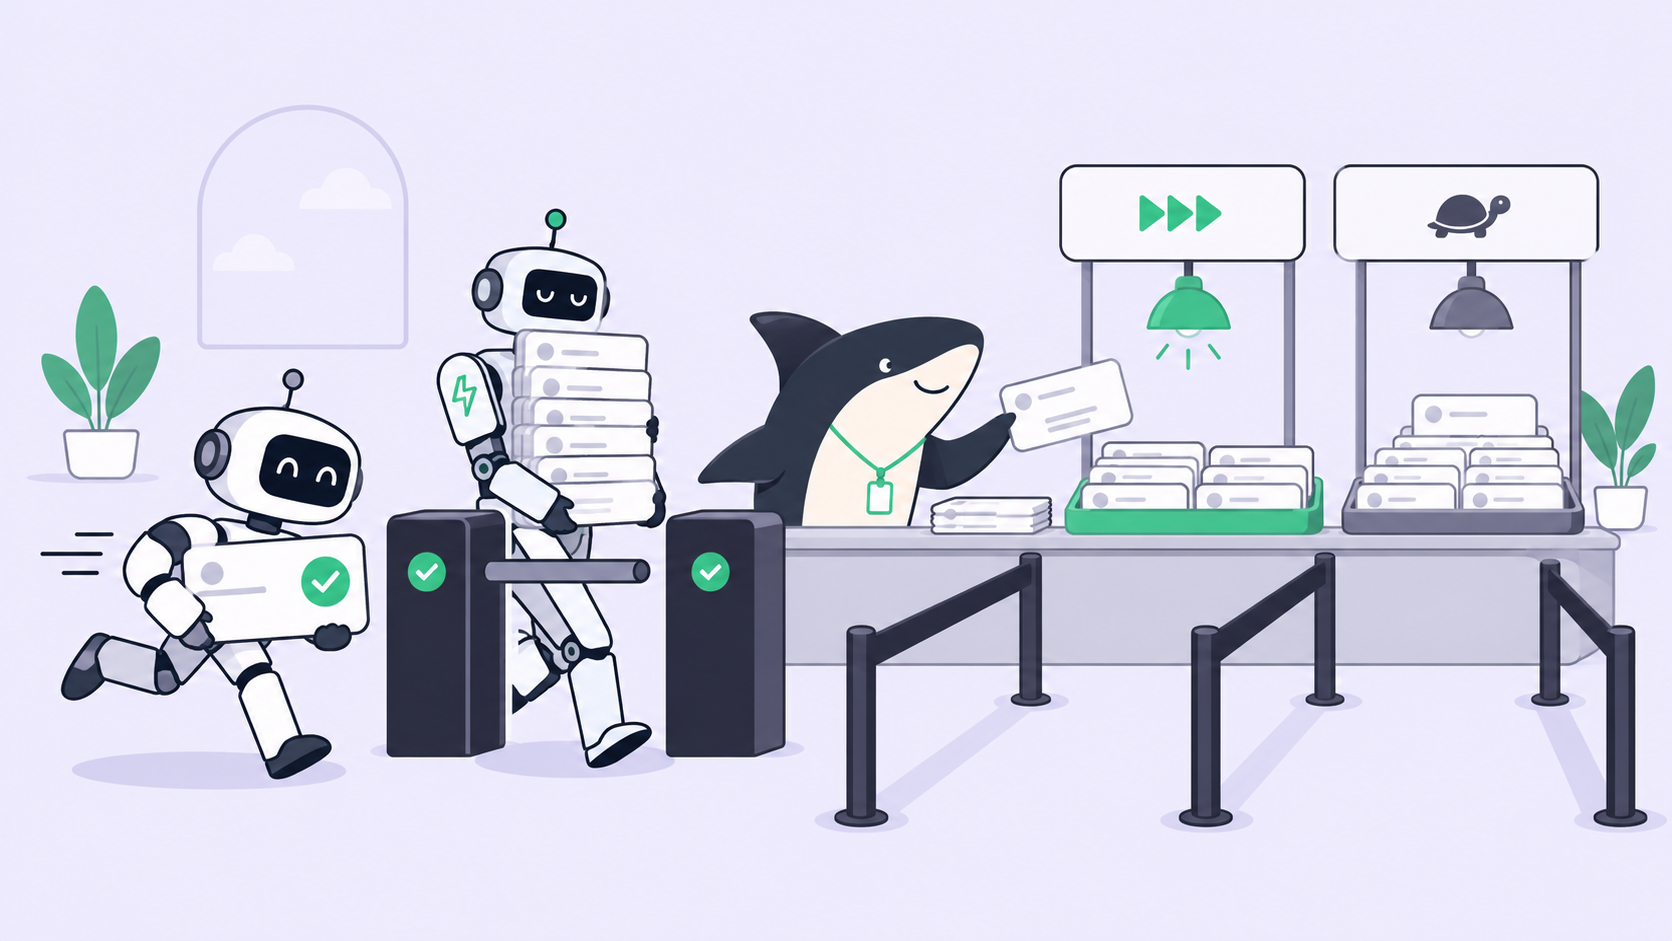
도입을 계획하기 전에 알아두어야 할 두 가지 제약이 있습니다. 첫째, 무료 모델은 GLM-5.3 풀 버전(Zen 기준 입력 토큰 100만 개당 1.40달러)이 아닌 GLM-5.3-Flash입니다. 둘째, '무료'라고 해서 속도까지 빠른 것은 아닙니다. 10월 16일 새로 설치한 OpenCode 환경에서 테스트해 본 결과, 모든 답변의 정확도는 뛰어났으나 동일한 한 줄짜리 질문에도 응답 시간이 7초에서 196초까지 크게 벌어졌습니다. 이는 이 모델에 어떤 작업(Task)을 맡겨야 할지를 좌우하는 중요한 요소입니다. 아직 Sharkly 작업(Sharkly Task)에서는 직접 구동해 보지 않았으므로, 본문에서는 여러분의 런타임(Runtime)에서 모델 사용이 가능한지 확인하는 스모크 테스트(smoke test)까지의 설정 과정을 안내합니다.
핵심 요약 (TL;DR)
무료 모델은 런타임이 OpenCode로 설정된 에이전트(Agent)에서만 사용할 수 있으며, 다른 런타임에서는 접근할 수 없습니다. 컴퓨터(Computer)에서 OpenCode의 모델 목록을 새로고침하고, OpenCode 설정에 모델을 지정한 뒤, 터미널에서 스모크 테스트를 거쳐 작은 작업(Task) 하나를 할당해 보세요. 제한 사항은 컨텍스트 200K 토큰, 최대 출력 32K 토큰이며, PDF 첨부는 지원되지 않고 무료 프로모션 종료일은 공개되지 않았습니다. 테스트 결과 응답 속도가 느리고 편차가 컸으므로, 누군가 결과를 기다리고 있는 작업보다는 백그라운드 작업에 배정하는 것이 좋습니다. 이미 DeepSeek V4.1 Flash Free를 사용 중이라면 응답 소요 시간에 따라 두 모델에 작업을 나누어 분배할 수 있습니다.
하나의 런타임에서 활용하는 두 가지 무료 모델
런타임(Runtime)이란 컴퓨터에서 세션을 수행하는 에이전트 도구를 뜻합니다. OpenCode의 무료 티어는 요청의 출처를 검증하므로, 이전 글인 DeepSeek V4.1 Flash 관련 글에서 다루었던 규칙이 그대로 적용됩니다. 즉, OpenCode 런타임 기반의 에이전트만 무료 모델에 접근할 수 있도록 설계되어 있으며, Claude Code, Codex, Gemini CLI 기반의 에이전트는 접근할 수 없습니다.
새로운 점은 이제 하나의 OpenCode 런타임에서 서로 다른 모델 계열의 두 무료 모델을 제공한다는 것입니다. 두 모델은 제한 사양은 공유하지만 동작 특성에서는 차이를 보입니다.
| GLM-5.3-Flash Free | DeepSeek V4.1 Flash Free | |
|---|---|---|
| 무료 제공 시작일 | 2026년 10월 16일 | 2026년 10월 15일 |
| 컨텍스트 / 최대 출력 | 200K / 32K | 200K / 32K |
| 유료 버전 제한 | 1M / 131K | 1M / 384K |
| 한 줄 질문 테스트 (자체 테스트) | 7~196초 (11회 테스트) | 4~15초 (3회 테스트) |
| 소규모 작성 및 실행 작업 (자체 테스트) | 13~109초 (5회 테스트) | 16~36초 (3회 테스트) |
| 이미지 입력 | 테스트 시 정상 작동 | OpenCode 메타데이터에 명시됨 |
| PDF 첨부 | 거부됨: “only text and image_url are” supported | OpenCode 메타데이터에서 비활성화됨 |
| Zen 문서 기준 데이터 정책 | 데이터 미보존(Zero retention), 학습 미사용 | 데이터 미보존(Zero retention), 학습 미사용 |
위 제한 사양은 OpenCode에서 제공하는 모델 메타데이터(opencode models opencode --verbose)를 바탕으로 정리한 것입니다. 소요 시간은 출시 당일 OpenCode 1.19.2 버전으로 직접 측정한 결과이며, 실행마다 편차가 매우 컸습니다. --variant low 옵션을 설정해도 GLM 모델의 속도가 안정적으로 빨라지지는 않았습니다. 다른 실행에서는 11초 만에 끝난 질문에 저비용(low-effort) 설정으로 196초가 걸리기도 했습니다. 이러한 지연은 모델의 추론 깊이 문제라기보다는 무료 엔드포인트의 트래픽 부하 때문으로 보입니다.
무료 GLM-5.3-Flash 에이전트 설정하기
1. 컴퓨터에 OpenCode를 설치합니다. 공식 스크립트를 사용하여 설치하거나, 런타임 상세 페이지에서 제공하는 경우 원클릭 설치(One-click install)를 이용합니다.
curl -fsSL https://opencode.ai/install | bash
컴퓨터 상세 페이지에서 런타임을 다시 감지(Re-detect Runtimes)하여 OpenCode 런타임의 상태가 'Available(사용 가능)'로 표시되는지 확인합니다. 컴퓨터가 온라인 상태라고 해서 런타임까지 바로 사용할 수 있는 것은 아닙니다.
2. 모델 목록을 새로고침합니다. OpenCode는 모델 카탈로그를 캐시합니다. 새로 설치했을 당시에는 새로고침하기 전까지 GLM을 제외한 9개의 무료 모델만 표시되었습니다. 로컬 서비스를 실행하는 사용자와 동일한 계정으로 다음 명령을 실행합니다.
opencode models opencode --refresh | grep glm-5.3-flash-free
3. 컴퓨터에서 모델을 한 번 설정합니다. 에이전트는 기본적으로 런타임의 기본 모델 설정을 따르며, OpenCode의 전역 설정 파일은 해당 컴퓨터의 모든 OpenCode 세션에 이 기본값을 적용합니다. 다음 내용을 ~/.config/opencode/opencode.json 파일로 저장합니다.
{
  "$schema": "https://opencode.ai/config.json",
  "model": "opencode/glm-5.3-flash-free"
}
런타임 카탈로그에 해당 모델이 표시된다면 에이전트의 Model 항목에서 직접 선택할 수도 있습니다. Model 항목 설정은 해당 에이전트에 한해 런타임 기본 설정을 덮어쓰므로, 하나의 컴퓨터에서 두 개의 OpenCode 에이전트가 각기 다른 무료 모델을 실행하도록 구성할 때 유용합니다.
4. 터미널에서 스모크 테스트를 진행한 뒤, 작업 하나를 할당합니다.
opencode run "Reply with the word ok."
출력 결과의 첫 줄에 사용 중인 모델 이름이 표시됩니다. 모델명이 glm-5.3-flash-free로 나오고 이어서 ok가 출력되어야 합니다. 응답이 지연될 수 있으므로 실패로 판단하기 전에 몇 분 정도 여유를 두고 기다려 보세요. 터미널 테스트가 통과되면 완료 조건이 명확한 작은 작업 하나를 할당하고, 실행 로그를 확인하여 어떤 모델이 작업을 수행했는지 확인합니다.
느린 응답 속도를 고려한 작업 분배 전략
응답 시간에 편차가 있더라도 무료 모델은 여전히 유용합니다. 다만 3분 정도의 지연이 발생해도 아무런 문제가 없는 작업에 배치해야 합니다.
GLM 에이전트는 백그라운드 작업에 활용하세요. 특정 모듈의 테스트 코드 보강, 패키지 전반의 린트(lint) 수정, API 변경에 따른 README 업데이트, 의존성 패키지 버전 업데이트처럼 검토를 위해 결과물이 나올 때까지 아무도 실시간으로 지켜보지 않아도 되는 작업에 적합합니다. 반면 누군가의 작업 진행을 가로막고 있는 병목 작업에는 더 빠른 에이전트를 배치하세요. 동료가 버그 수정을 기다리고 있다면, 4~15초 만에 응답하는 DeepSeek 에이전트나 유료 모델을 사용하는 것이 훨씬 낫습니다.
낮은 동시성(concurrency)으로 시작하세요. 속도가 느린 실행은 완료될 때까지 할당된 작업을 계속 붙잡고 있게 됩니다. 에이전트의 최대 동시성(할당된 작업 수)을 1로 유지하고, 며칠 동안 오류 없이 안정적으로 실행된 후에만 값을 올리세요. Sharkly의 공식 권장 사항도 동일합니다. "현재 컴퓨터와 런타임이 기존 워크로드를 안정적으로 처리한 이후에만" 동시성을 늘려야 합니다. 부하가 걸린 무료 엔드포인트에 작업을 병렬로 요청해 봐야 대기열(큐) 시간만 늘어날 뿐입니다.
이미지는 유용하지만, PDF는 지원되지 않습니다. 테스트 결과 모델이 API 사양 스크린샷을 읽고 유효한 OpenAPI 명세 파일을 작성할 수 있었습니다. 다만 특정 제한 수치를 30,000 대신 300,000으로 잘못 입력했는데, 이는 JSON 유효성 검사를 그대로 통과해 버렸습니다. 따라서 이미지에서 추출한 내용은 다른 코드 변경 사항과 마찬가지로 면밀히 검토해야 합니다. 작업 입력값이 PDF인 경우 먼저 각 페이지를 이미지로 변환하세요. 무료 엔드포인트는 PDF를 아예 거부합니다.
진짜 비용은 여전히 코드 리뷰에 있습니다. 무료 토큰을 쓴다고 해서 변경 사항을 승인하고 병합하는 비용까지 저렴해지는 것은 아닙니다. 저렴한 모델이 오히려 더 많은 비용을 유발하는 경우에서는 최종 반영된 변경 사항당 실행 비용을 계산하여 에이전트가 제 몫을 하고 있는지 판단하는 기준을 제시합니다. 또한 모델 혼합 크루(Mixed-model Crews)에서는 저렴한 작업자 뒤에 강력한 리뷰어 모델을 배치하는 방식을 다루며, 비용이 0달러인 작업자 역시 동일한 패턴으로 운용할 수 있습니다.
프로모션 종료 시 대처 방법
이 모델은 이전에도 무료로 제공된 적이 있습니다. 2026년 8월 20일부터 Ox Alpha라는 익명의 모델이 1M 토큰 컨텍스트 창을 갖추고 OpenCode의 무료 목록에 등록되었습니다. 8월 26일, Z.ai가 이 모델의 정체가 GLM-5.3-Flash임을 밝혔고, 6일 만에 무료 제공이 종료되었습니다. OpenCode가 참조하는 models.dev 카탈로그를 보면 이전에 무료로 제공되던 GLM 모델인 glm-4.7-free와 glm-5-free는 이미 지원 중단(deprecated)으로 표시되어 있습니다.
이번 프로모션 역시 마찬가지로 종료될 수 있음을 염두에 두어야 합니다. 프로모션이 끝나면 에이전트의 실행이 모델 에러와 함께 실패하기 시작하며, 실패한 작업은 실행 로그와 수신함(Inbox)에 표시되어 다음 조치를 결정할 수 있습니다. 모델 설정은 단 하나의 설정 파일에 있으므로 수정 한 번으로 전환할 수 있습니다.
- OpenCode Zen 유료
glm-5.3-flash: 1M 토큰 컨텍스트 창 전체를 제공하며, 입력 토큰 100만 개당 0.15달러, 출력 토큰 100만 개당 0.50달러입니다. - OpenCode Go: 월 10달러 요금제로, 이 모델에 대해 월 60달러 상당의 사용 한도가 제공됩니다. OpenCode Go 문서에 따르면 월 약 31,580회의 요청이 가능합니다.
- Z.ai 자체 API: 동일하게 0.15달러 및 0.50달러이며, 캐시된 입력은 0.03달러입니다.
- 작업 이전: 해당 작업들을 다른 런타임의 에이전트에 재할당하면, 보드에서 작업 이력을 그대로 유지할 수 있습니다.
무료 및 저비용 티어에서 에이전트 크루를 운영하는 데 드는 비용에서 모델별 대안을 비교해 볼 수 있습니다.
이 에이전트 사용 시 팀이 부담하는 실제 비용
청구 항목은 두 가지이며, '무료' 여부도 각각 별도로 적용됩니다. 첫째는 시트(Seat) 비용입니다. Sharkly 요금제는 최대 5인 조직까지 무료이며, 이후 연간 청구 시 인당 월 7달러가 청구됩니다. 에이전트와 컴퓨터는 시트 수에 포함되지 않습니다(세부 내용). 둘째는 모델 비용입니다. Sharkly는 토큰을 직접 판매하지 않으며, 각 런타임에 설정된 계정을 통해 사용량이 소진되는 BYOK(사용자 API 키 등록) 방식을 취하고 있습니다. 프로모션이 지속되는 동안 OpenCode 에이전트의 모델 사용 비용은 0달러입니다.
결론
GLM-5.3-Flash는 오직 OpenCode 기반 코딩 에이전트에만 무료로 제공되며, 그 외의 환경에서는 사용할 수 없습니다. 모델 목록을 새로고침하고, 컴퓨터에 설정한 뒤, 여유를 갖고 스모크 테스트를 진행해 보세요. 그리고 다른 에이전트의 유료 토큰이나 개발자의 대기 시간을 낭비할 필요가 없는 백그라운드 작업을 배정하세요. 프로모션이 종료되더라도 작업 내역과 이력, 리뷰 기록은 보드에 그대로 유지되며, 에이전트 설정 파일 하나만 수정하면 다른 모델로 쉽게 전환할 수 있습니다. 이미 여러 에이전트를 운영 중이라면 Sharkly를 통해 한곳에서 작업을 배정하고 작업 결과를 검토해 보세요.