
TL;DR: GPT-6.2의 API 속도 제한은 Astra와 Sol 모두 동일합니다. Build 티어에서 RPM 5,000회, TPM 1,000,000개, Launch에서 RPM 10,000회, TPM 4,000,000개, Grow에서 RPM 15,000회, TPM 40,000,000개입니다. 제한은 조직 단위와 프로젝트 단위로 적용되므로 하나의 키를 사용하는 모든 에이전트가 한도를 공유합니다. 에이전트 팀에서는 요청 수가 아닌 분당 토큰 수가 먼저 소진됩니다.
OpenAI가 2026년 11월 17일 GPT-6.2 Astra와 GPT-6.2 Sol을 출시했습니다. Astra는 가장 어려운 작업을 위한 프론티어 모델이고, Sol은 OpenAI의 표현을 빌리면 "대규모 에이전트 구동"을 위해 만들어진 더 저렴한 일상용 모델입니다.
에이전트 하나로는 한도에 도달하기 어렵습니다. 하지만 하나의 API 키로 에이전트 6개를 돌리면 점심 무렵에는 한도에 걸립니다. 이 가이드에서는 GPT-6.2 속도 제한, Codex 플랜 한도, 그리고 에이전트 팀이 실패하지 않고 대기열에서 기다리도록 규모를 조정하는 방법을 다룹니다. 이미 여러 코딩 에이전트를 운영 중이라면 Sharkly에서 동시에 실행할 에이전트 수를 설정할 수 있습니다.
사용 티어별 GPT-6.2 속도 제한
GPT-6.2 Astra와 GPT-6.2 Sol은 OpenAI의 Sol 모델 페이지와 Astra 모델 페이지에 동일한 표준 속도 제한표를 공유합니다. RPM은 분당 요청 수, TPM은 분당 토큰 수를 의미하며, 어느 쪽이든 먼저 소진되면 더 이상 요청할 수 없습니다.
| 티어 | 승급 기준 (총 크레딧 구매액) | 월 사용 한도 | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5,000 | 1,000,000 |
| Launch | $100 | $5,000 | 10,000 | 4,000,000 |
| Grow | $500 | $200,000 | 15,000 | 40,000,000 |
승급 기준과 월 사용 한도 수치는 OpenAI의 속도 제한 가이드에서 가져온 것입니다. 티어는 총 크레딧 구매액이 각 기준을 넘으면 자동으로 승급됩니다. 월 사용 한도는 직접 설정한 지출 한도와 별개의 상한입니다.
Astra는 토큰당 비용이 Sol의 4배입니다(백만 토큰당 입력 $8, 출력 $40 vs. Sol의 $2와 $10)하지만 속도 제한은 동일합니다. 어떤 한도에 먼저 걸리는지는 에이전트가 처리하는 토큰 양에 달려 있습니다.
Codex에서 GPT-6.2 사용량 한도가 작동하는 방식
API 키 대신 ChatGPT 플랜으로 Codex를 통해 에이전트를 실행한다면 다른 한도가 적용됩니다. OpenAI의 Codex 가격 페이지는 5시간 창당 로컬 메시지 수를 범위로 제시하는데, 이는 작업 크기에 따라 메시지당 비용이 달라지기 때문입니다.
| 모델 | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6~50 | 6~50 |
| GPT-6.2 Sol | 17~180 | 17~180 |
| GPT-6.1 Sol | 15~160 | 15~160 |
| GPT-6 Astra | 5~45 | 5~45 |
에이전트 팀과 관련해 중요한 네 가지 세부 사항은 다음과 같습니다:
- Pro 플랜은 현재 5시간 제한이 없습니다. 다만 주간 한도는 여전히 적용될 수 있습니다.
- 로컬 메시지와 클라우드 채팅은 하나의 사용량을 공유합니다. 클라우드 작업은 로컬 메시지보다 더 많은 사용량을 소모할 수 있습니다.
- 속도에는 대가가 따릅니다. Fast 모드는 GPT-6.2 모델에서 포함 사용량의 2배를, Ultrafast는 6배를 소모합니다.
- 긴 세션은 메시지당 더 많이 소모합니다. OpenAI에 따르면 더 많은 컨텍스트를 유지하는 작업은 사용량을 "상당히 더" 소모한다고 합니다.
저장소의 절반을 이미 읽어들인 에이전트는 매 턴마다 방대한 컨텍스트를 전송하므로 메시지 수가 빠르게 소진됩니다. Anthropic 플랜에서도 동일한 패턴을 Claude Code 사용량 한도에서 다루었고, Codex Pro 한도 축소에 대한 대응도 같은 논리를 따릅니다.
에이전트 팀을 제한하는 것은 RPM이 아닌 TPM입니다
코딩 에이전트는 수천 개의 작은 요청을 보내지 않습니다. 몇 개의 큰 요청을 보냅니다. 매 턴마다 지금까지의 대화 내용(지침, 읽은 파일, 도구 출력, 자신의 이전 추론)을 다시 전송합니다.
예시로 하나의 에이전트를 생각해 봅시다. 턴당 입력 토큰 80,000개, 분당 6턴입니다. 이는 RPM 6, TPM 약 480,000에 해당합니다. Build 티어와 비교하면:
- RPM: 5,000 중 6 사용. 전혀 문제없음.
- TPM: 1,000,000 중 480,000 사용. 에이전트 2개면 한도가 꽉 찹니다.
실제 수치는 다르겠지만 비율은 비슷할 것입니다. 에이전트는 토큰을 많이 쓰고 요청 수는 적습니다. 이 예시 에이전트의 경우 이론상 상한은 Build에서 프로젝트당 2개, Launch에서 8개입니다. 아래 규모 조정 단계의 30% 여유분을 적용하면 Build에서 1개, Launch에서 5개로 줄어듭니다. Grow에서는 속도 제한이 더 이상 병목이 되지 않고, 월 $200,000 상한이나 직접 설정한 예산이 대신 한계가 됩니다.
제한은 조직 전체에서 공유됩니다
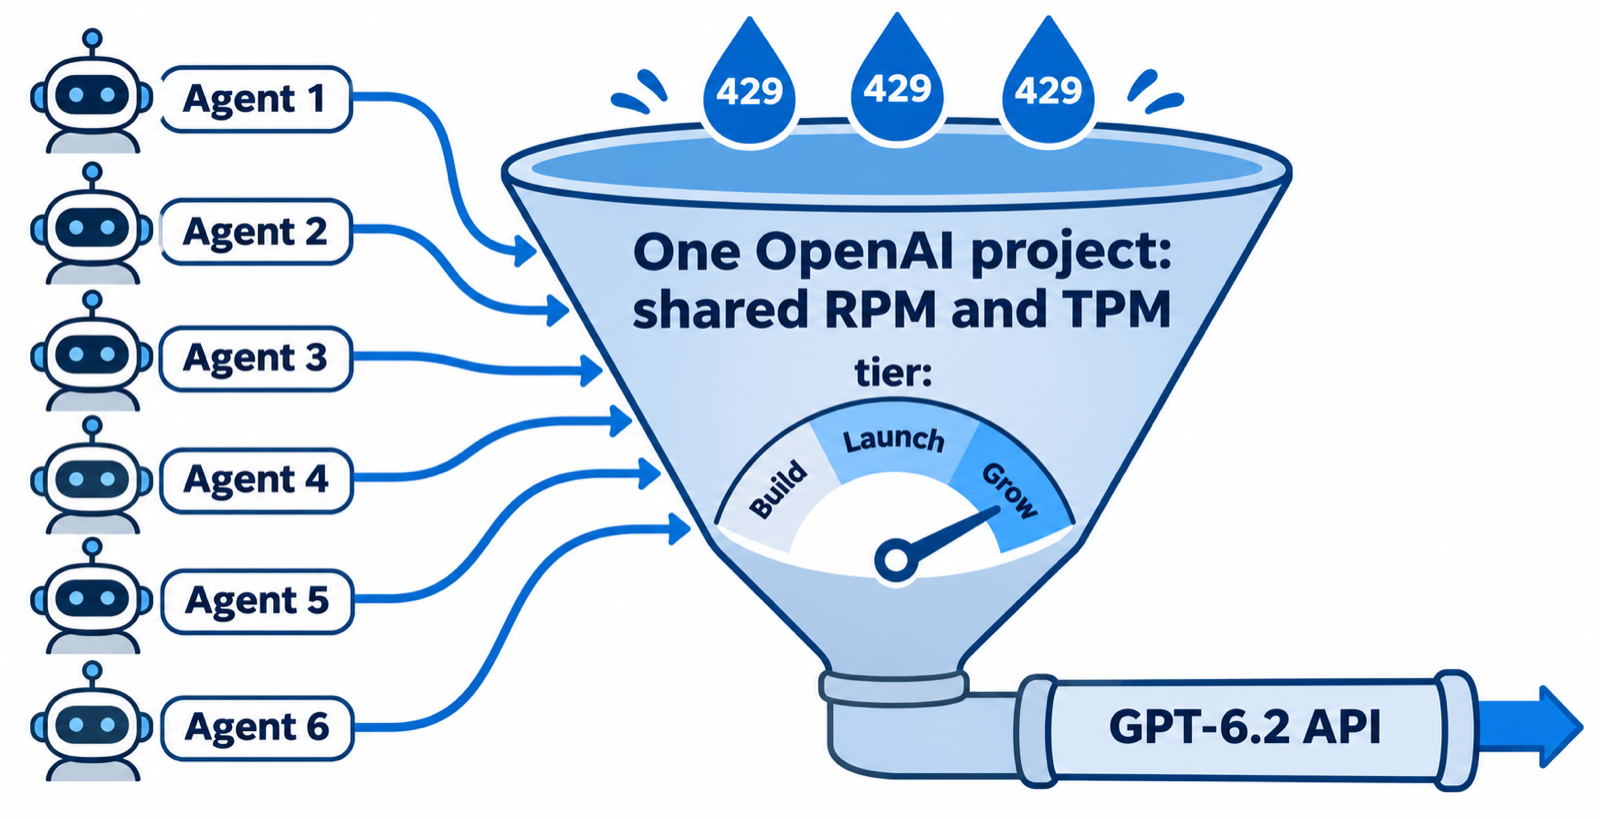
OpenAI는 속도 제한을 사용자 단위가 아닌 조직 수준과 프로젝트 수준에서 정의합니다. 한 프로젝트의 키를 사용하는 모든 에이전트는 같은 풀에서 사용량을 소진합니다. 일부 모델 계열은 한도 페이지에 공유 한도로 표시되어 있어, 한 모델로의 트래픽이 다른 모델 한도에도 포함될 수 있습니다.
GPT-6.2 티어에 맞게 에이전트 동시 실행 수 조정하기
해결책은 동시에 실행되는 에이전트 수를 제한하여, 남은 작업이 API에서 충돌하는 대신 대기열에서 기다리게 하는 것입니다. 다음 순서로 진행하세요:
- OpenAI 플랫폼의 Settings, Organization, Limits에서 티어를 확인합니다.
- 실제 에이전트 실행 하나를 측정합니다. Runtime의 사용량 출력에서 턴당 입력 토큰 수와 분당 턴 수를 기록합니다.
- TPM을 에이전트 하나의 TPM으로 나누고 급증에 대비해 30% 여유분을 남겨둡니다.
- 그 수치를 프로젝트를 사용하는 모든 에이전트의 동시 실행 상한으로 설정합니다.
- 일주일간 429 오류를 모니터링한 후, 한 번에 한 단계씩 상한을 올립니다.
Sharkly에서는 각 에이전트에 Max concurrency (assigned tasks) 설정, 분 단위의 Max run duration, 시간 단위의 Queue timeout이 있습니다. 상한이 가득 차면 새 작업은 슬롯이 비할 때까지 Queued 상태로 대기합니다. 채팅도 같은 한도를 공유할 수 있어, 대화가 한도를 몰래 우회할 수 없습니다.

Computer에도 자체 작업 동시 실행 한도가 있습니다. Sharkly 문서에 따르면 동시 실행 수가 높을수록 CPU, 메모리, 디스크, 공급자 용량, 저장소 대역폭을 더 많이 사용하므로, 현재 부하가 원활하게 돌아가는 것을 확인한 후에만 올리는 것이 좋습니다.
OpenAI 프로젝트로 에이전트 분리하기
프로젝트 수준 한도를 활용하면 에이전트 그룹을 분리할 수 있습니다. 리뷰 에이전트에는 하나의 OpenAI 프로젝트를, 대규모 리팩토링 에이전트에는 다른 프로젝트를 할당하세요. 그러면 무리한 리팩토링이 자기 프로젝트 한도에 걸릴 뿐, 리뷰 작업을 굶기지 않습니다. 조직 한도가 전체를 여전히 제한하므로, 이 방식은 우선순위를 정하는 것이지 용량을 늘리는 것이 아닙니다.
API 키로 인증하는 Runtime이라면 해당 키를 에이전트의 환경 변수로 설정하세요. Sharkly는 에이전트 프로세스가 시작될 때 에이전트 환경 변수를 주입합니다. 에이전트 그룹마다 자체 OpenAI 프로젝트의 키를 할당하면 트래픽이 올바른 한도에 반영됩니다.
작업당 토큰 수 모니터링하기
Sharkly의 에이전트 헤더에는 할당된 작업, 총 실행 횟수, 사용된 토큰이 표시됩니다. 월간 총량뿐 아니라 작업당 토큰 수를 확인하세요. 다른 작업의 3배 토큰을 태우는 작업 유형이 있다면, Astra 대신 Sol로 전환하거나 작업 설명을 더 구체적으로 다듬을 첫 번째 후보입니다.
대량 작업은 한산한 시간대로 옮기기
각 에이전트의 Runtime 설정에는 작업을 한산한 시간대에 예약할 수 있는 Working hours 스위치가 있습니다. 여기에 테스트 생성, 의존성 업데이트, 문서 작업을 지정하세요. 이런 작업들은 밤새 실행되고, 낮의 용량은 사람들이 기다리는 작업에 남겨둘 수 있습니다.
GPT-6.2 429 오류 처리 방법
상한을 설정해도 가끔 429를 만나게 됩니다. OpenAI의 가이드는 대응 방법을 구체적으로 안내합니다:
Retry-After헤더가 있으면 따르되, 최소값으로 취급합니다.- 헤더가 없으면 무작위 지터를 넣은 지수 백오프를 사용합니다.
x-ratelimit-remaining-tokens과x-ratelimit-reset-tokens를 읽어 얼마나 한도에 근접했는지 파악합니다.- 재시도를 중첩하지 마세요: 코드에서 재시도한다면 SDK의 자체 재시도를 끄세요. 그렇지 않으면 두 재시도가 곱해집니다.
- 할당량이나 결제 오류는 재시도하지 마세요. 사람의 개입이 필요합니다.
server_is_overloaded와 함께 오는 503은 여러분이 아니라 모델이 바쁘다는 뜻입니다. 같은 백오프 방식으로 처리하면 됩니다.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra와 Sol: 어떤 모델이 한도를 더 효율적으로 쓸까
속도 제한이 동일하므로 선택 기준은 토큰 사용량과 가격입니다. Astra는 아키텍처 변경, 어려운 버그, 긴 자율 실행에 사용하고, Sol은 일상적인 모든 작업에 사용하세요. Plus의 Codex에서 Sol은 Astra보다 5시간 창당 약 3배 많은 메시지를 사용할 수 있는데, 이것이 비용 격차를 가장 명확하게 보여주는 지표입니다.
일반적인 해법은 혼합 팀입니다. Astra 에이전트 하나가 이끌고 여러 Sol 에이전트가 세부 작업을 맡는 방식으로, GPT-6 Astra를 Crew 리더로 쓰기가 그 예입니다. 일상 작업은 더 저렴한 모델에 맡겨야 하며, 이것이 지루한 80%를 위한 GPT-6 Luna의 핵심 논리입니다.
GPT-6.2 처리량을 늘리는 다른 방법들
- Batch API. 동기식 속도 제한 밖에서 실행되며 표준 요금의 50%로 이용할 수 있습니다. 평가(evals)와 대량 분류에는 좋지만 대화형 에이전트에는 부적합합니다.
2h또는8h창의 백그라운드 모드. 실시간 TPM 대신 별도의 Batch/Background 대기열 한도에 포함됩니다.- 프롬프트 캐싱. 캐시된 입력은 Astra에서 백만 토큰당 $0.40, Sol에서 $0.10로, 같은 컨텍스트를 반복 전송하는 에이전트에 큰 절약이 됩니다.
결론
GPT-6.2의 속도 제한은 요청 기준으로는 넉넉하지만 토큰 기준으로는 빠듯합니다. 에이전트 팀의 경우 실질적인 한도는 티어의 TPM을 에이전트 하나의 소비량으로 나눈 값이며, 이를 프로젝트의 모든 에이전트가 공유합니다. 실행 하나를 측정하고, 동시 실행 수를 그 수치 이하로 제한하고, 시끄러운 에이전트 그룹은 별도 프로젝트로 분리한 뒤, 나머지는 대기열이 흡수하도록 하세요.
이것을 스크립트와 세마포어로 직접 구현할 수도 있고, Sharkly에서 에이전트별로 설정할 수도 있습니다. Computer 하나를 연결하고, Codex에서 GPT-6.2 Sol로 에이전트를 하나 만들고, 최대 동시 실행 수를 2로 설정한 뒤, 지루한 작업 하나를 할당해 보세요. 여러 에이전트를 나란히 실행하는 방법에 대한 자세한 내용은 AI 코딩 에이전트 10개 동시에 실행하기를 참고하세요.
FAQ
GPT-6.2의 속도 제한은 얼마인가요?
API에서 GPT-6.2 Astra와 Sol은 동일한 한도를 공유합니다: Build에서 RPM 5,000회와 TPM 1,000,000개, Launch에서 RPM 10,000회와 TPM 4,000,000개, Grow에서 RPM 15,000회와 TPM 40,000,000개입니다.
GPT-6.2 Astra가 Sol보다 속도 제한이 낮나요?
아니요. OpenAI는 모든 티어에서 두 모델에 동일한 RPM과 TPM을 표시합니다. Astra는 토큰당 비용이 더 높아 속도 제한이 아니라 예산을 더 빨리 소진합니다.
더 높은 OpenAI 사용 티어로 올라가려면 어떻게 하나요?
티어는 총 크레딧 구매액에 따라 자동으로 승급됩니다: Build는 $5, Launch는 $100, Grow는 $500입니다.
속도 제한은 API 키 단위인가요, 조직 단위인가요?
조직 및 프로젝트 단위입니다. 한 프로젝트의 모든 키가 같은 풀을 공유하므로, 한 프로젝트에서 열 개의 키로 돌아가는 열 개의 에이전트도 하나의 한도를 공유합니다.
Codex에서 GPT-6.2 Astra 메시지는 몇 개까지 쓸 수 있나요?
Plus와 Standard Business에서 OpenAI는 GPT-6.2 Astra의 경우 5시간 창당 로컬 메시지 6~50개, Sol의 경우 17~180개로 추정합니다. Pro 플랜은 현재 5시간 제한이 없지만, 주간 한도는 적용될 수 있습니다.
RPM은 문제없어 보이는데 에이전트가 429 오류에 걸리는 이유는 무엇인가요?
에이전트는 방대한 컨텍스트를 전송하므로, 분당 요청 수가 다하기 훨씬 전에 분당 토큰 수가 소진됩니다. 응답 헤더의 x-ratelimit-remaining-tokens를 확인하세요.
Sharkly가 자체 모델 한도를 추가하나요?
아니요. Sharkly는 이미 사용 중인 코딩 에이전트를 실행할 뿐이며, 모델 할당량은 팀이 연결한 도구, 플랜, API 계정에 따라 달라집니다. Sharkly는 각 에이전트가 한 번에 실행하는 작업 수를 제어합니다.