
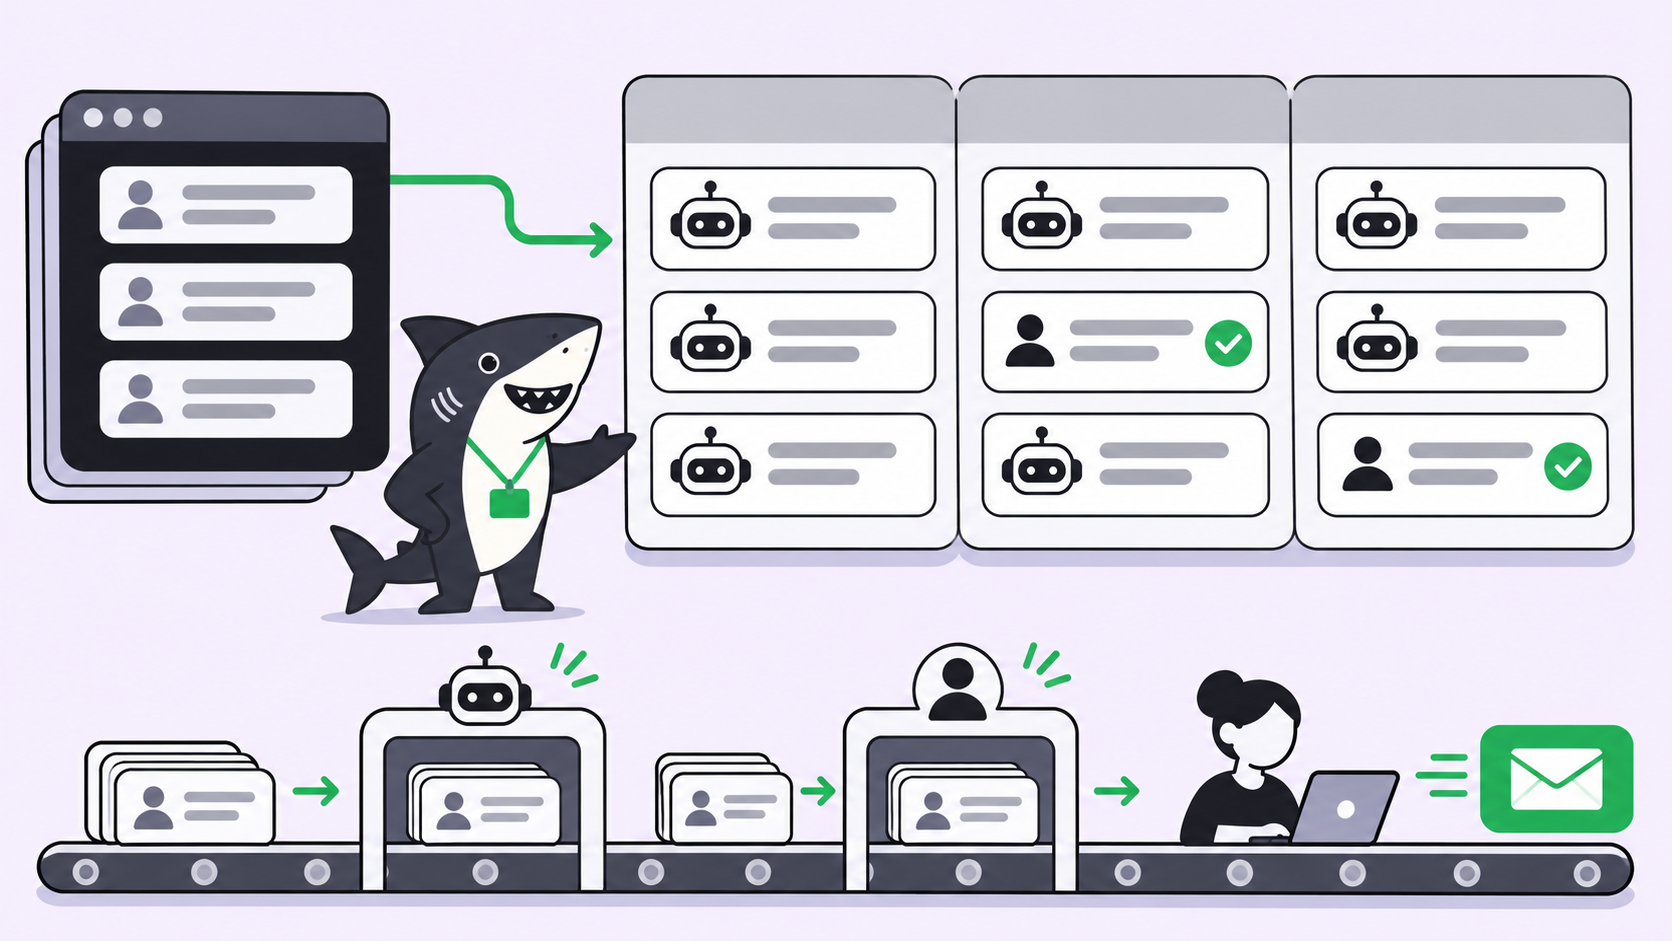
요약(TL;DR): 작업을 단계별 보드 태스크(ICP 필터, 규칙 파일, 자격 검증(qualification), 인물 검색, 이메일 탐색 및 검증, 시그널 파악, 아웃리치)로 분할하면 Claude Code에서 GTM을 체계적으로 운영할 수 있습니다. 각 데이터 태스크는 Treg을 데이터 레이어로 활용하여 에이전트가 실행합니다. 규칙 파일은 담당자가 직접 관리하며, 실제로 발송되기 전 모든 첫 문장(first line)을 승인합니다.
Claude Code에서 GTM을 운영한다고 하면 “괜찮은 타깃 기업 50곳을 찾아서 구매 담당자에게 보낼 이메일을 작성해 줘” 같은 하나의 긴 프롬프트를 떠올리기 쉽습니다. 데모용으로는 잘 작동할지 몰라도, 탐색 도구의 용량이 소진되거나 누가 이메일을 승인했는지 아무도 책임지지 못하는 순간 바로 문제가 발생합니다.
Treg의 GTM 엔지니어링 플레이북은 데이터 영역에 해당하는 절반을 다룹니다. ICP 설정부터 실제 롤아웃까지 16개 챕터로 구성되어 있으며, 6회의 기록된 실행, 502건의 로깅된 호출, 5.03달러의 사용량 기반 비용 데이터를 기반으로 작성되었습니다. 본문의 모든 수치는 Treg 자체 기록 결과이며 아직 독립적으로 재현 검증된 것은 아니므로, 실제 보유한 데이터에 직접 테스트해 보시기 바랍니다.
나머지 절반은 조율과 협업(coordination)입니다. 프로세스를 중단할 수 있는 담당자 지정, 아웃리치 담당 인력 배정, 단계별 데이터 행 수(row count) 추적 등이 이에 해당합니다. 단일 세션 하나로는 이러한 과정을 모두 감당할 수 없습니다. 이 글에서는 플레이북의 내용을 Sharkly의 태스크로 구성하여, Claude Code나 Codex를 기반으로 에이전트가 각 단계를 실행하고 플레이북이 지정한 두 번의 관문(게이트)에 사람이 개입하도록 설계하는 방법을 소개합니다.
Claude Code 기반 GTM에 단일 세션이 아닌 보드가 필요한 이유
에이전트 세션을 길게 하나로 운영하면, GTM 업무에서 결코 용납될 수 없는 세 가지 치명적인 문제가 가려집니다.
- 점검 지점 없는 비용 지출: 애초에 제외했어야 할 데이터 행에 유료 인리치먼트(enrichment) 비용을 낭비하게 됩니다.
- 알 수 없는 오류 발생(Silent breakage): Treg은 자체 실행 과정에서 중단 없이 발생했던 오류들을 나열합니다. 탐색 도구 용량 초과, 바잉 그룹(buying-group) 엔드포인트 용량 초과, 레이트 리밋(요청 제한)이 걸린 계정 3개, 그리고 1.08달러의 재실행 비용을 발생시킨 파서 버그 등이 있었습니다.
- 발송 책임자의 부재: 이 플레이북의 아웃리치 규칙은 명확합니다. “사람이 직접 읽지 않은 메시지는 절대 발송하지 않는다.”
이러한 문제는 모두 팀 차원의 과제이며, 명확한 담당자 지정, 진행 상태 관리, 단계별 실행 기록을 통해 해결할 수 있습니다. 이는 에이전트 작업에 대한 인간의 오너십 모델을 리드 목록 구축에 그대로 적용한 방식입니다.
스택 구성: 각 요소가 실행되는 위치
스택은 각각 명확한 역할을 가진 세 개의 계층으로 나뉩니다.
| 계층 | 도구 | 역할 |
|---|---|---|
| 실행 (Execution) | Claude Code or Codex | 프롬프트 실행, 규칙 파일 읽기, CSV 파일 작성 |
| 데이터 (Data) | Treg | 기업 및 인물 검색, 데이터 인리치먼트, 이메일 탐색 및 검증, 채용 및 투자 유치 시그널 파악 (호출당 종량제 과금) |
| 조율 및 협업 (Coordination) | Sharkly | 단계별 1개 태스크 구성, 태스크별 담당자 지정, 검토 상태 관리, 실행 기록 보관 |
에이전트가 실행되는 컴퓨터 환경에 Treg을 한 번만 설정해 두면 됩니다. Treg 설정 파일에 안내된 설치 방법은 다음과 같습니다.
# install the CLI and the treg skill for every agent it detects
curl -fsSL https://treg.to/install.sh | sh

# browser sign-in (GitHub, Google, or an emailed code)
treg login

# headless Computer: pass a token instead of a browser
curl -fsSL https://treg.to/install.sh | sh -s -- --token "$TREG_TOKEN"
또는 에이전트에 set up treg - https://treg.to/llms.txt 한 줄을 입력해도 됩니다. Treg의 설명에 따르면 신규 인증 계정에는 1.00달러의 무료 크레딧이 1회 제공되며, API 호출은 공급업체 원가 그대로 마크업 없이(0% 마크업) 청구되고, 결과를 찾지 못한 경우(misses)에는 0.00달러가 청구됩니다.
보드 태스크로 구성하는 GTM 파이프라인
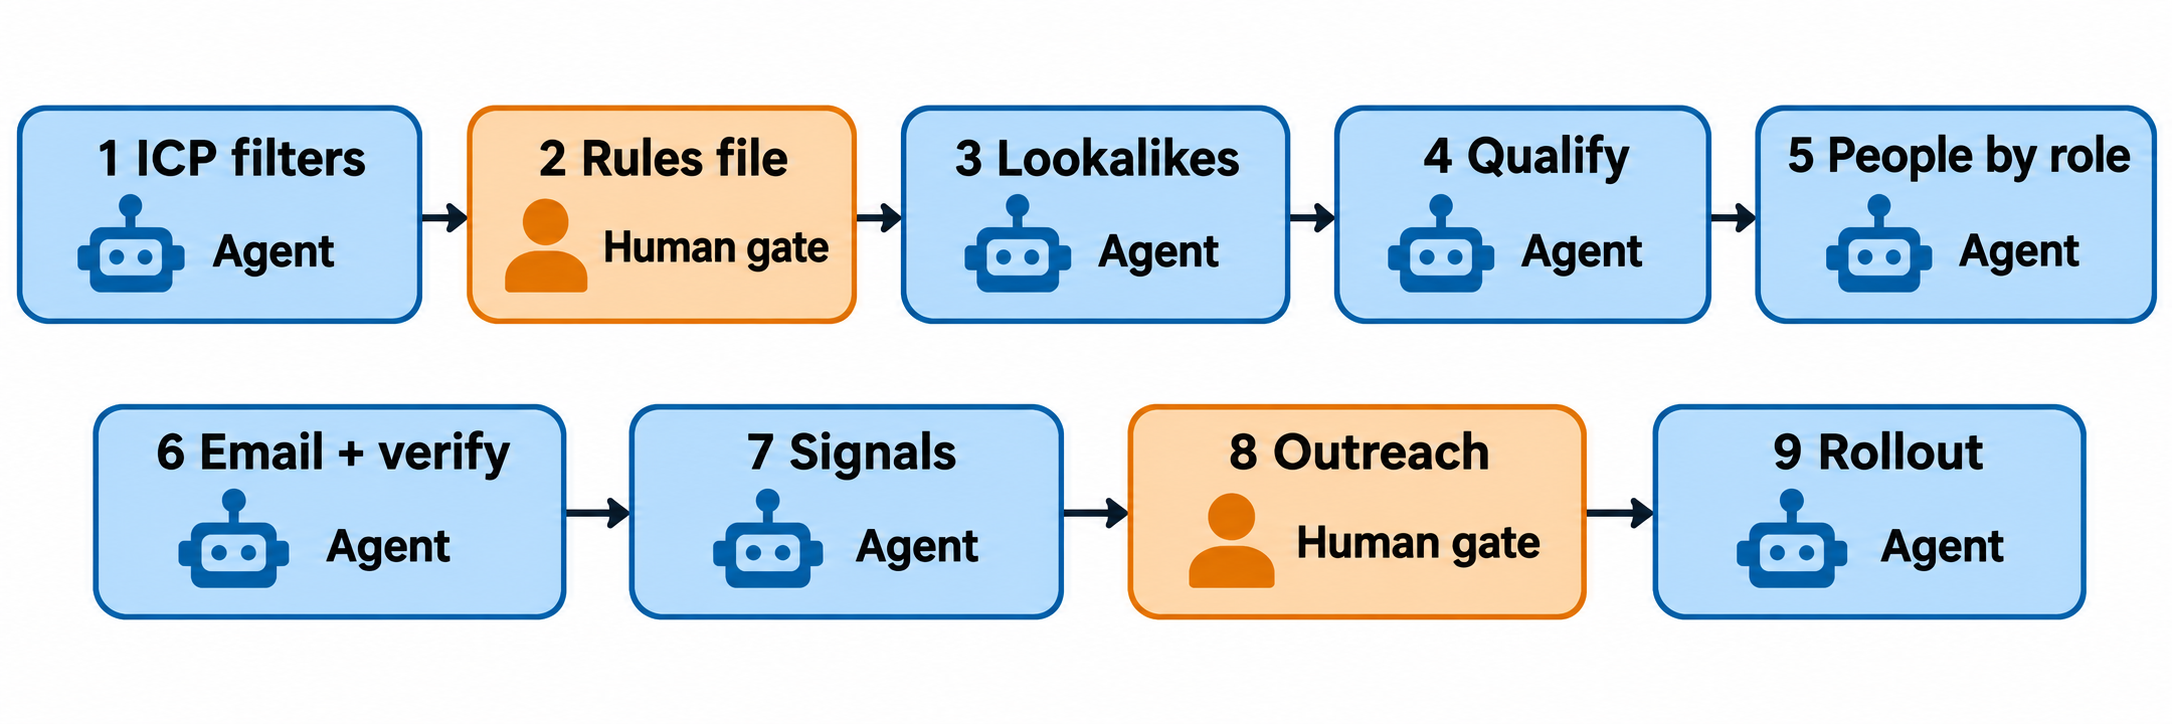
플레이북을 태스크 형태로 매핑한 구조는 다음과 같습니다. 세 번째 열은 해당 단계에 대해 Treg이 실제로 기록한 실행 결과입니다.
| 태스크 (플레이북 챕터) | 담당자 | Treg 기록 실행 결과 |
|---|---|---|
| ICP를 필터로 변환 + 무료 카운트 확인 (1~2) | 에이전트 | CompanyEnrich, B2B+SaaS, 임직원 수 51~200명, 미국: 10,403건; 2024년 이후 투자 유치: 1,357건 |
| 규칙 파일 (3) | 사람 | 인간 승인 관문: 기준값(임계치), 제외 조건, 지출 한도, 실행 중단 권한자 |
| 유사 기업(Lookalike) 발굴 (4) | 에이전트 | 0.006달러로 71개 후보 확보; 71개 중 8개가 50% ICP 적합도 검사 통과 |
| 비용 지출 전 자격 검증 (5) | 에이전트 | 50개 기업: 27개 통과, 21개 제외; 총 2.33달러, 발송 가능한 리드당 0.12달러 |
| 직무별 인물 검색 (6) | 에이전트 | 8개 기업의 “marketing” 담당자: 20명 확보, 0.00달러 (상세 연락처 조회가 유료 단계임) |
| 이메일 워터폴 탐색 + 검증 (7~8) | 에이전트 | 60명: 발송 가능(deliverable) 32명, 위험(risky) 16명, 불명(unknown) 4명, 유효하지 않음(invalid) 8명, 0.65달러 |
| 시그널 파악 (9~10) | 에이전트 | 27개 기업: 최근 60일 내 GTM 채용 공고가 있는 기업 16곳, 1.35달러 |
| 아웃리치 (11~12) | 에이전트 초안 작성, 사람 승인 | 뉴스 기반 첫 문장 19건 중 ‘양호(decent)’ 이상 평가는 4건에 불과 |
| 태깅, 지표 분석, 롤아웃 (14~16) | 에이전트 + 사람 | 단계별 데이터 행 수 추적, 원본 응답 저장, 실행당 지출 한도 설정 |
에이전트가 필터링할 수 있는 ICP는 어떻게 작성해야 할까요?
ICP를 ‘필터(filters)’와 ‘검사(checks)’로 분리하십시오. 필터는 데이터 제공업체가 검색할 수 있는 필드(국가, 임직원 수, 카테고리, 투자 유치 내역 등)입니다. 반면 검사는 각 데이터 행에 대한 정성적 판단이며, 유료 결제 단계로 넘어가기 전에 반드시 먼저 수행해야 합니다.
태스크 설명에는 Treg의 프롬프트를 다음과 같이 넣을 수 있습니다: “treg을 사용하여 icp.md의 ICP를 두 기업 검색 제공업체의 필터로 변환할 것. 무료 카운트 엔드포인트만 사용할 것.” 완료 기준(acceptance criteria) 역시 플레이북의 규칙을 따릅니다: 두 제공업체의 무료 카운트 결과가 대략 일치하고, 샘플 10개 행을 검토했을 때 적합하다고 판단되기 전까지는 유료 리스트를 구매하지 않습니다.
규칙 파일에 인간 담당자가 필요한 이유는 무엇일까요?
기준값(임계치)에 따라 리스트의 결과가 크게 달라지기 때문입니다. Treg의 실행 결과에 따르면, ICP 적합도 50% 기준에서는 48개 기업 중 27개가 통과했지만, 60% 기준을 적용했다면 14개만 통과했을 것입니다. 이는 비즈니스적 판단이 필요한 영역이므로, 규칙 파일을 작성하는 태스크의 오너십은 반드시 사람이 가져야 합니다.
모든 단계에서 참조할 수 있는 위치에 규칙을 배치하십시오. Sharkly 스킬(Skill)은 에이전트 작업을 위한 재사용 가능한 지침을 패키징하므로, 9개의 프롬프트마다 일일이 문단을 복사해 붙여넣을 필요 없이 모든 GTM 에이전트에 바인딩된 하나의 단일 스킬로 규칙 파일을 관리할 수 있습니다.
# gtm-rules.md (owner: the person who can stop the run)
icp_threshold: 0.50
max_spend_per_run_usd: 3.00
drop_if: [no_usable_domain, headcount_outside_51_200]
send_only: verifier_verdict == "deliverable"
stop_owner: "growth lead"
every_stage_reports: [rows_in, rows_out, metered_cost]
3~7단계: 비용을 지불하기 전에 먼저 자격을 검증하라
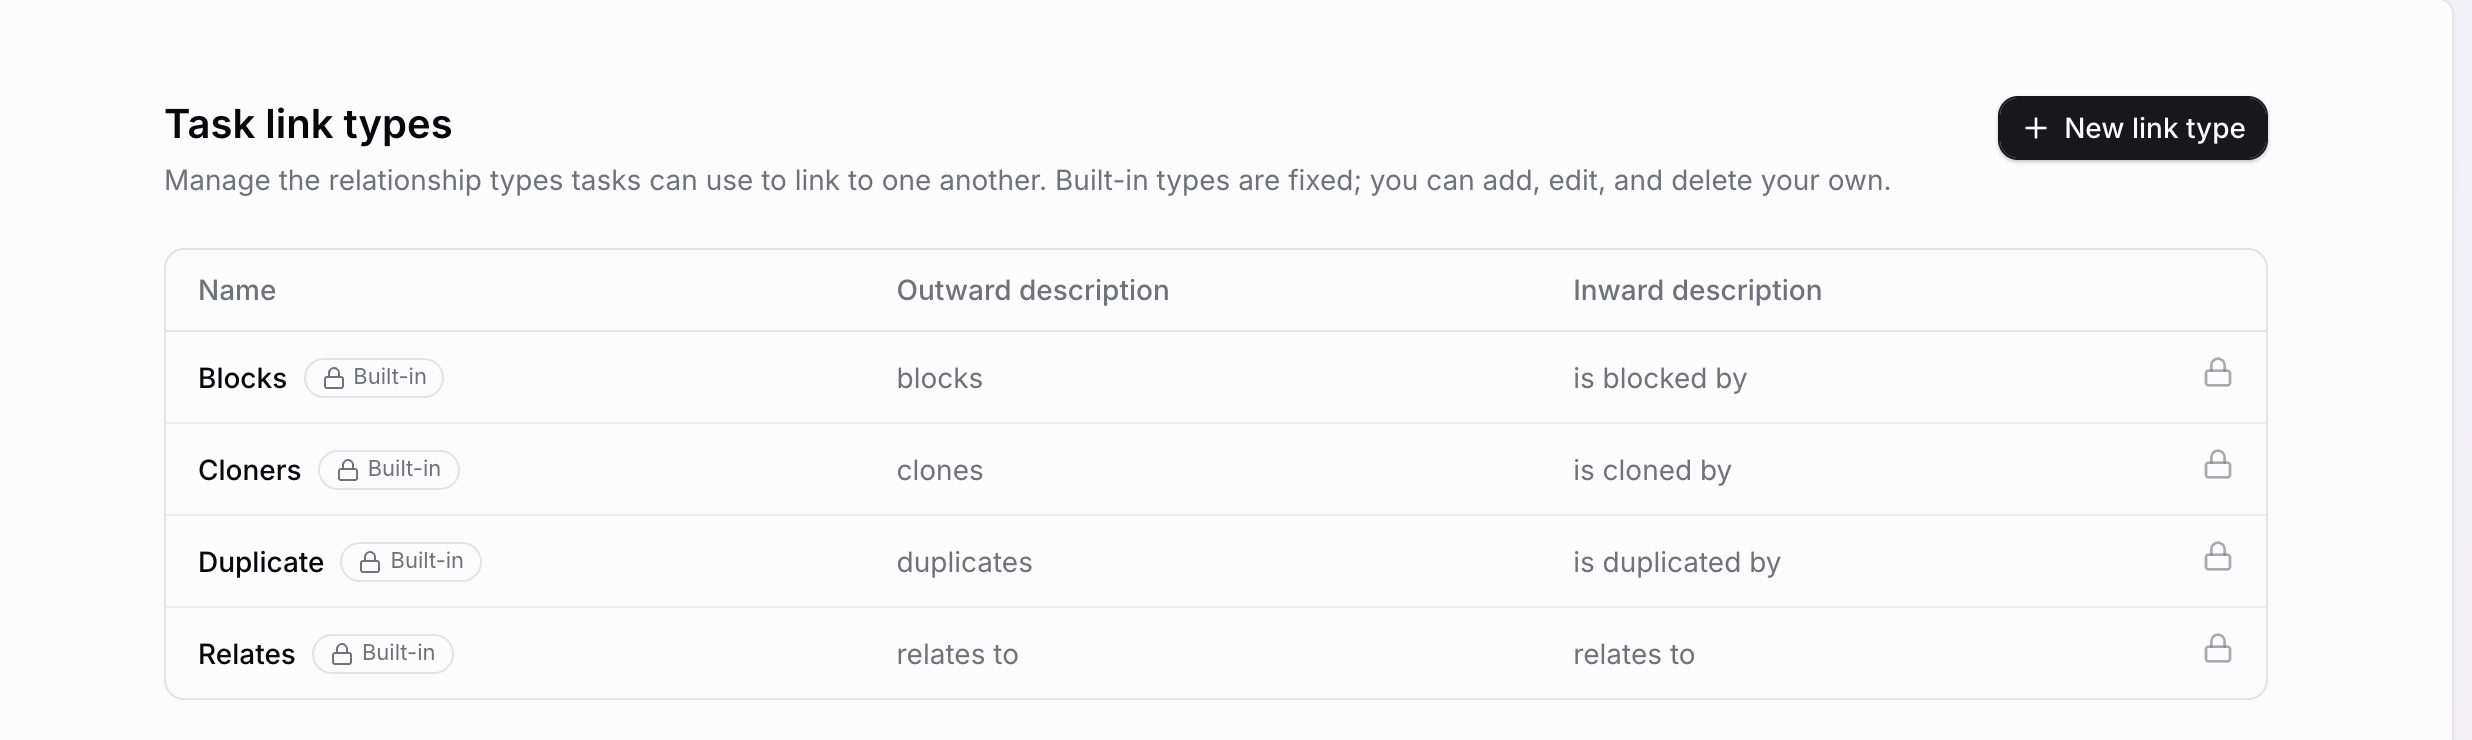
이 단계들은 저비용 작업을 먼저 수행하는 데이터 태스크들입니다. 인물 검색이 시작되기 전에 자격 검증이 완전히 끝날 수 있도록 이 작업들을 차단함 / 다음에 의해 차단됨(blocks / is blocked by) 관계로 연결하십시오. 실행 순서는 비용 절감에 결정적인 영향을 미칩니다. Treg은 50개 기업의 자격을 검증하는 데 2.33달러를 사용했으며, 유효한 도메인을 가진 48개 기업 전체에 인리치먼트를 진행했을 경우의 예상 비용은 4.12달러였습니다.
플레이북의 두 가지 규칙이 완료 기준이 됩니다. 첫째, 유사 기업(Lookalike)도 일반 데이터 행과 동일한 기업 규모 필터 및 ICP 검사를 통과해야 합니다. 둘째, 검증을 통해 발송 가능(deliverable) 판정을 받은 주소만 시퀀스(발송 대상)에 포함됩니다. Treg의 60명 대상 조사에서 탐색 도구는 60개의 주소를 찾아냈지만, 검증 도구를 통과한 것은 32개에 불과했습니다.
각 데이터 태스크는 에이전트의 댓글(투입된 행 수, 산출된 행 수, Treg의 종량제 비용)로 마무리됩니다. 이 정보는 실행 기록과 함께 해당 단계의 '영수증' 역할을 합니다.
발송 버튼 권한을 어떻게 사람이 유지하도록 할까요?
아웃리치 태스크에서는 에이전트가 리서치와 초안 작성까지만 수행하고 작업을 멈춥니다. Treg의 실행 결과에서도 뉴스 기반의 첫 문장 19개 중 ‘양호’ 이상으로 평가된 것은 4개에 불과했습니다. 따라서 에이전트는 태스크를 사람의 검토 대기 중(waiting for human review) 상태로 두고, 검토자가 이를 승인하거나 수정, 재작성합니다. 이 패턴은 인간 참여형(Human-in-the-loop) 코딩 에이전트에서 다룬 바 있으며, 이메일 아웃리치 작업에도 그대로 적용됩니다.
Sharkly가 플레이북의 규칙을 엄격하게 유지하는 방식
- 단계별 1개 태스크: 각 단계에 진행 상태, 담당자(Assignee: 에이전트, 크루 또는 사람), 완료 기준을 부여합니다.
- 검토 상태(Review states): 사람의 주의가 필요한 곳으로 집중시킵니다. 에이전트는 태스크를 사람의 답변 대기 또는 검토 대기 상태로 둘 수 있으며, 이러한 알림은 담당자의 인박스(Inbox)로 전달됩니다.
- 실행 기록(The run record): 실행 시작 및 종료 시점, 도구 호출 내역, 런타임 이벤트, 실패 상세 정보를 보여주며, 이는 롤아웃 챕터에서 요구하는 감사 추적(audit trail) 역할을 합니다.
- 상위 태스크(Parent tasks): 최종 결과물을 관리합니다. “Q4 마케팅 바이어 리스트”가 상위 태스크가 되고, 9개 단계가 하위 태스크가 됩니다.
9개의 태스크를 직접 일일이 나누기 번거롭다면, Sharkly 크루(Crews)에 설명된 것처럼 크루 리더(Crew leader)가 상위 태스크를 쪼개어 각 단계를 위임하도록 할 수 있습니다. Sharkly는 무료로 시작할 수 있으며, 모델 사용량은 런타임에 이미 연결된 Claude Code 또는 Codex 플랜을 통해 차감됩니다.
시그널: 출처 링크가 없다면 시그널이 아니다
시그널 태스크에는 가장 엄격한 완료 기준이 필요합니다. Treg은 최근 60일 내 GTM 채용 공고가 있는 기업 27곳 중 16곳을 찾아냈지만, 반환된 공고 675건 중 355건은 이미 마감된 상태였습니다.
이직(직무 변경) 데이터는 더 심각합니다. 새로운 직책을 발표한 148명을 대상으로 한 Treg의 조사에 따르면, 연락처 데이터베이스는 평균 68%의 확률로 새로운 직장을 감지하지 못했습니다. 실시간 프로필 확인 방식은 148명 중 49명만 찾아냈지만, 그중 47명이 정확했습니다. 따라서 플레이북의 원칙을 그대로 지켜야 합니다: 검증 가능한 출처 링크가 없다면 아웃리치도 진행하지 마십시오.
투자 유치 전 채용 추이에 대한 Treg의 테스트에서는 유의미한 집단 간 차이가 나타나지 않았으므로, 타이밍 관련 시그널에 가중치를 부여하기 전에 보유한 성공 및 실패 사례 데이터를 바탕으로 먼저 확인해 보시기 바랍니다.
Treg의 수치가 보여주는 것과 보여주지 않는 것
Treg은 인물 검색 페이지에서 면밀히 살펴볼 만한 두 가지 비교 결과를 공개하고 있습니다.
- 정확한 이메일당 비용: 2026년 10월 100개 리드를 대상으로 한 테스트에서 Clay는 84개의 정확한 업무용 이메일을 찾는 데 3.77달러가 든 반면, Treg은 92개를 찾아내며 100건당 0.58달러의 비용을 기록했다고 밝혔습니다.
- 에이전트 정확도: LessieAI의 119개 태스크로 구성된 People Search Bench의 B2B 잠재고객 발굴(prospecting) 작업에서, Claude Code 단독 사용 시에는 정확도가 43%였던 반면 Treg을 함께 사용한 Claude Code는 78.2%를 기록했으며 작업 완료 시간도 2.8분에서 1.4분으로 단축되었다고 보고했습니다.
이는 공급업체(vendor)가 당일 정가 기준으로 자체 측정한 결과이며, Treg 스스로도 몇 개 행 수준의 근소한 차이는 무승부나 다름없다고 언급하고 있습니다. 이 수치는 여러분의 데이터 50개 행에 무엇을 직접 테스트해 볼지 판단하는 참고 자료로 활용하십시오.
소프트웨어처럼 단계적으로 롤아웃하기
마지막 챕터의 핵심 규칙은 다음과 같습니다. 그림자 모드(shadow mode)로 실행해 보기 전에는 어떤 것도 완전 자동화하지 마십시오. 보드에서는 이를 세 단계로 나누어 진행합니다.
- 그림자 실행(Shadow): 에이전트가 모든 데이터 태스크를 실행하지만, 아웃리치 태스크는 검토 상태를 유지하며 어떤 메시지도 발송되지 않습니다.
- 소규모 세그먼트(Small segment): 1개 티어, 1주일 단위로 진행합니다. 규칙 파일에 명시된 기준과 대조하며 데이터 행 수와 발송 가능한 리드당 비용을 면밀히 모니터링합니다.
- 데이터는 자율화하되 발송은 절대 자동화 금지(Autonomy for data, never for sending): 자동화(Automation) 설정을 통해 데이터 태스크는 정해진 일정에 따라 자동 실행되지만, 최종 발송은 반드시 인간의 결정으로 남겨둡니다.
여러 실행을 동시에 모니터링하는 방법은 병렬로 실행되는 코딩 에이전트를 모니터링하는 방법을 참고하십시오.
한 단계부터 시작하기
Claude Code 기반의 GTM은 각 단계가 작게 쪼개져 있고, 비용이 산정되어 있으며, 명확한 담당자가 지정되어 있을 때 성공적으로 작동합니다. 또한 보드를 통해 실행을 중단할 수 있는 사람과 발송을 승인할 사람이 분명히 드러나 있어야 합니다. 작게 시작해 보십시오. Sharkly에서 ICP 태스크와 규칙 파일 태스크를 생성하고, 무료 카운트를 실행해 본 다음 유료 단계를 진행하시기 바랍니다.
자주 묻는 질문(FAQ)
GTM 엔지니어링이란 무엇인가요?
Treg의 플레이북에서는 이를 Go-To-Market 전략을 반복 가능한 워크플로(타깃 기업 설정, 리드 인리치먼트, 스코어링, 시그널 모니터링, 리서치, 인바운드 라우팅)로 구현하는 시스템을 설계, 구축, 유지관리하는 것으로 정의합니다. 이때 아웃바운드 메시지가 발송되기 전에는 반드시 사람이 검토하는 과정이 포함됩니다.
Treg의 리드당 비용은 얼마인가요?
Treg이 2026년 9월 23일에 직접 실행한 기록에 따르면, 적격 리드는 발송 가능한 리드당 0.12달러, 전체 리스트 기준 2.33달러였습니다. 호출당 사용량에 따라 종량제로 청구되며, 결과를 찾지 못한 경우(misses)에는 0.00달러가 청구됩니다.
AI 에이전트가 검토 없이 콜드 이메일을 발송해도 될까요?
아닙니다. Treg의 플레이북에서는 사람이 직접 읽어보지 않은 내용은 절대 발송하지 않아야 한다고 강조하며, 실제 에이전트가 조사하여 작성한 첫 문장 19개 중 ‘양호’ 이상의 평가를 받은 것은 4개에 불과했습니다.
GTM 에이전트의 규칙은 어디에 정의해야 하나요?
수치화된 기준값(임계치), 명시적인 제외 조건, 지출 한도, 그리고 실행 중단 권한을 가진 단 한 명의 담당자가 명시된 규칙 파일에 정의합니다. Sharkly에서는 이를 스킬(Skill) 형태로 패키징하여 모든 에이전트가 동일한 규칙을 참조하도록 할 수 있습니다.
Claude Code 대신 Codex를 사용해도 작동하나요?
네, 가능합니다. Treg의 설정은 Claude Code, Codex, Cursor를 모두 지원하며, Sharkly 에이전트는 동일한 보드에서 두 런타임(Runtime) 중 어느 것으로든 실행될 수 있습니다. 전반적인 설정 방법은 AI 태스크 관리자: 에이전트 작업 할당, 추적 및 검토를 참고하십시오.