
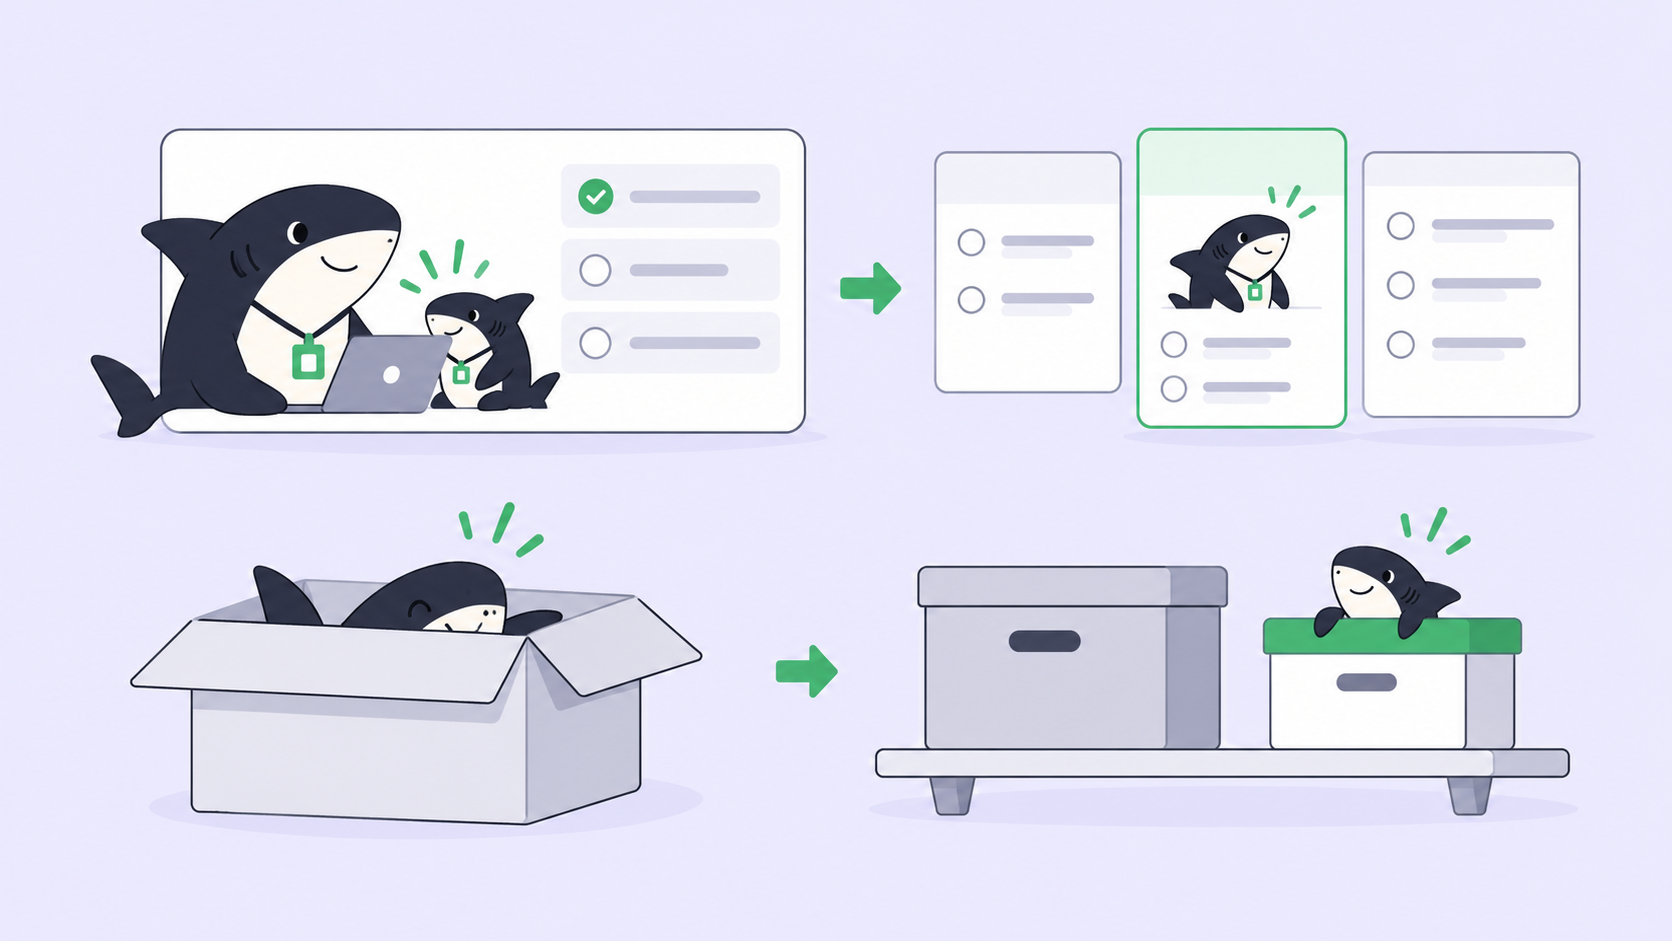
Anthropic은 10월 7일 Claude Haiku 5.5를 출시하며 그 역할을 한 줄로 명시했습니다. 바로 “코딩 작업에서 Opus 5.5 및 Sonnet 5.5의 서브에이전트로 훌륭하게 호환된다”는 점입니다. 출시 게시물에 따르면 요금은 10만 토큰 이하 프롬프트 기준 입력 백만 토큰당 0.10달러, 출력 백만 토큰당 0.50달러이며, 10만 토큰을 초과하면 각각 0.50달러와 2.50달러입니다. 해당 페이지에 소개된 6개의 고객사 인용구 중 2개도 동일한 활용 구조를 보여줍니다. Rogo는 상위 모델이 프레젠테이션 자료를 만드는 동안 Haiku 5.5 서브에이전트로 10-K 보고서에서 매출 항목을 추출하고, Cognition은 Devin Fusion에서 Opus 5.5를 보조하는 '사이드킥'으로 Haiku 5.5를 실행합니다.
하지만 이러한 접근은 모델 관점의 이야기입니다. 여러 에이전트를 운영하는 팀에 더 까다로운 질문은 '관리 보드' 관점에 있습니다. 서브에이전트는 다른 에이전트의 실행 세션 내부에서 동작합니다. 자체 Task나 Assignee(담당자), 고유한 상태가 없기 때문에 무언가 잘못 처리되었을 때 그 실수는 고스란히 리드 에이전트의 이름을 달고 나타납니다. 이제 저비용 작업은 얼마든지 대량으로 처리할 수 있을 만큼 저렴해졌으며, 정작 중요한 결정은 그 작업을 어디에서 보이게 할 것인가입니다.
핵심 요약 (TL;DR)
출력물을 리드 에이전트가 소비하고 그 자리에서 검증하는 작업(조회, 요약, 코드베이스 탐색, 압축 등)이라면 Haiku 5.5를 세션 내 서브에이전트로 유지하세요. 반면 작업 결과물이 배포되거나, 누군가 승인해야 하거나, 독립적으로 실패할 가능성이 있는 작업이라면 독립된 Agent와 자체 Task를 부여해야 합니다. Claude Code에서는 서브에이전트 파일에 haiku 별칭 대신 model: claude-haiku-5-5 전체 ID를 고정하고, 기본 내장된 Explore 서브에이전트는 Haiku가 아닌 메인 대화 세션의 모델로 실행된다는 점을 기억하세요. Sharkly에서는 Custom arguments 설정으로 저비용 Agent를 지정할 수 있어 두 가지 방식 모두 하나의 Computer를 공유할 수 있습니다. 에이전트는 조사, 실행, 테스트 및 보고를 담당하고, 사람은 방향을 설정하고 권한을 부여하며 결과를 최종 승인합니다.
상위 관리 관점에서 서브에이전트는 보이지 않는다
서브에이전트는 리드 에이전트가 자체 세션 내에서 생성하여 좁은 범위의 작업을 맡기고 그 답변을 받아오는 보조자입니다. 이는 많은 작업에 적합한 설계이지만, 동시에 하나의 경계이기도 합니다. 서브에이전트가 수행하는 모든 일은 단일 실행 세션 내부에서만 일어납니다.
관리 보드 관점에서 보면, 두 가지 배치 방식은 관리자가 던지는 모든 질문에서 명확한 차이를 보입니다.
| 질문 | 세션 내 서브에이전트로 Haiku 5.5 사용 | Task를 가진 독립 Agent로 Haiku 5.5 사용 |
|---|---|---|
| 결과의 책임은 누구에게 있는가? | 암묵적으로 리드 에이전트 | 명시적으로 해당 Task의 담당자(Assignee) |
| 작업 내역이 어디에 표시되는가? | 리드 에이전트의 실행 세션 및 최종 응답 내부 | 자체 Task, 실행 상태 및 실행 로그 |
| 누가 검토하는가? | 다음 단계로 넘어가기 전 리드 모델이 검토 | 최종 승인 전 사람 또는 검토자가 검토 |
| 실패 시 어떻게 되는가? | 리드 에이전트가 자체 흡수하거나 그대로 진행 | Task에서 실패 상태를 독립적으로 표시 |
| 실행 도중 사람이 개입하여 답변할 수 있는가? | 불가능 (리드 에이전트와만 상호작용) | 가능 (질문이 Task 및 수신함으로 전달됨) |
| 설정하는 데 필요한 것은? | 저장소 내 파일 하나 | 별도의 Agent 및 Task |
이 문제의 Codex 버전은 이미 본 블로그에서 다룬 바 있습니다. 세션이 여러 서브에이전트로 분기되면, 검토자가 보게 되는 것은 통합된 하나의 답변뿐이라는 점입니다. Anthropic이 Haiku 5.5를 정확히 그 위치에 맞추어 설계하고 가격을 책정했기 때문에 이러한 타협은 더욱 매력적으로 느껴집니다. Rogo의 방식이 잘 작동하는 이유는 리드 모델이 추출된 매출 항목을 활용해 슬라이드 자료를 만들고, 사람이 외부에 전달하기 전에 이 최종 산출물을 직접 검토하기 때문입니다. 서브에이전트의 오류가 있더라도 이 검토 과정에서 드러나게 됩니다.
하지만 동일한 모델을 출력물 자체가 최종 산출물이 되는 작업(마이그레이션, 설정 변경, 데이터 수정, 고객 응대 등)에 투입해 보십시오. 서브에이전트로 실행하면 해당 작업은 리드 에이전트의 요약 중 일부로만 관리 보드에 올라옵니다. 변경 사항(diff) 중 어느 부분이 저비용 모델에 의해 생성되었는지 아무도 알 수 없으며, Task를 승인하는 사람은 출처를 명확히 확인할 수 없는 작업물을 승인하게 됩니다.
역할 배치의 명확한 기준
Luna 관련 글에서는 어떤 작업이 저비용 티어에 적합한지에 대한 답을 제시했습니다. 바로 난이도가 아니라 '검증 용이성'에 따라 라우팅해야 한다는 점이었습니다. Haiku 5.5는 여기에 두 번째 기준 축을 더합니다. 작업 비용이 충분히 저렴해졌다면, 이제는 '출력물을 누가 소비하는가'에 따라 어디에 배치할지 결정해야 합니다.
Haiku 5.5 placement rule

In-run subagent when ALL of these hold:
  - the output is read by the lead agent, not shipped
  - the lead checks or uses it before continuing
  - a wrong answer shows up downstream, inside reviewed work
  examples: file lookups, codebase exploration, log and doc summaries,
            classification, pulling one fact from a long document

Own Agent and own Task when ANY of these hold:
  - the output ships (a diff, a message, a record, a submitted form)
  - a person has to accept it
  - it can fail, stall, or need a human answer independently
  - you want its acceptance rate measured separately from the lead's
작업이 리드 에이전트에게 필요한 하나의 답변으로 수렴된다면 서브에이전트를 사용하세요. 팀 차원에서 담당자 이름을 붙여 관리해야 하는 작업이라면 별도의 Task를 사용해야 합니다.
Sharkly에는 중간 형태의 옵션도 있습니다. Crew 기능에서는 리더 Agent가 특정 기여를 위해 팀원을 멘션하면, 해당 팀원들이 동일한 Task 내에서 실행되어 그 결과를 해당 채팅에 추가합니다. 이렇게 하면 Haiku 5.5 팀원은 자체 Task가 없어도 해당 Task상에서 명확히 확인됩니다. 통합된 결과를 한 사람이 승인하는 경우라면 이 방식을 사용하세요. 반면 서로 다른 사람이 각 부분을 검토해야 한다면 별도의 Task로 나누십시오.
두 가지 방식의 설정 방법
두 방식 모두 자칫 잘못 설정하기 쉬운 항목이 하나씩 있습니다.
Claude Code에서의 서브에이전트 방식. Haiku 5.5를 사용하려면 Claude Code v2.1.293 이상이 필요합니다. 서브에이전트 문서에 따르면 서브에이전트의 model 필드에는 sonnet, opus, haiku, fable, 전체 모델 ID, 또는 inherit을 지정할 수 있습니다. 이때 반드시 전체 ID를 고정하십시오.
---
name: lookup
description: Find files, symbols and config values. Read-only.
model: claude-haiku-5-5
---
Answer with paths and line numbers. Do not edit files.
별칭(alias)이 함정입니다. 모델 설정 문서에 따르면 haiku 별칭은 Anthropic API에서만 Haiku 5.5로 연결됩니다. Amazon Bedrock, Google Cloud, Microsoft Foundry 및 Claude Platform on AWS에서는 여전히 Haiku 4.5로 연결됩니다. 서로 다른 클라우드 제공업체의 Computer 간에 서브에이전트 파일을 공유할 경우, 동일한 이름 아래 두 개의 서로 다른 모델이 실행될 수 있습니다. 각 호스트에서 haiku가 가리키는 대상과 Claude Code가 백그라운드 기능에 사용하는 모델은 ANTHROPIC_DEFAULT_HAIKU_MODEL 환경 변수를 통해 설정됩니다.
또 다른 뜻밖의 사실은 기본 내장된 Explore 서브에이전트가 Haiku가 아닌 메인 대화 세션의 모델을 사용한다는 점입니다. 만약 리드가 Opus 5.5를 사용하고 있다면 코드 탐색 역시 Opus 5.5에서 실행됩니다. 공식 문서에서는 기본 설정을 덮어쓰도록 Explore라는 이름의 사용자 또는 프로젝트 서브에이전트를 생성하고 model: haiku를 지정하여 저비용 모델로 탐색을 실행할 것을 권장합니다. 앞서 소개한 파일의 이름을 이와 같이 지정하되, 전체 모델 ID를 유지하십시오.
Sharkly에서의 Agent 방식. Sharkly 자체는 모델을 직접 선택하지 않습니다. Agents 문서에는 다음과 같이 명시되어 있습니다. “Agent는 Runtime의 기본 모델을 따릅니다. 특정 모델명을 보장하거나 표시하지 않습니다. 모델을 변경하려면 Agent 또는 Runtime의 Custom arguments에 모델을 지정하십시오.” Agent 설정에는 모델 드롭다운이나 thinking depth(추론 깊이) 조절 기능이 없습니다. 따라서 저비용 Agent를 구성하려면 리드 Agent가 기본값을 유지하는 동안 동일한 Computer 및 동일한 Claude Code Runtime 상에 Custom arguments로 claude-haiku-5-5를 지정한 두 번째 Agent를 생성하면 됩니다. 자세한 절차는 공식 가이드인 Sharkly에서 Claude Haiku 5.5 에이전트 실행하기에서 확인할 수 있습니다.
Task에는 모델명이 표시되지 않으므로, 저비용 Agent의 지침에 최종 응답 시 사용된 모델을 보고하라는 한 줄을 추가하십시오. Claude Code에서 Haiku 5.5는 기본적으로 medium 노력 수준으로 설정되며 사고(thinking) 과정을 비활성화할 수 없기 때문에, 여기서 설정하는 노력 수준에 따라 각 실행 비용이 결정됩니다.
10만 토큰 요금 구간의 실제 영향
배치 방식의 결정은 지불하는 요금에도 직접적인 영향을 미칩니다. Haiku 5.5의 백만 토큰당 0.10달러/0.50달러 요금은 프롬프트가 10만 토큰 이하일 때만 적용됩니다. 이를 초과하면 가격 정책에 따라 5배 높은 0.50달러/2.50달러가 부과됩니다. Anthropic에 따르면 Haiku 4.5 요청의 약 90%가 이 기준치 이하에 머물렀다고 합니다.
서브에이전트 호출은 명확하고 좁은 지침, 짧은 문서 조회, 단일 답변 반환 구조를 띠므로 10만 토큰 이하를 유지하기에 적합합니다. 반면 긴 Task를 수행하는 독립 Agent는 이 기준을 넘어서기 쉽습니다. Claude Code는 Haiku 5.5와 같은 기본 1M 모델을 기본적으로 약 967K 토큰에 도달했을 때 압축하므로 10만 토큰을 훨씬 초과하게 되며, 이에 따라 장기 실행되는 Haiku 5.5 세션은 후반 턴의 대부분을 더 높은 요율로 소비할 수 있습니다. 긴 Task에 대한 올바른 해결책은 작업을 리드 에이전트의 실행 세션 안으로 되돌리는 것이 아니라 세부 작업으로 쪼개는 것입니다.
따라서 두 가지 배치를 적절히 선택하면 비용 우위를 확보할 수 있습니다. 낮은 요율을 유지하기 쉬운 짧고 읽기 위주의 호출에는 세션 내 서브에이전트를 활용하십시오. 실제 배포되는 작업에는 별도의 Agent를 사용하되, 컨텍스트가 초과되기 전에 실행이 완료될 수 있도록 Task의 규모를 조절하십시오.
여전히 변하지 않는 두 가지
Anthropic은 모델의 한계를 분명히 밝히고 있습니다. Sonnet 5.5와 Opus 5.5가 “복잡한 에이전트 기반 코딩 작업에 여전히 더 나은 선택”이며, 출시 비교표에서도 최대 노력 수준 기준 Terminal-Bench 4.0 점수가 Sonnet 5.5의 70.6%에 비해 Haiku 5.5는 39.2%에 머물렀습니다. Haiku 5.5는 작업자나 보조자일 뿐, 리드가 아닙니다.
또한 더 저렴한 작업자를 쓴다고 해서 결과물 검토 및 승인 비용까지 저렴해지는 것은 아닙니다. Haiku 5.5를 서브에이전트로 실행하든 독립 Agent로 실행하든, 누군가는 여전히 결과물에 책임을 져야 합니다. 서브에이전트 방식은 그 책임을 리드 에이전트의 실행 세션 뒤로 숨기는 반면, Agent 방식은 명확한 이름과 상태를 부여합니다. 실행이 절반만 완료된 채 끝날 수 있는 브라우저 및 데스크톱 작업의 경우, 이러한 차이로 인한 비용 손실이 빠르게 커질 수 있으며, 이는 저비용 브라우저 에이전트와 검토 대기열에서 다루고 있습니다. 동일한 정가 기준 Haiku 5.5와 GPT-6 Luna 중 무엇을 선택할지는 별개의 문제이며, 동일한 가격대의 두 저비용 Runtime 비교에서 다룹니다.
배치 기준을 명확히 세워두고, 리드가 검토하는 조회성 작업에는 서브에이전트를 유지하며, 실제로 배포되는 모든 작업에는 고유한 Task를 부여하십시오. 이미 여러 에이전트를 운영 중이라면, Sharkly를 통해 에이전트들의 작업과 결과를 한곳에서 관리할 수 있습니다.


