

핵심 요약 (TL;DR)
Gemini Decisions API로 AI 에이전트 작업을 라우팅하려면 작업의 제목과 설명을 gemini-decision-1에 세 가지 질문과 함께 전달하면 됩니다. 어떤 에이전트가 맡을지 결정하는 choice, 난이도를 평가하는 score, 사람이 먼저 결정해야 하는지 판단하는 noul입니다. 신뢰도(confidence)가 설정한 임계값을 넘으면 자동으로 할당하고, 그렇지 않은 작업은 사람이 직접 검토하도록 보류합니다.
소개
여러 코딩 에이전트를 운영하는 팀이라면 누구나 똑같은 번거로운 일에 부딪히게 됩니다. 바로 누군가 새 작업을 일일이 확인하고 누가 처리할지 결정해야 한다는 점입니다. 백엔드 에이전트가 맡아야 할까요, 프론트엔드 에이전트가 맡아야 할까요? 저렴한 모델을 쓸까요, 고성능 모델을 쓸까요? 당장 시작할 준비가 된 작업일까요, 아니면 아직 사람의 판단이 더 필요한 상태일까요?
Google은 2026년 11월 11일, 바로 이러한 작업을 위해 특화된 도구를 선보였습니다. Gemini Decisions API는 텍스트를 생성하는 대신 정밀하게 보정된 확률(calibrated probabilities)을 바탕으로 닫힌 질문에 답합니다. Google은 Gemini Notebook 내부에서 각 쿼리를 적절한 모델 티어와 사고 수준(thinking level)으로 전달하는 데 이 API를 사용하고 있으며, 일상적인 쿼리의 지연 시간을 최대 40%까지 단축했다고 밝혔습니다.
이 글에서는 에이전트 보드에 적용할 수 있는 동일한 라우터를 구축해 봅니다. 작업당 한 번의 호출, 세 가지 질문, 하나의 임계값만으로 작동하며, 라우터가 확신하지 못할 때는 깔끔하게 사람에게 작업을 인계합니다. 이를 직접 적용해 볼 보드가 필요하다면 Sharkly를 무료로 시작해 볼 수 있습니다. 라우팅 정책 자체(어떤 작업에 고성능 모델을 배정할지)에 대한 내용은 난이도별 에이전트 작업 라우팅 글을 먼저 참고해 주세요. 본 글에서는 해당 정책을 적용하는 API 호출 구현을 집중적으로 다룹니다.
Gemini Decisions API의 작동 방식
Gemini Decisions API는 공유된 입력값을 바탕으로 타입이 지정된 질문들을 평가하고, 각 질문에 대한 확률과 신뢰도 점수를 반환하는 엔드포인트입니다. 텍스트를 전혀 생성하지 않으므로 출력 토큰은 언제나 0입니다. 따라서 복잡한 파싱 과정 없이 숫자를 기반으로 코드에서 직접 분기 처리를 할 수 있습니다.
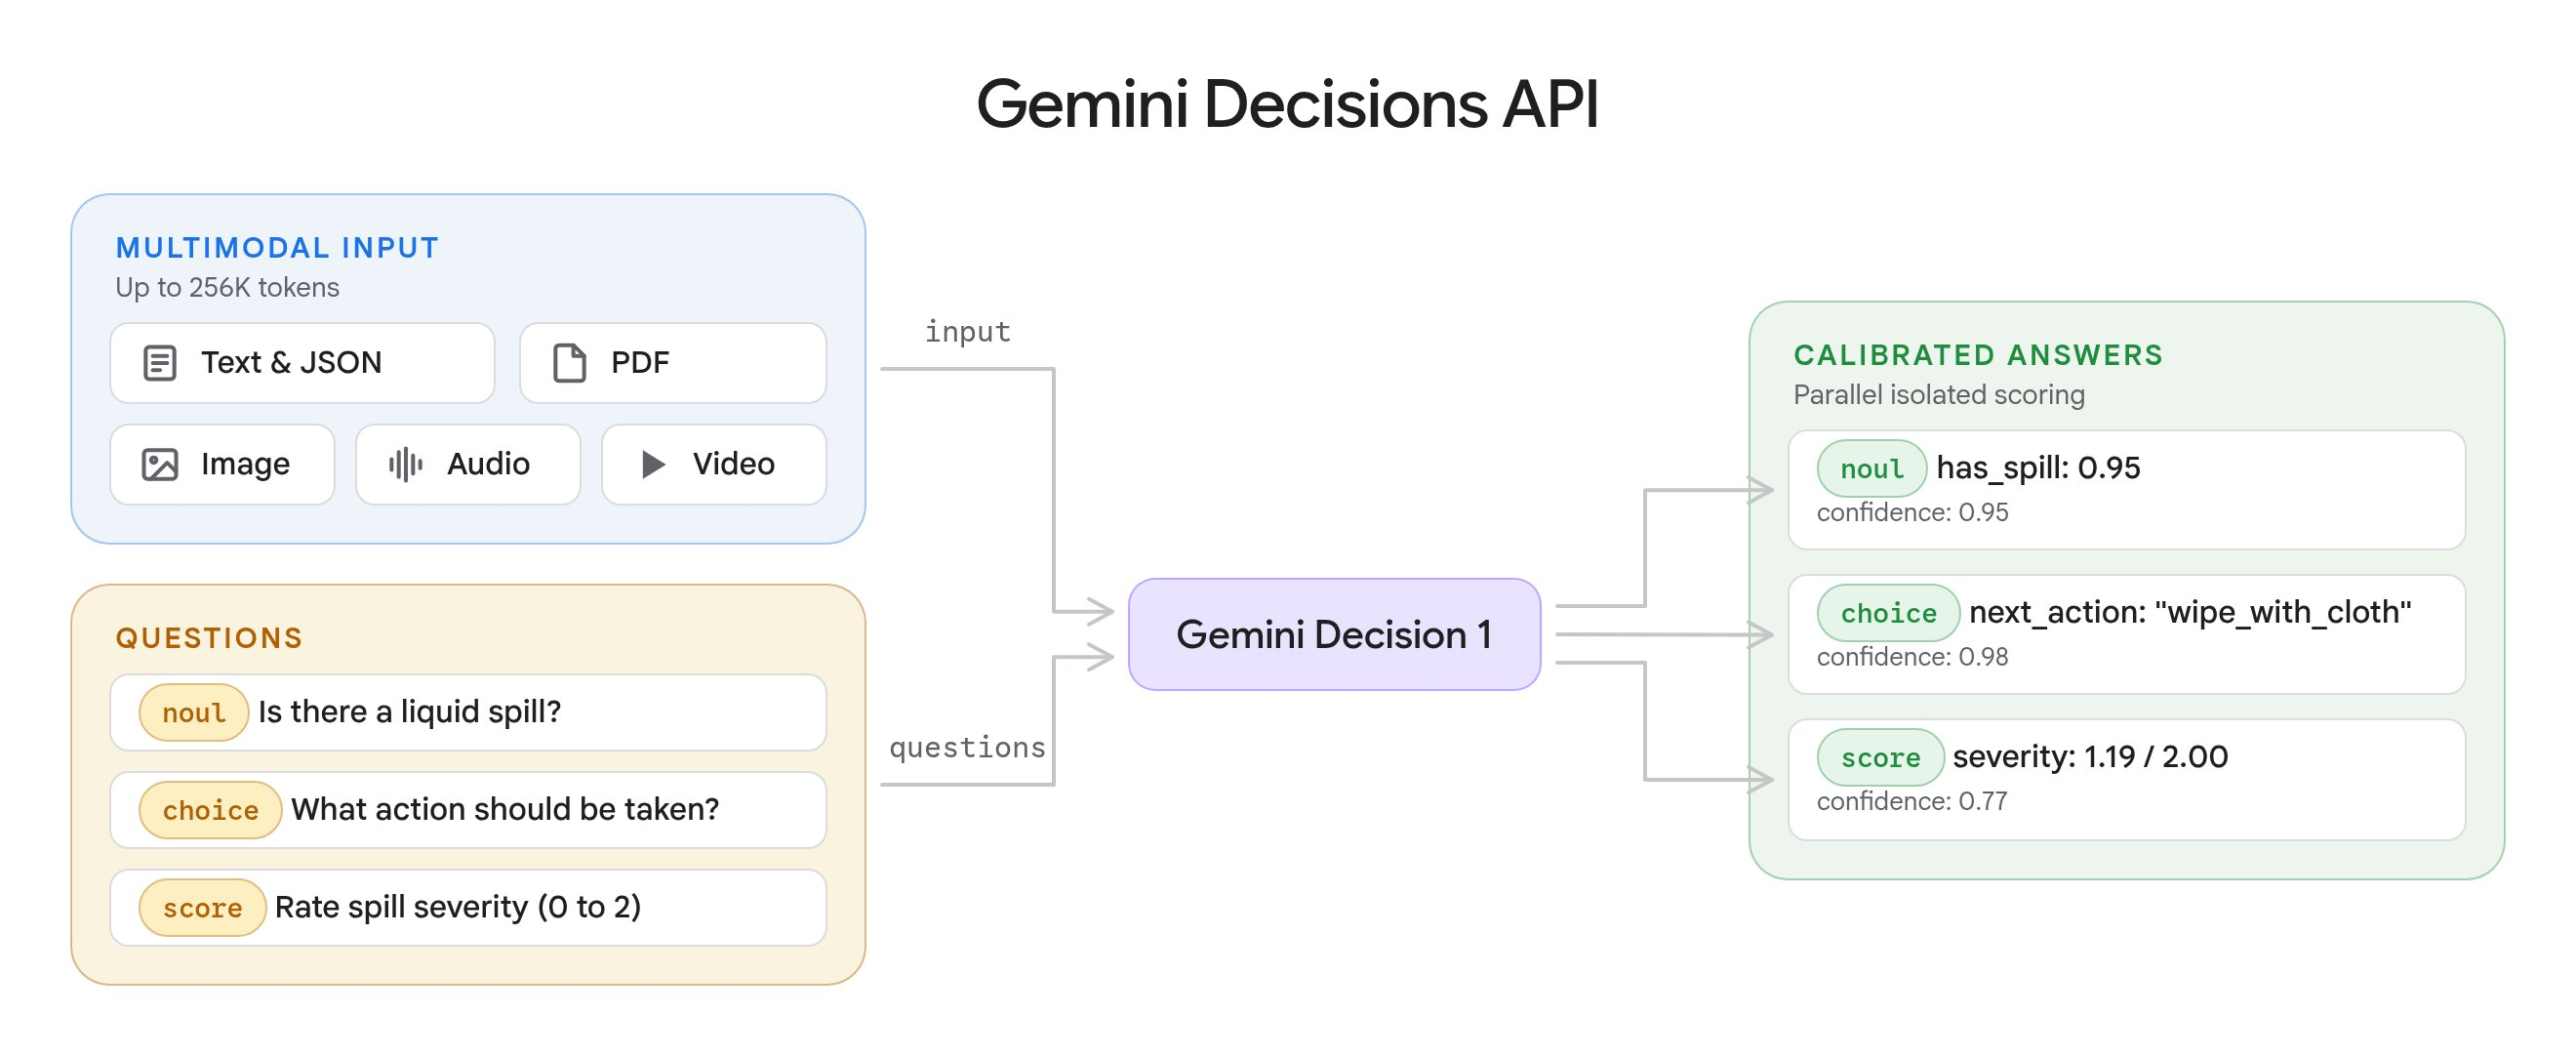
작업 라우팅에는 세 가지 질문 유형이 활용됩니다.
| 유형 | 응답 대상 | 반환 값 |
|---|---|---|
choice |
2~255개 보기 중 하나 선택 | choice, probabilities, confidence |
score |
순서가 지정된 루브릭 기준 평가 | score, probabilities, legend, confidence |
noul |
예 또는 아니오 | noul (0.01~0.99), confidence |
동일한 입력에 대해 단 한 번의 요청으로 최대 1,000개의 질문을 전달할 수 있습니다. Decisions API 공식 문서에 따르면, 질문들은 단일 순방향 패스(forward pass)로 처리되며 서로를 참조하지 않으므로 질문을 추가해도 다른 질문의 결과에 영향을 주지 않습니다. Google에 따르면 종단 간(end-to-end) 지연 시간은 150~250ms 수준이며, 질문 수가 1개에서 100개로 늘어나도 지연 시간은 거의 일정하게 유지됩니다.
Sharkly의 이전 글인 Jev와 코딩 에이전트를 위한 의사결정 모델을 읽어보셨다면 이 구조가 익숙하게 느껴지실 것입니다. 다만 이번에는 실용적인 차이점이 있습니다. Google 호스팅 모델을 사용하고, 구체적인 세 가지 질문을 정의하며, 이를 실제 보드에 직접 연동한다는 점입니다.
라우팅 호출 구현: 작업당 세 가지 질문
라우터 구현 코드는 다음과 같습니다. google-genai 3.2 이상 버전과 Google AI Studio에서 발급받은 GEMINI_API_KEY가 필요합니다.
import json
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

AGENTS = {
    "backend": "Server code, APIs, database migrations, and backend tests.",
    "frontend": "UI components, styling, client state, and frontend tests.",
    "docs": "README files, docs pages, and changelogs. No code changes.",
    "other": "Work that fits none of the options above.",
}

DIFFICULTY = [
    "Trivial: one file, obvious change, no design decision.",
    "Routine: a few files, follows a pattern already in the repo.",
    "Involved: several modules or a new pattern, needs new tests.",
    "Hard: cross-cutting, touches auth or data migrations, or the spec is thin.",
]

def ask(task):
    state = json.dumps({
        "title": task["title"],
        "description": task["description"][:8000],
    })
    result = client.decisions.create(
        model="gemini-decision-1",
        input=state,
        questions={
            "agent": {
                "type": "choice",
                "instructions": "Which agent should take the task in `title` and `description`?",
                "criteria": AGENTS,
            },
            "difficulty": {
                "type": "score",
                "instructions": "How hard is this task for a coding agent working alone?",
                "criteria": DIFFICULTY,
            },
            "needs_human": {
                "type": "noul",
                "instructions": "Does a person need to make a decision before any agent starts?",
                "criteria": {
                    "true_description": "The spec is ambiguous, contradicts itself, or asks for a product, security, or pricing call.",
                    "false_description": "The spec is clear enough to implement as written.",
                },
            },
        },
    )
    return result.answers
위 코드에서 공식 문서에 언급되어 있지만 놓치기 쉬운 네 가지 핵심 사항이 있습니다.
모델은 딕셔너리의 키를 전혀 보지 않습니다. 모델은 instructions와 criteria만 읽기 때문에, 질문 전체를 instructions에 명확히 작성하고 각 옵션의 내용을 빠짐없이 설명해야 합니다.
옵션 키는 알파벳순으로 정렬됩니다. API는 점수를 매기기 전에 선택지 키를 UTF-8 바이트 순서대로 정렬합니다. 따라서 예외 처리를 위한 기본 옵션 키로 other를 사용했습니다. none_of_the_above를 쓰면 실제 유효한 옵션들보다 앞서 정렬되기 때문입니다.
점수 단계(Score level)는 선형적이어야 합니다. 반환되는 score는 단계 인덱스의 확률 가중 평균이므로 여기서는 0에서 3 사이의 값이 됩니다. 인접한 단계 간의 차이를 명확하게 구분해 두어야 합니다.
질문에 꼭 필요한 정보만 전달하세요. 공식 문서에 따르면 관련 없는 내용이 포함되면 정확도가 떨어질 수 있습니다. 전체 댓글 스레드를 모두 보내는 것보다 제목과 본문 설명만 전달하는 편이 대체로 훨씬 정확합니다.
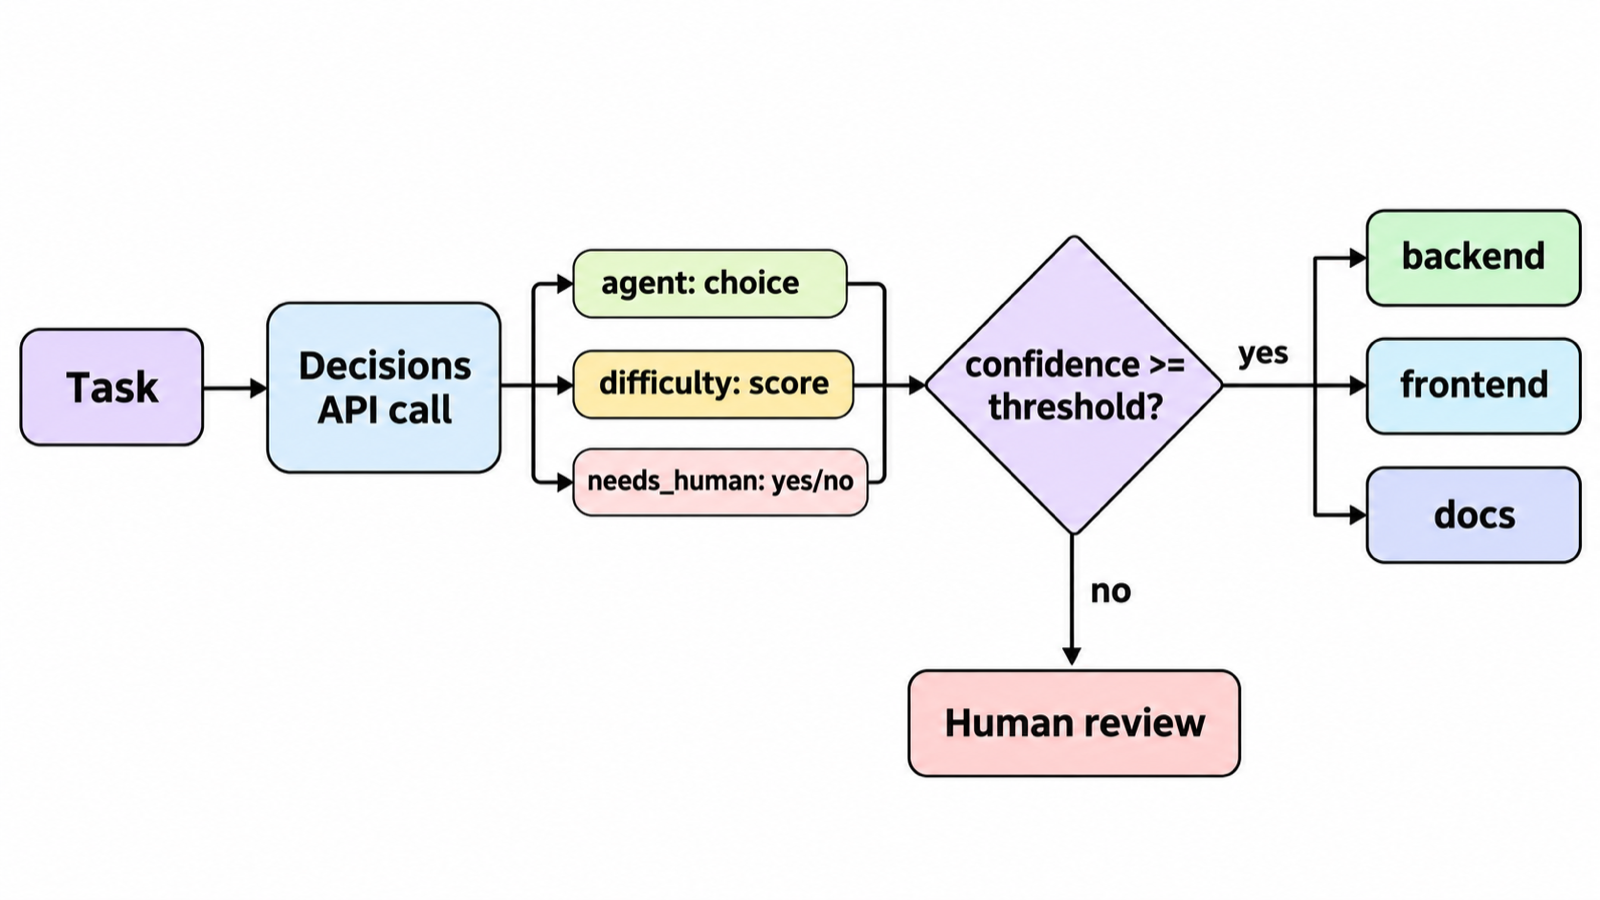
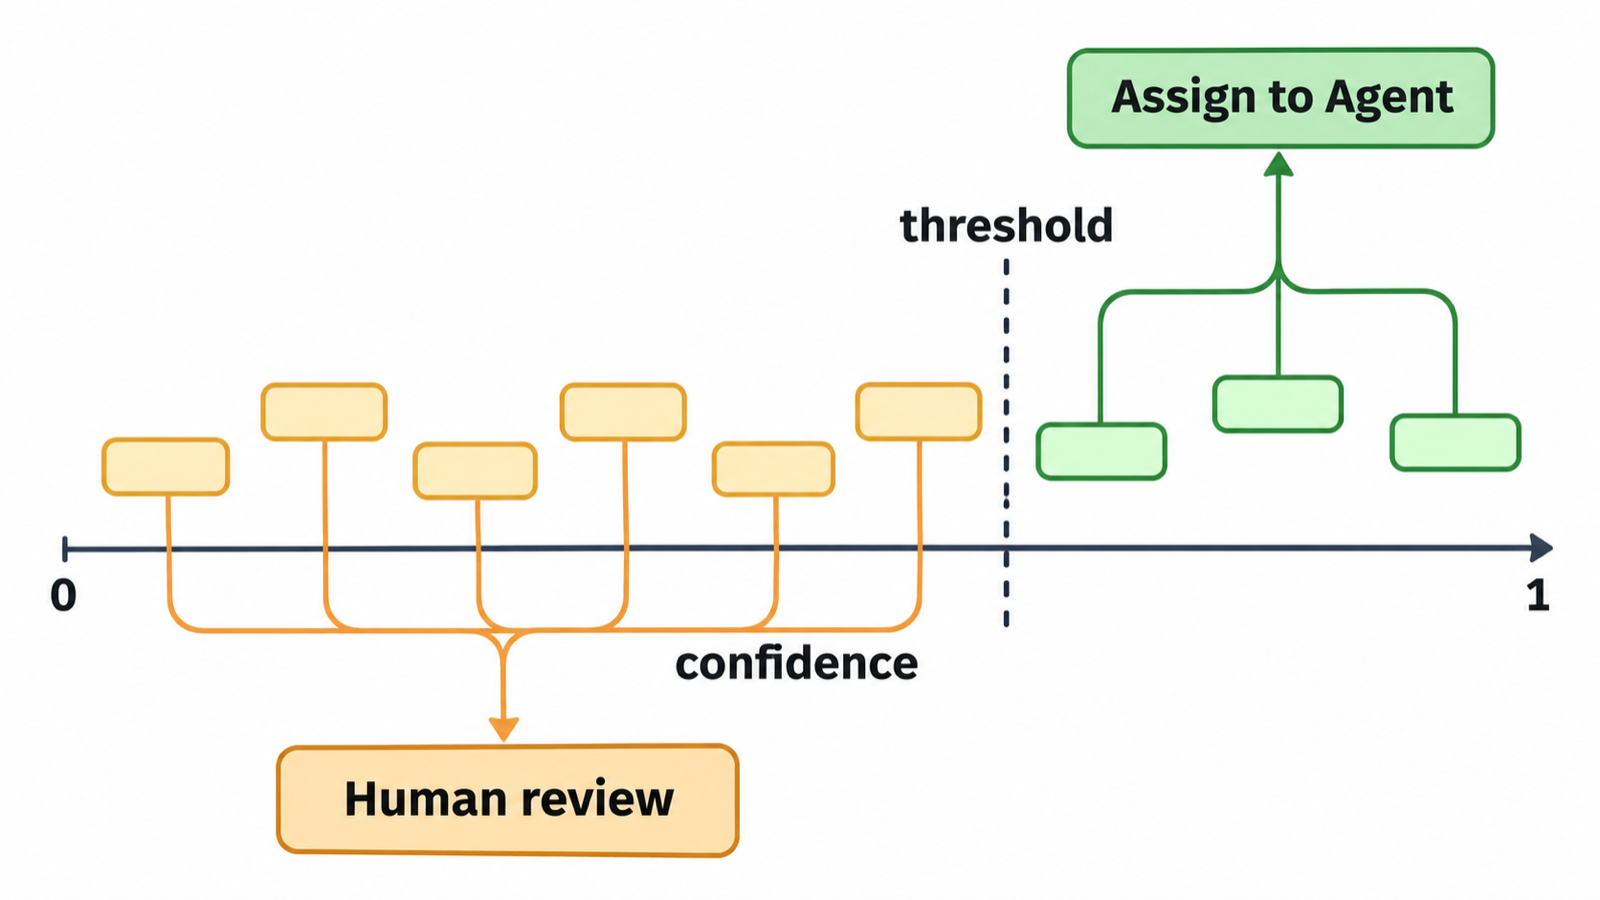
실제 작업 데이터를 기반으로 신뢰도 임계값 설정하기
응답 값은 무엇을 해야 할지 알려주고, 신뢰도는 사람에게 묻지 않고 바로 실행할지 여부를 알려줍니다. choice 응답의 신뢰도는 1순위 옵션의 확률과 같습니다. noul의 경우 max(noul, 1 - noul)로 계산됩니다.
의사결정 레이어 코드는 다음과 같습니다.
AUTO = 0.75      # assign without a person above this
HARD = 2.4       # difficulty score that earns the strong-model Agent

def decide(a):
    if a["needs_human"].noul >= 0.5:
        return ("human", "needs a decision first")
    if a["agent"].choice == "other" or a["agent"].confidence < AUTO:
        return ("human", f"router unsure ({a['agent'].confidence:.2f})")
    tier = "strong" if a["difficulty"].score >= HARD else "default"
    return (f"{a['agent'].choice}-{tier}", "auto")
0.75라는 수치를 그대로 가져다 쓰지 마세요. Google은 실제 환경의 라벨링된 예시 데이터를 바탕으로 임계값을 설정할 것을 권장합니다. 최근 완료된 작업 50~100개를 가져와 어떤 에이전트가 처리했는지 기록한 다음, 이를 ask() 함수에 넣어 돌려보세요. 자동으로 라우팅된 작업이 실제 팀에서 처리한 결과와 일치하는 가장 낮은 임계값을 선택하면 됩니다. 자동 라우팅이 잘못되면 실행 실패와 재할당 비용이 발생하지만, 불필요하게 사람 검토로 보류되면 몇 분의 시간 지연만 발생할 뿐입니다. 막연한 숫자를 정하기보다 이 두 가지 비용의 균형을 따져보고 결정하세요.
주의해야 할 함정이 두 가지 있습니다. 첫째, noul 확률은 결코 0.99를 넘지 않으므로 > 0.99 같은 조건문은 절대 실행되지 않습니다. 둘째, score가 1.5라는 것은 '1단계와 2단계 사이에서 팽팽하게 갈린 경우'일 수도 있고, '네 단계 전체에 걸쳐 확신하지 못한 경우'일 수도 있습니다. 정밀한 판단이 필요할 때는 probabilities 값도 함께 확인해야 합니다.
Sharkly 보드에 라우터 연동하기
라우터는 순수 Python으로 작성되었기 때문에 어디서나 실행할 수 있습니다. Sharkly 보드에서는 작업이 진행 가능한 상태가 되는 순간을 트리거로 설정하는 것이 가장 깔끔합니다.
1. 영역(Lane)과 티어(Tier)별로 에이전트를 하나씩 생성합니다. 예를 들어 backend-default, backend-strong, frontend-default와 같이 만듭니다. Sharkly 에이전트 문서에 따르면 각 에이전트는 기본적으로 런타임의 기본 모델을 따르지만, Model 설정에서 해당 런타임 카탈로그의 다른 모델을 지정할 수 있습니다. 바로 이 설정을 통해 난이도 점수가 적절한 모델 선택으로 연결됩니다.
2. sharkly CLI로 결정 사항을 적용합니다.
import subprocess

def apply(task_id, target, reason, a):
    note = (f"Router: agent={a['agent'].choice} ({a['agent'].confidence:.2f}), "
            f"difficulty={a['difficulty'].score:.1f}, "
            f"needs_human={a['needs_human'].noul:.2f}")
    if target == "human":
        subprocess.run(["sharkly", "task", "comment", task_id,
                        "--body", f"{note}. Held for a person: {reason}."], check=True)
        return
    subprocess.run(["sharkly", "task", "edit", task_id,
                    "--delegate-agent", target], check=True)
    subprocess.run(["sharkly", "task", "comment", task_id, "--body", note], check=True)
작업이 준비(ready) 상태일 때 에이전트를 할당하면 에이전트 실행이 시작됩니다. 확률 정보를 댓글로 남겨두는 것은 사소해 보여도 매우 중요합니다. 한 달 뒤 라우터의 결정을 감사(audit)하고 추적할 수 있는 근거가 되기 때문입니다.
3. 상태 변경을 트리거로 등록합니다. Sharkly Automation(자동화)에는 지침(instruction), 담당 에이전트, 트리거를 설정할 수 있습니다. 가벼운 라우터 에이전트를 만들고 "트리거를 발생시킨 작업에 대해 route.py를 실행하라"는 지침을 준 뒤, 팀에서 '준비 완료' 의미로 사용하는 상태에 대한 작업 상태(task-status) 트리거를 추가합니다. 작업 상태 트리거로 시작된 실행은 해당 작업과 자동으로 연결되므로 라우팅 기록이 작업 카드에 그대로 보존됩니다. CLI에서는 다음과 같이 실행합니다.
sharkly automation trigger create <automation-id> --kind task_event --to-status "Ready"
라우팅 호출 비용
Google 출시 발표에 따르면 Gemini Decision 1의 요금은 입력 토큰 100만 개당 0.10달러이며, 출력 토큰 비용은 0달러입니다. 공유 입력은 질문을 몇 개 작성하든 요청당 한 번만 과금됩니다.
| 항목 | 토큰 수 (추정치) |
|---|---|
| 작업 제목 및 설명 | 2,000 |
| 평가 기준을 포함한 3개 질문 | 300 |
| 라우팅 호출 1회당 총합 | 2,300 |
| 작업 1,000건 라우팅 시 | 230만 토큰, 약 0.23달러 |
라우팅에 드는 비용은 단일 작업에 에이전트를 한 번 실행하는 비용보다도 적습니다. 또한 Google AI Studio에서는 프로토타이핑을 위한 무료 티어도 제공합니다.
본격 도입 전 알아두어야 할 제한 사항
이 API는 Gemini Developer API에서 v1beta로 제공되며, Google Cloud 내 Gemini 지원은 "출시 예정(coming soon)"으로 명시되어 있습니다. 공식 문서에 따르면 컨텍스트 캐싱(context caching), Batch API, Flex 및 Priority 추론을 지원하지 않으므로 반복되는 입력도 매번 전체 토큰으로 계산됩니다. 티어별 요청 한도(Rate limit)는 Google의 요청 한도 페이지에서 확인할 수 있으니, 모든 작업을 단일 API 키로 라우팅하기 전에 한도를 미리 확인해 두세요.
작업 설명은 신뢰할 수 없는 입력(untrusted input)으로 취급해야 합니다. 공식 문서에서도 사용자가 입력한 텍스트가 특정 분류를 유도하도록 유인할 수 있다고 경고합니다. 팀 외부의 누군가가 작업을 등록할 수 있는 환경이라면, 라우터의 판단 결과와 무관하게 인증, 결제, 프로덕션 데이터와 관련된 작업은 반드시 사람이 검토하도록 보류해야 합니다.
Google이 발표한 벤치마크 결과(테스트 제품군 전반에서 가장 낮은 보정 오차 기록, Interactions API를 통한 Gemini 3.5 Flash-Lite 대비 약 5배 저렴)는 어디까지나 Google의 수치입니다. 실제로 가장 중요한 기준은 여러분의 팀이 직접 라벨링한 작업 데이터입니다.
라우팅 호출이 적합하지 않은 경우
Decisions API 호출은 사람이 직접 분류하기 어려울 정도로 작업이 빠르게 쌓이고, 선택지가 고정되어 있을 때(특정 에이전트 목록, 모델 티어 목록, 예/아니오 판별 등) 적합합니다. 이미 라벨만으로 결정할 수 있는 상황이라면 일반적인 규칙(rule)을 사용하는 것이 좋습니다. 예를 들어 docs 태그가 붙은 모든 작업이 문서 에이전트로 이동한다면, 단순한 if 조건문이 훨씬 저렴하고 절대 틀리지 않습니다.
반면 라우터가 결정 이유를 줄글로 설명해야 하거나, 작업 명세를 다시 작성해야 하거나, 작업을 여러 하위 작업으로 쪼개야 하는 경우에는 생성형 모델을 사용해야 합니다. Decisions API는 텍스트가 아닌 숫자만을 반환하기 때문입니다. 여러 역할에 걸쳐 작업을 분할해야 한다면 리더가 목표를 세부 단위로 나누는 크루(Crew) 방식이 더 적합합니다. 자세한 내용은 에이전트 크루를 위한 모델 라우팅을 참고하세요.
마치며
라우팅은 닫힌 집합(closed-set) 의사결정이며, Gemini Decisions API는 바로 이러한 결정을 위해 만들어졌습니다. 단 한 번의 호출, 명확한 타입의 응답, 임계값을 설정할 수 있는 신뢰도 점수, 그리고 1센트 미만의 저렴한 비용이 강점입니다. 이제 남은 일은 직접 만드는 것입니다. 선택지 설명을 명확히 작성하고, 완료된 작업 데이터로 임계값을 보정하며, 신뢰도가 낮은 작업은 사람에게 검토를 맡기도록 설정해 보세요.
우선 한 가지 영역부터 시작해 보세요. 일주일 동안 새로 들어오는 백엔드 작업을 라우팅해 보면서 라우터의 선택과 팀의 실제 판단을 비교한 다음, 적용 범위를 점차 넓혀가면 됩니다. 에이전트, 자동화, 사람의 검토를 한곳에서 지원하는 실제 보드에서 라우터를 직접 운영해 보고 싶다면 Sharkly 시작하기를 확인해 보세요.
자주 묻는 질문 (FAQ)
Gemini Decisions API란 무엇인가요?
2026년 11월 11일에 출시된 Gemini API 엔드포인트로, 텍스트, 이미지, 오디오, 비디오 또는 PDF에 대한 예/아니오, 선택(choice), 점수(score) 형태의 질문에 응답합니다. gemini-decision-1 모델을 사용하여 텍스트 생성 대신 정밀하게 보정된 확률과 신뢰도를 반환합니다.
Gemini Decision 1의 이용 요금은 얼마인가요?
Google 발표 기준 입력 토큰 100만 개당 0.10달러이며, 출력 토큰은 0달러입니다. 공유 입력은 요청당 한 번만 과금됩니다. 프로토타이핑을 위해 Google AI Studio에서 무료 티어도 제공됩니다.
단일 요청으로 몇 개의 질문까지 할 수 있나요?
입력 내용과 모든 질문을 합쳐 262,144 토큰의 컨텍스트 창 내에서 최소 1개부터 최대 1,000개까지 질문할 수 있습니다. 선택형(choice) 질문은 2개에서 255개 사이의 옵션을 지정할 수 있습니다.
라우팅에는 어떤 신뢰도 임계값을 사용해야 하나요?
모든 상황에 맞는 절대적인 수치는 없습니다. Google은 실제 작업 트래픽의 라벨링된 예시를 바탕으로 임계값을 설정할 것을 권장합니다. 완료된 작업 50~100건을 다시 실행해 보고, 자동 선택 결과가 팀의 판단과 잘 일치하는 임계값을 찾아보세요.
Decisions API로 에이전트가 사용할 모델을 지정할 수 있나요?
간접적으로 가능합니다. score 질문을 통해 난이도를 평가한 뒤, 높은 점수를 받은 작업을 더 강력한 모델로 구성된 에이전트에 매핑하면 됩니다. Sharkly에서는 각 에이전트마다 런타임 카탈로그의 특정 모델을 지정할 수 있습니다.
Gemini Decisions API는 Vertex AI에서도 사용할 수 있나요?
아직은 지원되지 않습니다. Google의 출시 발표에 따르면 Google Cloud 환경의 Gemini 지원은 곧 제공될 예정입니다. 현재는 Gemini Developer API에서 v1beta로 제공되고 있습니다.

