
여러 코딩 에이전트를 운영하는 대부분의 팀은 언젠가 모델 지출에 월간 상한을 설정합니다. 보통 힘든 한 주를 보낸 뒤에요. 숫자를 하나 정하고, 청구서가 그 아래로 유지될 때까지 동시 실행 수를 제한하고, 다음 분기에 다시 검토하죠. 2026년 9월 22일, 그 숫자는 조용히 원래의 의미를 잃었습니다.
OpenAI는 GPT-6 Sol을 백만 입력 토큰당 $2, 백만 출력 토큰당 $10, API id gpt-6-sol로 출시했고, 토큰 요율보다 훨씬 유용한 것을 공개했습니다. 바로 작업당 비용입니다. AutomationBench 1.0.6에서 초고추론 노력도(extra-high reasoning effort)의 Sol은 작업당 $0.27로 33.2%를 기록합니다. 최대 노력도의 Claude Opus 5는 같은 하네스에서 26.9%를 기록하며, 작업당 비용은 Sol의 11.1배입니다.
그러니 상한을 올리기 전에, 지금 그 상한이 무엇을 사주는지 따져보세요. 대부분의 팀에게 답은 이미 읽을 수 있는 양보다 많은 완료된 실행을 사준다는 것입니다. 즉, 그 상한은 예산을 보호한 적이 없습니다. 우연히 리뷰어를 보호하고 있었을 뿐이고, 이제 그마저도 끝나려 합니다.
요약
수용된 변경당 비용이란 사람이 실제로 읽고 수용하는 모든 diff에 대해 팀이 모델 추론에 지출하는 금액이며, 출시된 작업과 연결되는 유일한 에이전트 비용 지표입니다. 공개된 요율 기준으로, 리뷰어 4명 팀의 월간 전체 리뷰 가능 처리량은 대략 $136어치의 GPT-6 Sol로 충당됩니다. 병목은 청구서에서 수용 단계로 옮겨갔고, 어떤 모델 출시도 이걸 건드리지 못합니다. 에이전트는 조사하고, 실행하고, 테스트하고, 보고합니다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 수용합니다.
OpenAI가 실제로 공개한 숫자들
OpenAI는 점수와 함께 작업당 비용을 보고합니다. 이는 이례적으로 정직하고, 가격표보다 훨씬 유용합니다.
| OpenAI가 사용한 노력도 기준 모델 | AutomationBench 1.0.6 | 작업당 비용 |
|---|---|---|
| GPT-6 Sol, extra-high | 33.2% | $0.27 |
| GPT-6 Astra, low | 30.3% | Sol의 3.9배 |
| Claude Opus 5, max | 26.9% | Sol의 11.1배 |
| Opus 5 폴백을 둔 Fable 5.1, max | 31.4% | Sol의 8.9배 이상 |
첫 번째와 세 번째 행에 대한 OpenAI의 자체 요약: extra-high의 Sol은 Opus 5의 작업당 비용의 약 9%로 max의 Opus 5를 앞섭니다. 같은 패턴이 글의 다른 부분에서도 나타납니다. Agents' Last Exam V1에서 max의 Sol은 56.4%를 기록해 Opus 5의 최고 점수를 넘었고, 작업당 비용은 60% 더 낮습니다. DeepSWE 1.1에서 max의 Sol은 68.8%를 기록해 extra-high의 Fable 5(69.9%)에 1.1%포인트 차이로 근접하면서, 작업당 약 80% 더 저렴합니다.
이 수치들에는 두 가지 단서가 따라붙어야 하는데, 좀처럼 함께 언급되지 않습니다. OpenAI의 대표 주장은 Sol과 Luna가 각각 GPT-5.6 프로모션 가격보다 50% 저렴하다는 것이고, "프로모션"은 OpenAI가 쓴 표현입니다. 즉 비교 대상이 할인 요율이라는 뜻입니다. 그리고 OpenAI는 Claude Opus 5를 벤치마크 대상으로 삼았습니다. 왜냐하면 Claude Opus 5.5가 몇 시간 뒤에 Opus 5의 백만 토큰당 $5와 $25에 맞서 $4와 $20으로 출시되었기 때문입니다. Opus 5 열은 마지막으로 공개된 비교이며, 현재의 비교가 아닙니다.
예산을 실행 횟수로 환산하기
$0.27에 11.1을 곱하면, max의 Opus 5는 그 하네스에서 작업당 약 $3.00이 됩니다. 이 계산은 OpenAI의 두 수치에서 우리가 도출한 것입니다. 월간 상한을 각각으로 나누면, 상한의 의미를 바꿔놓는 표가 나옵니다.
| 월간 모델 예산 | Sol, extra-high 작업 수 | Astra, low 작업 수 | Opus 5, max 작업 수 |
|---|---|---|---|
| $250 | 약 925 | 약 240 | 약 83 |
| $1,000 | 약 3,700 | 약 950 | 약 330 |
| $5,000 | 약 18,500 | 약 4,750 | 약 1,660 |
벤치마크의 작업당 비용은 여러분의 작업당 비용이 아닙니다. AutomationBench의 작업은 벤치마크 형태입니다. 범위가 한정되고 짧으며, 수년간의 이력이 쌓인 저장소의 실제 티켓과는 전혀 다릅니다. 여러분의 작업은 토큰을 열 배, 혹은 백 배 더 태울 수도 있습니다. 벤치마크와 여러분의 저장소 사이에서 이전되는 것은 모델 간의 비율이지, 절대적인 달러 금액이 아닙니다. 표는 변화의 형태로 보고, 그다음 에이전트 전반의 실행당 비용을 직접 측정해 다시 환산하세요.
두 번째 보정이 있는데, 이건 반대 방향으로 작용합니다. 작업당 비용은 성공당이 아니라 시도당입니다. 벤치마크 자체의 33.2% 기준으로, 시도 세 번 중 약 두 번은 성공하지 못합니다. 따라서 Sol은 벤치마크 성공당 약 $0.81, max의 Opus 5는 약 $11.15가 됩니다. 이것도 우리 계산이며, 벤치마크 통과율은 팀의 수용률이 아니기에 대략적인 값입니다. 중요한 건 방향입니다. 같은 일을 두 번 시도하는 비용이 이제 충분히 작아져서, 재시도 전략은 예산 결정이 아니라 설계 선택이 되었습니다.
이제 상한은 어디에 있는가
리뷰 쪽도 같은 관점에서 봅시다. diff를 제대로 읽고, 에이전트가 무엇을 선택했는지 이해하고, 결과에 책임을 지는 리뷰어는 근무일 하루에 일정 수의 변경을 처리합니다. 6개라고 잡고, 여러분 팀에 맞게 조정하세요.
| 리뷰어 수 | 월간 수용된 변경 수 | $0.27 기준 Sol 비용 | $3.00 기준 Opus 5 max 비용 |
|---|---|---|---|
| 1 | 약 126 | $34 | $378 |
| 2 | 약 252 | $68 | $756 |
| 4 | 약 504 | $136 | $1,512 |
| 8 | 약 1,008 | $272 | $3,024 |
리뷰어당 하루 6개의 수용된 변경, 21 근무일 기준입니다. 우리의 가정이자 계산입니다. 여러분의 숫자를 넣어도 결론은 유지됩니다. 평범한 엔지니어링 팀이 한 달에 실제로 수용할 수 있는 모든 것은 값비싼 쪽에서도 추론 비용 몇백 달러면 충당됩니다. 4인 팀에 $1,000 상한은 제약이 아닙니다. 팀이 소화할 수 있는 양의 약 7배에 해당하는 에이전트 산출물입니다.
자기 작업을 리뷰하는 팀에게 가격 인하의 요점이 바로 이것입니다. 산출량을 높여주지 않았습니다. 짧은 큐에 대한 마지막 변명을 없애고, 늘 존재했던 병목을 사람의 리뷰 단계로 가시화했을 뿐입니다.
OpenAI의 내부 지출은 유용한 반례지, 모순이 아닙니다. 중간값 연구자는 API 가격 기준으로 하루 $600 이상의 코딩 에이전트 추론을 돌리고, 90번째 백분위는 하루 $7,000을 돌립니다. 이는 실제 수치이고 위의 표를 압도하는데, 그 작업의 형태가 다르기 때문입니다. 엄청난 팬아웃, 자동화된 채점, 그리고 이름 있는 담당자가 각 결과를 프로덕션 브랜치에 수용하는 단계가 없습니다. 여러분의 프로세스에 그 단계가 있다면, 모델 청구서는 계속 작게 유지되고 큐는 그렇지 않을 것입니다.
여유분으로 무엇을 살 것인가
예산이 병목이 아니게 되면, 질문은 몇 번의 실행을 살 것인가에서 그 차액을 어디에 쓸 것인가로 바뀝니다. 리뷰어에게 도착하는 작업을 늘리는 대신 줄이는 두 가지 답이 있습니다.
볼륨이 아니라 노력을 사세요. 추론 노력도는 비용 조절판이고, OpenAI의 표 자체도 벤치마크마다 다른 수준을 사용합니다. $0.27 수치는 extra-high 행이므로, 더 신중한 실행에 대한 프리미엄은 이미 대안의 9%에 해당하는 숫자 안에 포함되어 있습니다. 같은 작업 수에 이 비용을 지불하면 거의 아무것도 들지 않고, 확인하는 데 시간이 덜 걸리는 diff를 만들어냅니다.
토큰이 아니라 캐시를 사세요. GPT-6는 캐시된 입력 읽기를 90% 할인하고, 기본적으로 히트율을 더 높게 유지하며, 추론 노력도나 도구 가용성을 바꿔도 캐시를 무효화하지 않습니다. 명시적 브레이크포인트를 쓰면 캐시된 프리픽스가 어디서 끝나는지 직접 정할 수 있습니다. OpenAI는 GitHub가 수십억 건의 요청에서 새로 처리해야 하는 프롬프트 토큰이 50% 이상 줄었다고 언급합니다. Crew에게 이는 저장소에 붙는 첫 번째 에이전트와 열 번째 에이전트의 차이입니다. 이들은 레이아웃, 하우스 규칙, 관례라는 거의 같은 프리픽스를 다시 보내는데, 그 프리픽스야말로 캐시가 존재하는 이유입니다. 저장소 컨텍스트의 토큰 비용이야말로 플릿 청구서가 실제로 머무는 곳입니다.
정직한 결정 기준: 추가 실행이 사람이 수용하는 하나의 결과로 수렴할 때는 동시 실행 수를 올리세요. 예를 들어 테스트 스위트가 승자를 고르는 하나의 마이그레이션에 대한 세 번의 시도처럼요. 그러나 각 실행이 저마다의 diff와 요약, 수용 결정을 만들어낸다면 올리지 마세요. 실행이 아무리 저렴해졌어도 마찬가지입니다. 후자의 경우, 잘 확장된 것은 청구서뿐입니다.
새 상한을 셀 수 있게 만들기
예산은 용량을 나타내는 나쁜 대리 지표였지만, 한 가지 장점은 있었습니다. 누군가 지켜보는 숫자였다는 점입니다. 이제는 실제로 병목이 된 숫자로 교체하세요. 사람을 기다리는 완료된 실행입니다.
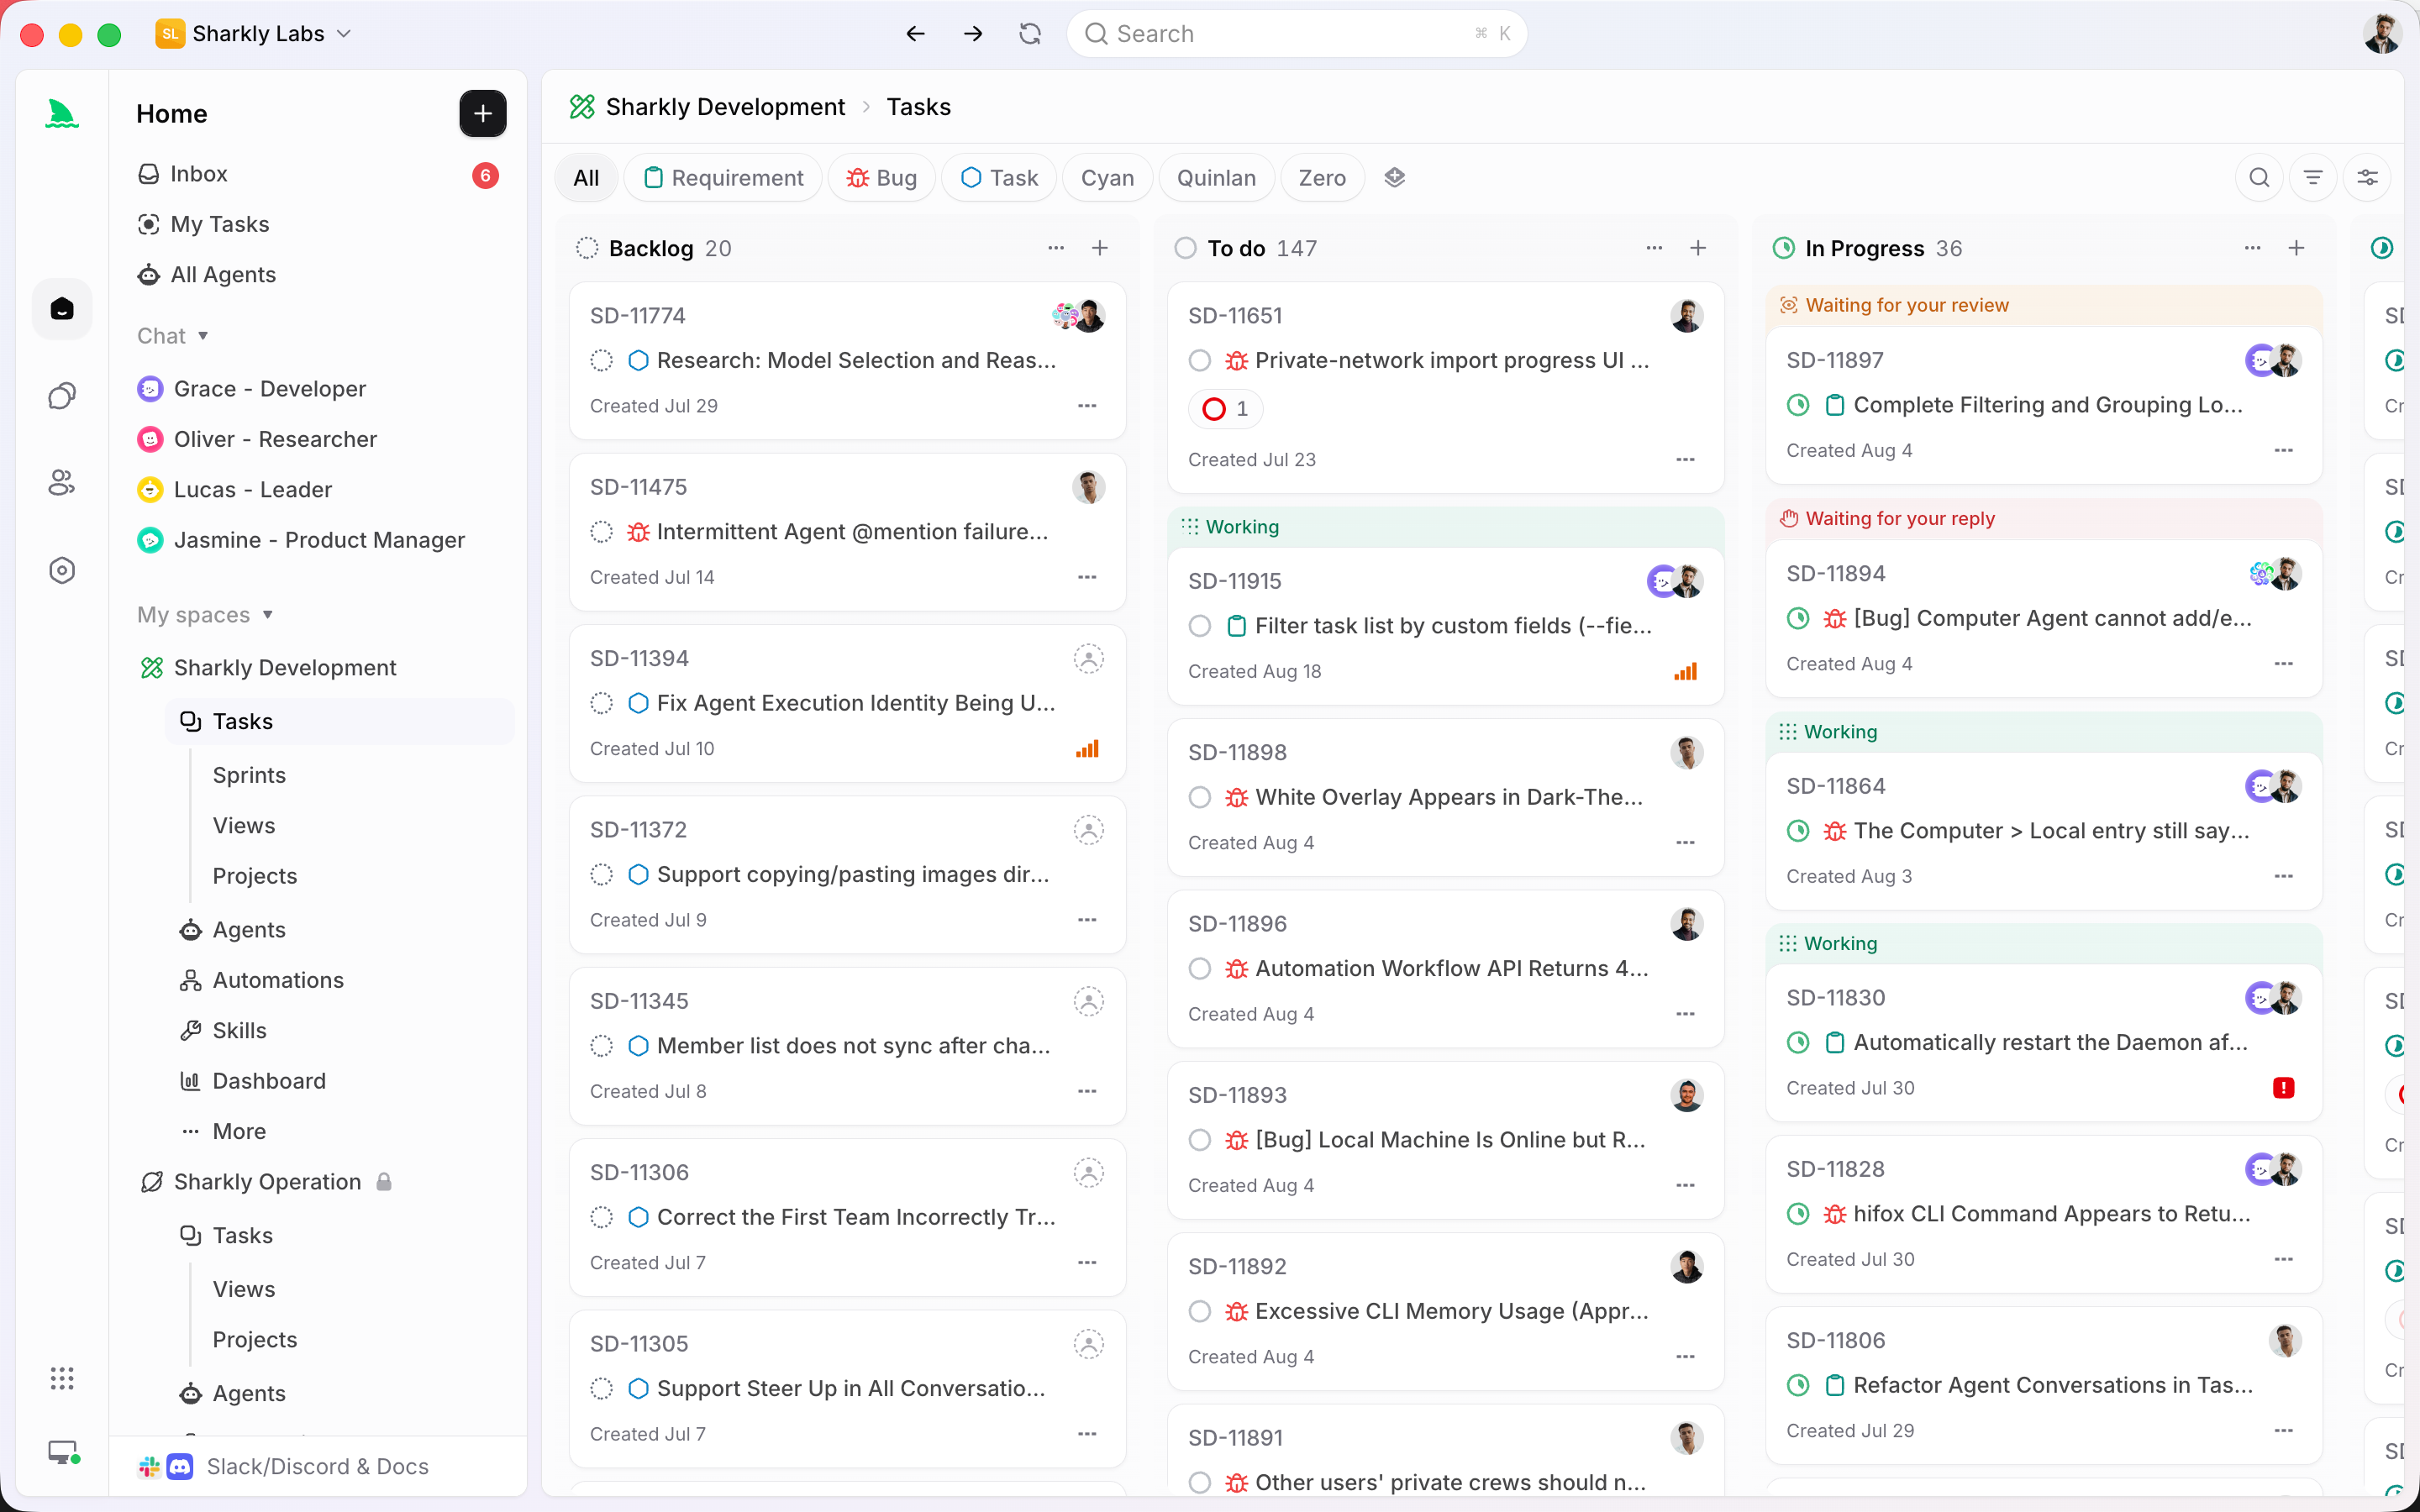
이는 실행이 개인 터미널에 머무르지 않아야 측정 가능합니다. Sharkly는 Codex, Claude Code, 또는 이 모델들을 돌리는 다른 도구들의 대체품이 아닙니다. 그것들을 둘러싼 레이어로, 컨텍스트와 진행 상황, 블로커, 결과, 그리고 사람의 리뷰가 요청부터 릴리스까지 가시적으로 유지됩니다. 실행과 블로커가 Task로 돌아오므로, "사람을 기다리는 중"은 금요일 오후에 드는 느낌이 아니라 보드에서 셀 수 있는 상태가 됩니다. 리뷰 용량 산정은 큐를 볼 수 있을 때만 작동합니다.
이미 여러 코딩 에이전트를 돌리고 있다면, 이번 주에 할 일은 상한을 올리는 게 아닙니다. 팀이 평범한 한 주에 몇 개의 완료된 실행을 수용하는지 파악하고, 그에 맞춰 동시 실행 수를 설정하고, 남은 예산을 수용하기 더 쉬운 실행에 쓰는 것입니다.


