Avalie o Claude Fable 5.2 em tarefas representativas do seu repositório com critérios de aceitação definidos, ambientes idênticos e uma linha de base que você já utilize. Meça em conjunto as alterações aprovadas, o esforço de revisão, o tempo decorrido e o custo total. Repita as execuções, documente as falhas e decida a adoção por categoria de tarefa em vez de se basear em uma única pontuação de benchmark.
A Anthropic anunciou o Fable 5.2 em 9 de novembro de 2026. O anúncio relata melhorias em codificação e raciocínio. Essas são alegações do próprio fornecedor com base em suas avaliações e experiências. Elas não determinam como o modelo se comporta diante de suas dependências, convenções e requisitos de release.
Sua avaliação deve responder a uma pergunta mais pontual: qual trabalho você pode delegar com uma carga de revisão aceitável? Se vários agentes de codificação já compartilham esse trabalho, o Sharkly oferece um espaço para organizar as tarefas e o contexto de revisão delas.
Este guia propõe um experimento. Ele não contém resultados comparativos medidos.
Crie um conjunto representativo de tarefas
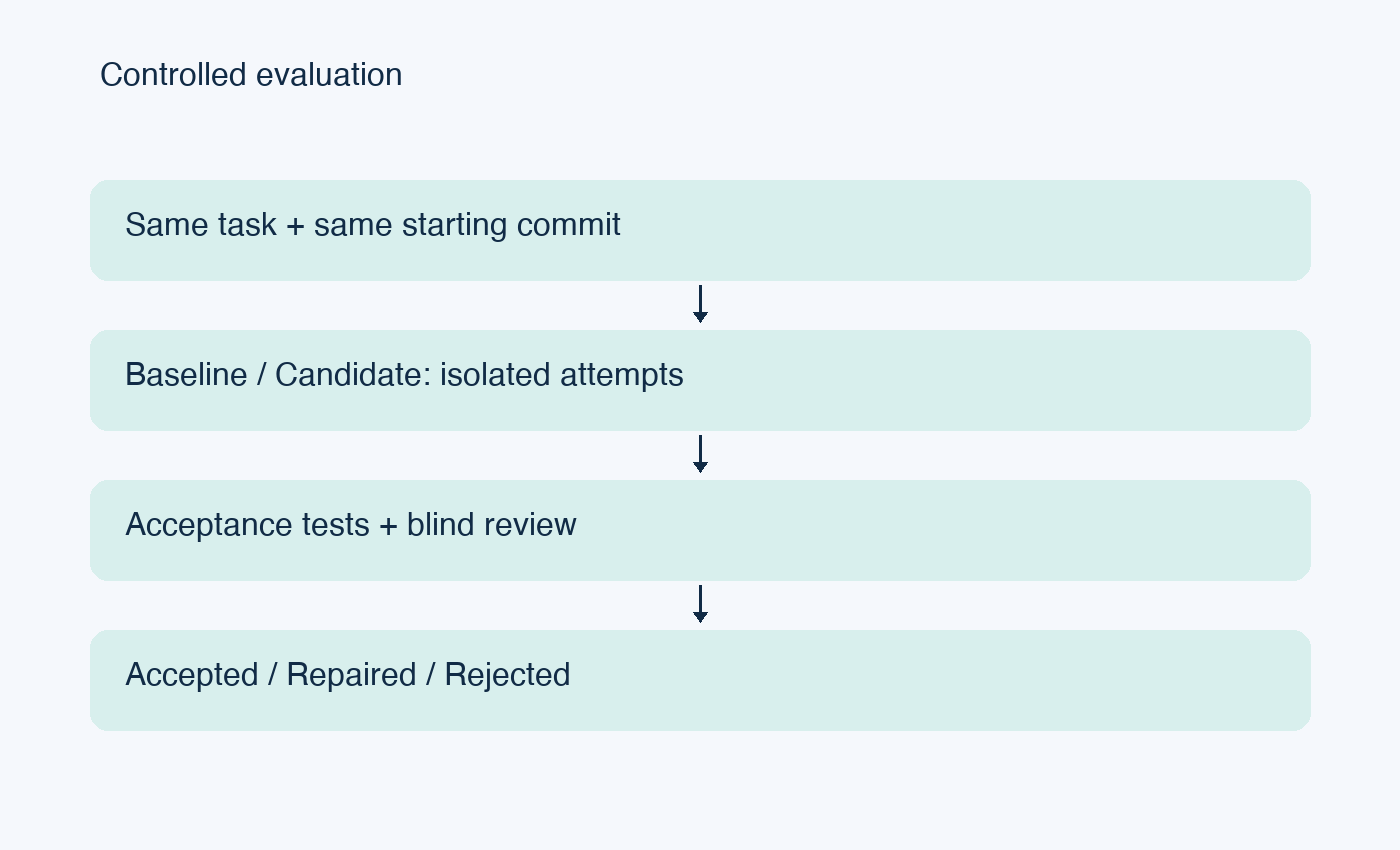
Uma avaliação em repositório é uma comparação controlada de fluxos de trabalho de codificação com base em requisitos extraídos do seu próprio trabalho de desenvolvimento. A unidade de sucesso é uma alteração aceita, incluindo seus testes e a revisão de código. Um patch plausível, um comando de teste aprovado ou uma mensagem de conclusão convincente, por si sós, não garantem a aceitação.
Comece com doze tarefas extraídas de trabalhos de manutenção recentes. Esse número é apenas uma sugestão de escopo piloto, não uma garantia estatística. Inclua correções de bugs, pequenas adições de recursos, refatorações e tarefas de investigação em proporções semelhantes às do seu backlog.
Escolha trabalhos que tenham um commit inicial bem definido e um revisor que compreenda o comportamento esperado. Evite selecionar apenas problemas com respostas óbvias. Inclua pelo menos uma tarefa cuja resposta correta exija fazer uma pergunta ou explicar uma dependência ausente.
Para problemas históricos, remova a solução do contexto fornecido. Registre se a correção já era pública, pois o modelo pode já tê-la encontrado anteriormente. Mantenha um conjunto separado de tarefas não publicadas para uma rodada de confirmação posterior.
Defina os critérios de aceitação antes de qualquer execução. Para a correção da paginação de uma API, especifique o comportamento para resultados vazios, limites de página, cursores inválidos e compatibilidade com clientes existentes. Inclua o escopo permitido para as alterações e as verificações necessárias para aprovação.
| Categoria | Exemplo de tarefa | Evidência de aceitação |
|---|---|---|
| Correção de bug | Tratar corretamente o limite do cursor | Teste de regressão e suíte existente aprovados |
| Pequena adição | Adicionar filtragem opcional de requisições | Testes de contrato e padrões documentados |
| Refatoração | Extrair validação duplicada | Comportamento público inalterado e revisão aprovada |
| Investigação | Diagnosticar timeout intermitente | Reprodução e explicação causal fundamentada |
Use uma tarefa pequena quando precisar de uma comparação direta e isolada. Use uma tarefa maior quando a coordenação fizer parte da questão avaliada, e pontue esse experimento separadamente.
Congele as condições antes de executar os agentes
Registre o commit do repositório, o sistema operacional, os lockfiles de dependências, as versões das ferramentas, o identificador do modelo e a configuração. Fixe também o harness do agente: o harness é o software que fornece ferramentas, contexto e o comportamento de execução ao redor do modelo.
Compare o Fable 5.2 com seu fluxo de trabalho atual. Uma comparação entre modelos exige o mesmo harness sempre que houver suporte. Uma comparação de fluxos de trabalho pode usar ferramentas diferentes, mas sua conclusão deve especificar essas configurações completas.
Mantenha equivalentes as permissões, o acesso à rede, o contexto inicial e os limites de tempo. Defina se a instalação de dependências conta para o tempo decorrido. Não permita que uma configuração herde arquivos editados, caches contendo respostas ou o histórico de conversa de outra execução.
Use um checkout limpo ou uma worktree isolada para cada tentativa. A documentação de worktree do Git explica como múltiplas árvores de trabalho compartilham um repositório. O isolamento de arquivos não isola bancos de dados, portas ou serviços externos; forneça recursos de teste separados para eles também.
Estabeleça uma regra explícita de intervenção. Por exemplo, permita apenas uma resposta de esclarecimento contendo informações acessíveis a todas as configurações. Registre todo o tempo de intervenção. Um revisor que corrige discretamente uma implementação altera o que o experimento está de fato medindo.
Execute tentativas pareadas e preserve as falhas
Execute cada configuração nas mesmas tarefas. Alterne a ordem de execução para que uma lentidão temporária do serviço não favoreça sistematicamente um dos candidatos. Repita as tentativas sempre que os recursos permitirem, adotando um número fixo de repetições definido antes de analisar os resultados.
Um piloto prático pode usar três tentativas por configuração para cada tarefa. Encare isso como um ponto de partida de engenharia. Uma amostra pequena não permite conclusões precisas sobre falhas raras ou superioridade indiscutível.
Armazene o prompt, a configuração, os registros de data e hora, a transcrição, o patch, a saída das ferramentas e a decisão final de cada tentativa. Registre timeouts e execuções abandonadas como desfechos. Ignorá-los faz com que as execuções bem-sucedidas pareçam mais baratas e mais rápidas do que o fluxo de trabalho real em produção.
Mantenha fixtures de teste e credenciais isoladas do ambiente de produção. Siga o processo de testes já adotado no seu repositório. Em repositórios Python, a documentação do pytest descreve fixtures e a execução de testes; cabe ressaltar que o framework não determina se seus critérios de aceitação cobrem adequadamente os requisitos.
Priorize a correção em relação à velocidade
Sempre que viável, faça com que um revisor inspecione o patch sem saber qual modelo o gerou. Utilize uma rubrica pré-definida que avalie o atendimento aos requisitos, o risco de regressão, a manutenibilidade, a qualidade dos testes e eventuais alterações fora de escopo.
Passar nos testes é indispensável quando a tarefa os exige, mas testes podem codificar comportamentos incorretos. Valide as asserções em relação ao requisito original. Fique atento a verificações desativadas, tolerâncias ampliadas, erros suprimidos e alterações que apenas contornam o caminho de falha.
Classifique os resultados em três status: aceito sem alterações, aceito após correções e rejeitado. Registre o tempo gasto em correções e a natureza de cada ajuste. Defina com antecedência se as alterações corrigidas serão contabilizadas na sua taxa de aceitação principal.
Em tarefas de investigação, avalie a cadeia de evidências. Um relatório útil descreve observações, diferencia hipóteses e indica um próximo passo reproduzível. Não premie um diagnóstico confiante que carece de evidências.
Calcule o custo por alteração aceita
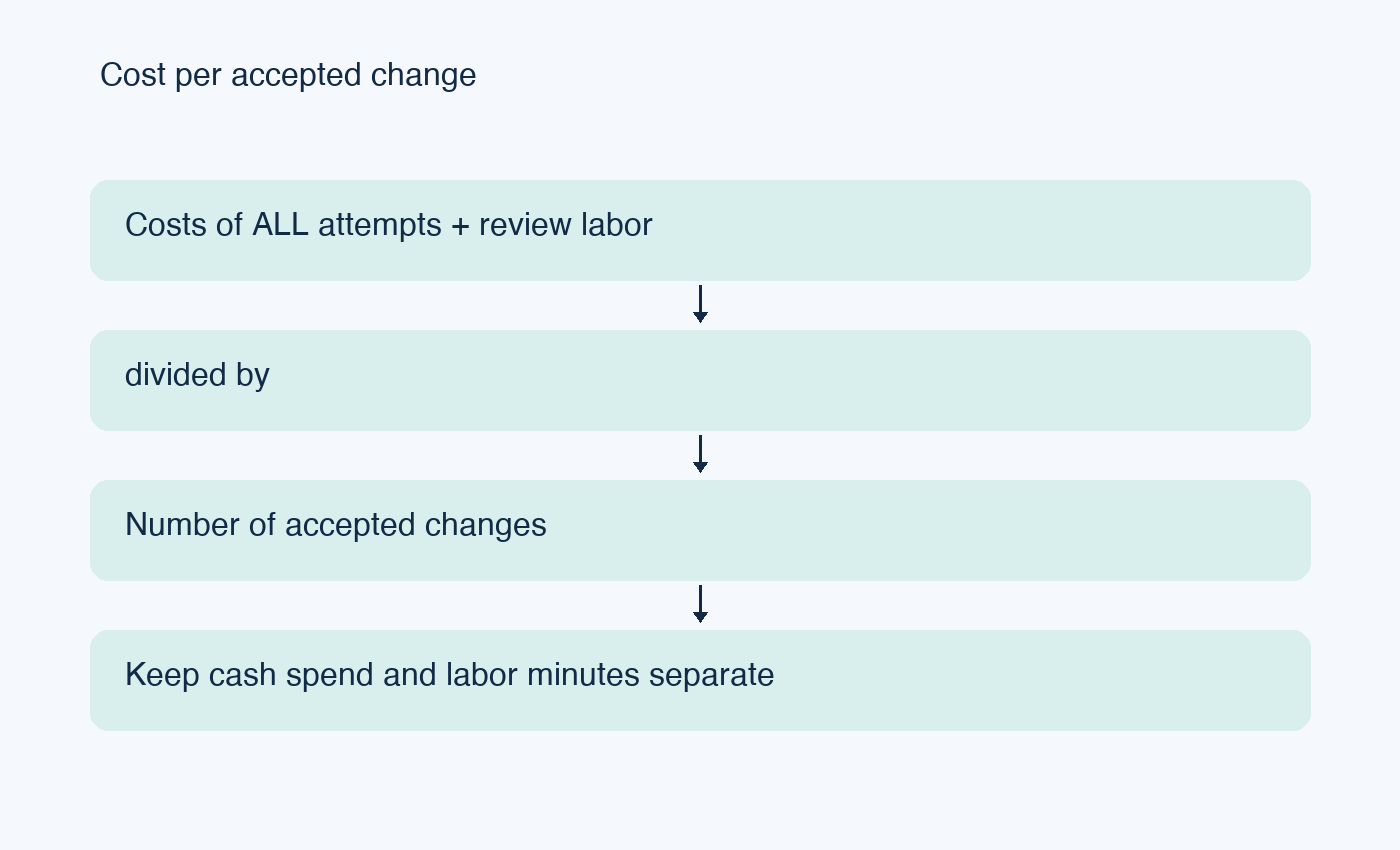
O custo por alteração aceita divide o custo total da avaliação pelo número de alterações aprovadas segundo a regra pré-estabelecida. Inclua as tentativas com falha no numerador. Se nenhuma alteração for aceita, relate o custo e zero aceitações; a razão não possui um valor finito.
Acompanhe estas métricas em conjunto:
- Taxa de aceitação por categoria de tarefa.
- Tempo de relógio decorrido desde o início da tarefa até a entrega pronta para revisão.
- Minutos dedicados à revisão humana e correções.
- Custos de modelo e ferramentas em todas as tentativas.
- Custos de infraestrutura, quando relevantes.
- Regressões identificadas durante a janela de observação.
Registre o consumo de tokens e a tabela de preços com data ao lado dos valores faturados. Tokens em cache, novas tentativas e ferramentas de execução podem alterar os custos. Não estime a fatura apenas com base no tamanho da saída gerada.
Se você atribuir um valor financeiro à hora do revisor, identifique isso como uma premissa interna. Apresente os custos financeiros diretos e os minutos de trabalho humano de forma separada, permitindo que os leitores refaçam os cálculos. Uma geração mais barata ainda pode demandar muito mais atenção da engenharia.
Mantenha as evidências da avaliação vinculadas ao trabalho
O Sharkly gerencia as demandas em torno de agentes de codificação. Seu fluxo de trabalho documentado conecta Tasks, Agents, Computers, contexto de execução e revisão humana. Consulte a documentação do Sharkly para conferir o vocabulário e a configuração atuais do produto.
Para este experimento, inclua os critérios de aceitação em cada Task e registre o patch, as evidências de teste e o resultado no mesmo registro de trabalho. Mantenha o histórico da avaliação em uma planilha ou em um arquivo de dados versionado se isso facilitar a análise. Não presuma que a plataforma calculará suas métricas experimentais de forma automática.
Utilize um único Agent para um teste de escopo delimitado. Introduza uma Crew apenas quando a própria coordenação fizer parte da avaliação. Alterar a estrutura da equipe no meio do processo adiciona uma variável indesejada.
Os agentes executam e reportam evidências. As pessoas definem a aceitação, inspecionam as alterações e autorizam o lançamento. Essa divisão continua indispensável mesmo quando o código passa em todas as verificações automatizadas.
Decida a adoção por categoria
Defina as regras de adoção antes de abrir os resultados. Exija primeiro um nível aceitável de precisão e correção; em seguida, compare o custo e o tempo decorrido entre as configurações que atingiram esse patamar. Mantenha categorias sensíveis à segurança ou com baixa cobertura de testes fora da implementação inicial.
Apresente contagens absolutas junto com as porcentagens. Um resultado de duas tarefas aceitas em três conta uma história bem diferente de duzentas em trezentas. Descreva as incertezas e os padrões de falha em vez de declarar um vencedor absoluto.
Repita a avaliação após mudanças significativas nos prompts, harnesses, versões de modelos ou na estrutura do repositório. Preserve a configuração antiga para que melhorias futuras tenham uma linha de base reproduzível.
Comece com uma tarefa representativa de manutenção no Sharkly, anexe critérios de aceitação explícitos e compare as evidências retornadas com o seu fluxo de trabalho atual. Expanda a aplicação somente depois de conseguir explicar tanto os sucessos quanto os fracassos.
FAQ
Um benchmark público de codificação pode substituir essa avaliação?
Ele pode ajudar a selecionar candidatos, mas não cobre as convenções do seu repositório, dependências, critérios de revisão ou restrições operacionais.
Todas as tentativas devem usar prompts idênticos?
Use informações equivalentes sobre a tarefa e uma política de prompts pré-definida. Registre wrappers específicos de ferramentas para que as diferenças possam ser auditadas.
Patches corrigidos contam como sucessos?
Defina essa regra com antecedência. Relate separadamente as aceitações sem alterações e as aceitações pós-correção, incluindo o tempo de reparo na comparação dos fluxos de trabalho.
Como os timeouts devem ser pontuados?
Considere-os como falhas dentro do tempo limite estabelecido. Inclua seus custos e o tempo decorrido nos resultados.
Quando a equipe deve expandir a adoção?
Expanda quando uma categoria de tarefas atender aos seus critérios de aceitação em testes repetidos e os revisores compreenderem seus padrões recorrentes de falha.
Recursos adicionais
Leia a documentação do Git para isolamento de repositórios, o guia de fixtures do pytest para configuração controlada de testes e acesse o Sharkly para organizar o trabalho de agentes e a revisão humana.