
Resumo: os limites de taxa do GPT-6.2 são iguais para Astra e Sol na API: 5.000 RPM e 1.000.000 TPM no tier Build, 10.000 RPM e 4.000.000 TPM no Launch e 15.000 RPM e 40.000.000 TPM no Grow. Os limites se aplicam por organização e por projeto, então todos os agentes em uma mesma chave compartilham o mesmo limite. Para equipes de agentes, o que se esgota primeiro são os tokens por minuto, não as requisições.
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. O Astra é o modelo de fronteira para os trabalhos mais difíceis; o Sol é o modelo mais barato para o dia a dia, feito para “alimentar agentes em escala”, nas palavras da própria OpenAI.
Um agente raramente atinge um limite. Seis agentes em uma única chave de API atingem antes do almoço. Este guia cobre os limites de taxa do GPT-6.2, os tetos dos planos do Codex e como dimensionar uma equipe de agentes para que ela entre em fila em vez de falhar. Se você já executa vários agentes de código, o Sharkly é onde você define quantos deles rodam ao mesmo tempo.
Limites de taxa do GPT-6.2 por tier de uso
O GPT-6.2 Astra e o GPT-6.2 Sol compartilham uma única tabela padrão de limites de taxa na página do modelo Sol e na página do modelo Astra da OpenAI. RPM significa requisições por minuto; TPM significa tokens por minuto. O que você esgotar primeiro é o que te bloqueia.
| Tier | Elegibilidade (compras totais de crédito) | Limite de uso mensal | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5.000 | 1.000.000 |
| Launch | $100 | $5.000 | 10.000 | 4.000.000 |
| Grow | $500 | $200.000 | 15.000 | 40.000.000 |
As colunas de elegibilidade e uso mensal vêm do guia de limites de taxa da OpenAI. Seu tier é atualizado automaticamente conforme as compras totais de crédito cruzam cada limite. O limite de uso mensal é um teto separado dos limites de gastos que você mesmo define.
O Astra custa quatro vezes mais por token ($8 de entrada e $40 de saída por milhão, contra $2 e $10 do Sol), mas o limite de taxa é o mesmo. O que você atinge depende de quantos tokens seus agentes consomem.
Como funcionam os tetos de uso do GPT-6.2 no Codex
Se seus agentes rodam pelo Codex em um plano ChatGPT em vez de uma chave de API, um teto diferente se aplica. A página de preços do Codex da OpenAI apresenta mensagens locais por janela de cinco horas como faixas, porque o tamanho da tarefa altera o custo de cada mensagem.
| Modelo | Plus | Business Standard |
|---|---|---|
| GPT-6.2 Astra | 6 a 50 | 6 a 50 |
| GPT-6.2 Sol | 17 a 180 | 17 a 180 |
| GPT-6.1 Sol | 15 a 160 | 15 a 160 |
| GPT-6 Astra | 5 a 45 | 5 a 45 |
Quatro detalhes importam para equipes de agentes:
- Os planos Pro não têm limite de cinco horas neste momento, mas limites semanais ainda podem se aplicar.
- Mensagens locais e chats na nuvem compartilham a mesma cota. Uma tarefa na nuvem pode consumir mais dela do que uma mensagem local.
- Velocidade custa cota. O modo rápido consome 2x a inclusão de uso nos modelos GPT-6.2; o ultrarrápido consome 6x.
- Sessões longas custam mais por mensagem. A OpenAI diz que tarefas que mantêm mais contexto usam “significativamente mais” da cota.
Um agente que já leu metade de um repositório envia um contexto enorme a cada turno, então sua contagem de mensagens cai rápido. Cobrimos o mesmo padrão nos planos da Anthropic em Claude Code usage limits, e a reação ao corte do limite do Codex Pro segue a mesma lógica.
Por que o TPM, e não o RPM, limita uma equipe de agentes
Um agente de código não envia milhares de requisições pequenas. Ele envia poucas requisições grandes. A cada turno, ele reenvia toda a conversa até então: instruções, arquivos que leu, saídas de ferramentas e seu próprio raciocínio anterior.
Considere um agente ilustrativo: 80.000 tokens de entrada por turno e 6 turnos por minuto. Isso dá 6 RPM e cerca de 480.000 TPM. Comparado ao tier Build:
- RPM: 6 de 5.000 usados. Nem perto.
- TPM: 480.000 de 1.000.000 usados. Dois agentes preenchem tudo.
Seus números vão diferir; a proporção não. Agentes são pesados em tokens e leves em requisições. Para esse agente de exemplo, o teto bruto é de dois agentes por projeto no Build e oito no Launch. Mantendo a margem de 30% das etapas de dimensionamento abaixo, isso cai para um agente no Build e cinco no Launch. No Grow, o limite de taxa deixa de ser seu gargalo e o teto mensal de $200.000 — ou o seu próprio orçamento — assume o controle.
Os limites são compartilhados por toda a organização
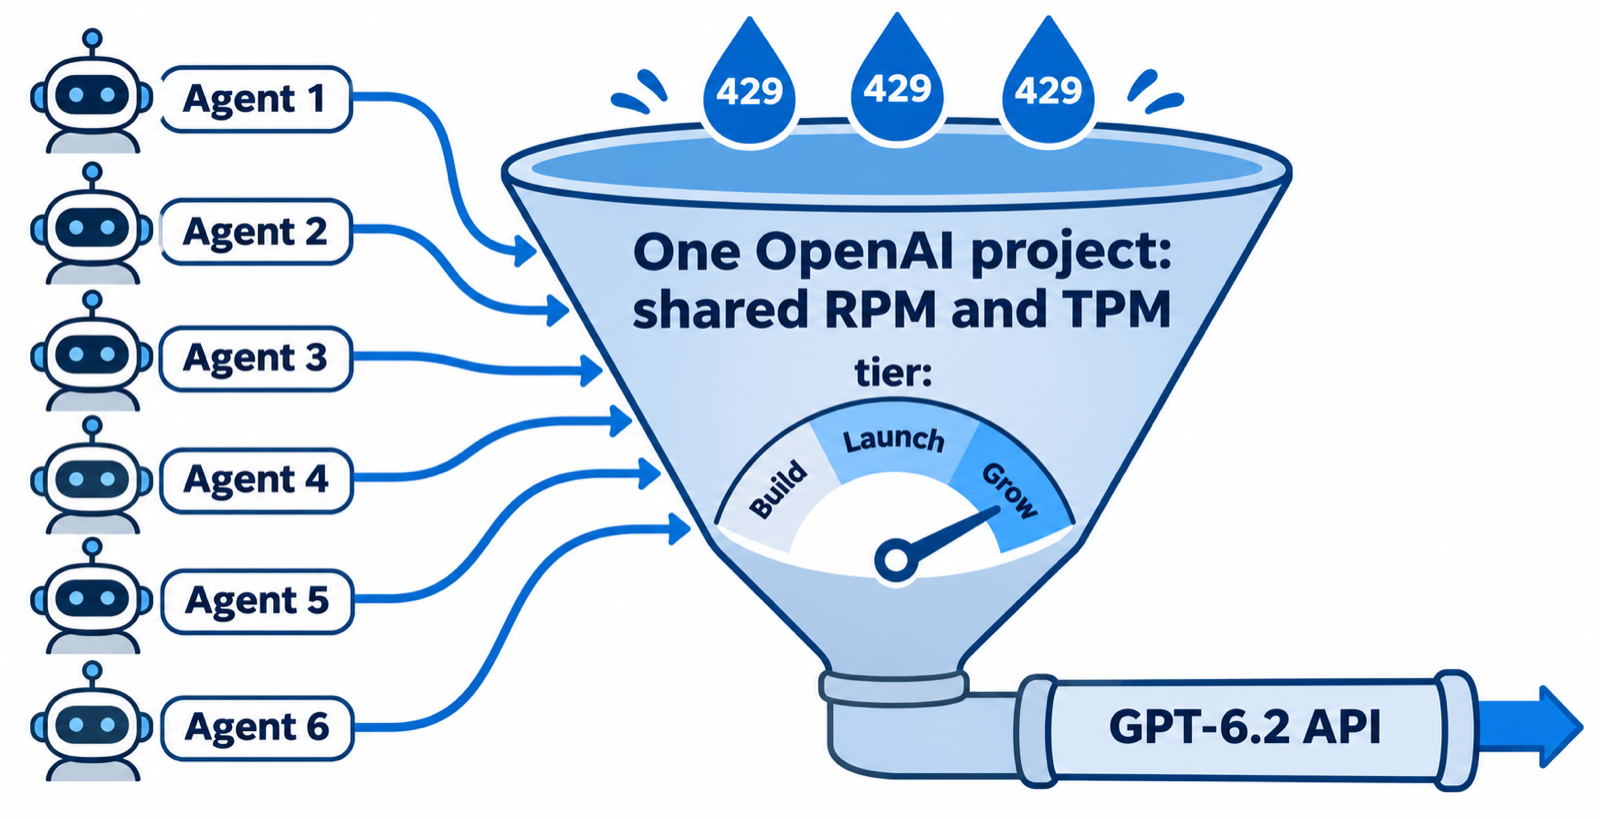
A OpenAI define limites de taxa no nível de organização e de projeto, não por usuário. Todo agente que usa chaves de um mesmo projeto tira do mesmo pool. Algumas famílias de modelos também têm um limite compartilhado listado na sua página de limites, então o tráfego para um modelo pode contar contra outro.
Como dimensionar a concorrência de agentes para o seu tier do GPT-6.2
A solução é limitar quantos agentes rodam ao mesmo tempo, para que o trabalho extra espere em uma fila em vez de colidir na API. Esta é a ordem que funciona:
- Descubra seu tier em Settings, Organization, Limits na plataforma da OpenAI.
- Meça uma execução real de um agente. Anote os tokens de entrada por turno e os turnos por minuto na saída de uso do seu Runtime.
- Divida seu TPM pelo TPM de um agente e mantenha 30% de margem para picos.
- Defina esse número como seu teto de concorrência para todos os agentes que usam o projeto.
- Fique de olho em erros 429 por uma semana, depois aumente o teto um passo de cada vez.
No Sharkly, cada Agent tem uma configuração de Max concurrency (assigned tasks), um Max run duration em minutos e um Queue timeout em horas. Quando o teto está cheio, novas tarefas ficam no estado Queued até que uma vaga se libere. Chats podem compartilhar o mesmo limite, então uma conversa não passa por ele despercebida.

Um Computer também tem seu próprio limite de concorrência de tarefas. A documentação do Sharkly observa que uma concorrência maior usa mais CPU, memória, disco, capacidade do provedor e banda do repositório, então aumente-a apenas quando a carga atual rodar sem problemas.
Divida os agentes entre projetos OpenAI
Os limites no nível de projeto permitem separar grupos de agentes. Dê aos seus agentes de revisão um projeto OpenAI e aos seus agentes de refatoração em massa outro. Uma refatoração descontrolada então atinge o limite do próprio projeto em vez de deixar a revisão sem recursos. O limite da organização ainda limita o total, então isso define prioridade; não adiciona capacidade.
Para um Runtime que se autentica com uma chave de API, defina a chave como variável de ambiente no Agent. O Sharkly injeta as variáveis de ambiente do Agent no processo do agente quando ele inicia. Dê a cada grupo de agentes uma chave do próprio projeto OpenAI dele, para que o tráfego caia no limite correto.
Monitore tokens por tarefa
O cabeçalho do Agent no Sharkly mostra tarefas atribuídas, total de execuções e tokens usados. Leia tokens por tarefa, não apenas o total mensal. Um tipo de tarefa que queima três vezes os tokens dos outros é seu primeiro candidato ao Sol em vez do Astra, ou para uma descrição de tarefa mais enxuta.
Mova o trabalho em massa para fora do horário de pico
As configurações de Runtime de cada Agent incluem uma chave Working hours para agendar trabalho fora do horário de pico. Aponte-a para geração de testes, atualizações de dependências e revisões de documentação. Essas tarefas rodam durante a noite e deixam a capacidade diurna para o trabalho que as pessoas estão esperando.
Como lidar com um erro 429 do GPT-6.2
Mesmo com um teto, você verá um 429 ocasional. O guia da OpenAI é específico sobre o que fazer:
- Siga o cabeçalho
Retry-Afterquando ele estiver presente, e trate-o como um mínimo. - Sem ele, use backoff exponencial com jitter aleatório.
- Leia
x-ratelimit-remaining-tokensex-ratelimit-reset-tokenspara ver quão perto você está. - Não aninhe retentativas: se seu código faz retry, desative os retries do próprio SDK, ou os dois se multiplicarão.
- Não repita erros de cota ou faturamento. Eles precisam de uma pessoa.
Um 503 com server_is_overloaded significa que o modelo está ocupado, não você. Trate-o com o mesmo backoff.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra ou Sol: qual modelo estica mais seus limites
Os limites de taxa são idênticos, então a escolha depende do uso de tokens e do preço. Use o Astra para mudanças de arquitetura, bugs difíceis e execuções autônomas longas. Use o Sol para tudo que é rotina. No Codex no plano Plus, o Sol rende cerca de três vezes mais mensagens por janela de cinco horas que o Astra, o sinal mais claro da diferença de custo.
Uma equipe mista é a resposta usual: um agente Astra lidera, vários agentes Sol fazem as partes, como em GPT-6 Astra as your Crew leader. O trabalho rotineiro pertence a um modelo mais barato — a lógica por trás do GPT-6 Luna para os 80% chatos.
Outras formas de obter mais throughput no GPT-6.2
- Batch API. Roda fora dos seus limites de taxa síncronos e custa 50% das tarifas padrão. Boa para evals e classificação em massa; errada para um agente interativo.
- Modo background com janela de
2hou8h. Conta contra um limite de fila Batch/Background separado em vez do seu TPM em tempo real. - Prompt caching. Entrada em cache custa $0,40 por milhão no Astra e $0,10 no Sol — uma economia grande para agentes que reenviam o mesmo contexto.
Conclusão
Os limites de taxa do GPT-6.2 são generosos por requisição e apertados por token. Para uma equipe de agentes, o limite de trabalho é o TPM do seu tier dividido pelo que um agente queima, compartilhado por todos os agentes do projeto. Meça uma execução, limite a concorrência abaixo desse número, separe os grupos barulhentos de agentes em seus próprios projetos e deixe a fila absorver o resto.
Você pode construir isso com scripts e um semáforo, ou configurar por Agent no Sharkly. Conecte um Computer, crie um Agent no Codex com GPT-6.2 Sol, defina a concorrência máxima dele como 2 e atribua algo chato. Mais sobre executar agentes lado a lado em How to run 10 AI coding agents at once.
FAQ
Quais são os limites de taxa do GPT-6.2?
Na API, o GPT-6.2 Astra e o Sol compartilham os mesmos limites: 5.000 RPM e 1.000.000 TPM no Build, 10.000 RPM e 4.000.000 TPM no Launch, e 15.000 RPM e 40.000.000 TPM no Grow.
O GPT-6.2 Astra tem limites de taxa menores que o Sol?
Não. A OpenAI lista o mesmo RPM e TPM para ambos os modelos em todos os tiers. O Astra custa mais por token, então ele atinge seu orçamento mais rápido, não seu limite de taxa.
Como mudar para um tier de uso mais alto da OpenAI?
Os tiers são atualizados automaticamente conforme as compras totais de crédito: $5 para o Build, $100 para o Launch, $500 para o Grow.
Os limites de taxa são por chave de API ou por organização?
Por organização e por projeto. Toda chave de um projeto tira do mesmo pool, então dez agentes em dez chaves em um mesmo projeto ainda compartilham um único limite.
Quantas mensagens de GPT-6.2 Astra eu tenho no Codex?
No Plus e no Business Standard, a OpenAI estima de 6 a 50 mensagens locais por janela de cinco horas para o GPT-6.2 Astra e de 17 a 180 para o Sol. Os planos Pro atualmente não têm limite de cinco horas, embora limites semanais possam se aplicar.
Por que meus agentes recebem erros 429 quando o RPM parece normal?
Agentes enviam contextos grandes, então esgotam os tokens por minuto muito antes das requisições por minuto. Verifique x-ratelimit-remaining-tokens nos cabeçalhos da resposta.
O Sharkly adiciona seus próprios limites de modelo?
Não. O Sharkly executa os agentes de código que você já usa, e a cota do modelo depende das ferramentas, planos e contas de API que sua equipe conecta. O Sharkly controla quantas tarefas cada Agent executa ao mesmo tempo.