

Você dispara três runs antes do almoço. Noventa segundos depois, dois dos três terminais não imprimiram absolutamente nada. Um deles está raciocinando sobre o repositório. O outro tomou um 504 na saída e não volta mais. Do lugar onde você está, os dois são o mesmo retângulo de scrollback com um cursor piscando.
Isso não é um problema novo, mas os lançamentos de 2026-09-22 o tornaram pior de um jeito específico e mensurável. As configurações de raciocínio mais altas dos novos modelos compram precisão pensando por muito tempo antes de dizer qualquer coisa. A Artificial Analysis mediu a variante de raciocínio “max” do GPT-6 Sol em 102,15 segundos até o primeiro token, e o GPT-6 Luna em 124,23 segundos. São medições de terceiros em uma configuração específica, não números dos fornecedores, e essa ressalva importa, mas a direção não está em dúvida: o silêncio no início de um run agora é longo o suficiente para ser indistinguível de uma falha.
TL;DR
Tempo até o primeiro token é o intervalo entre enviar uma requisição e o primeiro caractere da resposta chegar e, em um modelo de raciocínio de alto esforço, é nesse intervalo que acontece a maior parte do pensamento. Um terminal não consegue te dizer a diferença entre um run que está pensando, um run que está esperando uma pessoa e um run que morreu há dois minutos, porque os três não imprimem nada. Um status consegue. Agentes pesquisam, executam, testam e reportam. Pessoas definem a direção, concedem autoridade e aceitam o resultado. O que esse contrato precisa para funcionar é de um estado do run visível sem que alguém precise ficar vigiando: o Sharkly mantém contexto, progresso, bloqueios, resultados e revisão humana na Task, da requisição até a entrega, para que um pensamento longo e um run morto parem de se parecer.
A espera ficou maior, e o modelo barato não é o rápido
Veja o que as medições de terceiros dizem sobre os dois novos modelos GPT-6 na configuração máxima de raciocínio.
| Modelo | ID da API | Velocidade de saída | Tempo até o primeiro token | Entrada / saída por 1M de tokens |
|---|---|---|---|---|
| GPT-6 Sol (max) | gpt-6-sol |
115,2 tokens/s | 102,15s | $2 / $10 |
| GPT-6 Luna (max) | gpt-6-luna |
153,9 tokens/s | 124,23s | $0,10 / $0,50 |
Leia as duas últimas colunas juntas. O Luna custa um vigésimo do Sol por token e te faz esperar mais antes de falar. Custo e latência são eixos separados, e a intuição de que um modelo mais barato é um modelo mais ágil simplesmente não se aplica aqui.
Duas ressalvas honestas antes de alguém montar um dashboard com esses números. Primeiro, eles vêm da Artificial Analysis e não da OpenAI, e descrevem especificamente as variantes de raciocínio “max”. As configurações de esforço mais baixo são outra história, e seus próprios números vão variar com o tamanho do prompt, a disponibilidade de ferramentas e onde seu tráfego cai. Segundo, o tempo até o primeiro token não é a mesma medição que a velocidade de saída. A Anthropic diz que o Claude Opus 5.5 gera saída cerca de 30% mais rápido que o Opus 5, o que é uma afirmação sobre os tokens depois do primeiro. Um modelo pode fazer streaming rápido e ainda assim te deixar encarando o nada por um minuto e meio.
Um terminal silencioso não é um status
O silêncio em um terminal tem pelo menos quatro causas, e o terminal mostra todas elas da mesma forma:
- O Runtime está trabalhando. O raciocínio está acontecendo, ainda não há saída.
- O run terminou há um tempo e está esperando uma pessoa responder a uma pergunta.
- A requisição falhou. A documentação do Sharkly é direta sobre como é fácil interpretar isso errado: “Timeout / 408 / 504 significa que a requisição estava lenta, foi cancelada ou atrasou em um gateway. Isso não é o mesmo que o Computer estar offline.”
- O Computer realmente sumiu, ou o diretório de que o run precisava nunca ficou livre.
Um agente, um terminal, e você resolve isso esperando mais um minuto. Cinco agentes em três repositórios e dois Computers, e você resolve isso alternando entre janelas e chutando. Essa é a forma comum do caos de agentes: não uma falha dramática, apenas um time gastando a atenção na pergunta “esse aqui está vivo?” várias vezes por hora.
O reflexo a que as pessoas recorrem é matar e rodar de novo. Com esforço de raciocínio alto, esse reflexo custa caro em dobro. Você paga toda a espera pelo primeiro token outra vez e joga fora o raciocínio que estava prestes a chegar.
O que um status precisa distinguir
O modelo do próprio Sharkly vale ser copiado, use você Sharkly ou não, porque ele separa duas coisas que um terminal funde. É a mesma divisão que faz com que estado do run, logs e sinais de falha sejam legíveis. Um run tem um estado de execução: Queued, Dispatched, Waiting for local directory, Running, Completed, Failed ou Canceled. Uma Task tem um status de ciclo de vida, e um Agent tem um estado de trabalho por cima disso: Working, Waiting for human reply, Waiting for human review ou Error. A documentação define a fronteira sem rodeios: esses estados de run “não implicam automaticamente que a Task tenha o mesmo status de workflow”.
Essa divisão é a resposta inteira para a pergunta travado ou pensando.
| O que o terminal mostra | O que pode ser de fato | O que distingue | Quem age em seguida |
|---|---|---|---|
| Nada, 100s depois | Running, antes do primeiro token | O estado do run é Running, o log tem um timestamp de dispatch | Ninguém. Deixe como está. |
| Nada, 10 min depois | Waiting for human reply | O estado de trabalho mudou, a Task gera um item de atenção na Inbox | O Assignee responde em contexto |
| Nada, para sempre | Failed | O estado do run é Failed, o log de execução traz o título e a resposta original do serviço de modelo | O Assignee lê o log antes de tentar de novo |
| Nada, nunca começou | Queued ou Waiting for local directory | O estado do run, além de qual pool de diretórios está ocupado | Libere um diretório ou aumente a capacidade paralela |
Nenhuma dessas quatro linhas exige que alguém esteja olhando no momento em que muda. Essa é a ideia. O estado fica registrado, e a pergunta “está pensando ou está travado?” passa a ser algo que você consulta em vez de algo que você aguenta sentado.
O timeout por Task que você configurou em março
Um Agent no Sharkly carrega um número máximo de Tasks rodando em paralelo e um timeout por Task. A maioria dos times define esse timeout uma vez, no começo, com base em quanto tempo estavam dispostos a encarar um terminal. Se esse número é dois minutos e desde então você colocou um Agent em uma configuração de raciocínio max, você configurou uma política que cancela runs durante a fase de pensamento e os reporta como falhas.
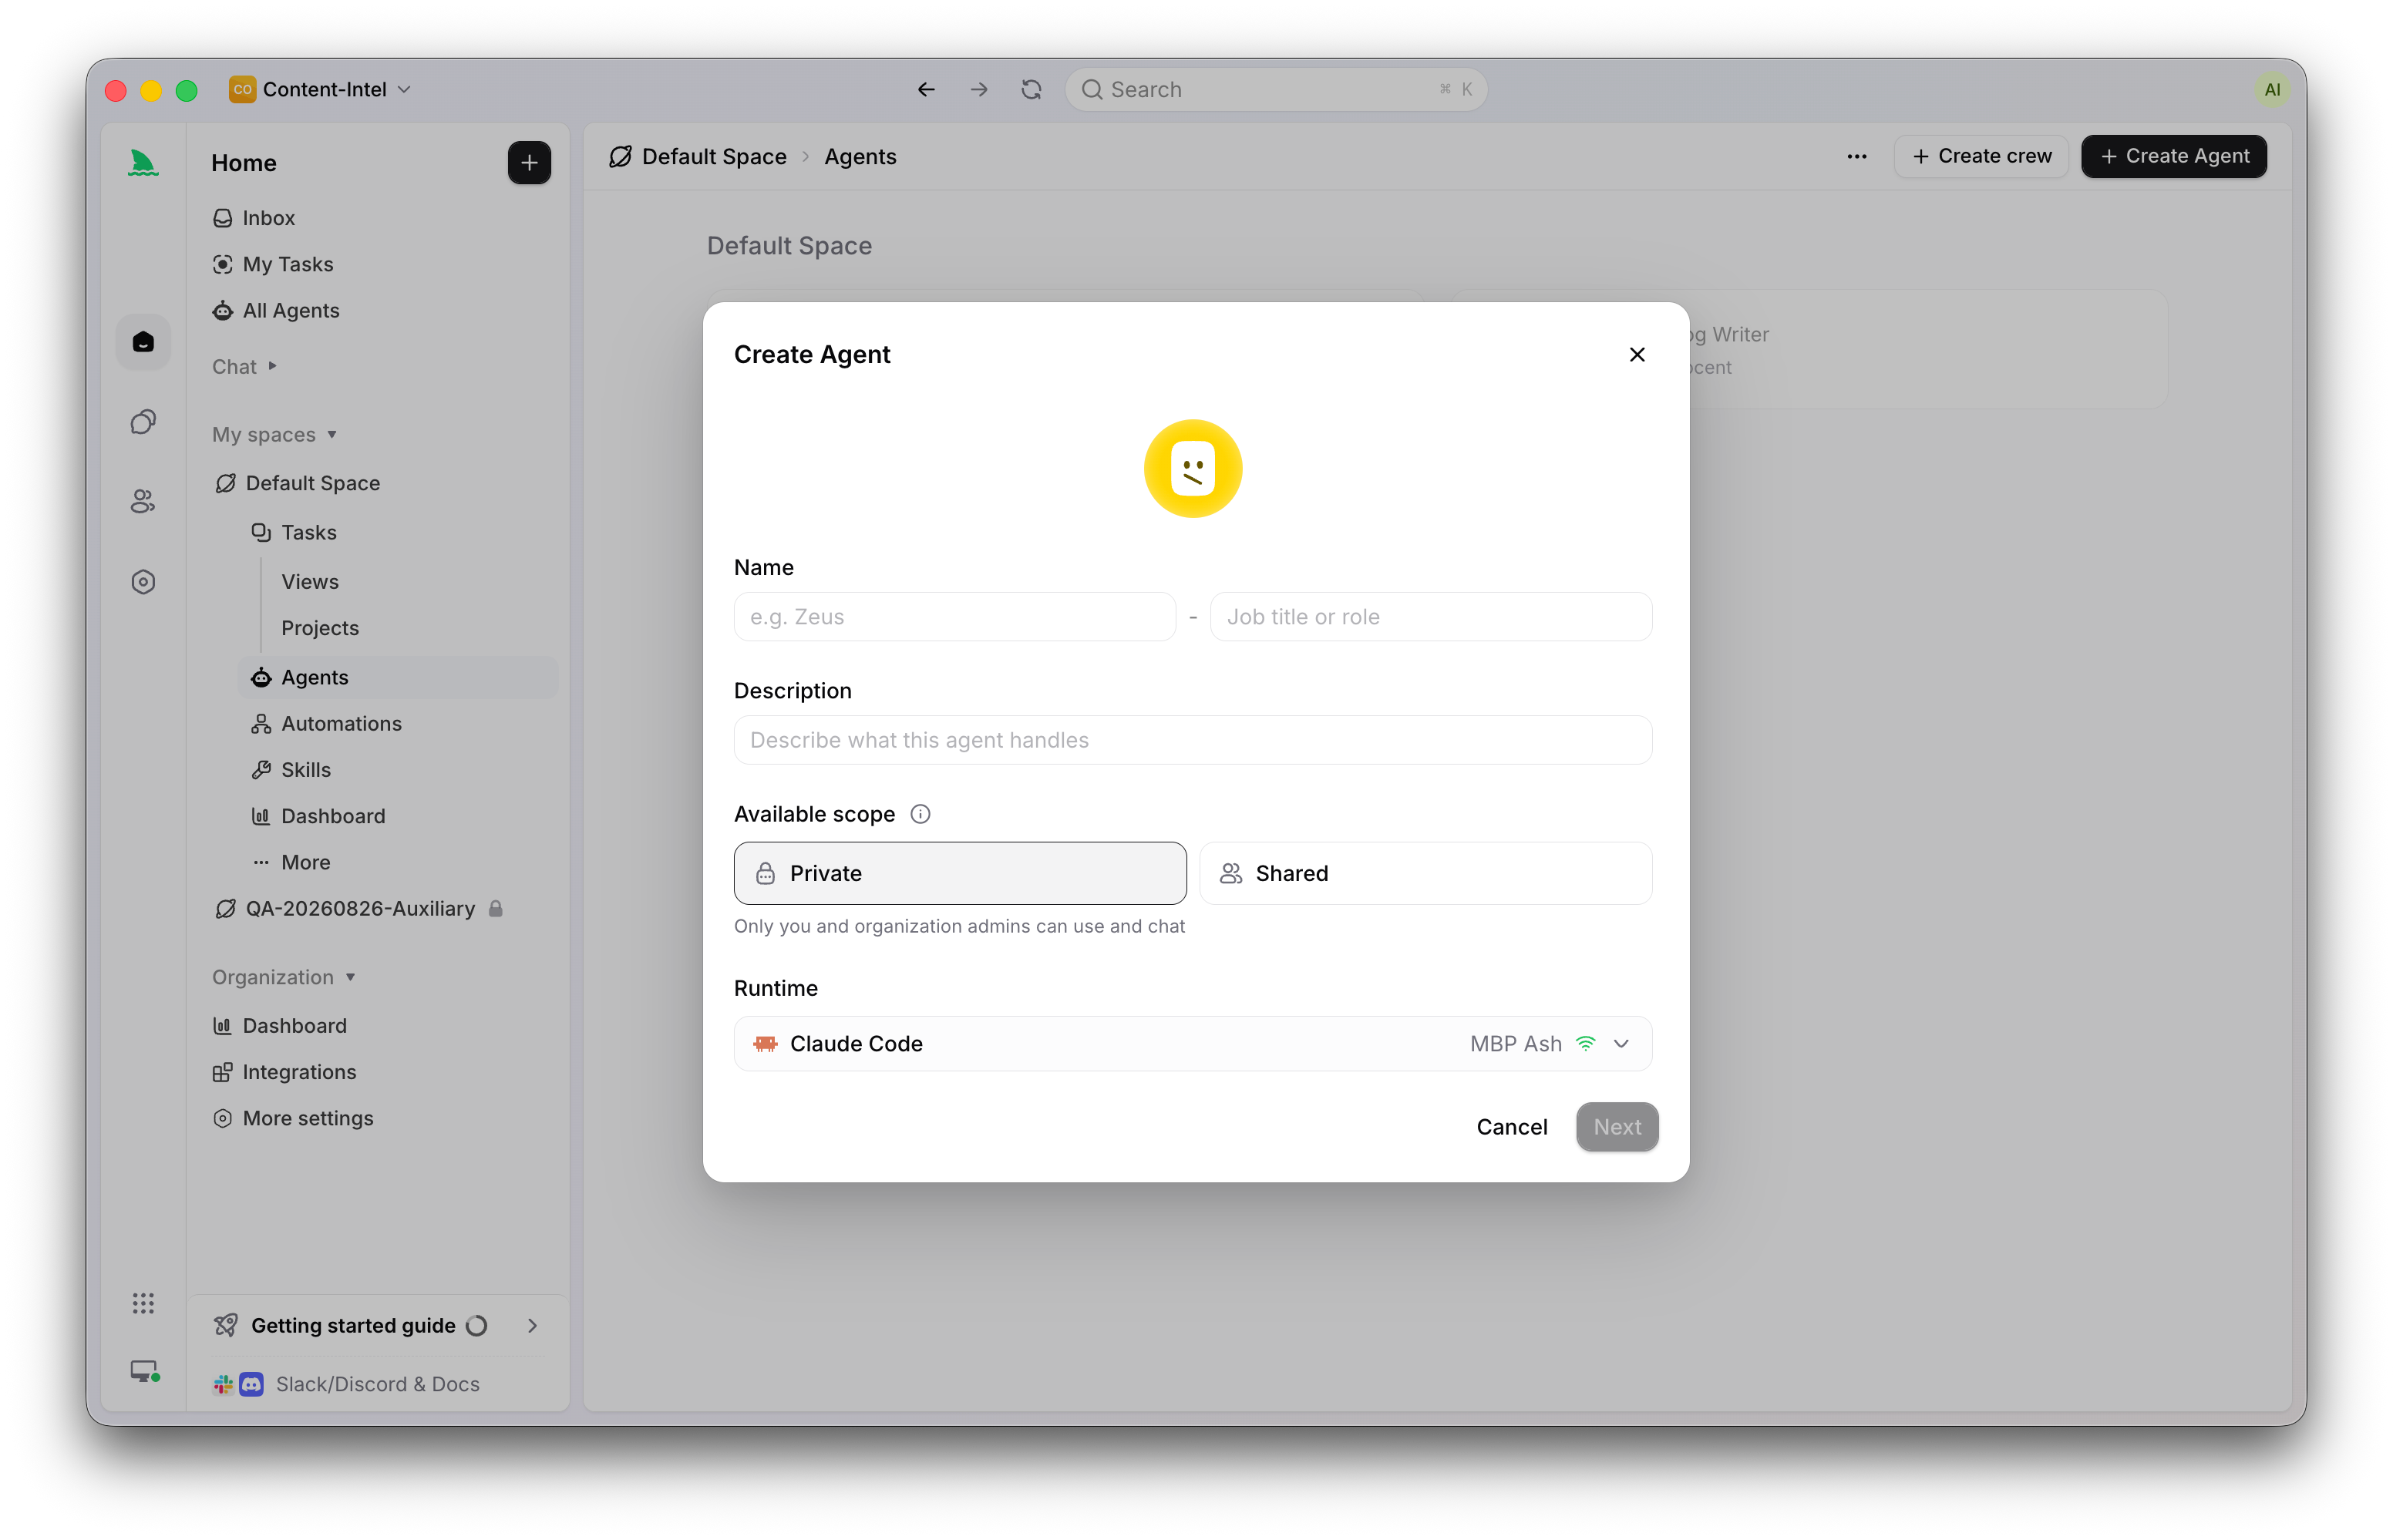
Vá olhar o seu esta semana. O piso não é “quanto tempo estou disposto a esperar”, é “quanto tempo este Runtime leva no nível de esforço que eu realmente uso, mais o trabalho em si”. Para um run cujo primeiro token sozinho pode levar mais de cem segundos, um timeout abaixo de cinco minutos é uma moeda jogada para o alto vestida de política.
Duas configurações relacionadas merecem a mesma revisão. O máximo de Tasks rodando em paralelo é o seu limite real de concorrência e, quando todos os diretórios configurados estão ocupados, novos runs ficam em Waiting for local directory em vez de falhar, o que é o comportamento correto, mas parece um travamento se você só está olhando um terminal.
O cache resolve isso?
Em parte, e não na parte que você quer. O cache de prompt da OpenAI para o GPT-6 dá 90% de desconto nas leituras de entrada em cache, com taxas de acerto maiores por padrão, adiciona breakpoints explícitos para você escolher onde termina um prefixo em cache e não invalida mais o cache quando você muda o esforço de raciocínio ou a disponibilidade de ferramentas. O GitHub relata mais de 50% menos tokens de prompt precisando de processamento novo em bilhões de requisições. É um ganho real de custo e latência no prompt, e a correção da mudança de esforço é genuinamente útil para agentes que escalam uma tarefa de uma configuração barata para uma cara no meio do fluxo.
Mas isso não elimina a passada de raciocínio. Um cache quente significa que menos do seu prompt é processado do zero. Não significa que o modelo já pensou sobre o seu bug. De qualquer forma, inclua a espera no orçamento.
Quando vale pagar a espera e quando não vale
Use a configuração máxima de raciocínio quando a tarefa for daquelas que você não quer rodar duas vezes: uma migração, um refactor transversal, qualquer coisa em que uma resposta errada custe mais que noventa segundos. A OpenAI reporta o Sol na configuração xhigh com 33,2% no AutomationBench 1.0.6 a US$ 0,27 por tarefa, que é o formato dessa troca. Precisão está barata em dinheiro agora e cara em tempo de relógio.
Use uma configuração de esforço menor quando tiver uma pessoa sentada ali esperando a resposta. Trabalho interativo, uma pergunta rápida sobre um arquivo, uma pequena correção bem delimitada: o problema do silêncio praticamente desaparece com esforço menor, porque o primeiro token aparece enquanto você ainda lembra o que perguntou.
E a fronteira honesta: se você está rodando um agente em uma Task, não precisa de um board para isso. Dê tail no log. O problema de estado começa no ponto em que o número de runs passa do número de terminais que você consegue acompanhar de verdade, o que, para a maioria das pessoas, é por volta de três.
O que isso não resolve
Um status te diz que um run está Working. Não te diz que o run está fazendo algo útil, e um agente confiantemente errado mostra o mesmo estado verde que um bom agente durante todo o tempo em que o run durar, o que, no Opus 5.5, pode ser 18 horas ou mais. Distinguir “rodando” de “rodando bem” continua sendo um problema de revisão, e revisão continua sendo trabalho de gente. A automação para onde o julgamento do time é necessário.
Se você já roda vários agentes ao mesmo tempo, a menor mudança útil para esta semana não é um modelo novo. É tornar o estado de cada run legível sem abrir um terminal, para que os próximos noventa segundos de silêncio sejam informação em vez de uma pergunta.

