Anthropic เปิดตัว Claude Haiku 5.5 เมื่อวันที่ 7 ตุลาคม ในราคา 0.10 ดอลลาร์ต่อ 1 ล้าน input token และ 0.50 ดอลลาร์ต่อ 1 ล้าน output token สำหรับ prompt ที่มีความยาวไม่เกิน 100K token และปรับขึ้นเป็น 0.50 ดอลลาร์ / 2.50 ดอลลาร์ทันทีเมื่อ prompt มีขนาดเกิน 100K token หากไม่เกินเกณฑ์ดังกล่าว ราคาจะเท่ากับ GPT-6 Luna พอดี และบทความเปิดตัวของ Anthropic ก็ได้ระบุบทบาทการใช้งานไว้อย่างชัดเจน ได้แก่ การสรุปเนื้อหา, การบีบอัดข้อมูล (compaction), การคิวรีฐานข้อมูล, การจำแนกประเภท (classification), การใช้งานเบราว์เซอร์ รวมถึงการทำงานเป็น subagent ภายใต้ Opus 5.5 หรือ Sonnet 5.5 สำหรับทีมที่รัน coding agent หลายตัว นี่ถือเป็นเลนประหยัดต้นทุน (cheap lane) ที่ทำงานร่วมกับ Claude Code บนบอร์ดงานเดียวกันกับระบบส่วนอื่นๆ
แต่มีจุดที่ต้องระวังอยู่สองประเด็น alias haiku ของ Claude Code จะชี้ไปที่ Haiku 5.5 เมื่อใช้ผ่าน Anthropic API เท่านั้น แต่บน Bedrock, Google Cloud, Microsoft Foundry และ Claude Platform on AWS ยังคงหมายถึง Haiku 4.5 นอกจากนี้ ราคายังไม่ได้คงที่เพียงระดับเดียว เซสชันของ Claude Code มีการสะสม context เพิ่มขึ้นเรื่อยๆ และ Claude Code จะทำ auto-compact สำหรับ Haiku 5.5 ก็ต่อเมื่อ context พุ่งไปถึงประมาณ 967K token ดังนั้นการทำงานที่รันต่อเนื่องยาวนานอาจใช้เวลาส่วนใหญ่ของรอบการทำงาน (turns) เกินขีดจำกัด 100K token ซึ่งคิดราคาแพงขึ้นถึง 5 เท่า เลนราคาประหยัดที่แอบแพงขึ้นอย่างเงียบๆ บนโมเดลที่ไม่มีใครมองเห็นได้จากหน้า Task คือความคลาดเคลื่อนที่บอร์ดบริหารงานมีไว้เพื่อตรวจจับ คู่มือนี้จะพาไปดูแนวทางที่สั้นและใช้งานได้จริงที่สุด: Computer หนึ่งเครื่อง, Agent เลนประหยัดหนึ่งตัว, และ Task จริงหนึ่งงาน
TL;DR
อัปเดต Claude Code บน Computer ให้เป็น v2.1.293 ขึ้นไป, ระบุเจาะจงเป็น claude-haiku-5-5 แทนที่จะใช้ alias haiku, และ rescan จนกว่า Claude Code Runtime จะแสดงสถานะ Available กำหนด Agent แยกต่างหากสำหรับเลนประหยัดนี้ พร้อมระบุชื่อโมเดลใน Custom arguments ของ Agent นั้น และจำกัดขอบเขตของแต่ละ Task ให้กระชับพอที่จะทำงานเสร็จก่อน prompt จะมีขนาดเกิน 100K token โดย Claude Code จะรัน Haiku 5.5 ที่ระดับ effort เป็น medium ตามค่าเริ่มต้น และไม่สามารถปิดการทำงานของโหมด thinking ได้ ทั้งนี้ Anthropic ระบุว่า Sonnet 5.5 และ Opus 5.5 ยังคงเป็นตัวเลือกที่เหมาะสมกว่าสำหรับการเขียนโค้ดผ่านเอเจนต์ที่มีความซับซ้อน (agentic coding) ดังนั้นบทบาทหัวหน้าทีม (lead) และผู้ตรวจสอบ (reviewer) จึงควรใช้โมเดลดังกล่าวต่อไป ตัว Agent มีหน้าที่ค้นคว้า ดำเนินการ ทดสอบ และรายงานผล ส่วนมนุษย์มีหน้าที่กำหนดทิศทาง มอบอำนาจการตัดสินใจ และอนุมัติผลงาน
การตั้งค่าโมเดลกำหนดไว้ที่จุดใด
Sharkly ไม่ได้เป็นผู้เลือกโมเดล และเอกสารคู่มือของ Agents ก็ได้ปรับเปลี่ยนวิธีที่คุณจะกำหนดโมเดลให้กับ Agent แล้ว โดยระบุว่า: “Agent จะอิงตามโมเดลเริ่มต้นของ Runtime และจะไม่การันตีหรือแสดงชื่อโมเดลเฉพาะเจาะจง หากต้องการเปลี่ยนโมเดล ให้ระบุใน Custom arguments ของ Agent หรือ Runtime” หรือคุณจะเปลี่ยนที่การกำหนดค่าเครื่องมือของ Runtime หรือ Computer แทนก็ได้ บน Agent จะไม่มีเมนูดรอปดาวน์สำหรับเลือกโมเดลแยกต่างหาก และไม่มีการควบคุมระดับความลึกของการคิด (thinking depth)
ประเด็นนี้มีความสำคัญต่อเลนประหยัดมากกว่าส่วนอื่นๆ คู่มือ Sonnet 5.5 ของเราได้ตั้งค่าโมเดลไว้ในการกำหนดค่าของ Claude Code บนเครื่องโฮสต์ ซึ่งทำให้การแยกหนึ่ง Computer ต่อหนึ่งระดับโมเดลกลายเป็นการตั้งค่าที่ตรงไปตรงมาที่สุด แต่เมื่อระบุชื่อโมเดลไว้ใน Custom arguments ของ Agent แล้ว Agent Haiku 5.5 และ Agent Opus 5.5 จะสามารถแชร์ Computer ร่วมกันเครื่องเดียวได้ โดยแต่ละตัวจะมีโมเดลระบุไว้ที่ตัว Agent เอง แทนที่จะอยู่ในไฟล์ config ที่ใครสักคนเข้ามาแก้ในวันทำงาน Agent มีหน้าที่กำหนดกระบวนการจัดการงาน, Computer ทำหน้าที่เป็นเครื่องโฮสต์, Runtime (ในที่นี้คือ Claude Code) ทำหน้าที่ดำเนินเซสชัน และ Task ยังคงเป็นบันทึกข้อมูลร่วมกันของทุกฝ่าย
ขั้นตอนที่ 1: กำหนด Haiku 5.5 ให้กับ Claude Code บน Computer
Haiku 5.5 ต้องใช้งานร่วมกับ Claude Code v2.1.293 ขึ้นไป ตามที่ระบุในเอกสารการกำหนดค่าโมเดล โดยคุณสามารถรันคำสั่ง claude update เพื่ออัปเดตได้ จากนั้นให้ลงชื่อเข้าใช้ด้วยแพ็กเกจแบบชำระเงินหรือ API key ที่มีสิทธิ์เข้าถึง ทั้งนี้ Claude Code ไม่มีให้บริการในแผน Claude Free และเครดิต API รายเดือนสำหรับสมาชิกระดับ Max และ Team ก็ไม่ครอบคลุมการใช้งาน Claude Code จึงไม่สามารถนำมาจ่ายค่า Runtime บน Computer ได้ หลังจากนั้นให้รัน claude --model claude-haiku-5-5 ในเทอร์มินัลทั่วไปบนโฮสต์เครื่องนั้น หากเซสชันเริ่มต้นทำงานได้สำเร็จ Sharkly ก็พร้อมใช้งานทันที
ให้ระบุไอดีเต็ม (full id) แทนการใช้ alias นี่คือสิ่งที่ alias haiku ถูกแมปไปใน Claude Code ณ ปัจจุบัน:
| แหล่งที่มาของโมเดลที่ Claude Code เรียกใช้ | ค่าที่ alias haiku ถูกแมปไป |
ค่าที่ควรระบุเจาะจงแทน |
|---|---|---|
| Anthropic API | Haiku 5.5 | claude-haiku-5-5 |
| Claude Platform on AWS | Haiku 4.5 | claude-haiku-5-5 |
| Amazon Bedrock | Haiku 4.5 | claude-haiku-5-5 |
| Google Cloud | Haiku 4.5 | claude-haiku-5-5 |
| Microsoft Foundry | Haiku 4.5 | claude-haiku-5-5 |
สำหรับ Bedrock และ Google Cloud นั้น Claude Code จะแมป id ดังกล่าวเข้ากับ model id ของผู้ให้บริการแต่ละราย ดังนั้น Computer ที่เข้าถึง Claude ผ่านคลาวด์โพรไวเดอร์แล้วเรียกใช้ haiku จะได้โมเดลรุ่นก่อนหน้าในราคาเดิม โดยที่บนหน้า Task จะไม่มีข้อความใดระบุบอกเลย
เมื่อกลับมาที่ Sharkly ให้เปิดหน้ารายละเอียดของ Computer แล้วกด rescan หรือทดสอบการเชื่อมต่อ (connection test) โดย Claude Code Runtime ควรแสดงสถานะเป็น Available การที่ Computer แสดงสถานะ online หมายถึงบริการในเครื่อง (local service) กำลังส่งสัญญาณ heartbeat เท่านั้น แต่สถานะของ Runtime ต่างหากที่เป็นตัวยืนยันว่าพร้อมเริ่มทำงานได้
ขั้นตอนที่ 2: สร้าง Agent สำหรับเลนประหยัดพร้อมกำหนดโมเดล
เปิดเมนู Agents เลือก New Agent จากนั้นเลือก Computer และ Claude Code Runtime แล้วตั้งชื่อตามหน้าที่ของเลนการทำงานมากกว่าชื่อโมเดล ในส่วน Custom arguments ให้ระบุโมเดลเป็น claude-haiku-5-5 ซึ่งเป็นค่าเดียวกับที่คุณทดสอบด้วย --model ในเทอร์มินัล กำหนด working directory เริ่มต้นเป็น Create temporary directory เพื่อให้แต่ละ Task ทำงานแยกขาดจากกันในไดเรกทอรีเฉพาะ และตั้งค่า timeout ต่อ Task ให้เหมาะกับงานที่มีขอบเขตแคบ หาก Haiku Agent รันนานถึงหนึ่งชั่วโมง นั่นเป็นสัญญาณเตือนว่าลักษณะของ Task อาจไม่เหมาะสม
พฤติกรรมของโมเดล 3 ประการเป็นตัวกำหนดการเขียน instruction ค่า Effort ใน Claude Code ถูกตั้งต้นไว้ที่ medium ซึ่งคู่มือ prompting ของ Anthropic แนะนำให้เป็นจุดเริ่มต้น “สำหรับงานเกือบทั้งหมด รวมถึง agentic coding” และควรเก็บ xhigh กับ max ไว้เฉพาะกรณีที่ผลการประเมิน (evals) แสดงให้เห็นถึงประสิทธิภาพที่ดีขึ้นจริง โหมด thinking ไม่สามารถปิดได้ใน Claude Code เมื่อใช้ Haiku 5.5 ดังนั้นการสั่งให้ Agent ตอบคำถามตรงๆ จึงไม่ได้ช่วยให้การรันประหยัดขึ้น นอกจากนี้ Haiku 5.5 ยังรันระบบตรวจสอบความปลอดภัย (safety classifier) ที่อาจปฏิเสธคำขอโดยไม่มี server-side fallback ซึ่งสำหรับทีมที่ย้ายมาจาก Haiku 4.5 การปฏิเสธคำขอเหล่านี้ถือเป็นเรื่องใหม่
เนื่องจาก Sharkly ไม่ได้แสดงชื่อโมเดล คำสั่ง (instruction) จึงระบุให้ Agent เขียนชื่อโมเดลลงใน Task:
You are the cheap lane. Take only the Task as written.
State the model id you ran on at the top of your report.
Read only the files the Task names, plus what you need to verify them.
If the work needs a broad codebase read, a design decision, or
changes across more than a few files, stop and say so in a comment
instead of continuing.
Run the closest relevant check before reporting done, and report
failures without hiding them.
If a refusal or safeguard notice appears, say so in your report.
Stop and ask before anything destructive or outside the attached
repositories.
ขั้นตอนที่ 3: ควบคุมการรันไม่ให้เกิน 100K token แล้วจึงมอบหมายหนึ่ง Task
ต่อไปนี้คือขั้นบันไดราคาจากเอกสารราคาของ Anthropic คิดต่อ 1 ล้าน token:
| Haiku 5.5 | Prompt ไม่เกิน 100K | Prompt เกิน 100K |
|---|---|---|
| Input | $0.10 | $0.50 |
| Output | $0.50 | $2.50 |
| Cache reads | $0.01 | $0.05 |
| 5-minute cache writes | $0.125 | $0.625 |
Anthropic ระบุว่า prompt ที่ไม่เกิน 100K นั้นคิดเป็นประมาณ 90% ของคำขอทั้งหมดที่ส่งไปยัง Haiku รุ่นก่อนหน้า ทว่าเซสชันของเอเจนต์ไม่ใช่คำขอตามปกติทั่วไป เพราะใน Claude Code นั้น prompt ของแต่ละเทิร์นจะรวบรวมประวัติของเซสชันที่ผ่านมาทั้งหมด และจะขยายใหญ่ขึ้นทุกครั้งที่มีการอ่านไฟล์หรือรับผลลัพธ์จากเครื่องมือ เอกสารระบุไว้อย่างตรงไปตรงมาว่า: “prompt ที่มีขนาดเกิน 100,000 tokens จะต้องจ่ายในราคาที่สูงขึ้น” และเมื่อฟังก์ชัน auto-compaction รอจนถึงประมาณ 967K การทำงานที่ข้ามขีดจำกัด 100K ไปแล้วจึงอาจค้างอยู่ในระดับราคานั้นไปตลอดทั้งเซสชัน
จึงนำมาสู่กฎการจัดเส้นทางงาน (routing rule) ที่สรุปเป็นคู่การตัดสินใจได้ดังนี้:
- ใช้ Haiku Agent เมื่อ Task ระบุชื่อไฟล์ชัดเจน ได้ผลลัพธ์ที่คนสามารถตรวจสอบได้ภายในหนึ่งนาที และเป็นประเภทงานที่ Anthropic วางตำแหน่งให้กับโมเดลนี้: การสรุปความ, การจำแนกประเภท, การค้นหาข้อมูล และการแก้ไขจุดผิดพลาดที่มีขอบเขตชัดเจน (scoped fix)
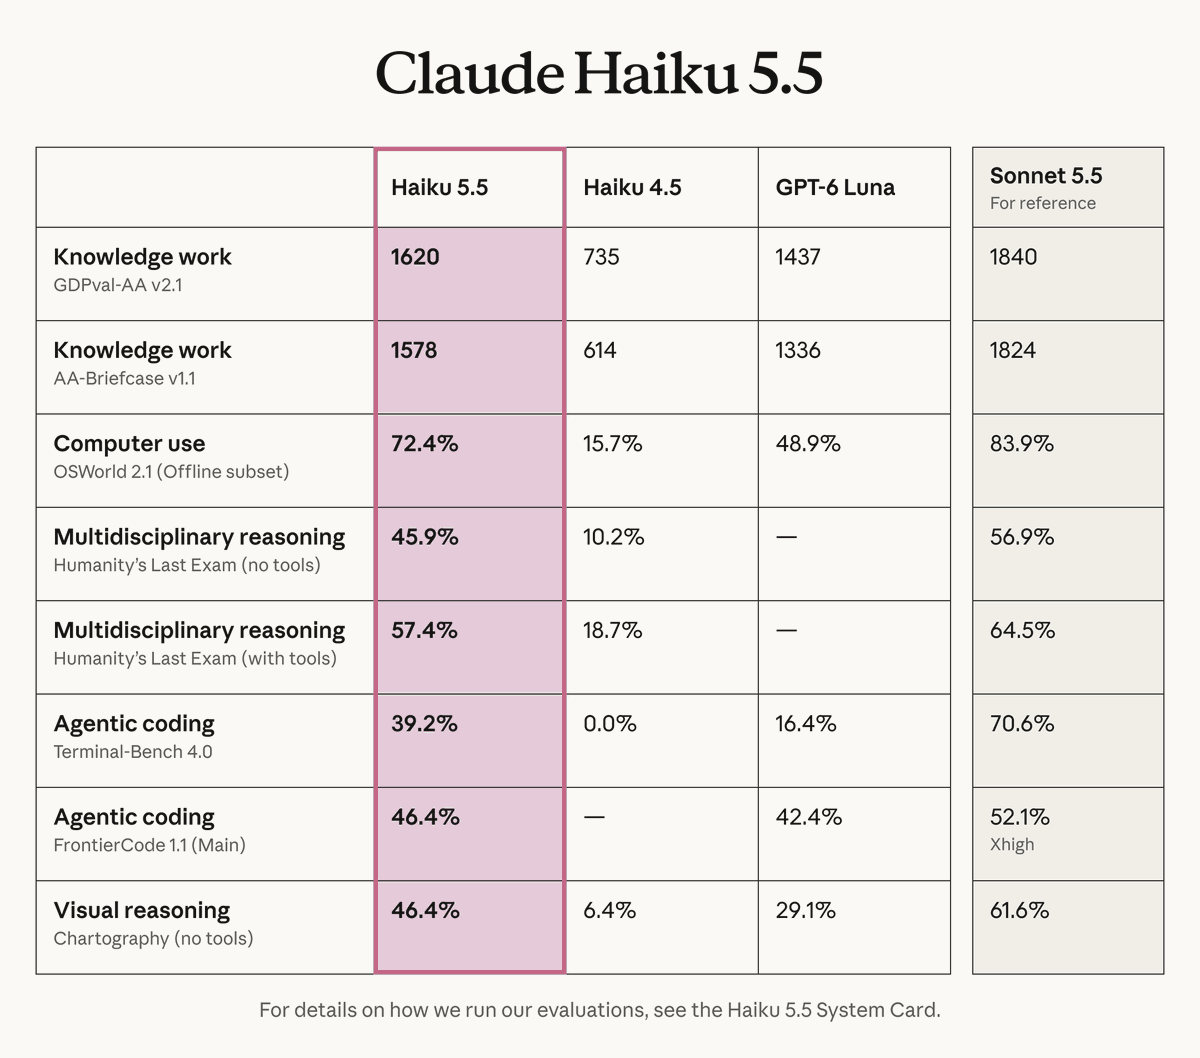
- ไม่ควรใช้ เมื่องานจำเป็นต้องอ่านโค้ดทั้ง repository ขนาดใหญ่, ต้องผ่านการแก้ไขบั๊กที่ยาวนาน (long debugging session), หรือต้องตัดสินใจในเรื่องที่ผู้ตรวจสอบจะต้องมานั่งแกะรอยย้อนหลัง เพราะการรันลักษณะนี้จะทำให้ token ทะลุเกณฑ์จนต้องจ่ายในอัตรา $0.50 / $2.50 ซึ่งเป็นงานที่ Anthropic แนะนำให้ส่งต่อไปยังโมเดลอื่น โดยผลคะแนนบน Terminal-Bench 4.0 แสดงให้เห็นว่า Haiku 5.5 ทำได้ 39.2% เมื่อเทียบกับ Sonnet 5.5 ที่ทำได้ 70.6% บทความ When cheap models cost more ได้อธิบายรายละเอียดการคำนวณส่วนที่เหลือเอาไว้ทั้งหมด
จากนั้นให้เลือก Task ที่มีเกณฑ์การยอมรับ (acceptance criterion) ชัดเจน เลือก Haiku Agent เป็น Assignee แล้วย้ายงานออกจาก Backlog (ซึ่งเป็นที่พักของ Task ที่มอบหมายแล้ว) ไปยังสถานะที่พร้อมสำหรับการทำงาน การรันจะเปลี่ยนสถานะตามลำดับจาก queued, dispatched ไปจนถึง running โดยบันทึกการทำงาน (execution log) ของ Task จะบันทึกการเรียกใช้เครื่องมือและเหตุการณ์ต่างๆ ของ Runtime เอาไว้ และหาก Agent หยุดทำงานเพื่อแจ้งว่า Task นั้นมีขอบเขตกว้างเกินไป ข้อซักถามนั้นจะถูกส่งกลับมาเป็นความคิดเห็นบน Task และส่งต่อไปยัง Inbox ซึ่งถือว่าเลนนี้ทำงานได้อย่างถูกต้องตามที่ออกแบบไว้
สิ่งที่ Haiku 5.5 เพิ่มเข้ามาให้กับเลนประหยัด
เหตุผลสนับสนุนการใช้เลนประหยัดได้ถูกนำเสนอไปแล้วในบทความ Luna for the boring 80 percent และ GPT-6 Luna in Sharkly รวมถึงกฎการจัดสรรโมเดลจากบทความ mixed-model Crews ที่ยังคงใช้ได้อยู่เสมอ นั่นคือ: สมาชิกทีมใช้โมเดลราคาถูก ส่วนหัวหน้าทีมและผู้ตรวจสอบใช้โมเดลราคาสูง แต่ Haiku 5.5 ได้สร้างความเปลี่ยนแปลงขึ้น 3 ประการ
มีผู้ให้บริการรายที่สองในระดับราคาเดียวกัน ในระดับที่ไม่เกิน 100K นั้น Haiku 5.5 และ Luna มีราคาเท่ากันพอดี แต่ทำงานอยู่บน Runtime คนละตัว นั่นคือ Claude Code และ Codex อีกทั้งเกณฑ์การปรับราคาก็แตกต่างกัน โดย OpenAI คิดราคา prompt ของ Luna ที่เกิน 272K input token เพิ่มขึ้น 2 เท่าสำหรับ input และ 1.5 เท่าสำหรับ output ในขณะที่ Haiku 5.5 ปรับราคาขึ้นถึง 5 เท่าตั้งแต่ 100K บทความ Haiku 5.5 vs GPT-6 Luna ได้เปรียบเทียบความแตกต่างของทั้งสองตัวในฐานะ Runtime ไว้อย่างละเอียด
สร้างขึ้นมาเพื่อทำหน้าที่เป็น subagent โดยเฉพาะ Anthropic และลูกค้ารายแรกๆ ที่เริ่มใช้งานอย่าง Rogo และ Cognition อธิบายถึงการทำงานของ Haiku 5.5 ว่าอยู่ภายใต้การควบคุมของโมเดลหลักที่มีขนาดใหญ่กว่า ซึ่งในการรัน Claude Code งานของ subagent ดังกล่าวจะไม่ปรากฏขึ้นบนบอร์ดในฐานะ Task ที่มีผู้รับผิดชอบแยกต่างหาก บทความ Subagent or its own Agent ได้ชี้ให้เห็นถึงความแตกต่างระหว่างทั้งสองรูปแบบนี้
ค่ารัน computer use ราคาถูก แต่ต้นทุนการตรวจสอบสูง รายงาน system card ของ Anthropic ระบุว่า Haiku 5.5 ได้คะแนน partial credit อยู่ที่ 72.4% ในชุดทดสอบย่อยของ OSWorld 2.1 แต่มีอัตราผ่านแบบเข้มงวด (strict pass rate) อยู่ที่ 37.1% เท่านั้น ทำให้การรันหลายครั้งเสร็จสิ้นเพียงบางส่วน บทความ Cheap browser agents ได้อธิบายถึงผลกระทบที่เกิดขึ้นกับคิวการรีวิวเอาไว้แล้ว
ทั้งหมดนี้ไม่มีค่าใช้จ่ายใดๆ ปรากฏในใบแจ้งหนี้ของ Sharkly เพราะการใช้งานโมเดลจะดำเนินการผ่านแพ็กเกจสมาชิกหรือ API key ที่กำหนดค่าไว้ในเครื่องมือเหล่านั้นโดยตรง ดังนั้นค่าบริการของ Haiku 5.5 ข้างต้นจึงเป็นการชำระให้กับ Anthropic หรือผู้ให้บริการคลาวด์ของคุณ
โมเดลอาจมีการเปลี่ยนแปลงในสัปดาห์นี้ แต่บริบท ความคืบหน้า ปัญหาที่ติดขัด ผลลัพธ์ และการตรวจสอบโดยมนุษย์ยังคงมองเห็นได้อย่างชัดเจนตั้งแต่ขั้นตอนคำขอไปจนถึงการปล่อยงาน คุณสามารถสร้างระบบนี้ขึ้นมาเองได้โดยใช้ worktrees หรือจะเลือกใช้ Sharkly เพื่อจัดการเวิร์กโฟลว์ทั้งหมดก็ได้