
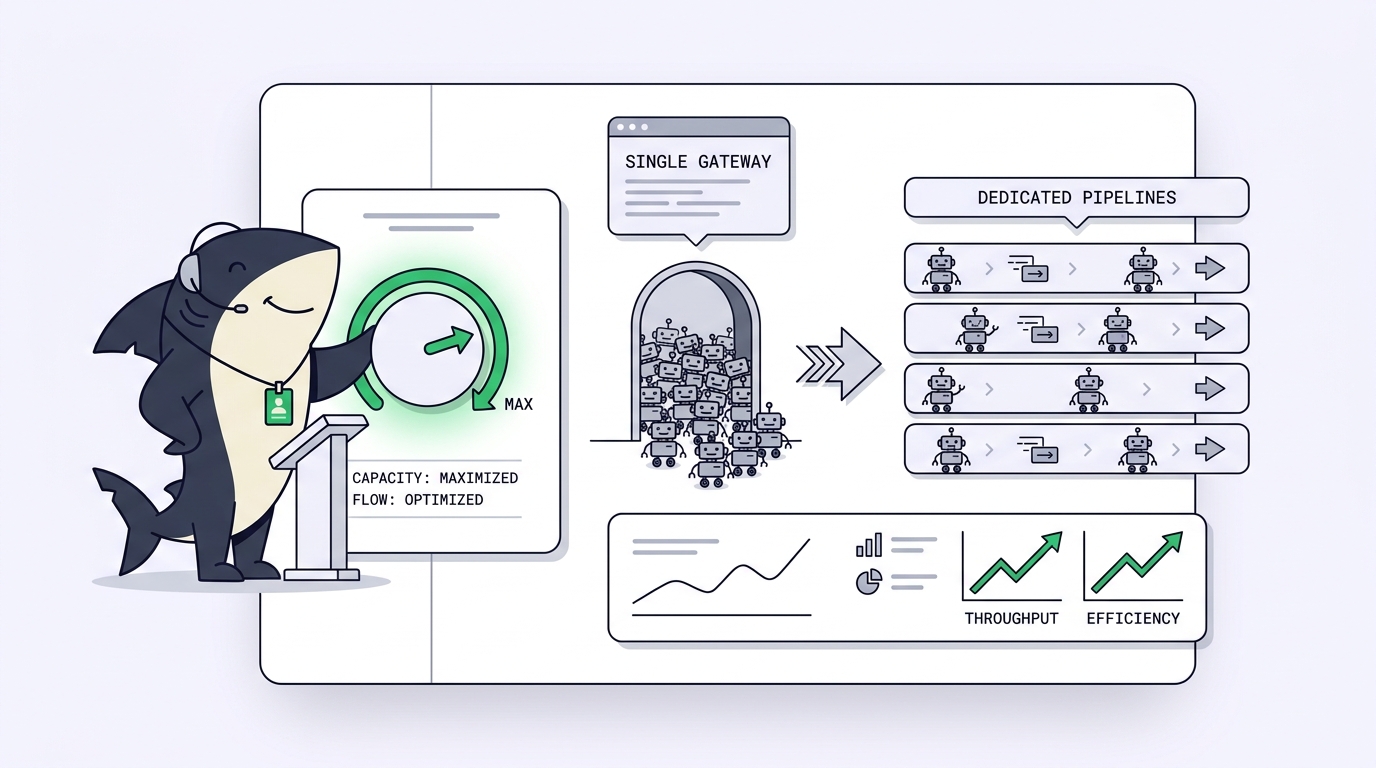
config snippet ตัวหนึ่งกำลังถูกแชร์กันทั่วในสัปดาห์นี้: ตั้งค่า agents.max_concurrent_threads_per_session = 64 ใน Codex config.toml ของคุณ แล้วดูเซสชันเดียวแตกออกเป็น subagent หลายสิบตัว โพสต์ที่เป็นจุดเริ่มต้นอ้างว่าค่า default คือ 3 และ OpenAI ทดสอบที่ 64 การตั้งค่านี้มีอยู่จริง แต่ตัวเลขทั้งสองไม่ได้อยู่ในเอกสาร official และส่วนที่น่าสนใจก็ไม่ใช่ตัวเพดานเลย สิ่งที่น่าสนใจคือสิ่งที่เกิดขึ้นกับงานเมื่อคุณเพิ่มมันขึ้นมา
โพสต์นี้จะอธิบายว่าการตั้งค่านี้ทำอะไรจริง ๆ ตามเอกสารอ้างอิงของ Codex และสามสิ่งที่พังตามลำดับเมื่อเซสชันเดียวรัน agent มากกว่าที่คนคนหนึ่งจะอ่านไหว
สรุปสั้น ๆ
agents.max_concurrent_threads_per_session เป็นตัวกำหนดเพดานว่า Codex จะเปิด thread ของ spawned agent ไว้พร้อมกันได้กี่ thread โดยไม่นับ primary thread เอกสารอ้างอิงไม่ได้ระบุค่า default ไว้ แต่บอกว่า Codex จะเลือก default ให้เองเมื่อไม่ตั้งค่า key นี้ subagent จะส่ง summary กลับไปยัง main thread ซึ่งจะรอทุกตัวแล้วตอบกลับเพียงครั้งเดียว และเอกสารแนะนำให้ใช้กับงานที่อ่านเป็นหลัก พร้อมเตือนว่า workflow ที่เขียนหนักแบบขนานจะสร้าง conflict และ overhead ในการประสานงาน การเพิ่มเพดานเป็น 64 จะกดดันสองจุดนี้พอดี: ไฟล์ที่ใช้ร่วมกัน และคำตอบรวมเพียงชุดเดียวที่ไม่มีใครตรวจสอบได้ Sharkly รัน Codex เป็น Runtime และยก parallelism ขึ้นไปอีกระดับ โดยแต่ละ run คือ Task ที่มี worktree ของตัวเอง มี log ของตัวเอง และมี reviewer ของตัวเอง
การตั้งค่านี้ทำอะไร
มีสาม key ในส่วน [agents] ของ config.toml ที่เกี่ยวข้องกับเรื่องนี้ ข้อความด้านล่างมาจากเอกสารอ้างอิงการตั้งค่า
| Key | สิ่งที่เอกสารอ้างอิงระบุ |
|---|---|
agents.max_concurrent_threads_per_session |
"จำนวน spawned-agent thread สูงสุดที่เปิดพร้อมกันได้ โดยไม่นับ primary thread เมื่อไม่ตั้งค่า Codex จะเลือก default ให้เอง" |
agents.max_threads |
"alias แบบเก่าของ agents.max_concurrent_threads_per_session" |
agents.enabled |
"เปิดหรือปิด multi-agent tools (default: true)" |
มีอีกสอง key ที่เกี่ยวข้อง คือ agents.default_subagent_model และ agents.default_subagent_reasoning_effort ซึ่งกำหนดว่า spawned agent จะรันด้วยอะไร เว้นแต่ตอน spawn จะระบุไว้เป็นอย่างอื่น
ดังนั้น snippet นี้ใช้ได้ตามที่เขียนไว้:
[agents]
max_concurrent_threads_per_session = 64
สิ่งที่เอกสารอ้างอิงไม่ได้บอกก็คือค่า default คือเท่าไร หรือมีค่าที่ถูกทดสอบจริงหรือไม่ ให้ถือว่า "default 3" และ "OpenAI tested 64" เป็นคำอ้างจากโพสต์หนึ่ง ไม่ใช่จากผู้ขาย จนกว่าเอกสารจะระบุเป็นอย่างอื่น
คู่มือ subagent เพิ่มสองประโยคที่ตัดสินได้ว่าการเพิ่มเพดานเป็นความคิดที่ดีหรือไม่ ในเรื่องผลลัพธ์: "เมื่อมี agent หลายตัวรันอยู่ Codex จะรอจนกว่าผลลัพธ์ที่ร้องขอมาครบทั้งหมด แล้วจึงคืนคำตอบแบบรวมชุดเดียว" ในเรื่องความเหมาะสม: subagent เหมาะกับ "งานที่อ่านเป็นหลัก เช่น การสำรวจโค้ด การทดสอบ การ triage และการสรุป" และคู่มือแนะนำให้ระวังกับ "workflow ที่เขียนหนักแบบขนาน เพราะ agent ที่แก้โค้ดพร้อมกันสามารถสร้าง conflict และเพิ่ม overhead ในการประสานงาน"
อ่านสองส่วนนี้รวมกัน แล้วลำดับความล้มเหลวก็เขียนออกมาได้เอง
สิ่งที่พังก่อน: shared checkout
subagent ในเซสชันเดียวกันจะใช้ working directory ของเซสชันร่วมกัน เว้นแต่คุณจะจัดแยกไว้เป็นอย่างอื่น นั่นก็โอเคสำหรับ agent หกสิบสี่ตัวที่อ่าน แต่กลายเป็นปัญหา merge สำหรับ agent สี่ตัวที่เขียน
ความล้มเหลวไม่ได้ดูน่าตื่นเต้นอะไร subagent สองตัวแก้ไฟล์เดียวกัน การเขียนครั้งที่สองชนะ และ summary รวมก็รายงานว่าทั้งสองงานเสร็จสมบูรณ์ คุณจะรู้ตัวตอน review ถ้ามี review หรือรู้ใน production ถ้าไม่มี คำเตือนของเอกสารเรื่อง conflict และ overhead ในการประสานงานก็กำลังพูดถึงเรื่องนี้แหละ
วิธีแก้คือวิธีที่ทุก setup ของ parallel agent ลงเอยเหมือนกัน: ใช้ working copy หนึ่งชุดต่อหนึ่งหน่วยงาน ใน Sharkly แต่ละ Task run จะได้ directory ที่แยกออกไป และงานที่ผูกกับ repository จะใช้ git worktree แยกต่อ run ซึ่งเป็นกลไกที่อธิบายไว้ใน parallel agents in isolated worktrees สิบ Task กับ repository เดียว ไม่มี state ร่วมกันเลย Runtime ที่แก้โค้ดยังเป็น Codex ได้ แต่การแยกนั้นถูกจัดไว้รอบ ๆ มัน
สิ่งที่พังเป็นอันดับสอง: คำตอบรวมชุดเดียว
Codex จะรอทุก subagent แล้วคืนคำตอบเดียว ที่ subagent สี่ตัวนั่นถือว่าสะดวก แต่ที่หกสิบสี่ตัว มันคือข้อความเดียวที่สรุปงานหกสิบสี่ชิ้น เขียนโดย agent ที่สั่งงานเหล่านั้น โดยที่ output ระหว่างทางถูกพับเก็บไป
นั่นเป็นรูปแบบที่ผิดสำหรับการ review reviewer ต้องรู้ว่าแต่ละหน่วยงานไปแตะอะไร รันอะไร และหยุดที่ตรงไหน และต้องสามารถรับหรือปฏิเสธแต่ละชิ้นแยกจากกันได้ summary ของ summary ไม่สามารถรับบางส่วนได้
Sharkly เก็บ final response ของ Agent ไว้บน Task และเก็บ execution log ต่อ run พร้อม trigger เวลาเริ่มและจบ tool call เหตุการณ์ใน Runtime และรายละเอียดความล้มเหลว Execution จะอยู่ในแท็บของตัวเอง แยกจาก timeline ของ comment หกสิบสี่หน่วยงานก็คือหกสิบสี่ Task พร้อมหกสิบสี่ log แต่ละอันตรวจสอบได้ แต่ละอันคืนผลลัพธ์ไปยังที่ที่คนจะไปดู
สิ่งที่พังเป็นอันดับสาม: human in the loop
เพดานไม่ได้บอกอะไรเลยว่าเกิดอะไรขึ้นเมื่อ subagent ต้องการคน ในเซสชันเดียว subagent ที่ถูกบล็อกก็คือ thread ที่เงียบไปในการรอแบบรวมชุดเดียว main thread ตอบแทนคุณไม่ได้ และคุณก็ไม่เห็นว่าหกสิบสี่ thread นั้นตัวไหนคือตัวที่หยุดไป
Sharkly แยกสถานะ Task กับ working state ของ Agent ออกจากกัน: Started Task แสดงได้ว่า Working, Waiting for human reply, Waiting for human review หรือ Error สัญญาณ Waiting และ failed จะไปโผล่ในส่วน Primary ของ Inbox ของคนที่รับผิดชอบ และการตอบกลับบน Task จะเริ่ม follow-up run ด้วย thread นั้นเป็น context ตัวที่ติดอยู่จะบอกคุณ แทนที่จะค้างอยู่ใน wait ที่คุณตรวจสอบไม่ได้
subagent หรือ Task? คู่ตัดสินใจ
ใช้ Codex subagent ในเซสชันเดียวเมื่องานอ่านเป็นหลักและลงเอยที่คำตอบเดียว: สำรวจ codebase, triage ชุด failure, สรุปชุดเอกสาร, รันชุด test นั่นคือสิ่งที่คู่มือแนะนำ และเพดานที่สูงขึ้นก็ราคาถูกเมื่อไม่มีอะไรเขียนเลย
ใช้แยก Task โดยแต่ละอันมอบให้ Agent บน Computer เมื่อหน่วยงานเขียนโค้ด เมื่อคนหลายคนจะ review คนละส่วน หรือเมื่ออาจมีคนต้องตอบระหว่าง run Sharkly ไม่ใช่ตัวแทนของ Codex; Codex คือ Runtime ที่รันแต่ละ Task ความต่างอยู่ที่ว่า parallelism อยู่ตรงไหน: ในการรอแบบรวมชุดเดียวของเซสชัน หรือข้ามบอร์ดที่ context, ความคืบหน้า, blocker, ผลลัพธ์ และ human review มองเห็นได้ตลอดตั้งแต่คำขอจนถึง release
เพิ่มเพดานอย่างปลอดภัย
ถ้าคุณจะเพิ่ม max_concurrent_threads_per_session จริง ให้ทำตามที่เอกสาร concurrency ของ Sharkly เองอธิบายสำหรับ Computer: เพิ่มก็ต่อเมื่อ setup ปัจจุบันรับ workload ที่มีอยู่ได้อย่างเสถียรแล้ว เพราะ concurrency ที่สูงขึ้นกิน CPU, memory, disk, capacity ของ provider และ bandwidth ของ repository มากขึ้น Computer ใน Sharkly มี task concurrency limit ของตัวเอง และ Agent ที่ใช้ temporary directory จะ default อยู่ที่ครึ่งหนึ่งของ limit นั้น Capacity ถูกจำกัดด้วย Computer, concurrency ของ Agent และความพร้อมของ directory และ Agent ที่ online ก็ยังมีงานค้างในคิวได้เมื่อ capacity เต็ม
Capacity ของ provider เป็นเรื่องที่คนมักลืม หกสิบสี่ thread กับ API key เดียวคือหกสิบสี่วิธีที่จะชน rate limit พร้อมกัน และ 429 ที่หมายถึง "quota หมด" ไม่ได้แก้ได้ด้วยการ retry log ของ run ที่ล้มเหลวของ Sharkly เก็บ response ต้นฉบับของ provider ไว้คู่กับ title แบบอ่านง่าย เพื่อให้เห็นความต่างก่อนที่ใครจะ retry
คำถามที่พบบ่อย
ค่า default ของ agents.max_concurrent_threads_per_session คือเท่าไร? เอกสารอ้างอิงการตั้งค่าไม่ได้ระบุไว้ แต่บอกว่า Codex จะเลือก default ให้เองเมื่อไม่ตั้งค่า key ตัวเลขที่แชร์กันบน social media ไม่ได้มาจากเอกสารอ้างอิง
การเพิ่มเพดานทำให้ Codex เร็วขึ้นไหม? สำหรับ fan-out ที่อ่านเป็นหลัก thread ที่มากขึ้นจบงานเร็วขึ้น สำหรับงานที่เขียนหนัก เอกสารเตือนว่าการแก้ไขพร้อมกันสร้าง conflict และ overhead ในการประสานงาน ซึ่งกินเวลามากกว่าที่ parallelism ประหยัดได้
Codex subagent รันใน git worktree แยกกันไหม? คู่มือ subagent ไม่ได้บอกว่าแยก ให้วางแผนเหมือนกับว่าใช้ working directory ร่วมกัน เว้นแต่คุณตั้ง isolation เองไว้แล้ว
Sharkly ใช้ Codex อย่างไร? ใช้เป็น Runtime Computer ที่รัน Codex จะรายงานว่าพร้อมใช้งาน และ Task ที่มอบให้ Agent บน Computer นั้นจะรันผ่านมัน โดยแต่ละ run อยู่ใน directory หรือ worktree ที่แยกออกไปของตัวเอง
ยังใช้ subagent ใน Sharkly Task ได้ไหม? ได้ ทุกอย่างที่ Runtime ทำเองได้ยังใช้ได้ใน run นั้น Sharkly เพิ่ม Task, isolation, log และ review เข้าไปรอบ ๆ มัน
เวอร์ชันสั้น
การตั้งค่านี้มีอยู่จริงและ snippet ก็ใช้ได้ สิ่งที่มันทำไม่ได้คือทำให้การแก้ไขพร้อมกันหกสิบสี่ชิ้นปลอดภัย ทำให้คำตอบรวมชุดเดียว review ได้ หรือบอกคุณว่า thread ไหนกำลังรอคุณอยู่ นั่นคือสามสิ่งที่พัง ตามลำดับนั้น เก็บ subagent ไว้สำหรับ fan-out ที่อ่านเป็นหลัก และวางงานขนานที่เขียนหนักไว้บนบอร์ดที่แต่ละ run มี worktree ของตัวเองและมี reviewer ของตัวเอง เชื่อม Computer หนึ่งเครื่องที่มี Codex อยู่ สร้าง Agent หนึ่งตัว แล้วมอบงานน่าเบื่อ ๆ ให้มัน เอกสารอธิบายแต่ละแนวคิดไว้ละเอียดกว่านี้: docs.sharkly.ai


