
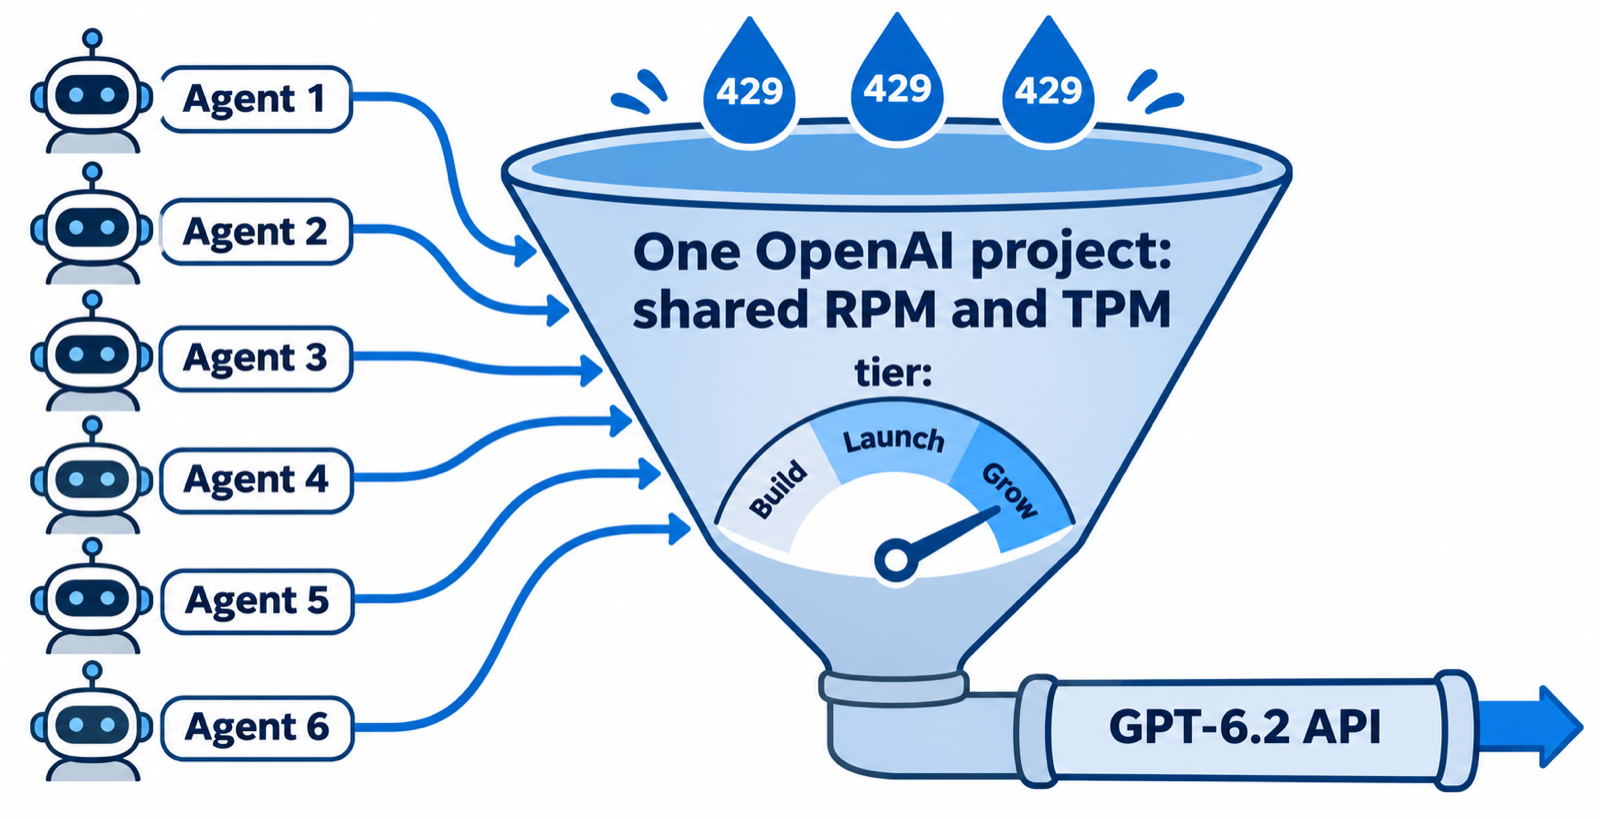
TL;DR: GPT-6.2 มีขีดจำกัดอัตราเท่ากันสำหรับทั้ง Astra และ Sol ใน API: 5,000 RPM และ 1,000,000 TPM ในระดับ Build, 10,000 RPM และ 4,000,000 TPM ใน Launch และ 15,000 RPM และ 40,000,000 TPM ใน Grow ขีดจำกัดนี้ใช้ต่อองค์กรและต่อโปรเจกต์ ดังนั้นเอเจนต์ทุกตัวที่ใช้คีย์เดียวกันจะแชร์โควตาร่วมกัน สำหรับทีมเอเจนต์ สิ่งที่หมดก่อนคือโทเค็นต่อนาที ไม่ใช่จำนวน request
OpenAI เปิดตัว GPT-6.2 Astra และ GPT-6.2 Sol เมื่อวันที่ 17 พฤศจิกายน 2026 Astra คือโมเดลระดับ frontier สำหรับงานที่ยากที่สุด ส่วน Sol คือโมเดลราคาประหยัดสำหรับงานประจำวัน ที่สร้างมาเพื่อ "ขับเคลื่อนเอเจนต์ในระดับใหญ่" ตามคำพูดของ OpenAI เอง
เอเจนต์ตัวเดียวไม่ค่อยชนขีดจำกัด แต่หกตัวบน API key เดียวชนได้ตั้งแต่มื้อกลางวัน บทความนี้ครอบคลุมขีดจำกัดอัตราของ GPT-6.2 เพลางานของแผน Codex และวิธีคำนวณขนาดทีมเอเจนต์ให้เข้าคิวรอแทนที่จะล้มเหลว ถ้าคุณรัน coding agent หลายตัวอยู่แล้ว Sharkly คือที่ที่คุณกำหนดได้ว่าให้รันพร้อมกันกี่ตัว
ขีดจำกัดอัตราของ GPT-6.2 แยกตามระดับการใช้งาน
GPT-6.2 Astra และ GPT-6.2 Sol ใช้ตารางขีดจำกัดอัตรามาตรฐานชุดเดียวกัน ตามที่ระบุใน หน้าโมเดล Sol และ หน้าโมเดล Astra ของ OpenAI RPM หมายถึงจำนวน request ต่อนาที ส่วน TPM หมายถึงโทเค็นต่อนาที ตัวไหนที่คุณใช้หมดก่อน ตัวนั้นจะเป็นตัวขวางคุณ
| ระดับ | เข้าเกณฑ์เมื่อ (ยอดซื้อเครดิตรวม) | ขีดจำกัดการใช้งานรายเดือน | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5,000 | 1,000,000 |
| Launch | $100 | $5,000 | 10,000 | 4,000,000 |
| Grow | $500 | $200,000 | 15,000 | 40,000,000 |
คอลัมน์เกณฑ์การเข้าถึงและการใช้งานรายเดือนมาจาก คู่มือ rate limits ของ OpenAI ระดับของคุณจะอัปเกรดอัตโนมัติเมื่อยอดซื้อเครดิตรวมผ่านเกณฑ์แต่ละจุด ส่วนขีดจำกัดการใช้งานรายเดือนเป็นเพลาแยกต่างหากจากวงเงินที่คุณตั้งเอง
Astra มีราคาต่อโทเค็นสูงกว่าสี่เท่า ($8 สำหรับ input และ $40 สำหรับ output ต่อล้านโทเค็น เทียบกับ $2 และ $10 ของ Sol) แต่ขีดจำกัดอัตราเท่ากัน สิ่งที่คุณจะชนขีดจำกัดหรือไม่ขึ้นอยู่กับจำนวนโทเค็นที่เอเจนต์ของคุณส่งออกไป
วิธีการทำงานของเพลาการใช้งาน GPT-6.2 ใน Codex
ถ้าเอเจนต์ของคุณรันผ่าน Codex บนแผน ChatGPT แทนที่จะใช้ API key จะมีเพลาแบบอื่นมาบังคับ หน้า ราคา Codex ของ OpenAI ระบุจำนวน local messages ต่อหน้าต่างเวลา 5 ชั่วโมงเป็นช่วง เพราะขนาดของงานส่งผลต่อต้นทุนของแต่ละข้อความ
| โมเดล | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6 ถึง 50 | 6 ถึง 50 |
| GPT-6.2 Sol | 17 ถึง 180 | 17 ถึง 180 |
| GPT-6.1 Sol | 15 ถึง 160 | 15 ถึง 160 |
| GPT-6 Astra | 5 ถึง 45 | 5 ถึง 45 |
มีสี่ประเด็นที่สำคัญสำหรับทีมเอเจนต์:
- แผน Pro ตอนนี้ไม่มีขีดจำกัด 5 ชั่วโมง แต่ขีดจำกัดรายสัปดาห์อาจยังมีผลบังคับอยู่
- Local messages และ cloud chats ใช้โควตาเดียวกัน งานบนคลาวด์หนึ่งงานอาจกินโควตามากกว่าข้อความ local หนึ่งข้อความ
- ความเร็วแลกมาด้วยโควตา โหมด Fast ใช้การใช้งานรวม 2 เท่าบนโมเดล GPT-6.2 ส่วน Ultrafast ใช้ 6 เท่า
- เซสชันยาวมีต้นทุนต่อข้อความสูงขึ้น OpenAI ระบุว่างานที่ถือ context มากกว่าจะใช้โควตา "มากขึ้นอย่างมีนัยสำคัญ"
เอเจนต์ที่อ่าน repo ไปแล้วครึ่งหนึ่งจะส่ง context ขนาดใหญ่ทุกเที่ยว ทำให้จำนวนข้อความที่ใช้ได้ลดลงเร็วมาก เราเคยพูดถึงรูปแบบเดียวกันนี้ในแผนของ Anthropic ในบทความ Claude Code usage limits และปฏิกิริยาต่อ การลดเพลา Codex Pro ก็เป็นตรรกะเดียวกัน
ทำไม TPM ไม่ใช่ RPM ที่เป็นตัวจำกัดทีมเอเจนต์
Coding agent ไม่ได้ส่ง request เล็ก ๆ จำนวนพัน แต่ส่ง request ใหญ่ไม่กี่ตัว ทุกเที่ยวจะส่งบทสนทนาทั้งหมดที่สะสมมาซ้ำอีกครั้ง: คำสั่ง, ไฟล์ที่อ่านมา, ผลลัพธ์จากเครื่องมือ และเหตุผลที่ตัวเองให้ไว้ก่อนหน้า
ลองดูเอเจนต์ตัวอย่าง: 80,000 input tokens ต่อเที่ยว และ 6 เที่ยวต่อนาที นั่นคือ 6 RPM และประมาณ 480,000 TPM เทียบกับระดับ Build:
- RPM: ใช้ 6 จาก 5,000 ยังห่างมาก
- TPM: ใช้ 480,000 จาก 1,000,000 เอเจนต์สองตัวก็เต็มแล้ว
ตัวเลขของคุณจะไม่เหมือนกัน แต่สัดส่วนจะเหมือน เอเจนต์กินโทเค็นเยอะแต่ใช้ request น้อย สำหรับเอเจนต์ตัวอย่างนี้ เพลาสูงสุดดิบคือสองตัวต่อโปรเจกต์บน Build และแปดตัวบน Launch เมื่อเผื่อ headroom 30% ตามขั้นตอนคำนวณขนาดด้านล่าง จะเหลือหนึ่งตัวบน Build และห้าตัวบน Launch บน Grow ขีดจำกัดอัตราไม่ใช่คอขวดของคุณอีกต่อไป แต่เพลารายเดือน $200,000 หรืองบประมาณที่คุณตั้งเองจะเป็นตัวกำหนดแทน
ขีดจำกัดถูกแชร์ทั้งองค์กร
OpenAI กำหนดขีดจำกัดอัตราที่ระดับองค์กรและระดับโปรเจกต์ ไม่ใช่ต่อผู้ใช้ เอเจนต์ทุกตัวที่ใช้คีย์จากโปรเจกต์เดียวกันจะดึงจากกองโควตาเดียวกัน โมเดลบางตระกูลยังมีขีดจำกัดแชร์ที่แสดงใน หน้า limits ของคุณอีกด้วย ทำให้ traffic ไปยังโมเดลหนึ่งอาจนับรวมกับอีกโมเดลหนึ่ง
วิธีปรับจำนวนเอเจนต์ที่รันพร้อมกันให้เหมาะกับระดับ GPT-6.2 ของคุณ
ทางแก้คือจำกัดจำนวนเอเจนต์ที่รันพร้อมกัน ให้งานส่วนเกินรอในคิวแทนที่จะปะทะกันที่ API ลำดับที่ได้ผลคือ:
- หาระดับของคุณ ที่ Settings, Organization, Limits บน OpenAI platform
- วัดการรันจริงของเอเจนต์หนึ่งตัว จดจำนวน input tokens ต่อเที่ยวและจำนวนเที่ยวต่อนาทีจากผลลัพธ์การใช้งานของ Runtime
- หา TPM ของคุณหารด้วย TPM ของเอเจนต์หนึ่งตัว และเผื่อ headroom 30% สำหรับความผันผวน
- ตั้งตัวเลขนั้นเป็นเพลา concurrency สำหรับเอเจนต์ทุกตัวที่ใช้โปรเจกต์นั้น
- เฝ้าดู error 429 สักหนึ่งสัปดาห์ แล้วค่อยเพิ่มเพลาทีละขั้น
ใน Sharkly แต่ละ Agent มีการตั้งค่า Max concurrency (assigned tasks), Max run duration เป็นนาที และ Queue timeout เป็นชั่วโมง เมื่อเพลาเต็ม งานใหม่จะรอในสถานะ Queued จนกว่าช่องว่างจะว่าง แชทก็แชร์เพลาเดียวกันได้ ทำให้บทสนทนาหลุดเพลาไปไม่ได้

Computer ก็มีเพลา task concurrency ของตัวเองเช่นกัน เอกสารของ Sharkly ระบุว่า concurrency ที่สูงขึ้นใช้ CPU, หน่วยความจำ, ดิสก์, ความจุผู้ให้บริการ และแบนด์วิดท์ repo มากขึ้น จึงควรเพิ่มเมื่อโหลดปัจจุบันรันได้อย่างราบรื่นเท่านั้น
แยกเอเจนต์ข้าม OpenAI projects
ขีดจำกัดระดับโปรเจกต์ช่วยให้คุณแบ่งกลุ่มเอเจนต์ได้ ให้เอเจนต์กลุ่ม review อยู่โปรเจกต์ OpenAI หนึ่ง และเอเจนต์กลุ่ม refactor จำนวนมากอยู่อีกโปรเจกต์หนึ่ง เมื่อ refactor ตัวใดวิ่งรั่ว มันจะชนขีดจำกัดของโปรเจกต์ตัวเองแทนที่จะไปอดอาหารกลุ่ม review อย่างไรก็ตาม ขีดจำกัดระดับองค์กรยังคงจำกัดยอดรวมอยู่ วิธีนี้จึงเป็นการกำหนดลำดับความสำคัญ ไม่ใช่การเพิ่มความจุ
สำหรับ Runtime ที่ยืนยันตัวตนด้วย API key ให้ตั้งคีย์เป็น environment variable บน Agent Sharkly จะฉีด Agent environment variables เข้าสู่ process ของเอเจนต์ตอนเริ่มทำงาน ให้แต่ละกลุ่มเอเจนต์ใช้คีย์จาก OpenAI project ของตัวเอง เพื่อให้ traffic ของกลุ่มไปตกที่เพลาที่ถูกต้อง
เฝ้าดูโทเค็นต่องาน
ส่วนหัวของ Agent ใน Sharkly แสดงงานที่รับมอบหมาย, จำนวนรันทั้งหมด และโทเค็นที่ใช้ ให้อ่านโทเค็นต่องาน ไม่ใช่แค่ยอดรวมรายเดือน งานประเภทที่กินโทเค็นสามเท่าของงานอื่นคือตัวเลือกแรกที่ควรย้ายไปใช้ Sol แทน Astra หรือปรับคำอธิบายงานให้กระชับขึ้น
ย้ายงานจำนวนมากไปช่วงนอกเวลาเร่งด่วน
การตั้งค่า Runtime ของแต่ละ Agent มีสวิตช์ Working hours สำหรับจัดตารางงานในช่วงนอกเวลาเร่งด่วน ชี้มันไปที่งานอย่างการสร้าง test, การอัปเดต dependency และการทบทวนเอกสาร งานพวกนี้จะรันตอนกลางคืน แล้วเหลือความจุช่วงกลางวันไว้ให้งานที่คนกำลังรอ
วิธีจัดการกับ error 429 ของ GPT-6.2
แม้จะตั้งเพลาแล้ว คุณก็ยังจะเจอ 429 เป็นครั้งคราว คู่มือของ OpenAI ระบุชัดว่าต้องทำอย่างไร:
- ทำตาม header
Retry-Afterเมื่อมีอยู่ และถือว่าเป็นค่าต่ำสุด - ถ้าไม่มี ให้ใช้ exponential backoff ร่วมกับ random jitter
- อ่าน
x-ratelimit-remaining-tokensและx-ratelimit-reset-tokensเพื่อดูว่าคุณใกล้เพลาแค่ไหน - อย่าซ้อน retry: ถ้าโค้ดของคุณ retry อยู่แล้ว ให้ปิด retry ของ SDK เอง ไม่งั้นสองอันจะคูณกัน
- อย่า retry กับ error เรื่องโควตาหรือการเรียกเก็บเงิน อันนั้นต้องมีคนมาจัดการ
503 พร้อม server_is_overloaded หมายถึงโมเดลยุ่ง ไม่ใช่ฝั่งคุณ จัดการด้วย backoff แบบเดียวกัน
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra หรือ Sol: โมเดลไหนทำให้เพลาของคุณยืดได้ไกลกว่า
เมื่อขีดจำกัดอัตราเท่ากัน การเลือกจึงขึ้นอยู่กับการใช้โทเค็นและราคา ใช้ Astra กับงานเปลี่ยนสถาปัตยกรรม, บั๊กยาก และการรันอัตโนมัติระยะยาว ใช้ Sol กับงานประจำทุกอย่าง ใน Codex บน Plus, Sol ให้จำนวนข้อความต่อหน้าต่าง 5 ชั่วโมงมากกว่า Astra ราวสามเท่า ซึ่งเป็นสัญญาณที่ชัดที่สุดของช่องว่างด้านต้นทุน
ทีมผสมคือคำตอบทั่วไป: เอเจนต์ Astra หนึ่งตัวเป็นหัวหน้า เอเจนต์ Sol หลายตัวทำชิ้นงานย่อย ตามแนวทางใน GPT-6 Astra as your Crew leader งานประจำควรอยู่กับโมเดลราคาถูก ซึ่งเป็นตรรกะเบื้องหลัง GPT-6 Luna สำหรับงานน่าเบื่อ 80 เปอร์เซ็นต์
วิธีอื่นในการเพิ่ม throughput ของ GPT-6.2
- Batch API. รันนอกขีดจำกัดแบบ synchronous ของคุณ และราคาเพียง 50% ของราคามาตรฐาน เหมาะกับงาน eval และการจำแนกข้อมูลจำนวนมาก แต่ไม่เหมาะกับเอเจนต์แบบโต้ตอบ
- Background mode พร้อมหน้าต่าง
2hหรือ8h. นับรวมกับขีดจำกัดคิว Batch/Background แยกต่างหาก ไม่ใช่ TPM สดของคุณ - Prompt caching. Input ที่ cache แล้วมีราคา $0.40 ต่อล้านโทเค็นบน Astra และ $0.10 บน Sol ประหยัดได้มากสำหรับเอเจนต์ที่ส่ง context เดิมซ้ำ ๆ
บทสรุป
ขีดจำกัดอัตราของ GPT-6.2 นั้นใจกว้างต่อ request แต่แน่นต่อโทเค็น สำหรับทีมเอเจนต์ เพลาที่ใช้งานได้จริงคือ TPM ของระดับคุณหารด้วยโทเค็นที่เอเจนต์หนึ่งตัวเผา โดยแชร์กับเอเจนต์ทุกตัวบนโปรเจกต์นั้น วัดการรันหนึ่งครั้ง ตั้งเพลา concurrency ต่ำกว่าตัวเลขนั้น แยกกลุ่มเอเจนต์ที่วุ่นวายไปไว้ในโปรเจกต์ของตัวเอง แล้วปล่อยให้คิวดูดซับงานที่เหลือ
คุณสร้างสิ่งนี้ด้วยสคริปต์และ semaphore ได้ หรือตั้งค่าต่อ Agent ใน Sharkly ก็ได้ เชื่อมต่อ Computer หนึ่งตัว สร้าง Agent หนึ่งตัวบน Codex ด้วย GPT-6.2 Sol ตั้ง max concurrency เป็น 2 แล้วมอบงานน่าเบื่อสักอย่างให้มัน อ่านเพิ่มเรื่องการรันเอเจนต์คู่ขนานได้ใน How to run 10 AI coding agents at once
FAQ
ขีดจำกัดอัตราของ GPT-6.2 เป็นเท่าไร?
ใน API, GPT-6.2 Astra และ Sol ใช้ขีดจำกัดเดียวกัน: 5,000 RPM และ 1,000,000 TPM บน Build, 10,000 RPM และ 4,000,000 TPM บน Launch และ 15,000 RPM และ 40,000,000 TPM บน Grow
GPT-6.2 Astra มีขีดจำกัดอัตราต่ำกว่า Sol หรือไม่?
ไม่ OpenAI ระบุ RPM และ TPM เท่ากันสำหรับทั้งสองโมเดลในทุกระดับ Astra มีราคาต่อโทเค็นสูงกว่า จึงชนงบประมาณของคุณเร็วกว่า ไม่ใช่ชนขีดจำกัดอัตราเร็วกว่า
ย้ายไประดับการใช้งาน OpenAI ที่สูงขึ้นได้อย่างไร?
ระดับอัปเกรดอัตโนมัติตามยอดซื้อเครดิตรวม: $5 สำหรับ Build, $100 สำหรับ Launch, $500 สำหรับ Grow
ขีดจำกัดอัตรานับต่อ API key หรือต่อองค์กร?
ต่อองค์กรและต่อโปรเจกต์ ทุกคีย์ในโปรเจกต์เดียวกันดึงจากกองโควตาเดียวกัน ดังนั้นสิบเอเจนต์บนสิบคีย์ในโปรเจกต์เดียวก็ยังแชร์เพลาเดียวกัน
ได้ข้อความ GPT-6.2 Astra กี่ข้อความใน Codex?
บน Plus และ Standard Business, OpenAI ประมาณการ local messages 6 ถึง 50 ข้อความต่อหน้าต่าง 5 ชั่วโมงสำหรับ GPT-6.2 Astra และ 17 ถึง 180 สำหรับ Sol แผน Pro ตอนนี้ไม่มีขีดจำกัด 5 ชั่วโมง แม้ขีดจำกัดรายสัปดาห์อาจมีผลบังคับ
ทำไมเอเจนต์ของฉันเจอ error 429 ทั้งที่ตัวเลข RPM ดูปกติ?
เอเจนต์ส่ง context ขนาดใหญ่ จึงหมดโทเค็นต่อนาทีก่อนจะหมด request ต่อนาทีนานมาก ลองเช็ค x-ratelimit-remaining-tokens ใน response headers
Sharkly เพิ่มขีดจำกัดโมเดลของตัวเองหรือไม่?
ไม่ Sharkly รัน coding agent ที่คุณใช้อยู่แล้ว และโควตาโมเดลขึ้นอยู่กับเครื่องมือ แผน และบัญชี API ที่ทีมของคุณเชื่อมต่อ Sharkly ควบคุมจำนวนงานที่แต่ละ Agent รันพร้อมกันเท่านั้น