
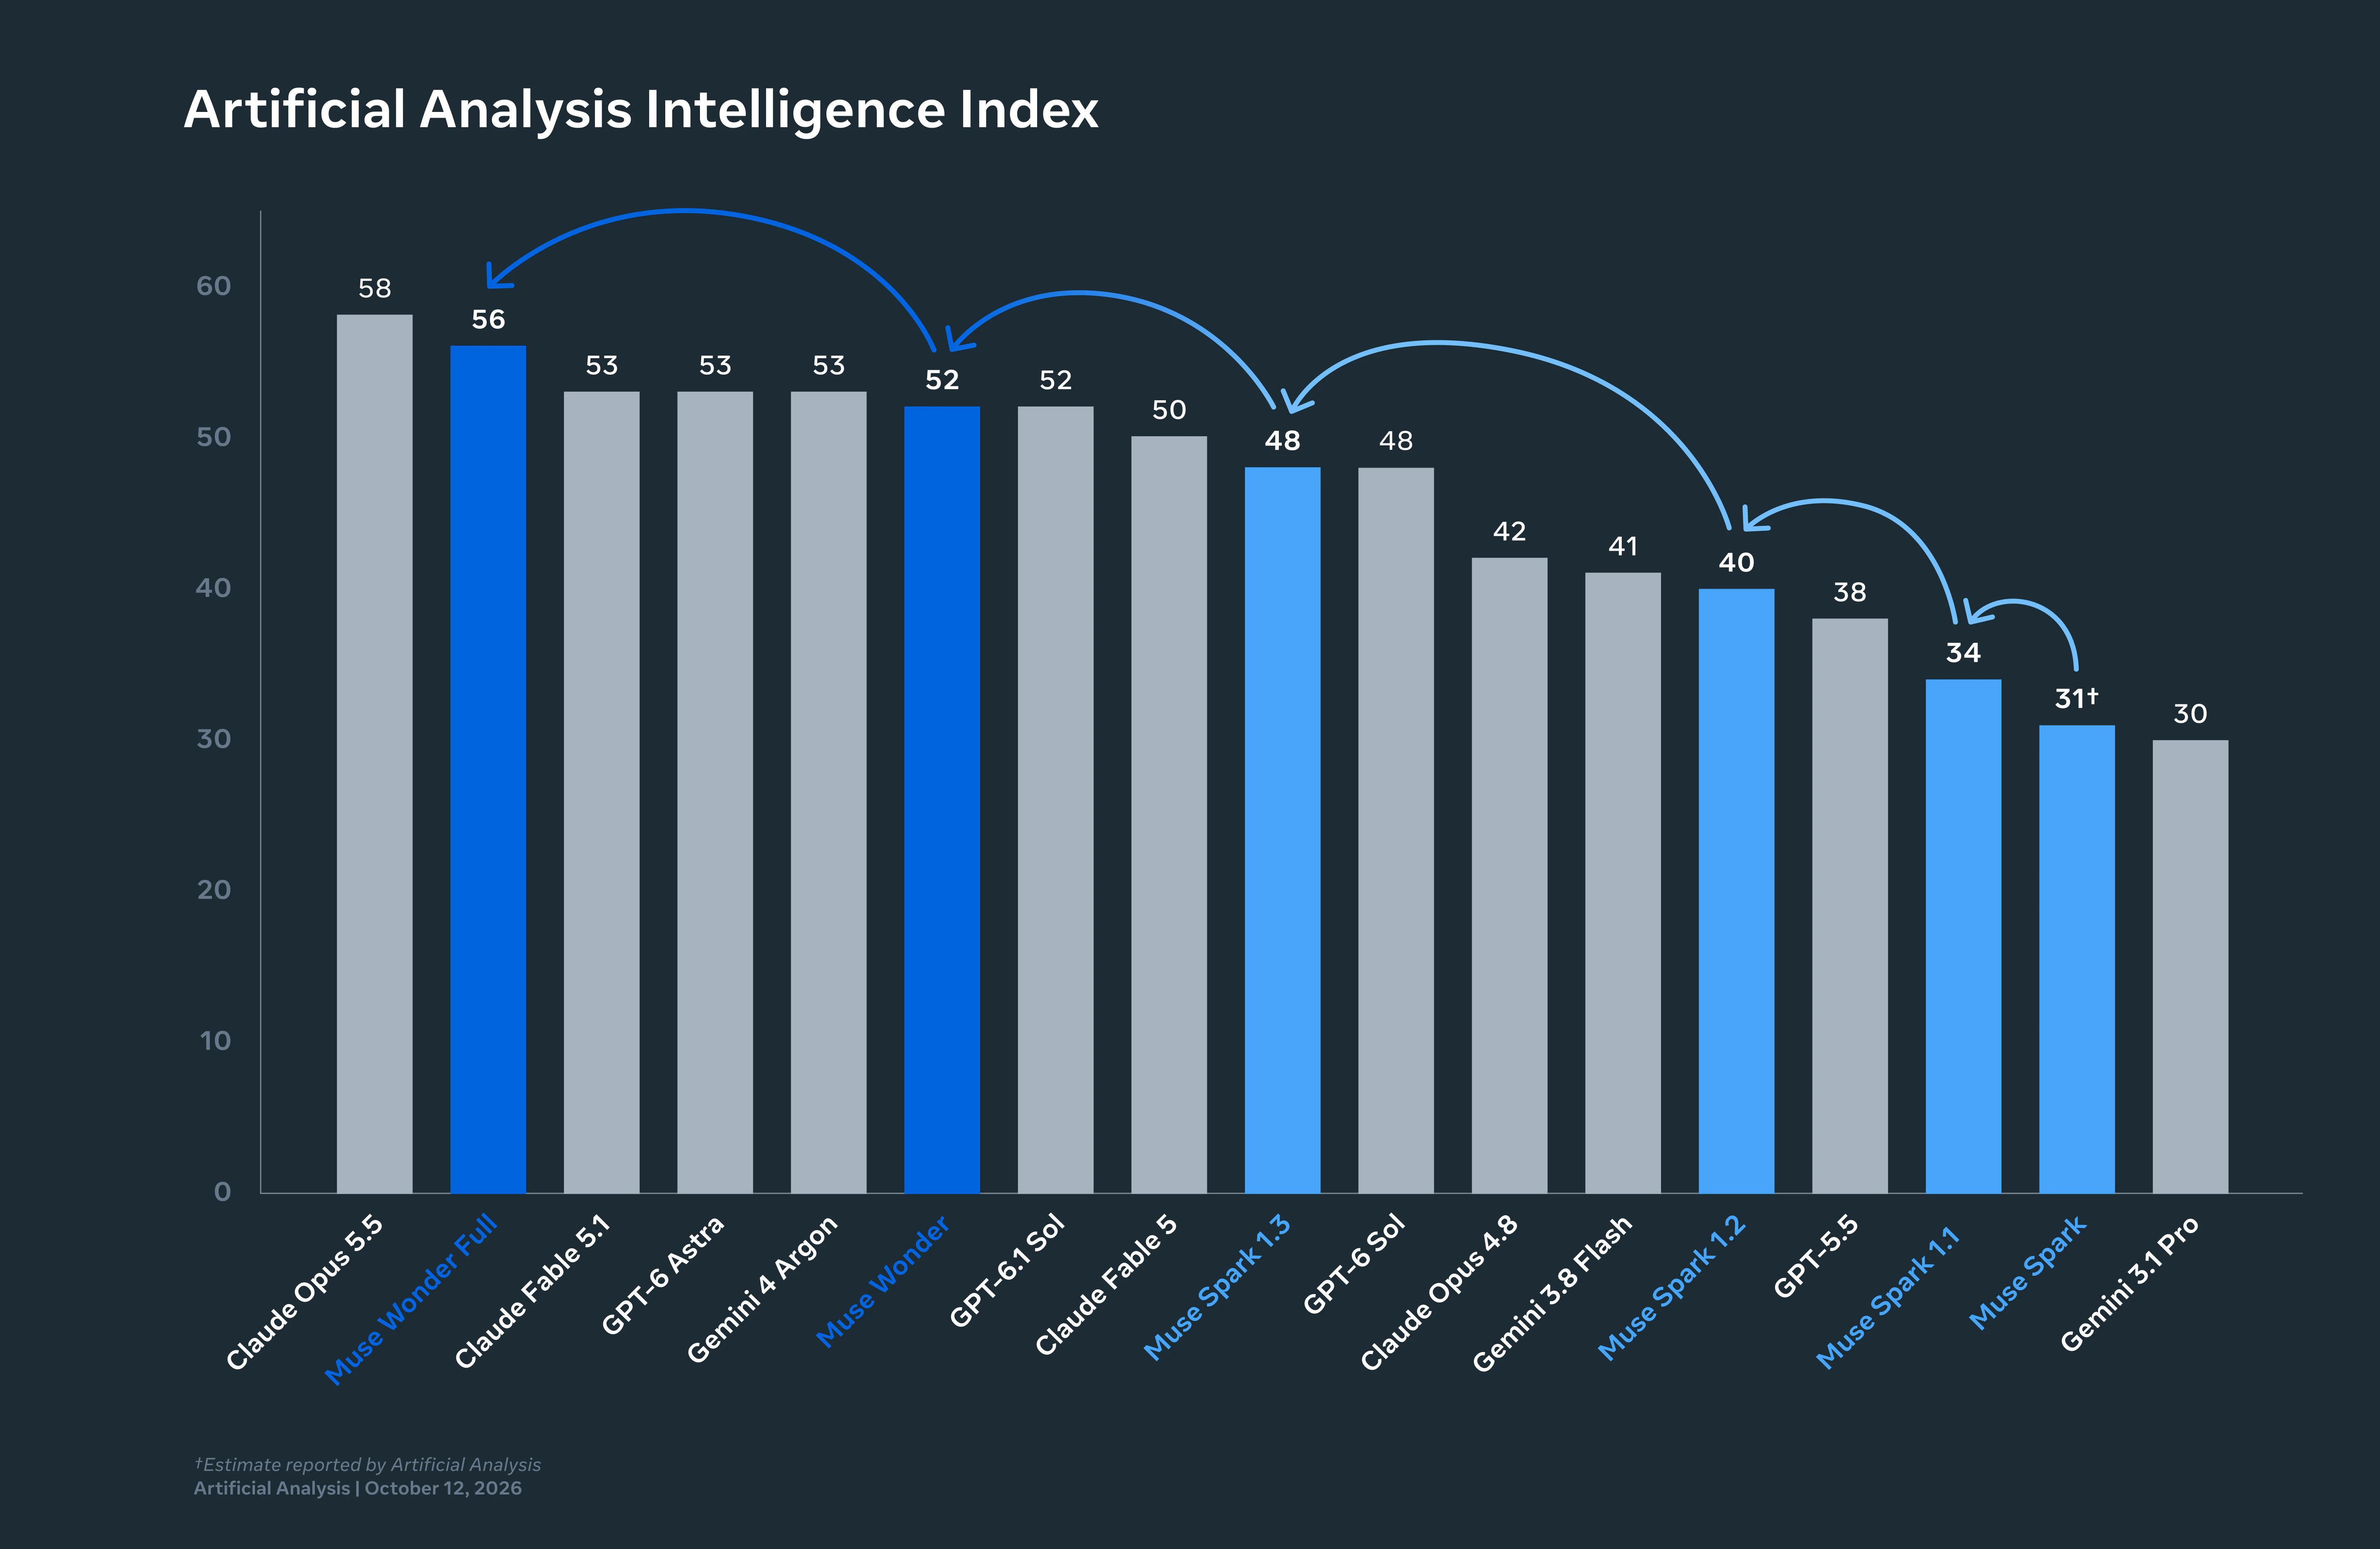
ทั้ง Muse Wonder และ Claude Opus 5.5 มีราคาเท่ากันพอดี คือ $4 ต่อ 1 ล้าน input token และ $20 ต่อ 1 ล้าน output token ดังนั้นสำหรับ Crew แล้ว การเลือกระหว่างสองโมเดลนี้จึงไม่ใช่เรื่องของการจัดสรรงบประมาณ แต่มันคือกฎในการกำหนดเส้นทางการทำงาน (Routing rule) ข้อมูลจาก Model card ของ Meta ระบุว่า Wonder มีคะแนนนำในการทดสอบเบนช์มาร์กสำหรับงานเขียนโค้ดระยะยาว (SWE-Marathon: 53.1 ต่อ 46.3) ส่วน Opus นั้นนำในเรื่องการทำงานบน Terminal (59.6 ต่อ 52.0), ความฉลาดรอบด้านทั่วไป (58 ต่อ 52 ตามดัชนีชี้วัดอิสระ) และคลังความรู้ (46 ต่อ 25) ตัวเลขทั้งสี่ชุดนี้สะท้อนถึง Agent สองตัวที่มีจุดเด่นต่างกันอย่างชัดเจน และบอร์ดงานที่แจกจ่ายงานตามตัวเลขเหล่านี้ จะดึงศักยภาพของทั้งสองโมเดลออกมาได้คุ้มค่ากว่าบอร์ดที่ตั้งค่าโมเดลเริ่มต้นเพียงตัวเดียวอย่างแน่นอน
บทความนี้จะเปลี่ยนตัวเลขเหล่านั้นให้เป็นแนวทางการมอบหมายงานจริง: Task แบบไหนควรส่งให้ Muse Wonder Agent, Task แบบไหนควรให้ Opus 5.5 จัดการต่อ, แต่ละโมเดลส่งผลกระทบต่อคิวการรีวิวอย่างไรบ้าง และจะประเมินผลหลังผ่านไปหนึ่งสัปดาห์ได้อย่างไรว่ากฎที่ตั้งไว้นั้นได้ผลหรือไม่ สำหรับขั้นตอนการตั้งค่าเลนการทำงานของ Meta สามารถดูได้ที่ วิธีรัน Muse Wonder Agent ใน Sharkly
ตัวเลขสำคัญที่ต้องรู้ก่อนวางกฎ Routing
| เกณฑ์วัด | Muse Wonder | Claude Opus 5.5 | แหล่งข้อมูล |
|---|---|---|---|
| SWE-Marathon (การรันโค้ดระยะยาว) | 53.1 | 46.3 | Meta model card |
| DeepSWE 1.1 | 78.8 | 74.2 | Meta model card |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Meta model card |
| AA-Omniscience (คลังความรู้) | 25 | 46 | Artificial Analysis |
| อัตราการเกิดภาพหลอน (Hallucination rate) | 27% | ต่ำกว่า ตามการจัดอันดับของ AA | Artificial Analysis |
| ดัชนีความฉลาด (Intelligence Index) | 52 | 58 | Artificial Analysis |
| ดัชนี Agent เขียนโค้ด (Coding Agents Index) | 63 | 66 (Claude Code) | Artificial Analysis |
| ค่าใช้จ่ายต่อ Task อ้างอิง | $4.52 | $5.98 | Artificial Analysis |
| ข้อมูลนำเข้า (Inputs) | ข้อความ, รูปภาพ, วิดีโอ, เสียง | ข้อความ, รูปภาพ, PDF | Vendor docs |
ตารางนี้สรุปจุดเด่นของทั้งสองโมเดลได้อย่างชัดเจน: Wonder เน้นความอึด พยายามไม่ลดละ ค่าใช้จ่ายต่อ Task ต่ำกว่าเนื่องจากการตอบมีความกระชับตรงประเด็น จุดอ่อนคือการดึงข้อมูลความรู้ (Recall) แต่รองรับอินพุตทั้งวิดีโอและเสียง ส่วน Opus ฉลาดกว่าในภาพรวม เก่งกว่าเมื่อต้องทำงานใน Shell มีคลังความรู้แน่นกว่า แต่มีค่าใช้จ่ายต่อ Task สูงกว่า ไม่มีโปรไฟล์ไหนดีไปกว่ากันอย่างสมบูรณ์แบบ ทั้งคู่แค่เหมาะกับ Task คนละประเภท
งานที่เหมาะกับ Muse Wonder Agent
จุดร่วมของงานที่เหมาะกับ Wonder คือเป็นงานยาวและมีอุปสรรคให้ต้องแก้ Meta ฝึกฝนโมเดลนี้ขึ้นมาโดยเน้นสิ่งที่เรียกว่า Active Focus ซึ่งก็คือความสามารถในการลองวิธีใหม่ๆ และหาทางก้าวข้ามอุปสรรคอย่างต่อเนื่อง โดยมี SWE-Marathon เป็นเบนช์มาร์กที่สร้างขึ้นมาเพื่อวัดความสามารถด้านนี้โดยเฉพาะ
- การ Refactor โค้ดหลายไฟล์พร้อมกับต้องคุมให้ชุด Test Suite ผ่านตลอดเวลา งานที่มีหลายขั้นตอน แต่ละขั้นตอนสามารถตรวจสอบได้ และข้อผิดพลาดต้องอาศัยการลองแนวทางที่สองและสาม
- การอัปเกรด Dependency และ Migration เฟรมเวิร์ก ตัวอย่างงานระยะยาวสุดคลาสสิก: อัปเกรด, พัง, แก้ไข, วนซ้ำ ซึ่งหน้าที่ของโมเดลคือต้องไม่ยอมแพ้และถอดใจไปในขั้นตอนที่สิบเอ็ด
- ลูปการแก้ไขและตรวจสอบ (Fix-and-verify) ร่วมกับชุด Test ที่ Flaky ไม่นิ่ง งานที่โมเดลต้องแยกแยะให้ออกว่า บั๊กเกิดจากโค้ดของตัวเองหรือมาจากตัว Test Suite กันแน่
- Task ที่มีอินพุตเป็นวิดีโอหรือไฟล์เสียง เช่น วิดีโอบันทึกหน้าจอที่แสดงบั๊ก หรือไฟล์บันทึกการประชุมที่สรุป Requirements ซึ่ง Opus 5.5 ไม่สามารถรับข้อมูลเหล่านี้ได้
ควรกำหนด Acceptance criteria (เกณฑ์การยอมรับงาน) ให้ชัดเจนเพื่อให้โมเดลตรวจสอบผลลัพธ์ได้ด้วยตัวเอง Wonder จะทำงานได้ดีที่สุดเมื่อ Task ระบุชัดเจน เช่น “ชุดทดสอบทั้งหมดใน packages/api ต้องผ่าน และมีการบันทึกข้อมูลใน changelog” แต่จะทำงานได้แย่ที่สุดเมื่อต้องตัดสินใจเองว่าคำว่า “เสร็จสมบูรณ์” หน้าตาเป็นอย่างไร
งานที่ควรให้ Opus 5.5 จัดการต่อไป
- งานที่ต้องพึ่งพาคำสั่ง Terminal อย่างหนัก สคริปต์จัดการโครงสร้างพื้นฐาน, ไปป์ไลน์การ Deploy หรืออะไรก็ตามที่ Agent ต้องทำงานอยู่ใน Shell เป็นหลัก คะแนนที่ต่างกันถึง 7.5 จุดบน Terminal-Bench ถือเป็นช่องว่างที่ชัดเจนมาก
- งานใดก็ตามที่ต้องอาศัยคลังความรู้ คะแนน Omniscience ที่ 25 เทียบกับ 46 หมายความว่า Wonder มีโอกาสขาดข้อมูลสำคัญมากกว่าถึงสองเท่า หากเป็นเรื่องของ Library API ที่ไม่คุ้นตา, รหัส Error ที่แปลกประหลาด หรือความรู้เฉพาะทางระดับ Domain knowledge ทางด้าน Opus จะสามารถตอบได้จากความทรงจำทันที ในขณะที่ Wonder ต้องคอยไปค้นหาหรือเดาเอาเอง
- หน้าที่ผู้ตรวจทานโค้ด (Reviewer) Agent ที่ทำหน้าที่อ่าน Diff โค้ดของ Agent ตัวอื่นและตัดสินว่าถูกต้องหรือไม่ ควรเป็นตัวที่ฉลาดที่สุดเท่าที่คุณมี ซึ่งตามดัชนีคะแนนรวมแล้วตำแหน่งนั้นคือ Opus และแนวทางการออกแบบ Crew แบบผสมผสานหลายโมเดล (Mixed-model Crew pattern) ก็จัดวางโมเดลที่มีราคาสูงกว่าไว้ในตำแหน่งนี้อยู่แล้ว
- Task สั้นและตรงไปตรงมา ใน DeepSWE ทั้งคู่ทำคะแนนได้ใกล้เคียงกัน แต่เรื่องความฉลาดทั่วไป Opus ยังคงนำอยู่ หากเป็นงานที่ใช้เวลารันเพียงสิบนาที ข้อได้เปรียบด้านความอึดไม่ยอมแพ้ก็แทบไม่มีโอกาสได้แสดงผลลัพธ์
ผลกระทบของแต่ละโมเดลต่อคิวการรีวิว
การจัดเส้นทางงาน (Routing) จะเปลี่ยนสิ่งที่ถูกส่งมากองตรงหน้า Reviewer และนั่นคือต้นทุนที่แท้จริง
เมื่อ Wonder ทำงานใน Task ที่ยาว ผลลัพธ์ที่ได้มักจะมีเส้นทางการทำงานที่ยาวกว่า: มีการพยายามหลายครั้งกว่า, การย้อนกลับแนวทางเดิมที่ใช้ไม่ได้บ่อยกว่า และมีจำนวน Commit มากกว่า ซึ่งนั่นคือการที่โมเดลทำหน้าที่ของมันอย่างเต็มที่ แต่นั่นก็แปลว่าเพียงแค่ Diff อย่างเดียวอาจเล่าเรื่องได้ไม่ครบถ้วน Reviewer จำเป็นต้องดู Run log ประกอบด้วย จึงเป็นเหตุผลว่าทำไม Prompt คำสั่งของ Agent จึงควรกำหนดให้โมเดลบันทึกสิ่งที่ได้พยายามทำไว้อย่างต่อเนื่อง หลักการที่ว่า การรีวิวโดยมนุษย์คือคอขวดสำคัญ (Human review is the bottleneck) จะยิ่งเห็นผลชัดเจนขึ้นเป็นพิเศษ เพราะโมเดลที่กัดไม่ปล่อยย่อมสร้างเนื้อหาให้ต้องรีวิวต่อหนึ่ง Task มากขึ้น ไม่ใช่น้อยลง
ช่องว่างด้านความรู้ของ Wonder มักจะปรากฏในรูปของรายละเอียดที่ตอบอย่างมั่นใจแต่ผิดพลาด เช่น การระบุ Flag คำสั่งที่ไม่มีอยู่จริง หรือ Method ที่ถูกเปลี่ยนชื่อไปแล้วตั้งแต่สองเวอร์ชันก่อน อัตราการเกิดภาพหลอนของ Wonder ถือว่าต่ำเมื่อเทียบกับโมเดลในระดับเดียวกัน คืออยู่ที่ 27% ตามการวัดผลของ Artificial Analysis ทว่า 27% ก็ไม่ใช่ศูนย์ ดังนั้นควรสั่งให้ Agent ตรวจสอบความถูกต้องจากโค้ดใน Repository เสมอเมื่อมีจุดที่ไม่แน่ใจ และให้ระบุอย่างชัดเจนหากไม่สามารถยืนยันได้ จากนั้นให้ Reviewer เจาะจงสุ่มตรวจเฉพาะบรรทัดเหล่านั้นเป็นพิเศษ
ในทางกลับกัน การรัน Opus บน Task เดียวกันมักจะสร้างขั้นตอนการทำงานที่สั้นกว่า มีการตัดสินใจที่เด็ดขาดกว่า แต่ก็แลกมาด้วยค่าใช้จ่ายต่อ Task ที่สูงกว่า การรีวิวในแต่ละรอบจึงทำได้เบาแรงกว่า อย่างไรก็ตาม เมื่องานนั้นยาวและเต็มไปด้วยอุปสรรค Opus มีแนวโน้มที่จะหยุดกลางคันมากกว่า ซึ่งจะส่งผลให้เกิดปัญหาอีกลักษณะหนึ่งเข้ามาในคิวรีวิว นั่นคืองานที่ส่งกลับมาแบบทำเสร็จเพียงครึ่งเดียวและต้องนำมากำหนด Scope ใหม่อีกรอบ
ตัวอย่างการกระจาย 3 รูปแบบ Task จริง
ตัวอย่างรูปธรรมเหล่านี้จะช่วยให้คุณนำกฎไปปรับใช้ในการมอบหมายงานได้ง่ายขึ้น
“อัปเกรด ORM จาก v5 ไปเป็น v7 ในทุก Service และ Integration Test ทั้งหมดต้องผ่าน” ส่งให้ Wonder เพราะมีขั้นตอนย่อยหลายสิบขั้น Test Suite จะทยอยพังด้วยสาเหตุใหม่ๆ ในแต่ละสเต็ป และมีเส้นชัยที่ชัดเจน ความอึดพยายามไม่ลดละของโมเดลคือจุดเด่นสำคัญ และตัวโมเดลเองก็สามารถตรวจสอบ Acceptance criterion ได้ด้วยตนเองตลอดการรัน
“เขียนโค้ด Terraform สำหรับ Staging Environment ตัวใหม่ แล้วรัน apply ทันที” ส่งให้ Opus เพราะต้องใช้คำสั่ง Shell หนักมาก ต้องอาศัยความรู้เฉพาะด้านเกี่ยวกับโครงสร้างพื้นฐาน และเป็นการกระทำที่ส่งผลกระทบสูง คะแนน Terminal-Bench ชี้ชัดว่าควรใช้ Opus ส่วนผลกระทบที่อาจลุกลาม (Blast radius) บ่งชี้ว่าไม่ว่าจะเป็นโมเดลตัวไหน Agent ก็ควรหยุดเพื่อสอบถามยืนยันก่อนจะสั่ง apply เสมอ
“อธิบายสาเหตุที่ Webhook ของระบบชำระเงินถูกเรียกซ้ำซ้อนสองรอบ พร้อมเสนอแนวทางแก้ไข” ให้ Opus เป็นผู้อธิบาย เพราะงานนี้ขึ้นอยู่กับการทำความเข้าใจกลไก Retry semantics ของผู้ให้บริการ ซึ่งเป็นการดึงความรู้เฉพาะทาง (Recall) ออกมาใช้ และหากแนวทางแก้ไขที่เสนอมากลายเป็นการแก้ไขโค้ดหลายไฟล์พร้อมเขียนเทสต์ Task ต่อเนื่องนั้นก็ค่อยส่งต่อให้ Wonder ทำแทน
รูปแบบสรุปคือ: ให้ใช้ Wonder กับ Task ที่วัดผลด้วย “เส้นชัยที่ชัดเจน” และใช้ Opus กับ Task ที่วัดผลด้วย “ความรู้ความเข้าใจที่ต้องมี” แต่หาก Task มีทั้งสองอย่างปนกัน ให้แยกย่อย Task ออกจากกัน ซึ่ง Sharkly ถูกสร้างมาเพื่อรองรับการแบ่งงานในลักษณะนี้โดยเฉพาะ โดยให้หนึ่ง Agent รับผิดชอบหนึ่ง Task ต่อหนึ่งเลน พร้อมบันทึกการส่งต่องานลงบนบอร์ดอย่างเป็นระบบ แทนที่จะปล่อยให้จำกันเอาเอง
รันใช้งานทั้งคู่ พร้อมวิธีประเมินผลลัพธ์
ลองนำกฎนี้ไปปรับใช้บนบอร์ดเป็นเวลาหนึ่งสัปดาห์ แล้วให้ผลลัพธ์ของ Task เป็นตัวตัดสิน
- สร้าง Muse Wonder Agent ขึ้นมาและเก็บ Opus 5.5 Agent เอาไว้ โดยในคำสั่งของ Agent ทั้งสองตัว ควรกำหนดให้ระบุ Model ID ไว้ที่ส่วนบนสุดของรายงาน เนื่องจาก Sharkly ไม่ได้แสดงข้อมูลนี้ไว้บนหน้าจอ
- มอบหมายงานตามกฎข้างต้น โดยไม่ใช้ความชอบส่วนตัว: งานที่ยาวและติดอุปสรรคเยอะส่งให้ Wonder, งาน Terminal และงานที่ต้องใช้ความรู้ส่งให้ Opus, และหน้าที่ Reviewer ส่งให้ Opus
- เมื่อครบหนึ่งสัปดาห์ ให้ดึง Task ที่ Agent แต่ละตัวปิดงานได้มาตรวจสอบ แล้วนับ 3 สิ่งนี้: จำนวนงานที่ตอบกลับมาเป็นคำถามแทนที่จะเป็นผลลัพธ์, จำนวนงานที่ต้องสั่งรันซ้ำรอบสอง และจำนวนความคิดเห็นจากการรีวิว (Review comments) ที่แต่ละตัวได้รับ
หากงานระยะยาวของ Wonder สามารถปิดจบได้โดยต้องรันซ้ำน้อยลง และงาน Terminal ของ Opus ปิดงานได้โดยต้องแก้งานน้อยลง แสดงว่ากฎการตั้งเส้นทางนี้ถูกต้องแล้ว แต่ถ้า Task ของ Wonder ก่อให้เกิด Review comment มากเสียจนไม่คุ้มกับเวลาที่ประหยัดได้จากการลดการรันซ้ำ ก็ควรจำกัดขอบเขตงานที่จะส่งให้ Wonder ให้แคบลง ตัวเลขในตารางเป็นเพียงค่าเฉลี่ยจากการทดสอบเบนช์มาร์ก งานจริงของคุณต่างหากคือบททดสอบที่สำคัญที่สุด
ค่าใช้จ่ายทั้งหมดนี้จะไม่ปรากฏบนบิลของ Sharkly เนื่องจากการเรียกใช้งานโมเดลจะหักผ่าน API Key ของ Meta และ Anthropic ที่กำหนดค่าไว้ใน Computer และด้วยราคาตั้งต้นที่เท่ากันทุกประการ ส่วนต่างของค่าใช้จ่ายจึงขึ้นอยู่กับตัวเลขที่บล็อก usage รายงานในการรันแต่ละครั้งเท่านั้น
โมเดลอาจมีการเปลี่ยนแปลงและอัปเดตใหม่ในเดือนนี้ ทว่า Context, ความคืบหน้า, อุปสรรคที่พบ, ผลลัพธ์ที่ได้ ตลอดจนการรีวิวโดยมนุษย์ ล้วนยังคงมองเห็นและติดตามได้อย่างโปร่งใสตั้งแต่ขั้นตอน Request ไปจนถึง Release คุณอาจสร้างระบบนี้ขึ้นมาเองโดยใช้ Worktrees หรือจะใช้ Sharkly ช่วยจัดการ Workflow ทั้งหมดก็ได้เช่นกัน


