เมื่อวันที่ 10 กันยายน OpenAI ได้เปิดตัว Agents API ในเวอร์ชัน Public Beta เพื่อ “ส่งมอบโครงข่าย harness และโครงสร้างพื้นฐานระดับเดียวกับที่ขับเคลื่อน Codex ให้แก่นักพัฒนาผ่าน API ที่ใช้งานง่ายและยืดหยุ่น” ต่อมาในงาน DevDay เมื่อวันที่ 29 กันยายน API ตัวนี้ยังได้รับการอัปเกรดความสามารถ computer use พร้อมเปิดตัวบริการคู่ขนานแบบเนทีฟบน AWS และอีกหนึ่งฟีเจอร์ใกล้เคียงอย่าง dots แบบ Always-on ตัวใหม่ของ ChatGPT ซึ่งทำงานอยู่บน harness ของ Codex เดียวกันนี้ด้วย
หากคุณอ่านข่าวนี้ในฐานะนักพัฒนาที่กำลังสร้างผลิตภัณฑ์ด้านเอเจนต์ นี่ถือเป็นข่าวดีอย่างยิ่ง เพราะ harness ที่คุณอาจต้องทนเขียนขึ้นมาแบบกระท่อนกระแท่น ตอนนี้มีคนอื่นมารับหน้าที่ดูแลแทนแล้ว แต่หากคุณมองในมุมของวิศวกรที่ทีมกำลังใช้งาน Claude Code และ Codex กับโค้ดเบสจริงอยู่แล้ว คำถามจะเปลี่ยนไปทันที เพราะ API ตัวนี้ตอบโจทย์แค่ว่า “จะทำให้เอเจนต์ทำงานต่อเนื่องหลายชั่วโมงได้อย่างไร” แต่ไม่ได้ตอบคำถามว่า “แล้วทีมจะรู้ได้อย่างไรว่าเอเจนต์ทั้งหกตัวทำอะไรไปบ้าง และใครเป็นผู้อนุมัติเว็บไซต์ที่เอเจนต์ตัวหนึ่งเพิ่งล็อกอินเข้าไป” ซึ่ง Sharkly ถูกสร้างขึ้นมาเพื่อตอบคำถามข้อหลังนี้นี่เอง
สรุปประเด็นสำคัญ (TL;DR)
Agents API ทำหน้าที่ดูแลจัดการ harness ของ Codex โดยครอบคลุมทั้ง durable sessions, การทำ compaction, การค้นหา tool, ระบบ subagents รวมถึง sandbox จาก OpenAI, โครงสร้างพื้นฐานของคุณเอง หรือจากพาร์ตเนอร์ทั้ง 9 ราย โดยไม่มีค่าใช้จ่ายเพิ่มเติม นอกเหนือจากค่าโทเคน, เครื่องมือ และเวลาการใช้งานคอนเทนเนอร์ ส่วนงาน DevDay ได้เพิ่มฟีเจอร์ computer use เข้ามา ซึ่งแอปพลิเคชันของคุณจะต้องอนุมัติเว็บไซต์ origin ใหม่แต่ละแห่งและทุกการเข้าสู่ระบบ (การอนุมัติ origin ไม่ใช่การยืนยันการกระทำในแต่ละขั้นตอน) รวมถึง Bedrock Managed Agents ที่นำความสามารถหลักเหล่านี้ไปรันภายใน AWS อย่างไรก็ตาม ทั้งหมดนี้ไม่ได้ครอบคลุมการทำงานในระดับทีม (team layer) แต่อย่างใด ไม่ว่าจะเป็นเรื่องที่ว่าใครเป็นผู้มอบหมายงาน, งานอยู่กับเอเจนต์ตัวไหน, งานใดเสร็จแล้ว, งานใดล้มเหลว และใครเป็นผู้ตรวจรับผลงาน
Agents API คืออะไร และ OpenAI ดูแลจัดการส่วนไหนบ้าง
ภาพรวมของ OpenAI ได้สรุป API ออกเป็น 4 องค์ประกอบหลัก โดย Agent คือ “โมเดล, คำสั่ง (instructions), เครื่องมือ (tools) และเซิร์ฟเวอร์ MCP ที่เอเจนต์สามารถเรียกใช้ได้” Environment คือ “sandbox หรือคอมพิวเตอร์ (ไม่บังคับ) ที่เอเจนต์ใช้เข้าถึงไฟล์, โหลดทักษะ (skills) และรันคำสั่ง” Session คือ “อินสแตนซ์ที่ทำงานได้อย่างต่อเนื่อง (durable instance) ของเอเจนต์ ซึ่งคอยจัดการงานและตอบสนองต่ออินพุต” และ Events and items คืออินพุตที่คุณส่งเข้าไปและเอาต์พุตที่ได้รับกลับมา
คุณสามารถสร้างเซสชันพร้อมกำหนดการตั้งค่าของเอเจนต์ มอบหมายงานให้เมื่อ environment พร้อม ติดตามการทำงานผ่านระบบสตรีมมิงหรือเว็บฮุก (webhooks) จากนั้นก็ส่งงานเพิ่มเติมหรือปรับทิศทางการทำงานต่อในเซสชันเดิมได้ ตัวอย่างโค้ดแบบย่อจากเอกสารทางการ:
const session = await client.beta.agents.sessions.create({
  agent: {
    model: "gpt-6-astra",
    instructions: "Use the docs MCP and web search. Delegate independent research to subagents when useful.",
    tools: [
      { type: "programmatic_tool_calling" },
      { type: "mcp", server_label: "openai_docs", transport: { type: "http", server_url: "https://developers.openai.com/mcp" } },
      { type: "web_search" },
    ],
    multi_agent: { enabled: true, max_concurrent_subagents: 4 },
  },
  environment: { type: "self_hosted", workspace_directory: "/workspace" },
  input: [{ role: "user", content: [{ type: "input_text", text: "Research how to connect an MCP server to an OpenAI agent and summarize the setup." }] }],
});
ไฮไลต์สำคัญอยู่ที่โค้ดสองบรรทัด ได้แก่ multi_agent ที่เปิดใช้งานการกระจายงานไปยัง subagent พร้อมกำหนดขีดจำกัดการทำงานพร้อมกัน (concurrency cap) และ environment.type ที่กำหนดตำแหน่งที่จะรันโค้ด ไม่ว่าจะเป็น openai_hosted, self_hosted หรือ sandbox ของพาร์ตเนอร์รายต่างๆ (Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop, Vercel)
ในเอกสารได้สรุปการแบ่งหน้าที่ไว้อย่างชัดเจนในประโยคเดียวว่า “OpenAI จัดการเรื่องเซสชัน, orchestration, context compaction และการกู้คืนระบบ ในขณะที่แอปพลิเคชันของคุณมีหน้าที่จัดเตรียมเครื่องมือและเลือกสภาพแวดล้อมในการประมวลผล (execution environment)”
| OpenAI เป็นผู้จัดการ | คุณยังคงต้องเป็นผู้จัดเตรียม |
|---|---|
| ลูปการทำงานของเอเจนต์: การเรียกโมเดล, การใช้เครื่องมือ, การลองใหม่ (retries) | ตัวงาน และคำนิยามของความสำเร็จ (definition of done) |
| การทำ Context compaction เมื่อเซสชันใกล้ถึงขีดจำกัด | เครื่องมือ: เซิร์ฟเวอร์ MCP, ฟังก์ชัน, built-ins |
| การค้นหาและโหลดเครื่องมือ | ข้อมูลรับรองความถูกต้อง (credentials) ผ่าน vault IDs |
| การแบ่งงานย่อยให้ Subagent และการประสานงาน | การเลือกและการตั้งค่า environment |
| การกลับมาทำงานต่อของเซสชัน (resumption) และการปรับทิศทาง | ทุกสิ่งทุกอย่างที่เกิดขึ้นหลังจากเซสชันสิ้นสุดลง |
การใช้งานโมเดลจะคิดค่าบริการตามอัตรา API ปกติของโมเดลนั้นๆ เครื่องมือคิดตามอัตรามาตรฐาน และ sandbox ที่ OpenAI โฮสต์คิดตามอัตราค่าบริการคอนเทนเนอร์ โดยในบทความเปิดตัวระบุว่า “ไม่มีค่าธรรมเนียมเพิ่มเติมสำหรับการใช้งาน Agents API” อย่างไรก็ตาม ในเอกสารได้ระบุข้อจำกัดไว้อย่างชัดเจน 2 ข้อคือ ในปัจจุบันตัว API “รองรับการจัดเก็บข้อมูล (data residency) เฉพาะในสหรัฐอเมริกาเท่านั้น และยังไม่รองรับนโยบาย Zero Data Retention (ZDR)” ซึ่งการเลือกใช้ sandbox แบบ self-hosted ก็ไม่ได้ทำให้เข้าเกณฑ์ ZDR แต่อย่างใด หากข้อใดข้อหนึ่งนี้มีความสำคัญต่อนโยบายความปลอดภัยและการปฏิบัติตามกฎเกณฑ์ (compliance) ขององค์กรคุณ การย้าย sandbox มาดูแลเองภายในก็ไม่ได้ช่วยเปลี่ยนเงื่อนไขนี้
สิ่งที่เพิ่มเข้ามาในงาน DevDay
Computer use: เพียงเพิ่มเครื่องมือ computer_use และเปิดใช้งานเดสก์ท็อปบน environment ที่ OpenAI โฮสต์ เอเจนต์ก็สามารถควบคุมเบราว์เซอร์บนคลาวด์ได้ โดยในคู่มือการใช้งาน computer use ได้ออกแบบเวิร์กโฟลว์ตามเหตุการณ์การขออนุมัติ (approval events) เบราว์เซอร์จะขออนุมัติจากผู้ใช้ก่อนเข้าชมเว็บไซต์ origin ใหม่ทุกครั้ง รวมถึงเว็บไซต์สาธารณะทั่วไปด้วย การเข้าสู่ระบบจะส่งคำขอแยกออกมาเพื่อให้แอปพลิเคชันของคุณแสดงฟิลด์กรอกอีเมล, รหัสผ่าน และรหัสยืนยัน โดยยังไม่รองรับ passkey และการสแกน QR code อีกทั้งมีเพียงเอเจนต์หลักเท่านั้นที่สามารถขอข้อมูลรับรองความถูกต้องได้ ไม่ใช่ subagent และประโยคสำคัญที่ต้องเน้นย้ำคือ “การอนุมัติ origin ไม่ได้ครอบคลุมถึงการยืนยันก่อนการกระทำในแต่ละขั้นตอน” หากเป็นการสั่งซื้อสินค้าหรือการเปลี่ยนแปลงที่อาจส่งผลกระทบเสียหาย เอกสารแนะนำให้จำกัดการเข้าถึงของเบราว์เซอร์บนคลาวด์ไม่ให้เข้าถึงส่วนที่ทำสิ่งเหล่านั้นได้ หรือเลือกใช้เบราว์เซอร์ runtime ที่คุณควบคุมเอง ทั้งนี้ในสรุปงาน DevDay ระบุว่าฟีเจอร์ computer use สามารถใช้งานได้ “ผ่านทาง API รวมถึงใน Codex และ ChatGPT Work บนแพ็กเกจ Pro 500 และ Enterprise”
Bedrock Managed Agents, powered by OpenAI: OpenAI และ Amazon ได้นำ “ขีดความสามารถหลักของ Agents API” มาปรับแต่งเพิ่มเติมเพื่อให้ทำงานร่วมกับ AWS ได้อย่างไร้รอยต่อแบบเนทีฟ โดยในหน้าผลิตภัณฑ์ของ AWS ระบุว่าสถานะยังเป็นรุ่นพรีวิว และกล่าวว่าทั้ง agent runtime รวมถึงกระบวนการอนุมานโมเดล (model inference) จะยังคงอยู่ภายใน AWS โดยเอเจนต์แต่ละตัวจะมีข้อมูลระบุตัวตน (AWS identity) และสิทธิ์การเข้าถึงของตนเองใน AWS
Dots บน harness เดียวกัน: เว็บไซต์ Decrypt รายงานว่า harness ของ Codex “ปัจจุบันใช้ขับเคลื่อน dots และเปิดเป็นโอเพนซอร์สแล้ว” โดย dots คือเอเจนต์แบบ always-on ของ ChatGPT ซึ่งแต่ละตัวจะมีคลาวด์คอมพิวเตอร์เป็นของตัวเอง และบทความอธิบาย dots ของเราได้กล่าวถึงจุดเด่นที่ระบบนี้ทำได้ดีไว้แล้ว
ดังนั้น ลูปการทำงานเพียงชุดเดียวนี้จึงรองรับตั้งแต่เอเจนต์เขียนโค้ด, เซสชัน API, เอเจนต์บน AWS ไปจนถึงผู้ช่วยแบบ always-on โครงข่าย harness กำลังหลอมรวมเข้าด้วยกัน แต่สิ่งที่ส่งผลกระทบต่อการทำงานของทีมโดยตรงก็คือ approval events เพราะแต่ละเหตุการณ์คือคำถามที่เกิดขึ้นภายในเซสชันหนึ่งๆ ซึ่งตอบได้โดยใครก็ตามที่เปิดสตรีมนั้นค้างไว้อยู่ และเมื่อมี 5 เซสชันส่งคำขอเข้ามาพร้อมกัน ย่อมต้องมีใครสักคนคอยกำหนดว่าใครมีสิทธิ์อนุมัติ origin ใดบ้าง และจะบันทึกการตัดสินใจนั้นไว้ที่ไหน นี่จึงกลายเป็นปัญหาเรื่อง approval gate ซึ่งเราได้วิเคราะห์กรณีการใช้งานฝั่ง Computer ไว้แล้วในบทความ แนวทางควบคุมความปลอดภัย (guardrails) สำหรับ computer use บน GPT-6 Astra
สิ่งที่ระบบไม่ได้ดูแล: การจัดการในระดับทีม (Team Layer)
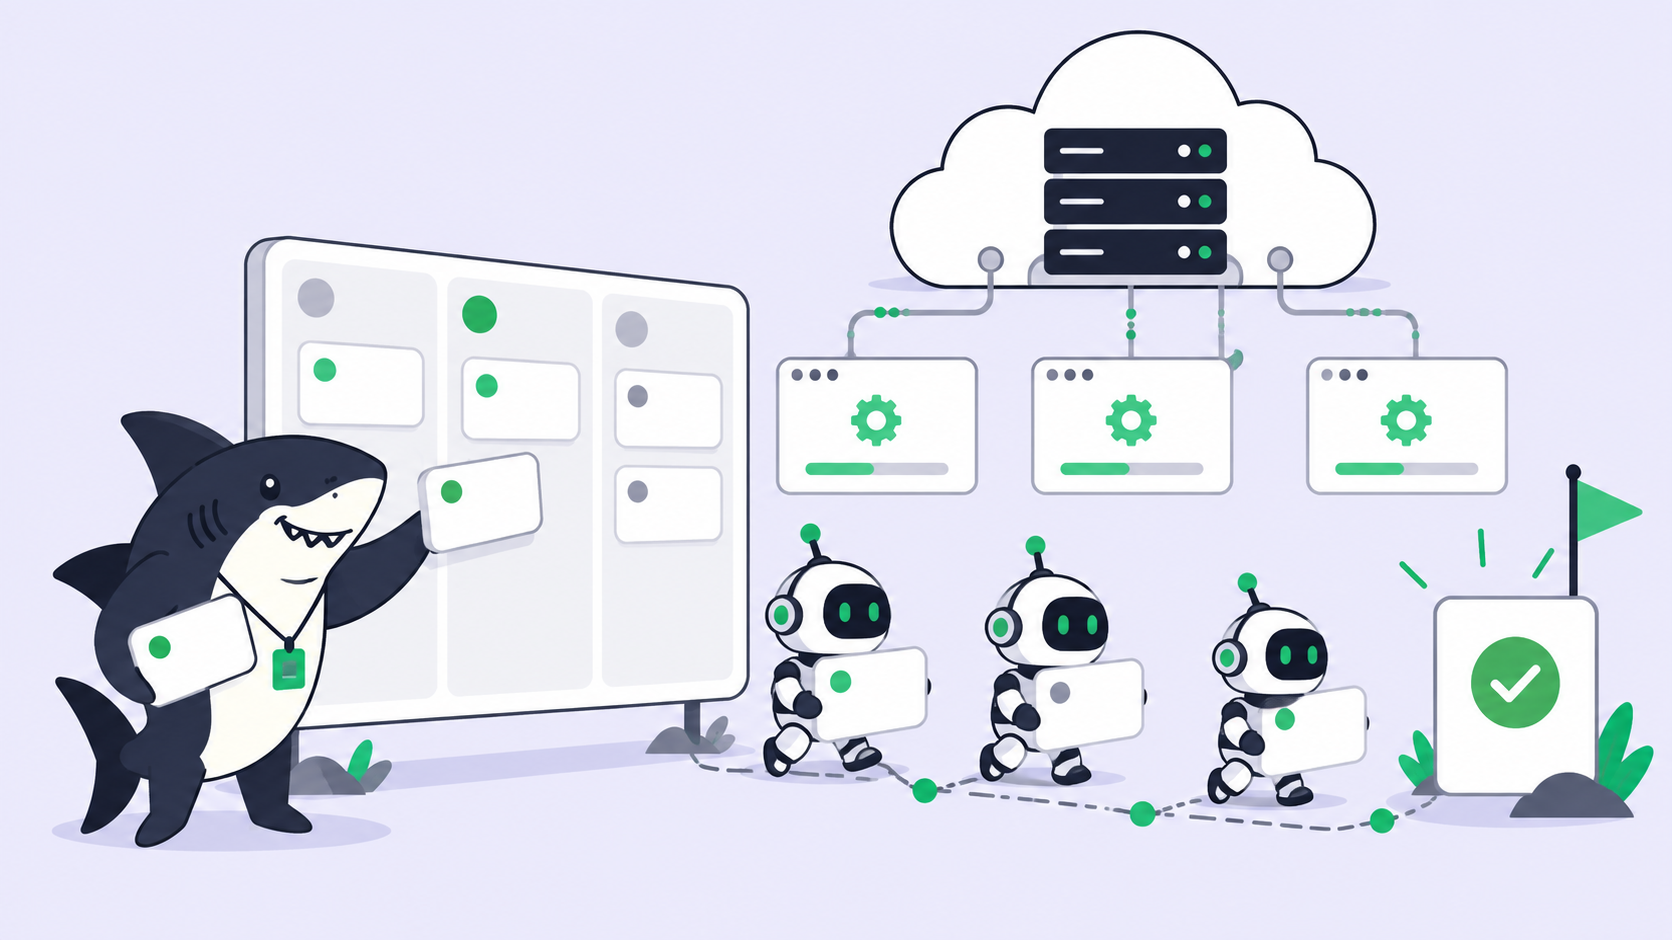
แต่ละเซสชันรับรู้เฉพาะเรื่องของตัวเอง มันไม่รู้เลยว่ามีอีกสามเซสชันกำลังแตะ repository เดียวกันอยู่ หรือผลลัพธ์ของเซสชันที่สี่ถูกทิ้งไว้โดยไม่มีใครเปิดอ่านมาตั้งแต่วันอังคาร สิ่งเหล่านี้คือปัญหาด้านการบริหารจัดการ ซึ่งจะเกิดขึ้นทันทีที่มีคนมากกว่าหนึ่งคนเริ่มเปิดใช้งานเอเจนต์มากกว่าหนึ่งตัว
นี่คือ 5 คำถามที่ตัว API จงใจปล่อยว่างไว้ตามการออกแบบ:
- ใครเป็นผู้มอบหมายงานนี้ และอิงกับทิกเก็ตไหน? เซสชันมีเพียง ID และ metadata เท่าที่โค้ดของคุณส่งเข้าไปเท่านั้น ข้อมูลผู้รับผิดชอบ, Sprint หรือลิงก์ไปยัง issue ต้นเรื่อง จะมีอยู่ก็ต่อเมื่อคุณใส่เข้าไปเอง
- มีการเปลี่ยนแปลงที่ repository และ branch ใด? การเปลี่ยนแปลงของโค้ด (diff) ต้องถูกดึงไปแสดงยังที่ที่ผู้รีวิวสามารถเปิดดูได้
- งานไหนเสร็จแล้ว งานไหนล้มเหลว งานไหนกำลังรออยู่? Events จะสตรีมมาเฉพาะตอนที่คุณเปิดรับฟัง หรือส่งผ่านทาง webhook เท่านั้น โดยไม่มีระบบรวบรวมผลลัพธ์เข้าคิวเพื่อรอให้คนมาตรวจสอบ
- ใครเป็นผู้ตรวจรับผลงาน? Approval event ครอบคลุมเพียงการเข้าถึงเว็บไซต์หรือการเข้าสู่ระบบเท่านั้น ไม่ได้ครอบคลุมตัวชิ้นงาน “เซสชันสิ้นสุดลง” กับ “มีคนตรวจดูผลงานและกดอนุมัติ” จึงเป็นเหตุการณ์เดียวกัน เว้นแต่คุณจะพัฒนาระบบที่สองขึ้นมาเอง
- แล้วเอเจนต์ที่ไม่ใช่ของ OpenAI ล่ะ? หากใช้ Claude Code กับงานประเภทหนึ่ง และใช้ Codex กับงานอีกประเภทหนึ่ง นั่นหมายความว่าคุณมีโมเดลเซสชัน 2 รูปแบบ และต้องคอยดูข้อมูลจาก 2 ที่แยกกัน
คุณอาจพัฒนาระบบทั้ง 5 ข้อนี้ขึ้นมาครอบ events อีกที ไม่ว่าจะเป็นบอร์ด, webhook, ฟิลด์สถานะ หรือคอลัมน์สำหรับการรีวิว แต่แล้วเมื่อมีคนถามขึ้นมาว่า “เราปล่อยตัวแก้ปัญหาระบบ export ไปหรือยังนะ” คำตอบอาจตกหล่นอยู่ในประวัติการเลื่อนหน้าจอที่ไม่มีใครบันทึกไว้ ซึ่งบทความ การจัดการงานสำหรับ AI Agent ได้เจาะลึกแนวทางการพัฒนาระบบเหล่านี้ขึ้นมาใช้งานเองไว้แล้ว
ใช้ Subagents ภายในเซสชัน หรือจัดการเป็น Tasks บนบอร์ดดีกว่ากัน?
การกำหนดค่า max_concurrent_subagents คือคำตอบของ API ในการประมวลผลแบบขนาน ซึ่งทำงานได้ดีมากสำหรับลักษณะงานที่เหมาะสม นี่คือข้อแลกเปลี่ยนที่เราเคยเขียนถึงตอนที่ Codex เพิ่มขีดจำกัด subagent เป็น 64 ตัว โดย subagents จะแชร์โปรเซสหลักร่วมกัน สรุปผลลัพธ์กลับมารวมเป็นคำตอบเดียว และถูกรีวิวผลงานในฐานะผลลัพธ์ชิ้นเดียว
ควรเลือกใช้ subagents ภายในเซสชันเมื่องานส่วนใหญ่เน้นการอ่านข้อมูล (read-heavy), แต่ละส่วนเป็นอิสระต่อกัน และต้องการเพียงผลลัพธ์สรุปรวมในขั้นตอนสุดท้าย เช่น การค้นคว้าหาข้อมูล API 4 ตัวพร้อมกัน, การสแกนโค้ดเบสเพื่อหารูปแบบแพตเทิร์น หรือการรวบรวมหลักฐานเมื่อเกิด incident
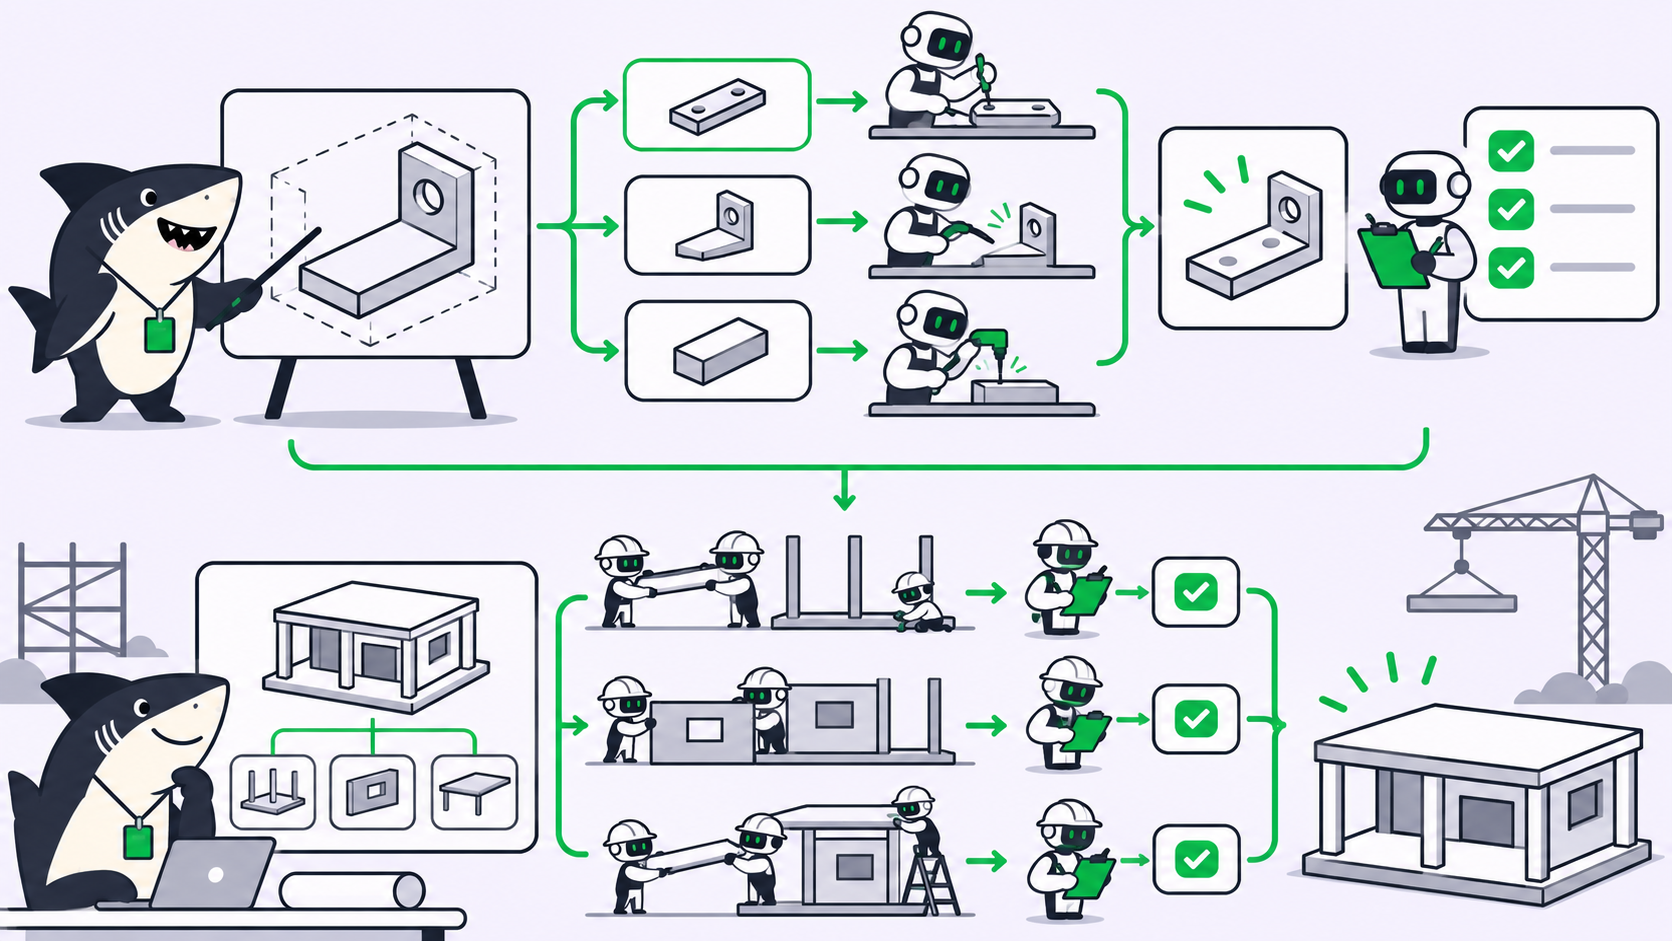
ควรแยกออกเป็น Tasks ต่างหากเมื่องานแต่ละส่วนมีการเขียนโค้ดที่ต้องได้รับการรีวิวแยกเป็นรายชิ้น เช่น การทำ data migration, การพัฒนาฟีเจอร์ในโมดูลหนึ่งๆ หรือการแก้บักที่กระทบกับไฟล์ส่วนกลาง ซึ่งใน Sharkly การทำงานแต่ละครั้งจะมี git worktree แยกต่างหากบน Computer ของคุณเอง และผลลัพธ์แต่ละชิ้นจะถูกส่งกลับมายัง Task ของตัวเองพร้อมแสดง diff, execution log และผู้รีวิวที่เกี่ยวข้อง การรวมการแก้ไขที่มีการเขียนโค้ดหนักๆ (write-heavy) ถึง 4 ส่วนลงในสรุปผลของ subagent เพียงอันเดียว เท่ากับเป็นการซ่อนการตัดสินใจ 4 เรื่องไว้ในการรีวิวเพียงครั้งเดียว
คำถามที่พบบ่อย (FAQ)
ฟีเจอร์ computer use ทำงานบนโมเดลใด? ตัวอย่างในเอกสารทางการใช้ gpt-6-astra โปรดตรวจสอบคู่มือการใช้งานก่อนที่จะสรุปว่าโมเดลอื่นสามารถใช้ร่วมกับเครื่องมือ computer_use ได้
Sharkly สามารถรันเซสชันของ Agents API ได้หรือไม่? Sharkly รันเอเจนต์เขียนโค้ดแบบ CLI ที่ติดตั้งอยู่บน Computers ของคุณ เช่น Codex และ Claude Code ในรูปแบบของ Runtimes ในขณะที่เซสชันของ Agents API จัดเป็นบริการแบบโฮสต์ (hosted service) ไม่ใช่ Runtime ที่ติดตั้งลงในเครื่อง จึงควรมองว่าเป็นเส้นทางการประมวลผลคนละส่วนกัน
กระบวนการตรวจทานโดยมนุษย์ (human review) เกิดขึ้นที่ไหน? สำหรับ Agents API จะขึ้นอยู่กับว่าคุณพัฒนาระบบไว้ตรงไหน เนื่องจาก approval events ครอบคลุมแค่การเข้าถึงเว็บไซต์และการเข้าสู่ระบบเท่านั้น ไม่ได้ครอบคลุมการตรวจรับชิ้นงาน แต่ใน Sharkly เอเจนต์สามารถตั้งสถานะ Task ให้รอการตรวจทานโดยมนุษย์ได้ โดยคำขอจะส่งตรงไปยัง Inbox ของผู้รับผิดชอบ และผู้ใช้จะเปลี่ยนสถานะได้หลังจากอ่านคำตอบ, ตรวจดู execution log และตรวจสอบ diff เรียบร้อยแล้ว
บทบาทที่เหมาะสมของแต่ละเลเยอร์
Durable session บนโครงสร้างพื้นฐานของ OpenAI ถือเป็นองค์ประกอบที่สะดวกสบายที่สุดในการเปิดตัวครั้งนี้ และยังเป็นสิ่งที่ผูกมัดผู้ใช้มากที่สุดด้วย ซึ่งสำหรับทีมวิศวกรแล้ว ประเด็นนี้มีความสำคัญอย่างยิ่ง เพราะเอเจนต์เขียนโค้ดที่ดีที่สุดมีการเปลี่ยนแปลงอยู่ตลอดเวลา และทีมใดที่ผูกสถานะการรีวิวรวมถึงกฎการมอบหมายงานไว้กับระบบจัดเก็บเซสชันของผู้ให้บริการรายเดียว ย่อมต้องรื้อสร้างเวิร์กโฟลว์ใหม่ทั้งหมดทุกครั้งที่ผู้นำตลาดเปลี่ยนไป
หากคุณกำลังพัฒนาผลิตภัณฑ์ที่ขับเคลื่อนด้วยเอเจนต์หรือสร้างบริการฝั่งแบ็กเอนด์ Agents API ถือเป็นเลเยอร์ที่ตอบโจทย์อย่างยิ่ง และ Bedrock Managed Agents ก็เป็นทางเลือกที่เทียบเท่ากันสำหรับทีมที่ต้องการใช้งานภายใน AWS คุณจะได้โครงสร้าง harness โดยไม่ต้องคอยดูแลเอง และได้ sandbox โดยไม่ต้องเสียเวลาจัดเตรียมโครงสร้างพื้นฐาน คุณอาจไม่จำเป็นต้องมีบอร์ดติดตามงานเลยด้วยซ้ำ เพราะตัวแอปพลิเคชันของคุณเองคือบอร์ดนั้น
แต่หากเอเจนต์ของคุณเปรียบเสมือนเพื่อนร่วมทีมที่ทำงานบนโค้ดเบสของคุณเอง ถูกสั่งการโดยมนุษย์ ตรวจทานโดยมนุษย์ และส่งมอบงานผ่าน repository กับระบบติดตามงานเดิมที่มีอยู่ สมการจะเปลี่ยนไปทันที โดย Codex และ Claude Code จะทำหน้าที่ประมวลผล ส่วน Sharkly จะเข้ามาจัดการการมอบหมายงานในระดับทีม, คอมพิวเตอร์ที่เชื่อมต่อ, บริบทของงาน, ความคืบหน้า, ปัญหาติดขัด (blockers), ผลลัพธ์ ตลอดจนการตรวจสอบโดยมนุษย์ครอบคลุมทุกเครื่องมือ Sharkly ไม่ได้เข้ามาแทนที่ Runtime ตัวใดตัวหนึ่ง หรือแทนที่ Agents API แต่อย่างใด คำถามเรื่องการวางตำแหน่งเลเยอร์การทำงานในลักษณะเดียวกันนี้ยังนำไปปรับใช้กับตัว Codex ได้เช่นกัน ซึ่งเราได้อธิบายไว้ในบทความ Codex บนคลาวด์เทียบกับบน Computer ของคุณเอง
จงเลือกเช่า harness หากคุณกำลังสร้างเอเจนต์ขึ้นมา แต่จงเป็นเจ้าของเลเยอร์การบริหารจัดการเอง และรักษาความเป็นกลางไม่ยึดติดกับผู้ให้บริการรายใด หากหน้าที่ของคุณคือการบริหารจัดการเอเจนต์เหล่านั้น
หากคุณกำลังใช้งานเอเจนต์หลายตัวอยู่แล้ว Sharkly จะช่วยให้คุณมีศูนย์กลางเพียงแห่งเดียวในการจัดการงานและผลลัพธ์ทั้งหมด Sharkly ไม่ได้ขายโทเคน โดยการคิดค่าบริการโมเดลจะยังคงตัดผ่านแพ็กเกจสมาชิกหรือ API keys ที่คุณตั้งค่าไว้ในเครื่องมือต่างๆ ที่คุณนำมาเชื่อมต่อ