

สรุปสาระสำคัญ (TL;DR)
หากต้องการกระจายงาน (routing) ให้กับ AI Agent ด้วย Gemini Decisions API ให้ส่งชื่อและรายละเอียดของงานไปยัง gemini-decision-1 พร้อมคำถาม 3 ข้อ ได้แก่ choice เพื่อเลือกว่า Agent ตัวไหนควรรับงาน, score เพื่อประเมินระดับความยาก และ noul เพื่อตรวจสอบว่าต้องให้คนตัดสินใจก่อนหรือไม่ จากนั้นมอบหมายงานโดยอัตโนมัติเมื่อค่าความมั่นใจ (confidence) สูงกว่าเกณฑ์ที่คุณตั้งไว้ ส่วนงานอื่น ๆ นอกเหนือจากนี้ให้ส่งต่อให้คนตรวจสอบ
บทนำ
ทุกทีมที่ใช้งาน Coding Agent หลายตัวมักจะต้องเจอกับภาระงานที่ซ้ำซากเหมือนกัน นั่นคือต้องมีคนคอยอ่านงานใหม่แต่ละชิ้นแล้วตัดสินใจว่าใครควรจะรับไปทำ Agent ฝั่ง Backend หรือ Frontend ดี? ควรใช้โมเดลราคาประหยัดหรือโมเดลตัวท็อปประสิทธิภาพสูง? งานนี้พร้อมเริ่มทำได้เลย หรือว่ายังขาดการตัดสินใจในส่วนไหนอยู่หรือไม่?
Google ได้เปิดตัวเครื่องมือที่ออกแบบมาเพื่องานนี้โดยเฉพาะเมื่อวันที่ 11 พฤศจิกายน 2026 โดย Gemini Decisions API จะตอบคำถามปลายปิดด้วยค่าความน่าจะเป็นที่ผ่านการปรับเทียบมาตรฐาน (calibrated probabilities) แทนที่จะเป็นการสร้างข้อความขึ้นมา ทาง Google เองก็นำเครื่องมือนี้ไปใช้ภายใน Gemini Notebook เพื่อส่งแต่ละคำค้นหาไปยังระดับของโมเดล (model tier) และระดับการคิด (thinking level) ที่เหมาะสม ซึ่งระบุว่าช่วยลดความหน่วง (latency) ของคำค้นหาทั่วไปในชีวิตประจำวันได้สูงสุดถึง 40%
บทความนี้จะพาคุณมาสร้างตัวกระจายงานแบบเดียวกันสำหรับ Agent Board: ยิง API เพียงครั้งเดียวต่องาน, ถามคำถาม 3 ข้อ, กำหนดเกณฑ์วัด 1 ค่า และส่งต่องานให้คนดูแลได้อย่างราบรื่นเมื่อระบบไม่มั่นใจ หากคุณกำลังมองหาบอร์ดสำหรับทดลองใช้งาน Sharkly เปิดให้เริ่มต้นใช้งานได้ฟรี ส่วนเรื่องนโยบายการกระจายงาน (ว่างานประเภทไหนควรใช้โมเดลตัวเก่ง) แนะนำให้อ่าน route agent tasks by difficulty ก่อนเป็นอันดับแรก เพราะบทความนี้จะเน้นไปที่การเรียกใช้งาน API เพื่อนำนโยบายดังกล่าวไปปฏิบัติจริง
การทำงานของ Gemini Decisions API
Gemini Decisions API คือเอนด์พอยต์ที่ประเมินคำถามตามประเภทที่กำหนด (typed questions) เทียบกับข้อมูลนำเข้าชุดเดียวกัน แล้วส่งคืนค่าความน่าจะเป็นและคะแนนความมั่นใจ (confidence score) สำหรับคำถามแต่ละข้อ โดยที่ไม่มีการสร้างข้อความตอบกลับเลย ส่งผลให้โทเค็นขาออก (output tokens) เป็นศูนย์เสมอ โค้ดของคุณจึงสามารถแยกเงื่อนไขการทำงานตามตัวเลขดังกล่าวได้โดยตรงโดยไม่ต้องมีขั้นตอนแยกวิเคราะห์ข้อมูล (parsing)
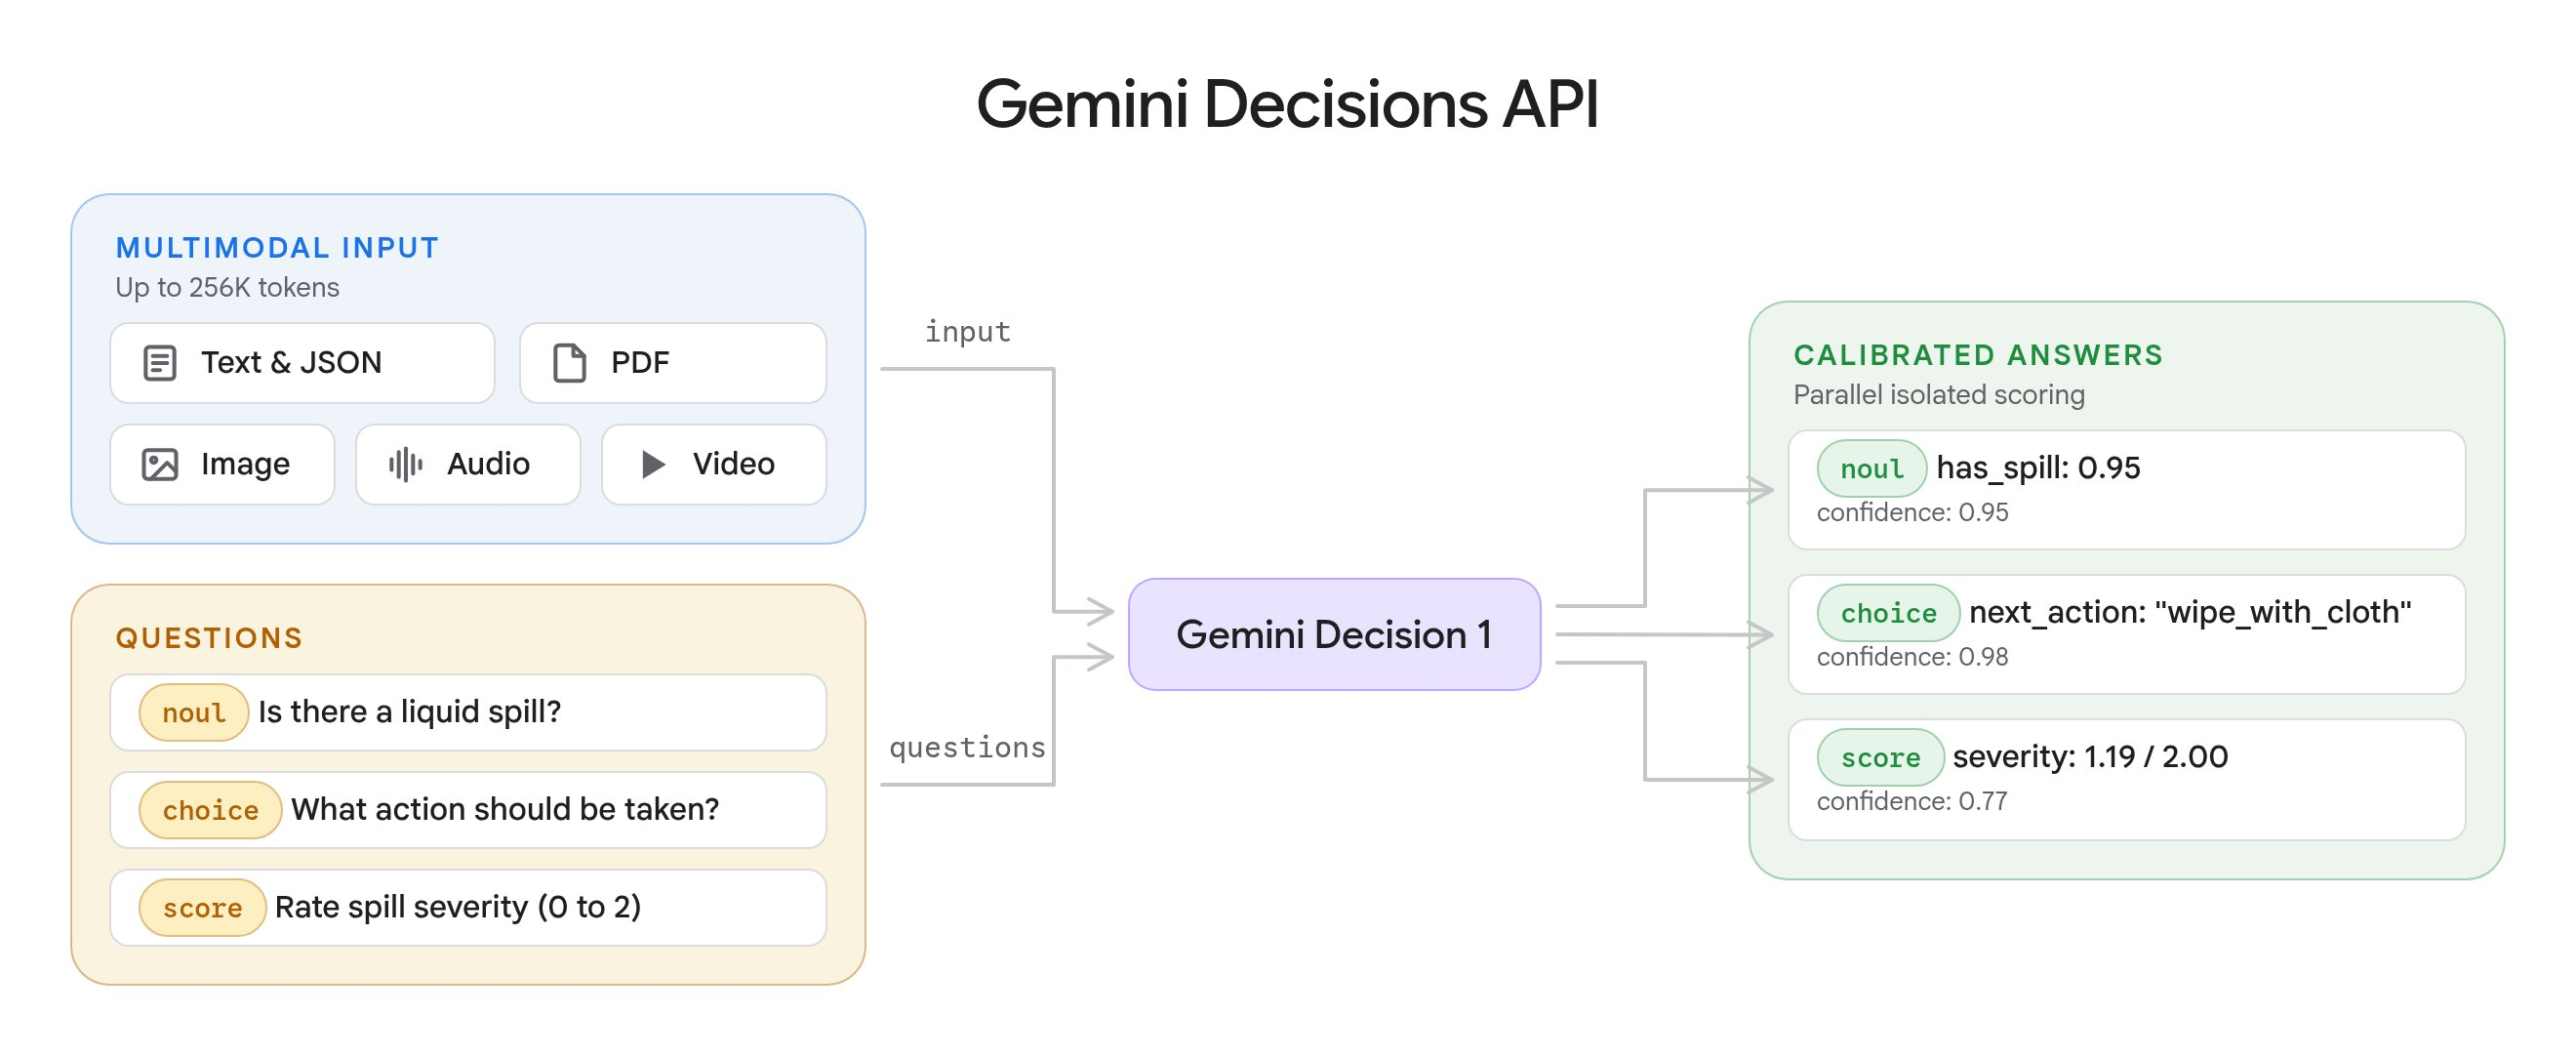
ประเภทของคำถาม 3 รูปแบบที่ครอบคลุมงานกระจายงานมีดังนี้:
| ประเภท | สิ่งที่ใช้ตอบ | ผลลัพธ์ที่ได้กลับมา |
|---|---|---|
choice |
เลือก 1 ตัวเลือก จากทั้งหมด 2 ถึง 255 ตัวเลือก | choice, probabilities, confidence |
score |
ให้คะแนนตามเกณฑ์การประเมินที่มีลำดับชัดเจน | score, probabilities, legend, confidence |
noul |
ใช่ หรือ ไม่ใช่ | noul (0.01 ถึง 0.99), confidence |
คำขอ (request) หนึ่งครั้งสามารถใส่คำถามได้สูงสุดถึง 1,000 ข้อสำหรับข้อมูลนำเข้าชุดเดียวกัน ข้อมูลจาก เอกสารของ Decisions API ระบุว่า คำถามทั้งหมดจะประมวลผลพร้อมกันใน forward pass รอบเดียวและไม่เห็นคำถามข้ออื่น ดังนั้นการเพิ่มคำถามจึงไม่ส่งผลกระทบต่อคำตอบของคำถามข้ออื่น ๆ โดย Google ระบุว่าความหน่วงตั้งแต่ต้นจนจบ (end-to-end latency) อยู่ที่ 150 ถึง 250 มิลลิวินาที และแทบจะคงที่ตั้งแต่ 1 ไปจนถึง 100 คำถาม
หากคุณเคยอ่านบทความของเราเกี่ยวกับ Jev and decision models above coding agents รูปแบบการทำงานนี้คงดูคุ้นเคย สิ่งที่แตกต่างในครั้งนี้คือการนำไปใช้งานจริง: การใช้โมเดลที่โฮสต์โดย Google, การระบุคำถาม 3 ข้ออย่างชัดเจน และการเชื่อมต่อไปยังบอร์ด
การเรียกใช้งานเพื่อกระจายงาน: 3 คำถามต่องานหนึ่งชิ้น
นี่คือตัวกระจายงาน โค้ดนี้ต้องการ google-genai เวอร์ชัน 3.2 ขึ้นไป และ GEMINI_API_KEY จาก Google AI Studio
import json
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

AGENTS = {
    "backend": "Server code, APIs, database migrations, and backend tests.",
    "frontend": "UI components, styling, client state, and frontend tests.",
    "docs": "README files, docs pages, and changelogs. No code changes.",
    "other": "Work that fits none of the options above.",
}

DIFFICULTY = [
    "Trivial: one file, obvious change, no design decision.",
    "Routine: a few files, follows a pattern already in the repo.",
    "Involved: several modules or a new pattern, needs new tests.",
    "Hard: cross-cutting, touches auth or data migrations, or the spec is thin.",
]

def ask(task):
    state = json.dumps({
        "title": task["title"],
        "description": task["description"][:8000],
    })
    result = client.decisions.create(
        model="gemini-decision-1",
        input=state,
        questions={
            "agent": {
                "type": "choice",
                "instructions": "Which agent should take the task in `title` and `description`?",
                "criteria": AGENTS,
            },
            "difficulty": {
                "type": "score",
                "instructions": "How hard is this task for a coding agent working alone?",
                "criteria": DIFFICULTY,
            },
            "needs_human": {
                "type": "noul",
                "instructions": "Does a person need to make a decision before any agent starts?",
                "criteria": {
                    "true_description": "The spec is ambiguous, contradicts itself, or asks for a product, security, or pricing call.",
                    "false_description": "The spec is clear enough to implement as written.",
                },
            },
        },
    )
    return result.answers
รายละเอียด 4 ประการในโค้ดนี้มาจากเอกสารคู่มือโดยตรงและเป็นจุดที่มักจะมองข้ามได้ง่าย
โมเดลจะไม่เห็นคีย์ (key) ที่คุณตั้งไว้ โมเดลจะอ่านเฉพาะ instructions และ criteria เท่านั้น ดังนั้นให้เขียนคำถามฉบับเต็มไว้ใน instructions และอธิบายตัวเลือกทุกข้อให้ชัดเจน
คีย์ของตัวเลือกจะเรียงตามตัวอักษร ตัว API จะเรียงลำดับคีย์ของตัวเลือกตามลำดับไบต์ UTF-8 ก่อนทำการคำนวณคะแนน นี่คือเหตุผลว่าทำไมตัวเลือกแบบครอบจักรวาลจึงใช้ชื่อ other แทนที่จะเป็น none_of_the_above ซึ่งจะถูกจัดให้อยู่ก่อนตัวเลือกจริงอื่น ๆ
ระดับคะแนนต้องเรียงเป็นเส้นตรง (linear) ค่า score ที่ส่งกลับมาคือค่าเฉลี่ยถ่วงน้ำหนักตามความน่าจะเป็นของดัชนีแต่ละระดับ ซึ่งในที่นี้คือ 0 ถึง 3 ดังนั้นควรระบุความแตกต่างระหว่างระดับที่อยู่ติดกันให้ชัดเจน
ส่งเฉพาะข้อมูลที่จำเป็นสำหรับคำถามเท่านั้น เอกสารระบุว่าเนื้อหาที่ไม่เกี่ยวข้องจะลดความแม่นยำลง การส่งเพียงชื่อเรื่องและรายละเอียดของงานมักจะได้ผลลัพธ์ที่ดีกว่าการส่งข้อความในเธรดความคิดเห็นทั้งหมด
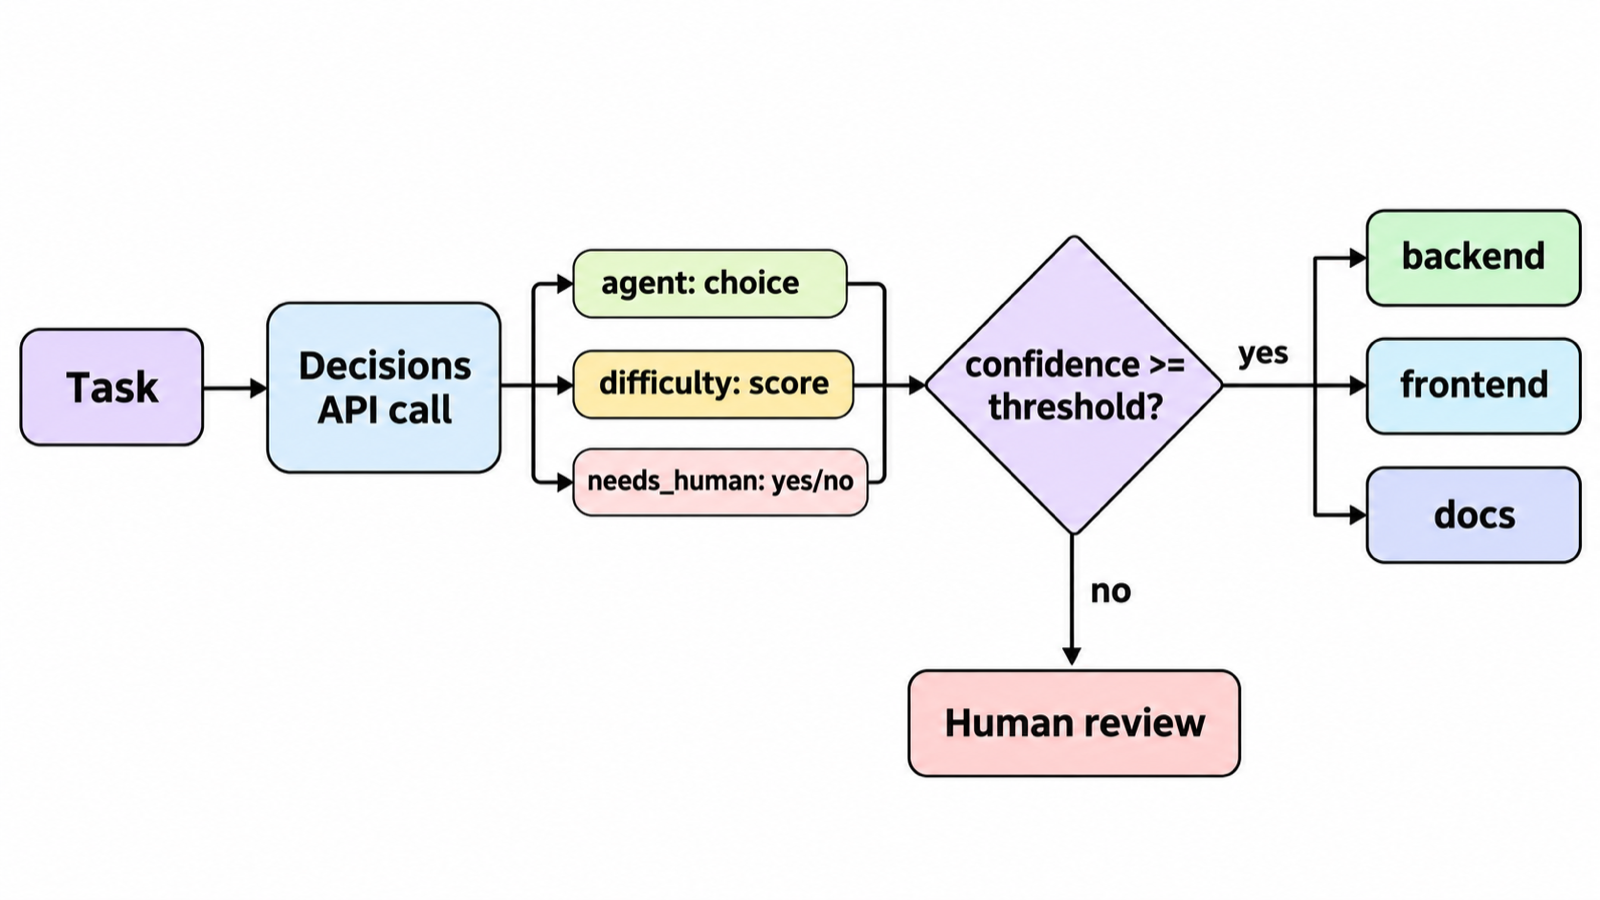
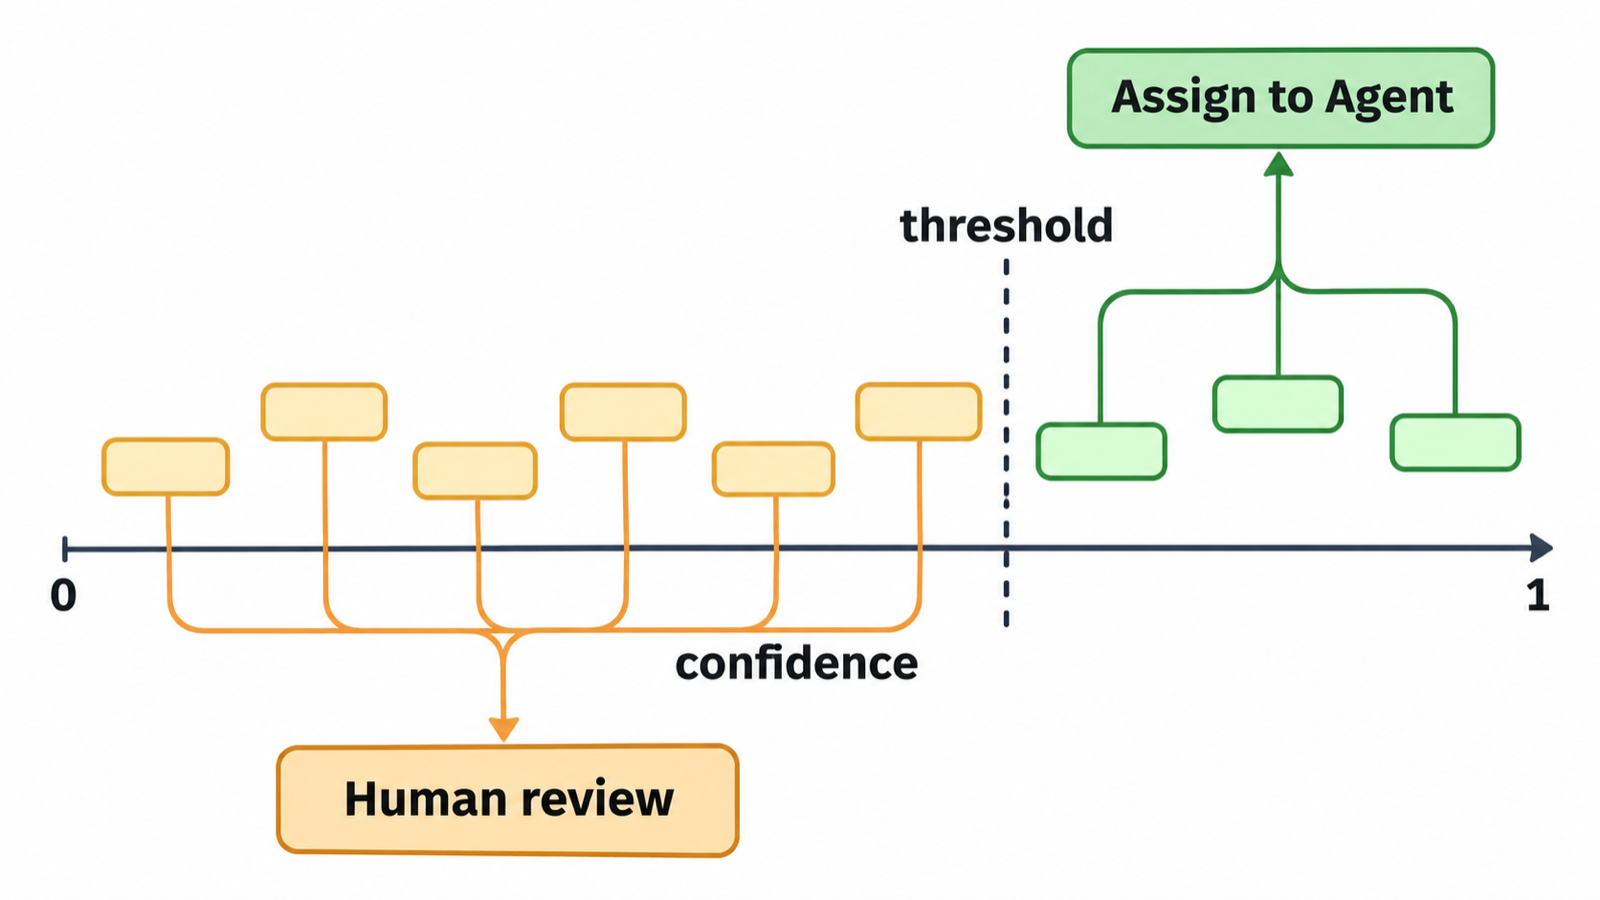
กำหนดเกณฑ์ความมั่นใจจากงานจริงของทีมคุณ
ค่าของคำตอบจะบอกคุณว่าควรทำอะไร ส่วนค่าความมั่นใจ (Confidence) จะบอกคุณว่าสามารถลงมือทำได้เลยโดยไม่ต้องถามคนหรือไม่ สำหรับคำตอบแบบ choice ค่าความมั่นใจจะเท่ากับความน่าจะเป็นของตัวเลือกอันดับสูงสุด ส่วนคำตอบแบบ noul จะมีค่าเท่ากับ max(noul, 1 - noul)
นี่คือตัวอย่างโค้ดในส่วนของการตัดสินใจ (decision layer):
AUTO = 0.75      # assign without a person above this
HARD = 2.4       # difficulty score that earns the strong-model Agent

def decide(a):
    if a["needs_human"].noul >= 0.5:
        return ("human", "needs a decision first")
    if a["agent"].choice == "other" or a["agent"].confidence < AUTO:
        return ("human", f"router unsure ({a['agent'].confidence:.2f})")
    tier = "strong" if a["difficulty"].score >= HARD else "default"
    return (f"{a['agent'].choice}-{tier}", "auto")
อย่าคัดลอกค่า 0.75 ไปใช้โดยไม่คิด คำแนะนำของ Google คือให้ตั้งเกณฑ์วัดจากตัวอย่างงานจริงที่ติดป้ายกำกับไว้แล้ว ลองดึงงานที่ปิดไปแล้ว 50 ถึง 100 ชิ้นล่าสุด บันทึกว่า Agent ตัวใดเป็นผู้สะสางงานแต่ละชิ้น แล้วนำงานเหล่านั้นมารันผ่านฟังก์ชัน ask() จากนั้นเลือกค่าเกณฑ์ที่ต่ำที่สุดซึ่งทำให้งานที่กระจายอัตโนมัติตรงกับสิ่งที่ทีมของคุณเคยทำไว้ การกระจายงานอัตโนมัติผิดพลาดต้องแลกมาด้วยการรันที่ล้มเหลวและการมอบหมายงานใหม่ ในขณะที่การรั้งงานไว้ให้คนตรวจโดยไม่จำเป็นจะเสียเวลาเพียงไม่กี่นาที จงชั่งน้ำหนักระหว่างผลกระทบสองสิ่งนี้ แทนที่จะยึดติดกับตัวเลขกลม ๆ
ข้อควรระวัง 2 ประการ: ค่าความน่าจะเป็นของ noul จะไม่มีทางเกิน 0.99 ดังนั้นเงื่อนไขอย่าง > 0.99 จะไม่มีวันทำงาน และค่า score ที่ได้ 1.5 อาจหมายถึง "ก้ำกึ่งระหว่างระดับ 1 กับ 2" หรือ "ไม่มั่นใจเลยในทั้ง 4 ระดับ" หากจุดนี้มีความสำคัญ ควรตรวจสอบค่า probabilities ควบคู่ไปด้วย
เชื่อมต่อตัวกระจายงานเข้ากับ Sharkly Board
ตัวกระจายงานนี้เขียนขึ้นด้วย Python ธรรมดา จึงสามารถรันที่ไหนก็ได้ สำหรับบนบอร์ดของ Sharkly จุดสั่งการ (trigger) ที่เป็นระเบียบที่สุดคือจังหวะที่งานพร้อมสำหรับการดำเนินการ
1. สร้าง Agent หนึ่งตัวต่อหนึ่งสายงานและระดับโมเดล เช่น backend-default, backend-strong, frontend-default ตามเอกสารคู่มือ Sharkly Agents โดยค่าเริ่มต้น Agent แต่ละตัวจะใช้โมเดลตาม Runtime ของตัวเอง และแถว Model จะช่วยให้คุณเลือกโมเดลอื่นจากแคตตาล็อกของ Runtime นั้นได้ ซึ่งจุดนี้เองที่ระดับความยากจะถูกแปลงเป็นตัวเลือกของโมเดล
2. บังคับใช้การตัดสินใจด้วย sharkly CLI
import subprocess

def apply(task_id, target, reason, a):
    note = (f"Router: agent={a['agent'].choice} ({a['agent'].confidence:.2f}), "
            f"difficulty={a['difficulty'].score:.1f}, "
            f"needs_human={a['needs_human'].noul:.2f}")
    if target == "human":
        subprocess.run(["sharkly", "task", "comment", task_id,
                        "--body", f"{note}. Held for a person: {reason}."], check=True)
        return
    subprocess.run(["sharkly", "task", "edit", task_id,
                    "--delegate-agent", target], check=True)
    subprocess.run(["sharkly", "task", "comment", task_id, "--body", note], check=True)
การมอบหมายงานให้ Agent จะเริ่มสั่งให้มันทำงานทันทีเมื่องานอยู่ในสถานะพร้อม (ready) การบันทึกค่าความน่าจะเป็นลงในความคิดเห็นมีความสำคัญมากกว่าที่คิด เพราะนี่คือวิธีที่คุณจะใช้ตรวจสอบการทำงานย้อนหลังของตัวกระจายงานในอีกหนึ่งเดือนข้างหน้า
3. ตั้งทริกเกอร์เมื่อมีการเปลี่ยนสถานะ ระบบอัตโนมัติ (Automation) ของ Sharkly จะจัดเก็บคำสั่ง (instructions), ผู้รับมอบหมายที่เป็น Agent และตัวทริกเกอร์ ให้คุณส่งคำสั่งไปยัง Router Agent ตัวเล็ก ๆ ว่า "รัน route.py กับงานที่เรียกทริกเกอร์นี้" จากนั้นเพิ่มทริกเกอร์สถานะงาน (task-status trigger) สำหรับสถานะที่ทีมของคุณใช้แทนคำว่า "พร้อม" (ready) การรันที่เริ่มขึ้นจากทริกเกอร์สถานะงานจะเชื่อมโยงกลับไปยังงานชิ้นนั้นเสมอ ทำให้ประวัติการกระจายงานถูกบันทึกไว้ควบคู่กับตัวงาน คำสั่งผ่าน CLI มีดังนี้:
sharkly automation trigger create <automation-id> --kind task_event --to-status "Ready"
ต้นทุนค่าใช้จ่ายในการเรียกใช้งาน Router
Gemini Decision 1 คิดค่าบริการ $0.10 ต่อ 1 ล้านโทเค็นขาเข้า และ $0 สำหรับโทเค็นขาออก ตามโพสต์เปิดตัวของ Google โดยข้อมูลนำเข้าที่ใช้ร่วมกันจะคิดค่าบริการเพียงครั้งเดียวต่อหนึ่งคำขอ ไม่ว่าคุณจะถามคำถามกี่ข้อก็ตาม
| รายการ | จำนวนโทเค็น (โดยประมาณ) |
|---|---|
| ชื่อเรื่องและรายละเอียดของงาน | 2,000 |
| คำถาม 3 ข้อพร้อมเกณฑ์การตัดสิน | 300 |
| รวมต่อการเรียกใช้งาน 1 ครั้ง | 2,300 |
| กระจายงาน 1,000 ชิ้น | 2.3 ล้านโทเค็น, ประมาณ $0.23 |
ค่าใช้จ่ายของตัวกระจายงานนั้นถูกกว่าการรัน Agent ทำงานเพียงหนึ่งครั้งต่องานหนึ่งชิ้นเสียอีก นอกจากนี้ Google ยังมีระดับใช้งานฟรี (no-cost tier) ใน AI Studio สำหรับการทดสอบและพัฒนาต้นแบบอีกด้วย
ข้อจำกัดที่ควรรู้ก่อนนำไปใช้งานจริง
ปัจจุบันตัว API เปิดให้ใช้งานในรูปแบบ v1beta บน Gemini Developer API ส่วน Gemini ใน Google Cloud นั้นระบุว่า "เร็ว ๆ นี้" (coming soon) เอกสารคู่มือระบุว่ายังไม่รองรับ Context Caching, Batch API หรือการอนุมานแบบ Flex และ Priority ดังนั้นข้อมูลนำเข้าที่ส่งซ้ำจะถูกนับเต็มจำนวนทุกครั้ง สำหรับข้อจำกัดด้านความถี่ในการเรียกใช้งาน (Rate limits) ตามแต่ละระดับ สามารถดูได้ที่หน้าระบุขีดจำกัดอัตราการใช้งานของ Google โปรดตรวจสอบขีดจำกัดของคุณก่อนที่จะส่งงานทุกชิ้นผ่านคีย์เพียงคีย์เดียว
ควรปฏิบัติต่อรายละเอียดของงานเสมือนเป็นข้อมูลที่ไม่น่าไว้วางใจ (untrusted input) เอกสารระบุเตือนว่าข้อความที่ผู้ใช้ป้อนเข้ามาอาจมีการโน้มน้าวหรือชี้นำการจัดหมวดหมู่ของตัวเองได้ หากมีบุคคลภายนอกทีมสามารถเปิดงานได้ ขอแนะนำให้ส่งเรื่องให้คนตรวจสอบเสมอสำหรับงานใดก็ตามที่แตะต้องเรื่องระบบยืนยันตัวตน (auth), ระบบชำระเงิน หรือข้อมูลบน Production ไม่ว่าตัวกระจายงานจะตัดสินอย่างไรก็ตาม
ข้ออ้างเรื่องผลการทดสอบประสิทธิภาพของ Google (มีค่าความคลาดเคลื่อนในการปรับเทียบต่ำที่สุดในบรรดาชุดทดสอบ, ราคาถูกกว่า Gemini 3.5 Flash-Lite ผ่าน Interactions API เกือบ 5 เท่า) ล้วนเป็นตัวเลขของ Google เอง ข้อมูลงานจริงในทีมที่คุณติดป้ายกำกับไว้ต่างหากคือเกณฑ์วัดประสิทธิภาพที่สำคัญที่สุดอย่างแท้จริง
สถานการณ์ที่ไม่ควรใช้การเรียกใช้งาน Router
ควรใช้ Decisions API เมื่อมีงานเข้ามาเร็วกว่าที่คนจะคัดแยกได้ทัน และตัวเลือกมีอยู่อย่างจำกัดตายตัว เช่น ชุดของ Agent, ระดับความสามารถของโมเดล หรือเงื่อนไขตัดสิน ใช่/ไม่ใช่ แต่ให้ใช้กฎธรรมดา (rule) เมื่อป้ายกำกับ (label) ระบุชัดเจนอยู่แล้ว หากทุกงานที่ติดแท็ก docs ต้องส่งให้ docs Agent เสมอ การใช้คำสั่ง if ธรรมดานั้นประหยัดกว่าและไม่มีทางผิดพลาด
ให้เปลี่ยนไปใช้โมเดลแบบ Generative แทนเมื่อคุณต้องการให้ตัวกระจายงานอธิบายเหตุผลเป็นข้อความร้อยแก้ว, เรียบเรียงสเปกงานใหม่ หรือแยกย่อยงานออกเป็นงานย่อย ๆ เนื่องจาก Decisions API ส่งคืนเฉพาะตัวเลข ไม่ใช่ข้อความ และหากต้องการแบ่งงานข้ามหลายบทบาท การใช้ Crew ที่มีหัวหน้าคอยย่อยเป้าหมายจะเหมาะสมกว่า สามารถอ่านเพิ่มเติมได้ที่ model routing for agent Crews
บทสรุป
การกระจายงานคือการตัดสินใจแบบชุดจำกัด (closed-set decision) และ Gemini Decisions API ก็ถูกสร้างขึ้นมาเพื่อการตัดสินใจแบบนี้โดยเฉพาะ: เรียกใช้งานเพียงครั้งเดียว, ได้คำตอบตามประเภทที่ชัดเจน, มีคะแนนความมั่นใจให้คุณกำหนดเกณฑ์วัดได้ และมีค่าใช้จ่ายเพียงเศษเสี้ยวของหนึ่งเซนต์ งานที่เหลืออยู่จึงเป็นหน้าที่ของคุณ: เขียนคำอธิบายตัวเลือกให้ชัดเจน, ปรับเทียบเกณฑ์วัดความมั่นใจกับงานที่ปิดไปแล้วในทีม และส่งต่องานที่มีความมั่นใจต่ำไปให้คนช่วยดูแล
เริ่มต้นจากสายงานเดียวก่อน ลองกระจายงานฝั่ง Backend ใหม่ ๆ สักหนึ่งสัปดาห์ เปรียบเทียบผลการเลือกของตัวกระจายงานกับสิ่งที่ทีมของคุณจะทำจริง แล้วค่อยขยายขอบเขตการใช้งานให้กว้างขึ้น หากต้องการรันตัวกระจายงานนี้บนบอร์ดจริงที่รวบรวมทั้ง Agents, Automations และการตรวจสอบโดยคนไว้ในที่เดียว สามารถเริ่มต้นได้ที่ get started with Sharkly
คำถามที่พบบ่อย (FAQ)
Gemini Decisions API คืออะไร?
คือเอนด์พอยต์หนึ่งของ Gemini API ที่เปิดตัวเมื่อวันที่ 11 พฤศจิกายน 2026 สำหรับตอบคำถามประเภท ใช่/ไม่ใช่ (yes/no), ตัวเลือก (choice) และการให้คะแนน (score) จากข้อความ, รูปภาพ, เสียง, วิดีโอ หรือไฟล์ PDF โดยจะส่งคืนค่าความน่าจะเป็นที่ปรับเทียบแล้วและค่าความมั่นใจแทนการสร้างข้อความตอบกลับ ผ่านการประมวลผลด้วยโมเดล gemini-decision-1
Gemini Decision 1 มีค่าใช้จ่ายเท่าไหร่?
Google กำหนดราคาไว้ที่ $0.10 ต่อ 1 ล้านโทเค็นขาเข้า และ $0 สำหรับโทเค็นขาออก โดยข้อมูลนำเข้าที่ใช้ร่วมกันจะถูกคิดค่าบริการเพียงครั้งเดียวต่อหนึ่งคำขอ นอกจากนี้ยังมีระดับการใช้งานฟรีใน Google AI Studio สำหรับการทดสอบและพัฒนาต้นแบบ
หนึ่งคำขอสามารถถามคำถามได้กี่ข้อ?
ตั้งแต่ 1 ถึง 1,000 ข้อ ภายใต้ขีดจำกัดขนาดบริบท (context window) รวม 262,144 โทเค็น สำหรับข้อมูลนำเข้าและคำถามทั้งหมดรวมกัน โดยคำถามประเภทตัวเลือก (Choice) รองรับได้ตั้งแต่ 2 ถึง 255 ตัวเลือก
ควรใช้เกณฑ์ความมั่นใจเท่าใดในการกระจายงาน?
ไม่มีตัวเลขที่เป็นสากลตายตัว Google แนะนำให้กำหนดเกณฑ์จากตัวอย่างงานจริงที่ติดป้ายกำกับไว้แล้ว ให้ลองทดสอบย้อนหลังกับงานที่ปิดไปแล้ว 50 ถึง 100 ชิ้น แล้วเลือกค่าเกณฑ์ที่ทำให้การตัดสินใจอัตโนมัติตรงกับผลการตัดสินใจของทีมคุณ
Decisions API สามารถเลือกได้หรือไม่ว่า Agent ควรใช้โมเดลใด?
สามารถทำได้ทางอ้อม โดยการตั้งคำถามแบบ score เพื่อประเมินระดับความยาก จากนั้นจับคู่คะแนนระดับสูงเข้ากับ Agent ที่กำหนดค่าให้ใช้โมเดลที่ทรงพลังกว่า สำหรับใน Sharkly คุณสามารถตั้งค่าให้ Agent แต่ละตัวใช้โมเดลที่ต้องการจากแคตตาล็อกของ Runtime นั้น ๆ ได้
Gemini Decisions API พร้อมใช้งานบน Vertex AI แล้วหรือยัง?
ยังไม่พร้อมใช้งานในขณะนี้ โดยโพสต์เปิดตัวของ Google ระบุว่าการรองรับสำหรับ Gemini ใน Google Cloud กำลังจะมาเร็ว ๆ นี้ ซึ่งในปัจจุบันสามารถใช้งานได้บน Gemini Developer API ในรูปแบบ v1beta

