คำตอบโดยสรุป: โค้ดที่สร้างโดย AI ควรเป็น open source หรือไม่? ไม่มีกฎหมายใดบังคับว่าต้องเป็น ข้อโต้แย้งสนับสนุนฝั่งนี้อ้างอิงสองประเด็น: โมเดลเรียนรู้มาจากโค้ด open source และโค้ดที่เขียนโดย AI ล้วนอาจไม่ได้รับความคุ้มครองลิขสิทธิ์ ไม่ว่าคุณจะเห็นด้วยกับฝั่งใด ทีมของคุณต้องการสิ่งเดียวกันก่อน คือบันทึกที่ระบุว่า agent ตัวใดเขียนอะไร จากงานใด และใครเป็นคนรีวิว
เมื่อวันที่ 17 พฤศจิกายน 2026 โพสต์ชื่อ “All AI-generated code should be Open Source” ขึ้นอันดับต้นสุดของ Hacker News ด้วยคะแนนมากกว่า 1,200 และความคิดเห็น 650 รายการ เธรดนี้ดังระงม แต่คำถามที่ซ่อนอยู่ข้างใต้เป็นเรื่องปฏิบัติจริง หาก agent ของคุณเขียนโค้ดใน codebase ของคุณมากขึ้นเรื่อยๆ ใครเป็นเจ้าของโค้ดนั้น อยู่ภายใต้ license ใด และใครรับผิดชอบเมื่อมันพัง?
ข้อโต้แย้ง “โค้ดที่สร้างโดย AI ควรเป็น open source” ว่าอะไรบ้าง
ข้อเสนอให้เปิดโค้ดที่สร้างโดย AI เป็น open source ประกอบด้วยข้อกล่าวอ้างเชิงจริยธรรมบวกกับเชิงกฎหมาย: โมเดลถูกฝึกจากโค้ด open source และ Creative Commons ดังนั้นการปิดผลลัพธ์ของมันคือการ “ฟอก” license เหล่านั้น และโค้ดที่ไม่มีมนุษย์เป็นผู้เขียนอาจไม่ได้รับความคุ้มครองลิขสิทธิ์อยู่ดี จึงควรเผยแพร่ภายใต้ open license หรือ CC0
โพสต์ของ Jakub Jankiewicz วางข้อโต้แย้งในสี่ขั้น:
- ข้อมูลฝึกโมเดล (Training data) โมเดลเรียนรู้จากโค้ด open source หลายทศวรรษและคำตอบบน Stack Overflow ซึ่งอยู่ภายใต้ license ของ Creative Commons ที่กำหนดให้ต้องระบุที่มา การเปลี่ยนสิ่งเหล่านี้เป็นโค้ดปิด “รู้สึกเหมือนการฟอก license” ตามคำพูดของเขา
- ความเป็นผู้เขียน (Authorship) โค้ดที่สร้างโดย AI ล้วนไม่มีมนุษย์เป็นผู้เขียน จึงไม่ควรได้รับความคุ้มครองลิขสิทธิ์ เขาอ้างถึงกรณีภาพเซลฟี่ลิงและจุดยืนของ U.S. Copyright Office เรื่อง AI
- เขตอำนาจศาล (Jurisdiction) บางประเทศ เช่น สหราชอาณาจักร ให้ความคุ้มครองอย่างจำกัดแก่ผลงานที่สร้างโดยคอมพิวเตอร์ กฎจึงไม่เป็นเอกภาพ
- ทางแก้ นักพัฒนาควรเผยแพร่โค้ดที่สร้างโดย AI ภายใต้ open source license หรือมอบให้เป็นสาธารณสมบัติด้วย CC0 อย่างน้อยในกรณีที่มนุษย์แทบไม่ได้ทำอะไรมากไปกว่าการเขียน prompt
ประเด็นสุดท้ายนี้สำคัญที่สุดสำหรับทีมต่างๆ: เขากำลังพูดถึงโค้ดที่ไม่มีใครรีวิวหรือแก้ไข ไม่ใช่โค้ดที่มนุษย์ออกแบบแล้วให้ agent พิมพ์
ลิขสิทธิ์กับโค้ดที่สร้างโดย AI: กฎหมายอยู่ตรงไหน
ส่วนเชิงกฎหมายของข้อโต้แย้งนี้มีน้ำหนักรองรับจริงในสหรัฐอเมริกา แต่ได้รับการสนับสนุนน้อยกว่าในที่อื่น
ในเดือนมกราคม 2025 U.S. Copyright Office เผยแพร่ ส่วนที่ 2 ของรายงานเรื่อง AI ว่าด้วยการได้รับความคุ้มครองลิขสิทธิ์ จุดยืนของรายงานคือ: ลิขสิทธิ์ต้องการผู้เขียนที่เป็นมนุษย์ prompt เพียงอย่างเดียวโดยทั่วไปไม่ได้ให้การควบคุมผลลัพธ์เพียงพอ และการมีส่วนร่วมของมนุษย์ เช่น การคัดเลือก จัดเรียง หรือแก้ไขผลลัพธ์ ยังคงได้รับการคุ้มครองได้ ในเดือนมีนาคม 2025 D.C. Circuit ยืนยันในคดี Thaler v. Perlmutter ว่า Copyright Act กำหนดให้ต้องมีผู้เขียนที่เป็นมนุษย์
สหราชอาณาจักรมีแนวทางต่างออกไป มาตรา 9(3) ของ Copyright, Designs and Patents Act 1988 ถือว่าผู้เขียนของผลงานที่สร้างโดยคอมพิวเตอร์คือบุคคลที่จัดการขั้นตอนจำเป็นให้ผลงานนั้นถือกำเนิดขึ้น
ดังนั้นในสหรัฐฯ ไฟล์ที่ agent สร้างขึ้นโดยไม่มีการแก้ไขที่มีนัยสำคัญจากมนุษย์ อาจได้รับการคุ้มครองลิขสิทธิ์อ่อนแอหรือไม่ได้รับเลย ส่วนไฟล์ที่นักพัฒนาจัดโครงสร้างใหม่ ตัดทอน และต่อยอด ย่อมได้รับการคุ้มครอง โค้ดส่วนใหญ่ในระบบ production อยู่ระหว่างสองขั้วนั้น และเส้นแบ่งอยู่ที่กระบวนการรีวิวของคุณ
ข้อโต้แย้งฝ่ายตรงข้าม เทียบข้างต่อข้าง
ข้อคัดค้านที่หนักแน่นที่สุดในเธรดไม่ใช่ “ผู้เขียนเข้าใจกฎหมายผิด” แต่เป็นเรื่องว่าอะไรจะตามมาจากมัน
| ข้อโต้แย้ง | ข้อคัดค้าน |
|---|---|
| โมเดลฝึกจาก open source ผลลัพธ์จึงควรเปิดเผย | ข้อกล่าวหาเรื่องข้อมูลฝึกโมเดลกำลังถูกต่อสู้ในศาล การกำหนด license ให้ผลลัพธ์ไม่ได้ช่วยยุติเรื่องนี้ |
| โค้ดที่ไม่มีลิขสิทธิ์ควรถูกเผยแพร่ | การไม่มีลิขสิทธิ์ไม่เท่ากับการถูกเผยแพร่ รายงานของ Copyright Office ไม่ได้บังคับให้คุณเผยแพร่โค้ดแต่อย่างใด |
| โค้ดที่ใช้แรงงานน้อยไม่สมควรได้รับการคุ้มครอง | แทบไม่มีโค้ด production ใดที่ใช้แรงงานเป็นศูนย์: การเขียนสเปก การรีวิว การทดสอบ และการแก้ไข คืองานของมนุษย์ |
| open license เป็นการแสดงความเคารพต่อสาธารณสมบัติ | การใช้ CC0 ครอบคลุมทั้งหมดอาจแย่งการคุ้มครองจากส่วนที่มนุษย์เขียนซึ่งปะปนอยู่ในไฟล์เดียวกัน |
| กฎควรเป็นเอกภาพทั่วทุกประเทศ | กฎหมายลิขสิทธิ์เป็นเรื่องระดับชาติ กฎของสหราชอาณาจักรข้างต้นก็ต่างจากของสหรัฐฯ อยู่แล้ว |
สังเกตสิ่งที่ทั้งสองคอลัมน์ต้องถือสมมติฐานร่วมกัน ทุกแถวต้องอาศัยการรู้ว่าการเปลี่ยนแปลงหนึ่งๆ มาจาก agent มากแค่ไหน และมนุษย์กำหนดรูปเล่มไว้เท่าไร คุณไม่สามารถเลือกนโยบาย license ตอบคำถามเรื่องที่มาของโค้ดจากลูกค้า หรือโต้แย้งเรื่องความเป็นผู้เขียนได้ หากไม่มีบันทึกเหล่านั้น
ใครรับผิดชอบโค้ดที่ agent เขียน?
การถกเถียงเรื่อง license ยังไม่จบ แต่เรื่องความรับผิดชอบไม่ใช่ คนที่ merge การเปลี่ยนแปลงนั้นคือเจ้าของมัน ไม่ว่าใครหรืออะไรเขียนฉบับแรก
นั่นคือแนวคิดหลักในโพสต์ของเราเรื่อง human ownership of agent work บั๊กในโค้ดที่ agent เขียนก็ยังเป็นบั๊กของคุณ secret ที่รั่วไหลใน pull request ของ agent ก็ยังเป็นเหตุการณ์ความปลอดภัยของคุณ
Agent ทำการวิจัย ดำเนินการ ทดสอบ และรายงาน ส่วนมนุษย์กำหนดทิศทาง มอบอำนาจ และรับผลลัพธ์ การถกเถียงเรื่อง open source ไม่ได้เปลี่ยนการแบ่งหน้าที่นี้ แต่เพิ่มต้นทุนของการตามงานไม่ทัน
ที่มาของโค้ดที่สร้างโดย AI: ควรบันทึกอะไร
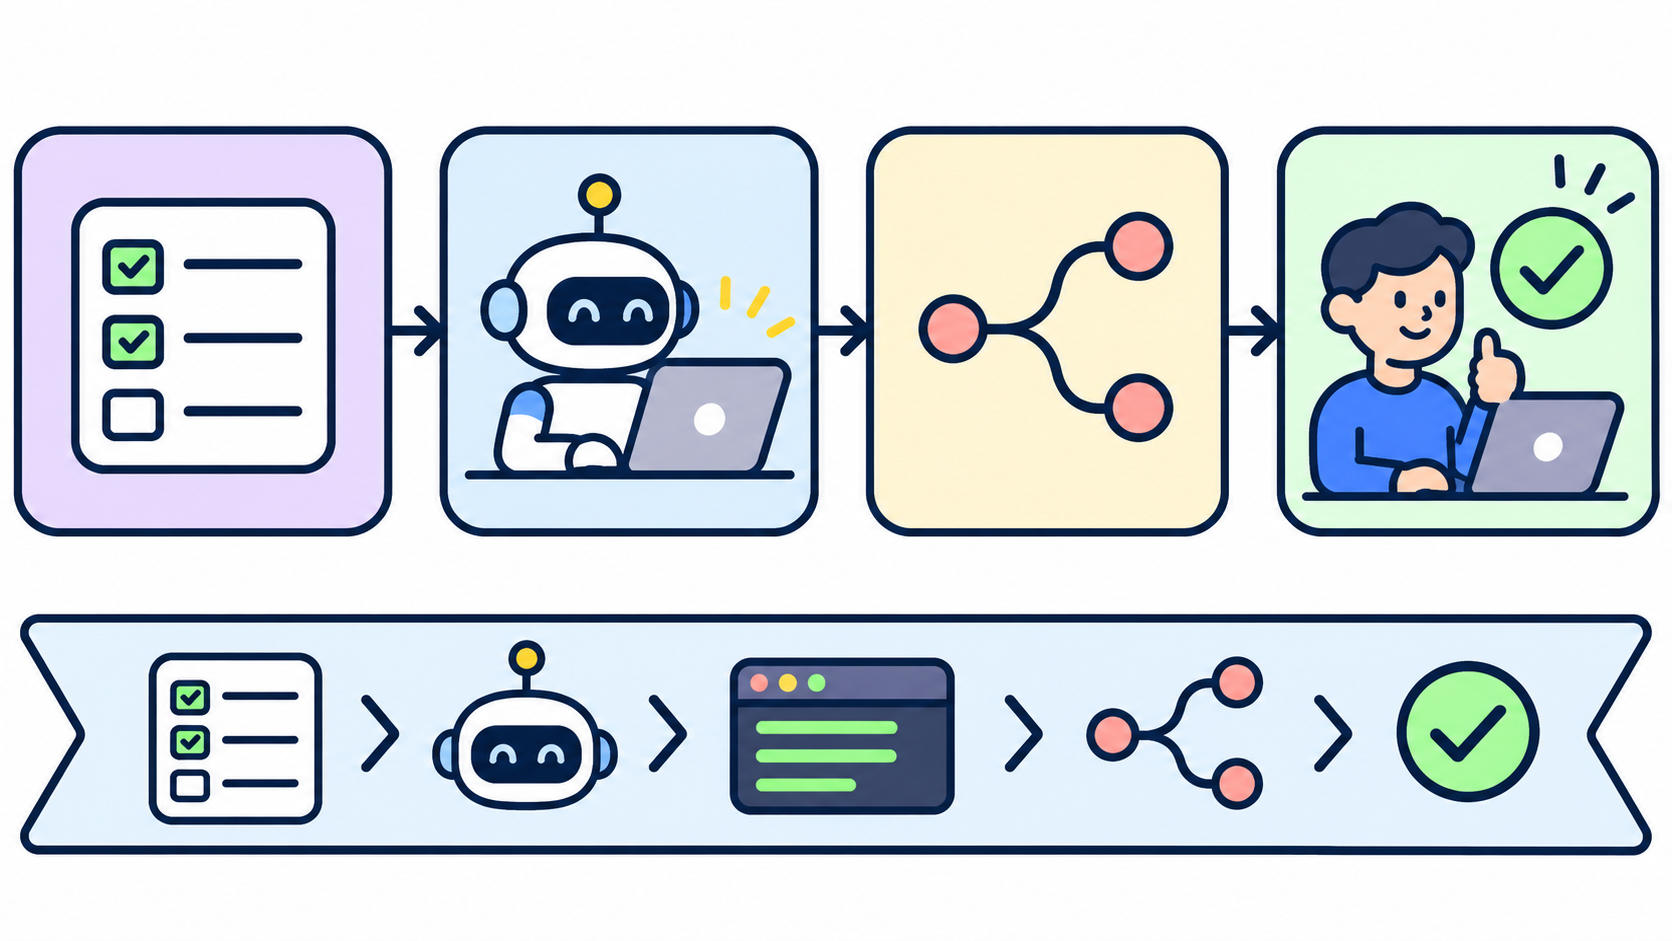
Provenance คือบันทึกว่าการเปลี่ยนแปลงหนึ่งมาจากไหน สำหรับโค้ดที่ agent เขียน บันทึกที่มีประโยชน์ต้องตอบหกคำถาม:
- งานใด (task) ที่ร้องขอการเปลี่ยนแปลง พร้อมความต้องการและเกณฑ์การยอมรับ
- agent ตัวใด ทำงานนั้น บน runtime และโมเดลใด
- run ใด ที่สร้างมันขึ้น พร้อมเวลาเริ่ม เวลาจบ และแหล่งที่มาของ trigger
- pull request ใด ที่นำมันเข้าสู่ repository
- ใครรีวิวมัน และแก้ไขอะไรก่อนยอมรับ
- license ใด ที่ repository ใช้กับโค้ดนั้น
ทีมส่วนใหญ่มีชิ้นส่วนของข้อมูลเหล่านี้อยู่แล้ว ใน pull request มี diff และผู้รีวิว Git สามารถส่งต่อ metadata แบบมีโครงสร้างผ่าน commit trailers ได้ coding agent บางตัว เช่น Claude Code เพิ่ม co-author trailer ให้โดยค่าเริ่มต้น และคุณขยายรูปแบบนี้ด้วย key ของคุณเองได้:
fix(auth): return 401 instead of 500 on expired refresh token

Refresh tokens past their TTL threw an unhandled TokenExpiredError
in the session middleware. Map it to a 401 with a retry hint.

Co-Authored-By: Claude <[email protected]>
Agent-Task: COIN-1287
Agent-Run: 3f9c2a71-0b4e-4c8a-9d51-6e2f4b7a1c09
Reviewed-By: Priya Shah
Human-Edits: renamed handler, added regression test
Trailers เดินทางไปพร้อมกับ commit จึงรอดจากการย้าย repository แต่สิ่งที่มันเก็บไม่ได้คือ run เอง: การเรียกใช้เครื่องมือ ความพยายามที่ล้มเหลว และการอภิปรายเบื้องหลังรูปลักษณ์สุดท้าย
สำหรับการติดตาม license ในระดับไฟล์ ตัวระบุ SPDX และรูปแบบ REUSE ช่วยให้ทุกไฟล์มี license header ที่เครื่องมือตรวจสอบได้ หากทีมของคุณตัดสินใจว่าไฟล์ที่สร้างโดย AI บางส่วนจะเผยแพร่ภายใต้ CC0 นี่คือจุดที่การตัดสินใจนั้นกลายเป็นสิ่งที่ตรวจสอบได้
Sharkly เก็บบันทึกไว้ที่ task อย่างไร
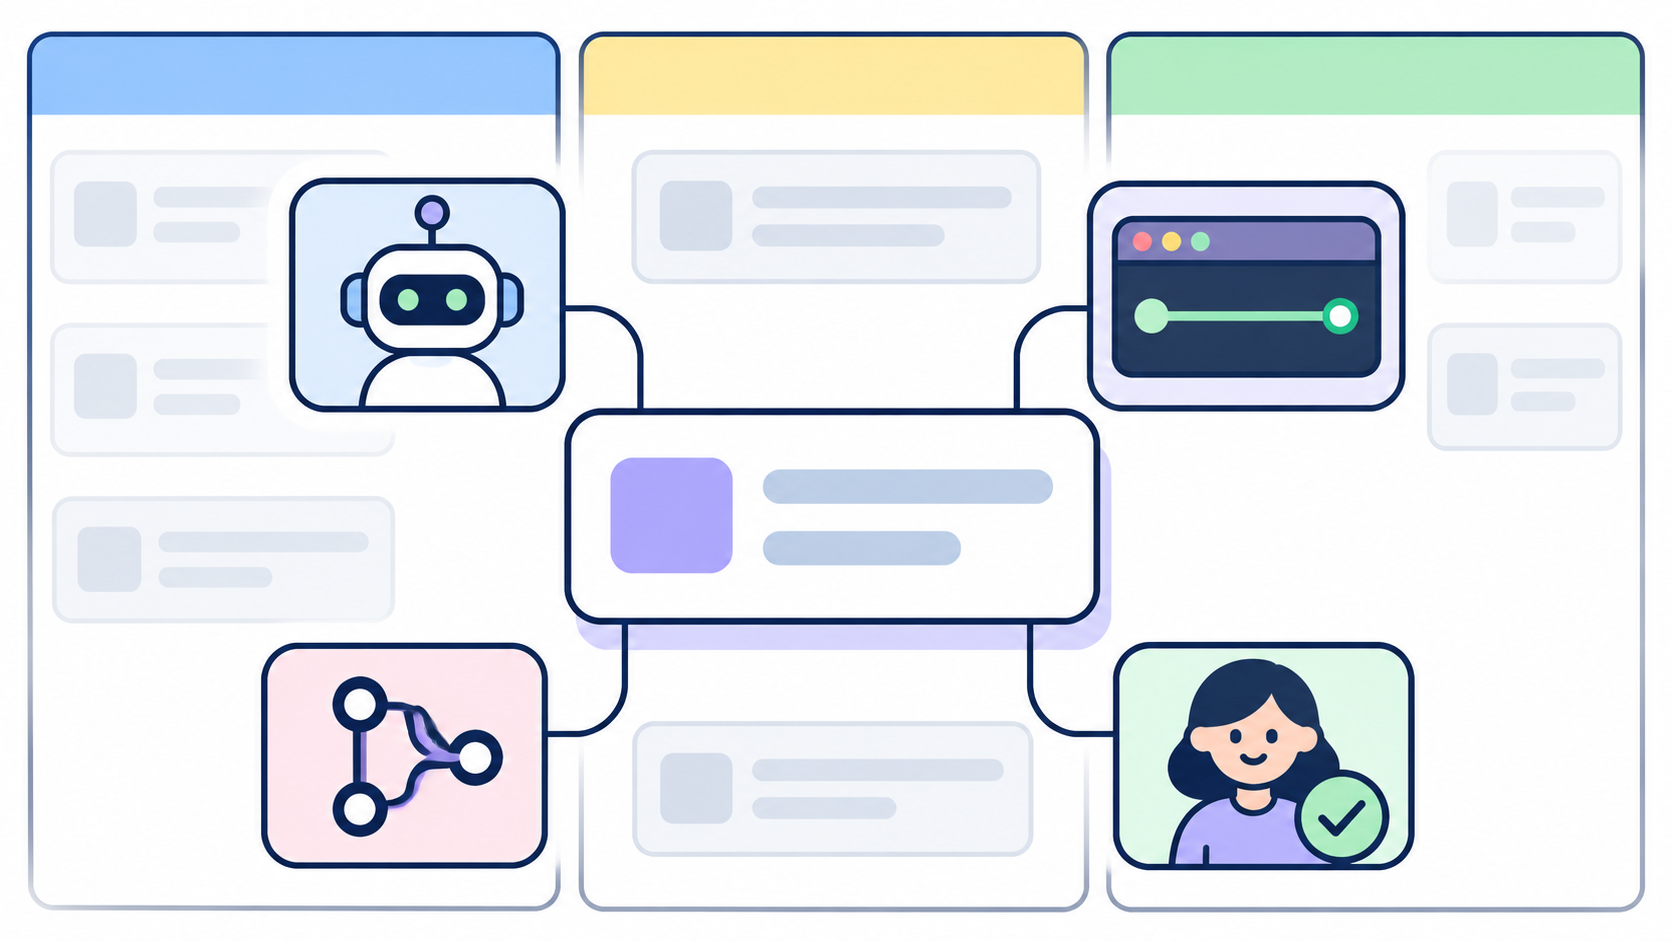
Sharkly เป็นระบบบริหารงานสำหรับมนุษย์และ coding agent คุณมอบหมาย Task ให้ Agent ได้เหมือนมอบหมายให้คน และ Task ยังคงเป็นบันทึกร่วมของทีม
บันทึกนั้นคือร่องรอย provenance ที่ทีมส่วนใหญ่ขาดหายไป:
- Task เก็บความต้องการ ผู้รับผิดชอบ (Assignee) ความคิดเห็น ไฟล์แนบ และไทม์ไลน์ Activity ของการเปลี่ยนแปลงต่างๆ ใน task
- execution log แสดงในแต่ละ run ว่าทำไมจึงเข้าคิว เริ่มและจบเมื่อใด การเรียกใช้เครื่องมือและเหตุการณ์ Runtime แหล่งที่มาของ trigger และรายละเอียดความล้มเหลว ตามที่ เอกสาร task execution อธิบาย
- ความคิดเห็นของ Agent ที่เขียนถึงทีมถูกบันทึกเป็น Comments ที่เชื่อมกับ run นั้น คำอธิบายจึงอยู่ข้างหลักฐาน
- สัญญาณการรีวิว: Agent สามารถปล่อย Task ให้รอการรีวิวจากมนุษย์ ซึ่งจะส่งต่อให้ผู้รับผิดชอบ แทนที่จะ merge อย่างเงียบๆ
- ลิงก์ pull request: การเชื่อมต่อ GitHub เชื่อม pull requests และซิงก์ issues เข้าสู่ Space ทำให้การเปลี่ยนแปลงโค้ดและ task ชี้หากัน
Sharkly ไม่ได้ตัดสินใจเลือก license ให้คุณ และไม่ใช่ผลิตภัณฑ์ด้าน compliance แต่มันเก็บข้อเท็จจริงที่การตัดสินใจเรื่อง license ต้องอาศัยไว้ในที่เดียว แทนที่จะกระจายอยู่ใน session terminal ส่วนตัว
นโยบาย provenance ที่คุณนำไปใช้ได้ภายในสัปดาห์นี้
ใช้นโยบายที่เล็กที่สุดที่ตอบหกคำถามข้างต้นได้ เริ่มจากนี่:
- หนึ่ง task ต่อหนึ่งการเปลี่ยนแปลงจาก agent ห้ามให้ agent ทำงานโดยไม่มี task ID การคุยแบบ ad hoc ใช้สำรวจได้ แต่อะไรก็ตามที่จะขึ้นระบบต้องมี task
- ใส่ task ID ใน branch และ commit trailer หนึ่งอันหรือ prefix ในชื่อ branch ก็เพียงพอสำหรับการค้นหาภายหลัง
- กำหนดให้มีผู้รีวิวที่เป็นมนุษย์และระบุชื่อ ชื่อผู้รีวิวต้องปรากฏใน pull request และ task พร้อมบันทึกสิ่งที่เขาแก้ไข
- เขียนบรรทัดระบุ license ต่อหนึ่ง repository ตัดสินใจว่าโค้ดที่ agent เขียนจะอยู่ภายใต้ license เดิมของ repository (ค่าเริ่มต้นของทีมส่วนใหญ่) หรืออย่างอื่น แล้วเขียนไว้ใน
CONTRIBUTING.md - แท็กไฟล์ที่มี license แตกต่างออกไป ใช้ SPDX headers หากคุณเลือก CC0 หรือ license อื่นสำหรับไฟล์ที่สร้างโดย AI
- เก็บ run logs นานเท่ากับที่คุณเก็บ pull requests ถ้าคุณจะเก็บเธรดรีวิว ก็ควรเก็บ run ที่สร้าง diff นั้นด้วย
สำหรับกลไกการรีวิวเชิงลึก ดู how to review AI-generated code with task-level evidence และ where to put approval gates for coding agents
ใช้นโยบายแบบเบาเมื่อ agent แตะเพียงเครื่องมือภายในและชุดทดสอบ ใช้ครบทั้งหกขั้นตอนเมื่อโค้ดจาก agent ส่งถึงลูกค้า รันในสภาพแวดล้อมที่มีกฎระเบียบกำกับ หรือเข้าสู่ repository ที่คุณเผยแพร่ภายใต้ open source license อยู่แล้ว
ทีมของคุณควรเปิดโค้ดที่ agent เขียนเป็น open source หรือไม่?
อาจไม่ควรโดยค่าเริ่มต้น และไม่ใช่เพราะเธรดนี้เพียงอย่างเดียว กฎหมายยังเปลี่ยนอยู่ ผลลัพธ์จาก agent ส่วนใหญ่ใน workflow ที่มีการรีวิวมีการมีส่วนร่วมจากมนุษย์อย่างแท้จริง และการเผยแพร่แบบ CC0 ครอบคลุมทั้งหมดอาจมอบสิทธิ์ไปมากกว่าที่คุณตั้งใจ
ทางที่ดีกว่าคือทำให้คำถามนี้ตอบได้ เมื่อลูกค้าหรือทีมกฎหมายถามว่า “agent เขียนส่วนนี้ไปเท่าไร และใครตรวจสอบมัน” คุณเปิดบันทึกเดียวแล้วชี้ให้ดู task, run, pull request และผู้รีวิว
หากคุณใช้ Claude Code, Codex หรือ coding agent ตัวอื่นอยู่แล้ว ลองเชื่อมต่อ Computer หนึ่งตัวเข้ากับ Sharkly มอบหมายงานความเสี่ยงต่ำหนึ่งงานให้ Agent แล้วดูว่าบันทึกของ task แสดงอะไรเมื่อ run จบลง บันทึกนั้นคือร่องรอย provenance ของคุณ ไม่ว่าการถกเถียงเรื่อง open source จะลงที่ไหน
FAQ
โค้ดที่สร้างโดย AI ขึ้นทะเบียนลิขสิทธิ์ได้หรือไม่?
ในสหรัฐฯ โค้ดที่ AI สร้างโดยไม่มีการมีส่วนร่วมอย่างมีนัยสำคัญจากมนุษย์ มีแนวโน้มว่าไม่ได้รับความคุ้มครองลิขสิทธิ์ ตามรายงานปี 2025 ของ Copyright Office และคดี Thaler v. Perlmutter แต่การคัดเลือก จัดเรียง และแก้ไขผลลัพธ์โดยมนุษย์ยังคงได้รับการคุ้มครองได้ ประเทศอื่นๆ รวมถึงสหราชอาณาจักร จัดการผลงานที่สร้างโดยคอมพิวเตอร์แตกต่างออกไป
ฉันต้องเปิดเผยโค้ดที่ AI agent เขียนเป็น open source หรือไม่?
ไม่มีกฎหมายบังคับ โพสต์บน Hacker News โต้แย้งว่าคุณควรทำด้วยเหตุผลเชิงจริยธรรม แต่โค้ดที่ไม่มีลิขสิทธิ์ไม่ได้แปลว่าเป็นสาธารณะโดยอัตโนมัติ คุณยังคงเก็บมันเป็นส่วนตัวได้
ใครรับผิดชอบบั๊กในโค้ดที่สร้างโดย AI?
ทีมที่ merge มัน agent อาจเป็นผู้เขียนการเปลี่ยนแปลง แต่คนที่ยอมรับ pull request คือเจ้าของผลลัพธ์ ให้บันทึกชื่อคนนั้นไว้ใน task และ pull request
ฉันจะติดตามว่าโค้ดส่วนใด AI agent เขียนได้อย่างไร?
ผูกทุกการเปลี่ยนแปลงจาก agent เข้ากับ task เพิ่ม task ID และ run ID เป็น commit trailers เชื่อม pull request เข้ากับ task และบันทึกชื่อผู้รีวิวที่เป็นมนุษย์ ใช้ task board ที่เก็บ run log ของ agent ไว้ ก็จะได้ข้อมูลส่วนที่เหลือ
CC0 เหมาะสมกับโค้ดที่สร้างโดย AI หรือไม่?
เหมาะสมสำหรับไฟล์ที่สร้างโดย AI ที่แยกออกมาได้ชัดเจน เช่น fixtures หรือ scaffolding แต่การใช้ CC0 กับไฟล์ที่ปะปนกันเสี่ยงที่จะเผยแพร่ส่วนที่มนุษย์เขียนไปด้วย จึงควรแท็กไฟล์เหล่านั้นด้วย SPDX headers แทนการเปลี่ยน license ทั้ง repository